Khi AI Agent gặp sự cố: làm sao để thực sự dừng nó?
Vì sao tắt model chưa chắc đã dừng được agent
Một AI agent thường chỉ là một phần trong hệ thống lớn hơn. Model chọn hành động, nhưng orchestrator chạy workflow, danh tính cấp quyền truy cập, còn công cụ hoặc API mới là thứ thực thi. Quy tắc mạng quyết định công cụ được kết nối tới đâu.
Vì vậy, việc vô hiệu hóa agent có thể dừng tác vụ hiện tại ở hệ thống này, nhưng ở hệ thống khác các job đang xếp hàng, cơ chế thử lại hay một phiên đã thiết lập vẫn tiếp tục chạy. Thu hồi một thông tin xác thực không đồng nghĩa vô hiệu hóa token hay kết nối khác. Endpoint model có thể offline trong khi một dịch vụ riêng vẫn xử lý công việc đã nhận.
Do đó, "kill switch" nên được hiểu là một bộ kiểm soát đã được kiểm thử: dừng các lượt chạy đang hoạt động và đang chờ, thu hồi thông tin xác thực, vô hiệu hóa quyền truy cập công cụ và hạn chế đường mạng. Trình tự đúng phụ thuộc vào kiến trúc và rủi ro gián đoạn các dịch vụ khác.
Khi nào cần khoanh vùng agent?
Hành vi bất thường không đồng nghĩa agent đã bị xâm phạm. Workflow thay đổi, lỗi phần mềm, cấu hình sai hay đầu vào lạ đều có thể tạo ra hành vi trông đáng ngờ, nên cần điều tra tín hiệu trong bối cảnh của nó.
Các dấu hiệu đáng chú ý gồm:
- Agent gọi công cụ hoặc truy cập tài nguyên ngoài nhiệm vụ được giao.
- Khối lượng đọc, ghi hoặc xuất dữ liệu bất thường.
- Workflow vẫn tiếp tục sau khi người vận hành tưởng đã tạm dừng.
- Agent dùng thông tin xác thực, quyền hoặc tích hợp mà chủ sở hữu không lường trước.
- Log về danh tính, ứng dụng hoặc mạng cho thấy hoạt động khác với công việc thường ngày.
Log của chính agent giúp giải thích nó đã cố làm gì, nhưng chỉ là một nguồn bằng chứng. Cần đối chiếu với dữ liệu từ nhà cung cấp danh tính, API, ứng dụng và mạng. Một dòng log ghi hành động được thử không chứng minh hành động đó đã thành công.
Quy trình ứng phó thực tế
- Tạm dừng workflow bị ảnh hưởng: dừng lượt chạy đang hoạt động và tạm ngưng trigger, cơ chế thử lại hoặc hàng đợi nếu có thể. Nếu agent dùng chung hạ tầng với dịch vụ khác, hãy cô lập workflow bị ảnh hưởng thay vì hạ toàn bộ hệ thống, miễn là làm được an toàn. Một câu lệnh yêu cầu agent dừng lại không phải là biện pháp kiểm soát; cần can thiệp qua hệ thống vận hành workflow.
- Thu hồi hoặc giới hạn quyền truy cập: xác định thông tin xác thực, phiên, quyền được cấp và danh tính dịch vụ liên quan tới lượt chạy; vô hiệu hóa hoặc thu hồi quyền không còn đáng tin. Nếu có dấu hiệu lộ bí mật, hãy xoay vòng và rà soát nơi khác đang dùng. Việc thu hồi diễn ra khác nhau giữa các hệ thống, nên cần xác nhận quyền truy cập đã thực sự không còn dùng được.
- Hạn chế công cụ và đường mạng: vô hiệu hóa công cụ hoặc tích hợp liên quan, hoặc áp chính sách chặn agent tới tài nguyên bị ảnh hưởng. Nếu dữ liệu có thể đang bị đưa ra ngoài, kiểm soát mạng giúp hạn chế kết nối tiếp theo trong lúc điều tra. Biện pháp này phải nằm ngoài chỉ dẫn của chính agent. Hướng dẫn của OWASP về bảo mật AI Agent khuyến nghị cấp quyền công cụ theo nguyên tắc đặc quyền tối thiểu, ủy quyền rõ ràng cho thao tác nhạy cảm, có audit trail và cách ngắt hoặc hoàn tác thao tác của agent.
- Lưu bằng chứng và xác định sự việc: ghi lại danh tính agent, ID lượt chạy hoặc phiên, mốc thời gian, lệnh gọi công cụ, quyết định ủy quyền và tài nguyên bị ảnh hưởng. Bảo toàn log trước khi bị xóa hoặc luân chuyển theo chính sách, tránh chép giá trị bí mật vào ghi chú sự cố. Sau đó xác định agent đã thay đổi hoặc truy cập gì, tách hành động đã hoàn tất khỏi hành động mới chỉ được thử, và tách sự thật đã xác nhận khỏi giả định.
- Khoanh vùng ảnh hưởng lan rộng: nếu agent đã truy cập tài khoản hoặc tài nguyên nhạy cảm, đánh giá riêng tài nguyên đó, thu hồi thêm quyền, gỡ thay đổi trái phép và lôi kéo chủ sở hữu hệ thống liên quan. Nếu dữ liệu có thể đã rời môi trường, tuân theo quy trình sự cố, quyền riêng tư và thông báo của tổ chức. Dừng agent chỉ hạn chế hoạt động tiếp diễn, không hoàn tác những gì đã xảy ra.
Khôi phục cẩn trọng và chuẩn bị trước sự cố
Trước khi chạy lại workflow, cần xác định nguyên nhân: đầu vào không an toàn, quyền quá rộng, tích hợp bị xâm phạm, thay đổi cấu hình hay lỗi trong hệ thống bao quanh agent. Chỉ sửa prompt sẽ không giải quyết vấn đề về thông tin xác thực hay chính sách mạng. Hãy khôi phục với phạm vi nhỏ nhất mà tác vụ cần, kiểm thử trong môi trường có kiểm soát, xác minh các thao tác tác động lớn có được ủy quyền đúng và theo dõi lệnh gọi công cụ sau khi chạy lại. Với thao tác có thể lộ dữ liệu nhạy cảm hoặc gây thay đổi không thể đảo ngược, một bước con người duyệt giúp kịp phát hiện sai sót trước khi thực thi.
Kế hoạch ứng phó chỉ hữu ích nếu đội ngũ biết dùng biện pháp nào và tiếp cận được chúng dưới áp lực. Với mỗi agent chạy production, tổ chức cần biết: ai sở hữu và ai có thể tạm dừng; agent dùng danh tính, thông tin xác thực, công cụ và hệ thống nào; cách thu hồi quyền và chặn kết nối mạng; log nào thể hiện hành động và kết quả; cách điều tra thay đổi và khôi phục an toàn. Các quy trình này cần được kiểm thử, kể cả diễn tập tình huống, và xác minh rằng việc thu hồi thông tin xác thực, vô hiệu hóa công cụ thực sự hiệu quả trong môi trường thật. Hướng dẫn ứng phó sự cố của NIST coi chuẩn bị, ứng phó và phục hồi là một phần của quản lý rủi ro an ninh mạng, không phải việc tùy cơ ứng biến sau khi sự kiện xảy ra.
Ứng phó hiệu quả bắt đầu từ việc biết agent có thể dùng thông tin xác thực nào và cách thu hồi quyền truy cập. Giải pháp như KeeperPAM kết hợp quản lý bí mật, kiểm soát truy cập và kiểm toán để quản trị thông tin xác thực đứng sau các workflow do AI vận hành; Keeper Secrets Manager cho phép cấp agent đúng bí mật cần thiết, lấy thông tin xác thực khi chạy và rà soát sự kiện truy cập bí mật.
Nguồn: The Hacker News
Trích nguồn từ: The Hacker News
Tags:
Bài viết liên quan
Tin tặc khai thác lỗ hổng PHP2Shell trên cổng Check Point để cài backdoor TSGA và xóa dữ liệu ESXi
Check Point ghi nhận nhóm tin tặc chưa xác định khai thác lỗ hổng PHP2Shell và CVE-2026-123039 trên cổng bảo mật chưa vá để cài backdoor TSGA, sau đó tấn công máy chủ VMware ESXi bằng wiper.
Đọc thêm
Hai cuộc tấn công Mior và Skyfall cho phép máy chủ cloud độc hại đọc dữ liệu trong VM AMD SEV-SNP
Mior và Skyfall là hai kỹ thuật tấn công mới nhắm vào AMD SEV-SNP, cho phép hypervisor độc hại đọc hoặc sửa bộ nhớ của máy ảo bảo mật. AMD đã phát hành bản vá firmware và microcode cho các dòng chip EPYC bị ảnh hưởng.
Đọc thêm
PostgreSQL vá 52 lỗ hổng, gồm lỗi 22 năm tuổi cho phép RCE sau khi đăng nhập
PostgreSQL phát hành bản cập nhật vá 52 lỗ hổng bảo mật, trong đó CVE-2026-6460 (CVSS 8.8) cho phép người dùng cơ sở dữ liệu chạy mã trên máy chủ. Quản trị viên cần nâng cấp và biên dịch lại các extension viết bằng C.
Đọc thêm
Lỗ hổng MongoDB nghiêm trọng CVE-2026-118383: hai request từ kẻ chưa xác thực có thể làm sập server khi chuyển vai primary
MongoDB đã phát hành bản vá cho lỗ hổng use-after-free nghiêm trọng CVE-2026-118383, cho phép kẻ tấn công chưa xác thực gửi hai request khiến thành viên replica set bị sập khi đảm nhận vai primary.
Đọc thêm
Chiến dịch chiếm phiên Google: Lời mời lịch và proxy trực tiếp
Nhóm nghiên cứu Material Security phát hiện chiến dịch lừa đảo chiếm phiên đăng nhập Google của người dùng doanh nghiệp qua lời mời Google Calendar, dùng proxy ngược để đánh cắp mật khẩu và mã xác thực hai lớp.
Đọc thêm
Lỗ hổng nghiêm trọng trong Red Hat Quay cho phép đọc và ghi đè mọi container image riêng tư
Red Hat Quay dính hai lỗ hổng nghiêm trọng: kẻ tấn công có thể đọc, ghi đè image riêng tư trong mọi repository và đánh cắp token robot account của tenant khác. Bản vá đã phát hành cho tám nhánh Quay 3.
Đọc thêm
Hàng nghìn tài khoản GitHub bị chiếm đoạt để cài mã độc đánh cắp bí mật CI
Kẻ tấn công dùng thông tin đăng nhập của 4.837 tài khoản GitHub để cấy mã độc đánh cắp bí mật vào các quy trình CI, ảnh hưởng ít nhất 1.806 kho mã và hàng nghìn kho khác nhận commit độc hại.
Đọc thêm
Google Cloud cảnh báo ba lỗ hổng CPU AMD Turin có thể rò rỉ dữ liệu giữa các tiến trình trong VM
Google Cloud yêu cầu khách hàng dùng máy ảo trên chip AMD Turin cài bản vá hệ điều hành khách và khởi động lại máy để chống ba lỗ hổng kênh kề có thể làm lộ dữ liệu giữa các tiến trình.
Đọc thêm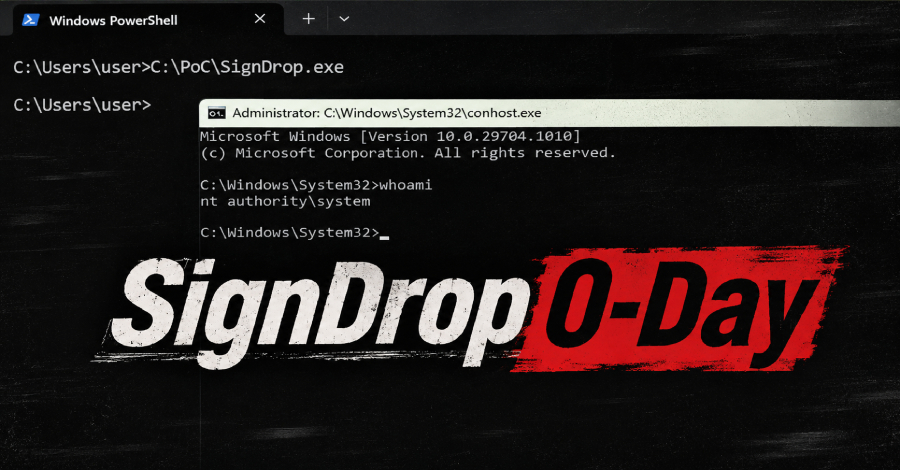
SignDrop: Lỗ hổng zero-day biến tính năng bảo mật CLFS của Windows thành công cụ chiếm quyền SYSTEM
Mã khai thác công khai SignDrop lợi dụng cách driver CLFS tạo tệp đồng hành để nâng quyền từ người dùng thường lên SYSTEM; Microsoft chưa xác nhận, chưa cấp CVE hay phát hành bản vá.
Đọc thêm
Lỗ hổng nghiêm trọng trong Apache HTTP/2 có thể cho phép kẻ tấn công chưa xác thực thực thi mã từ xa
Lỗ hổng CVE-2026-119618 trong module mod_http2 của Apache HTTP Server ảnh hưởng các phiên bản 2.4.55 đến 2.4.70, được vá trong 2.4.71, cho phép kẻ tấn công chưa xác thực chiếm quyền điều khiển tiến trình máy chủ.
Đọc thêm