

Vì sao thời gian fine-tuning thực tế lâu hơn ước tính FLOPs
GPU là một trong những tài nguyên đắt đỏ và khan hiếm nhất trong AI hiện nay. Bất kỳ ai vận hành cụm GPU chia sẻ đều phải quyết định mỗi ngày job nào chạy trên GPU nào và theo thứ tự nào. Kế hoạch đó chỉ tốt bằng ước tính thời gian của từng job: job xong sớm thì GPU ngồi không, job trễ thì mọi thứ phía sau bị dồn lại. Vậy mà phần lớn đội ngũ vẫn dùng cách tính FLOPs sơ bộ, và con số đó thường sai lệch đáng kể so với thực tế.
Khoảng cách giữa tính toán và thực tế
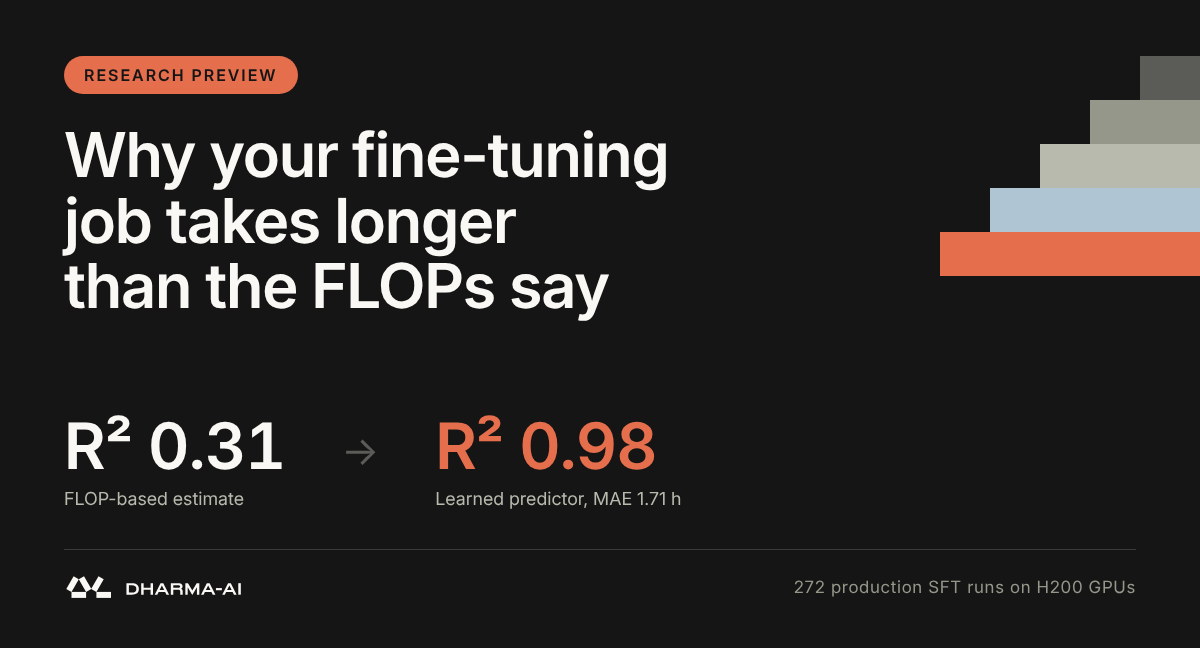
Nhóm nghiên cứu lấy 272 job supervised fine-tuning (SFT) thực tế từ cụm GPU NVIDIA H200 production, tổng cộng khoảng 7.382 GPU-giờ, để so sánh ước tính giải tích với mô hình học dự đoán. Ước tính dựa trên FLOPs thông thường chỉ giải thích được rất ít dữ liệu quan sát (R² = 0.31, MAE 12,41 giờ). Trong khi đó, một mô hình CatBoost chỉ dùng thông tin có sẵn trước khi job được điều phối đạt R² = 0.98, MAE 1,71 giờ và sai số trung vị 0,51 giờ trong kiểm định chéo 5 fold.
Lý do của khoảng cách này: công thức FLOPs chỉ mô tả vòng lặp tối ưu hóa. Một job thực tế còn gồm thiết lập môi trường, tải mô hình, tokenization, đánh giá định kỳ, upload checkpoint và lưu mô hình cuối. Trên cụm đa người dùng, tất cả các bước này còn tranh chấp băng thông mạng và I/O lưu trữ với job khác. Hai job có cùng khối lượng tính toán danh nghĩa có thể kết thúc cách nhau hàng giờ.
Cách xây dựng mô hình dự đoán
Nhóm nghiên cứu coi thời gian chạy end-to-end là bài toán hồi quy có giám sát, dự đoán thời gian từ lúc job nhận GPU đến khi hoàn thành, không tính thời gian xếp hàng. Hai lựa chọn thiết kế quan trọng:
- Mọi đầu vào đều biết trước khi điều phối: siêu tham số, kích thước dataset, định danh mô hình, phân bổ GPU, không dùng log runtime.
- Bổ sung các đặc trưng phản ánh chi phí phụ trợ như số mẫu đánh giá, số checkpoint lưu, khối lượng token trên mỗi GPU; ước tính FLOPs với MFU cố định 0,45 được đưa vào như một đặc trưng nền tảng.
Nhóm so sánh Linear Regression, Ridge, XGBoost và CatBoost, kết hợp lọc tương quan, mutual information và permutation importance trên 18 bộ đặc trưng ứng viên. Mô hình CatBoost cuối cùng dùng 24 đặc trưng.
Kết quả và giới hạn
Dữ liệu gồm các mô hình tới 15 tỷ tham số, cả LoRA và full fine-tuning, chạy trên 1, 2 hoặc 4 GPU trong cụm 8 đến 32 H200. Thời gian chạy dao động từ 1,6 đến 172,4 giờ, trung bình 23,43 giờ.
- Không có giá trị MFU đơn lẻ nào cứu được baseline FLOPs: quét MFU từ 0,25 đến 0,65, mức tốt nhất là 30% vẫn còn sai số trung bình trên 12 giờ.
- Mô hình giải tích chi tiết hơn như Calculon cũng không thu hẹp khoảng cách, chỉ ước tính được trung vị 11% thời gian thực đo.
- Ridge giảm MAE xuống 7,23 giờ nhưng vẫn chững lại; CatBoost và XGBoost gần như tương đương, CatBoost được chọn vì sai số trung bình thấp nhất.
Đặc trưng quan trọng nhất là num_eval_data (tổng số mẫu đánh giá trong suốt vòng đời job), tiếp theo là số tham số huấn luyện được, tỷ lệ batch đánh giá, tổng số tham số và số GPU. Điều này cho thấy tần suất đánh giá, kích thước tập đánh giá và số checkpoint lưu ảnh hưởng lớn đến thời gian chạy, bên cạnh quy mô mô hình và dataset.
Về độ chính xác: sai số tuyệt đối trung vị là 0,51 giờ, 80% dự đoán nằm trong 2,20 giờ và 90% trong 4,31 giờ. Với job dưới 60 giờ, sai số trung vị khoảng một giờ hoặc ít hơn; phần đuôi dài trên 60 giờ là điểm yếu do chỉ có 13 lần chạy. Trên tập holdout 20%, MAE giảm từ 1,63 xuống 1,50 giờ khi dùng 100% thay vì 85% dữ liệu huấn luyện, chưa thấy điểm bão hòa.
Ứng dụng và hạn chế
Mô hình giúp bộ điều phối lập kế hoạch trước khi job bắt đầu: chạy job nào cùng nhau, khi nào GPU được giải phóng, job có kịp hạn không. Hạn chế gồm: chỉ áp dụng cho SFT, chưa gồm RLHF, DPO hay RLVR; chỉ hiệu chỉnh cho H200 nên không chuyển thẳng sang thế hệ GPU khác mà không huấn luyện lại; và sai số tăng với các job rất dài. Điều có thể chuyển giao là phương pháp: đặc trưng nhận biết chi phí phụ trợ, lọc đặc trưng đa cộng tuyến và quy trình so sánh, để có thể tái lập trên bất kỳ tập log thực thi nào có cấu trúc tương tự.
Nguồn: Hugging Face Blog
Trích nguồn từ: Hugging Face Blog
Tags:
Bài viết liên quan

Thúc đẩy agent sử dụng máy tính cho đội ngũ y tế
Bài viết đề cập hướng phát triển agent sử dụng máy tính nhằm hỗ trợ các nhóm làm việc trong lĩnh vực y tế.
Đọc thêm
OpenAI triển khai đánh giá nhúng độc lập với các đối tác nghiên cứu
OpenAI bắt đầu giai đoạn đầu tiên của chương trình đánh giá nhúng, hợp tác với Apollo Research, METR, Transluce và Goodfire để đánh giá độc lập mức độ căn chỉnh, các biện pháp bảo vệ và hệ thống giám sát của mô hình.
Đọc thêm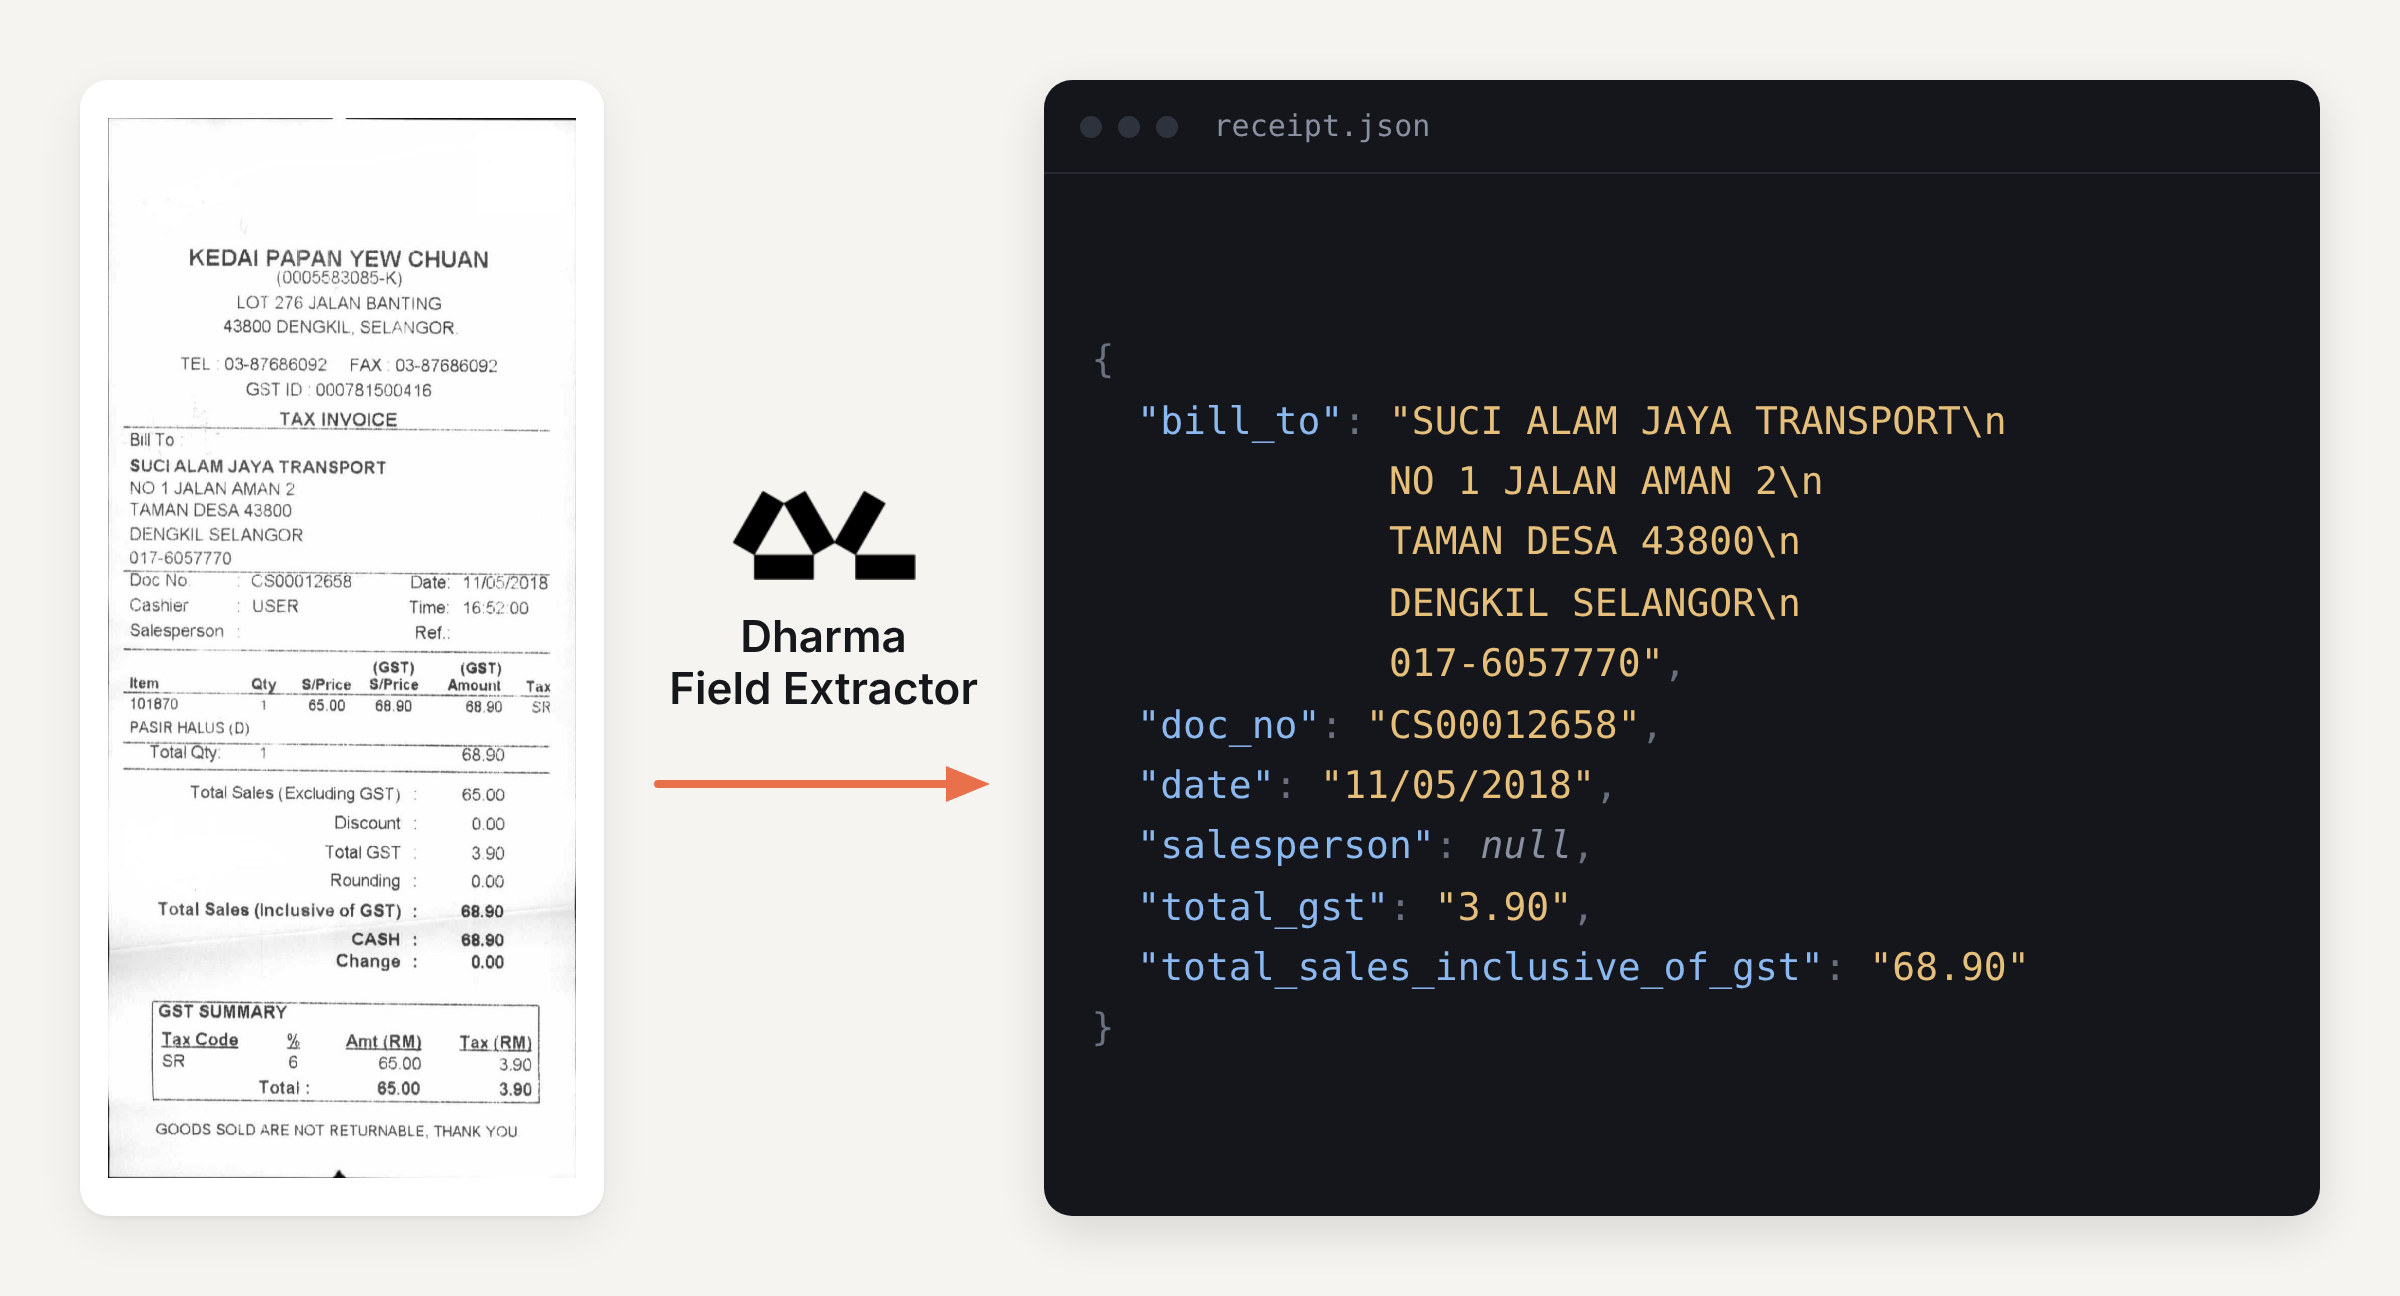
Dharma Field Extractor: mô hình 2 tỷ tham số trích xuất trường dữ liệu từ mọi loại tài liệu
Dharma-AI ra mắt Field Extractor, mô hình 2 tỷ tham số chuyên trích xuất trường dữ liệu có cấu trúc từ tài liệu và trả về JSON, đạt điểm cao hơn các LLM frontier trong thử nghiệm với chi phí thấp hơn nhiều lần.
Đọc thêm
StateBench: Đánh giá khả năng theo dõi thay đổi trạng thái của mô hình ngôn ngữ trong tài liệu dài
Nhóm nghiên cứu giới thiệu StateBench, bộ đánh giá bốn mức độ về khả năng theo dõi trạng thái thực thể trong ngữ cảnh dài, cho thấy mô hình hồi quy và hybrid tổng quát hóa tốt hơn transformer còn các mô hình tiên tiến vẫn suy giảm ở mức khó.
Đọc thêm
Phân phối kỹ năng Agent qua gói NuGet: cách tiếp cận mới cho lập trình với AI
Nhóm phát triển .NET thử nghiệm việc đóng gói các tệp SKILL.md vào gói NuGet để agent AI có thể học cách dùng thư viện ngay khi cài đặt, kèm các công cụ dotnet-inspect và dotnet-package-skills hỗ trợ khám phá và lưu trữ kỹ năng.
Đọc thêm
Biến .NET API thành AI Agent: Vì sao MCP Server sẽ là kỹ năng quan trọng của .NET Developer trong giai đoạn AI Agent?
AI Agent đang thay thế Mobile App như một client mới của API. Tìm hiểu vì sao MCP Server là kỹ năng .NET Developer không thể bỏ qua trong giai đoạn này.
Đọc thêm
BMAD Framework: Review Thực Tế Sau Khi Áp Dụng Vào Dự Án
BMAD Framework là gì và hoạt động ra sao trong thực tế? Review từ TEDU sau khi áp dụng vào dự án AI Driven Development — từ agent team đến docs-as-code.
Đọc thêm
Làm việc với Claude AI hiệu quả: 4 tầng bạn cần setup
Muốn Claude AI thực sự hữu ích? Chỉ nhắn tin thôi chưa đủ. Bài này hướng dẫn 4 tầng setup từ cơ bản đến nâng cao, kèm ví dụ thực tế cho developer và indie hacker.
Đọc thêm
Máy bạn chạy được AI nào? Dùng CanIRun.ai để biết ngay
Muốn chạy AI local nhưng không biết máy có đủ sức? CanIRun.ai giúp bạn kiểm tra ngay — không cần cài đặt, không cần đoán mò.
Đọc thêm
Xây dựng trợ lý AI (Copilot) bằng cách sử dụng Semantic Kernel framework với C#.NET
Semantic Kernel (SK) là một SDK mã nguồn mở, giúp bạn dễ dàng xây dựng các AI agent có thể gọi code hiện có của bạn. SK hỗ trợ các model từ OpenAI, Azure OpenAI, Hugging Face, v.v.
Đọc thêm