

Dharma Field Extractor: mô hình 2 tỷ tham số trích xuất trường dữ liệu từ mọi loại tài liệu
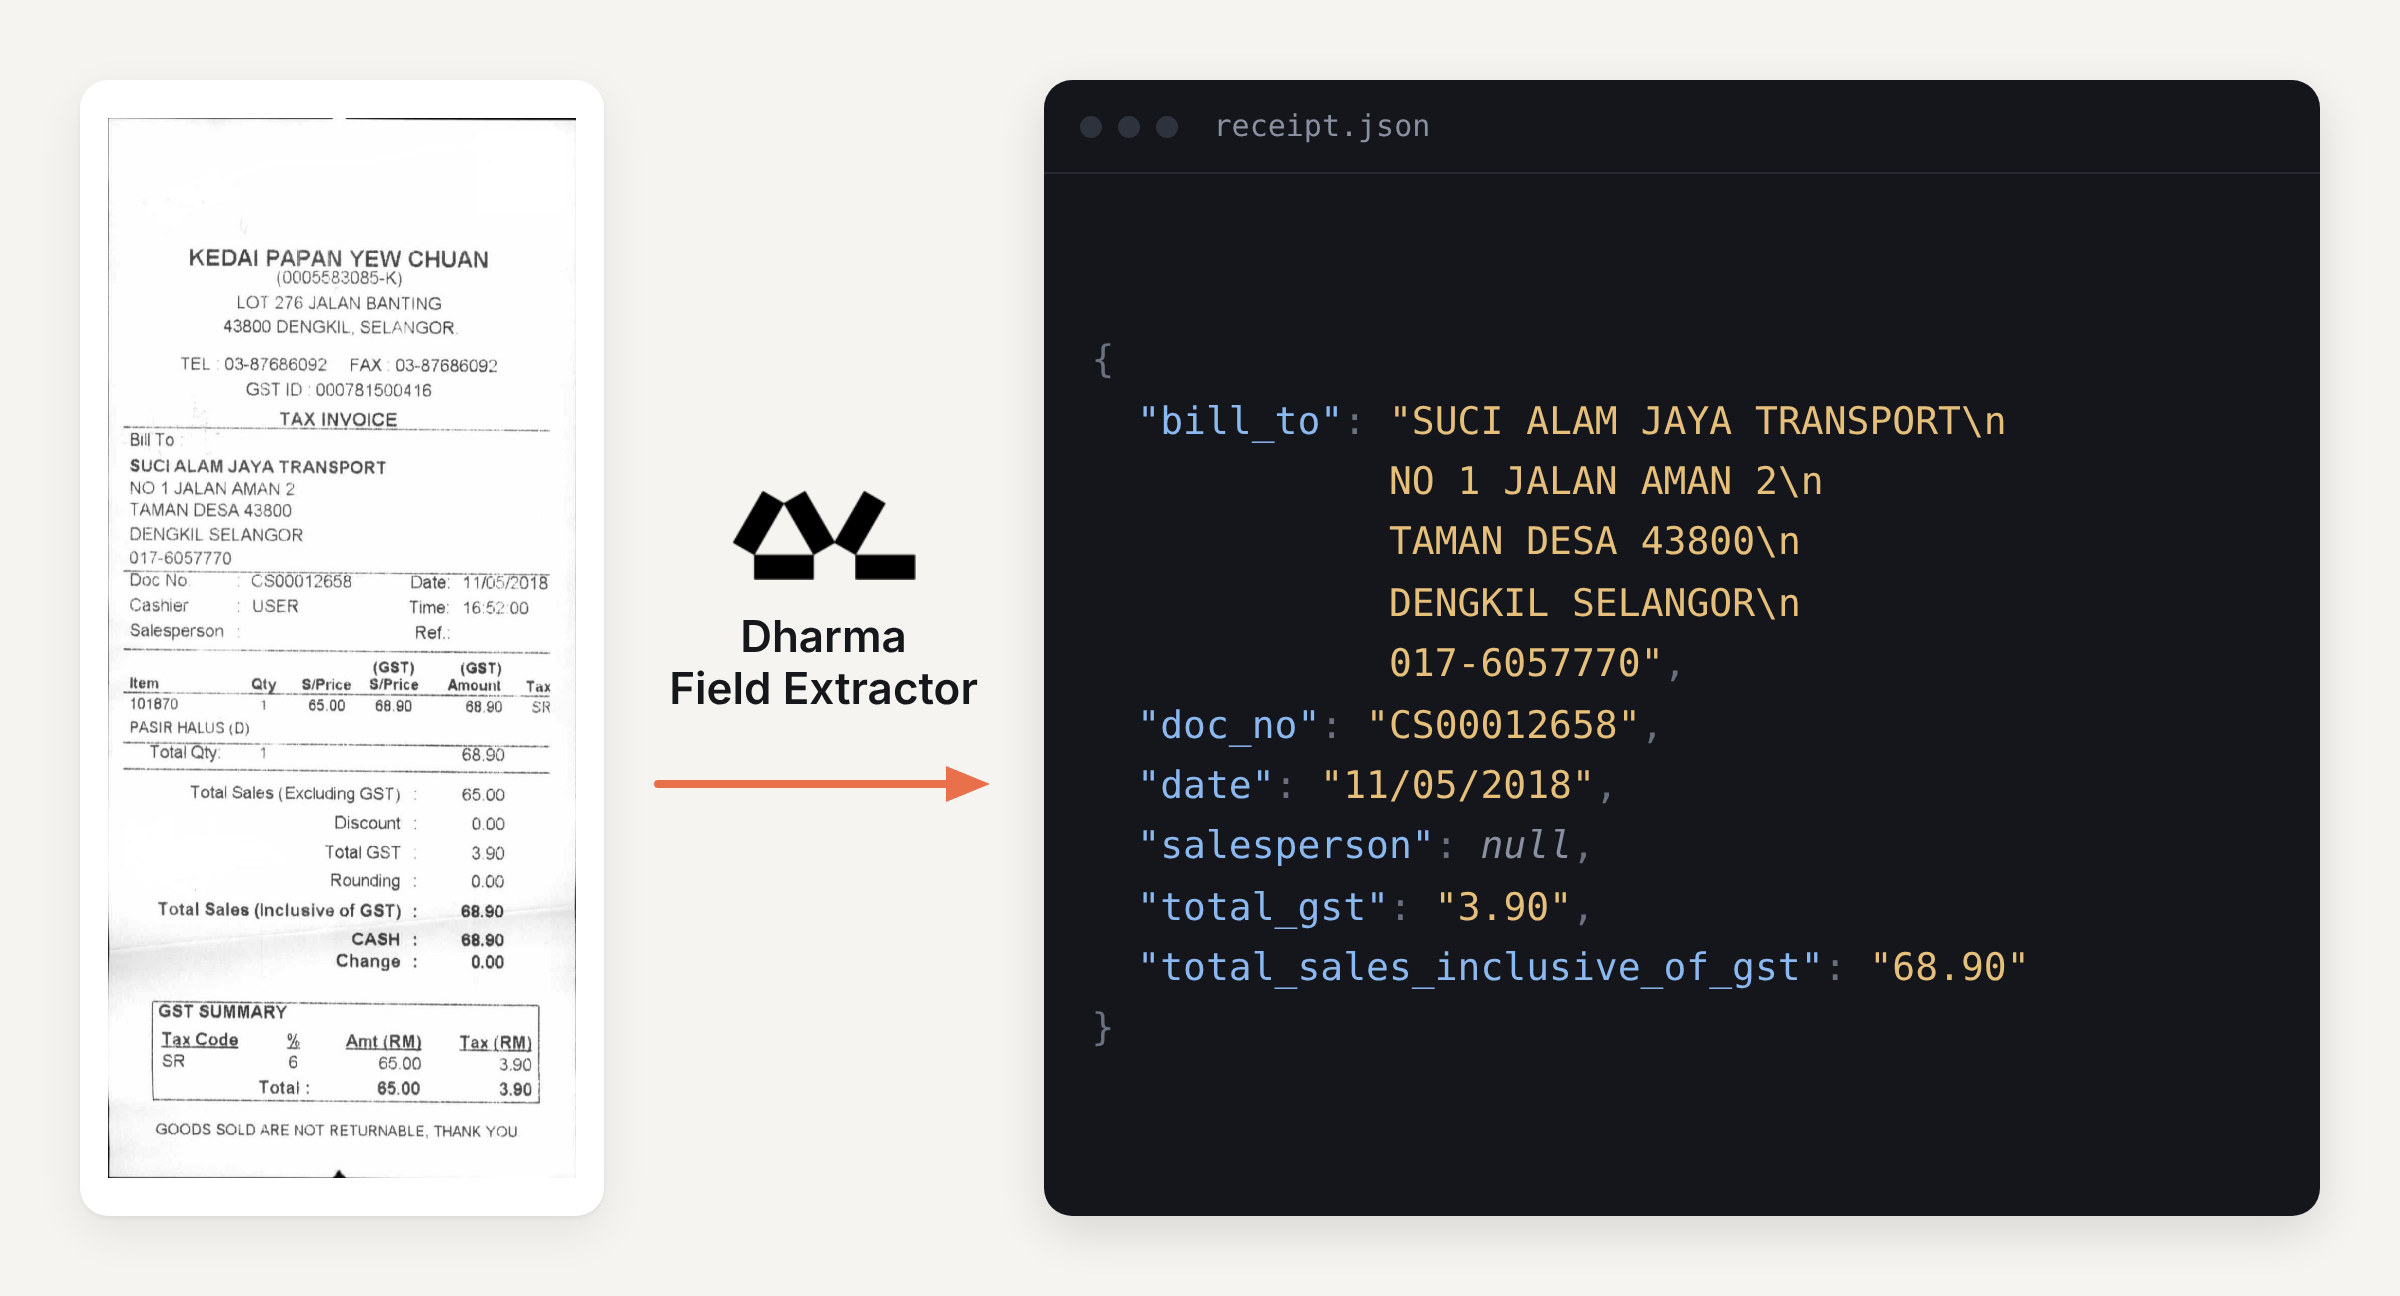
Dharma-AI vừa giới thiệu Dharma Field Extractor, một mô hình 2 tỷ tham số chuyên trích xuất đúng các trường dữ liệu được yêu cầu từ bất kỳ loại tài liệu nào và trả kết quả dưới dạng JSON có cấu trúc. Theo nhóm phát triển, mô hình này vượt mọi cấu hình LLM frontier mà họ thử nghiệm, với chi phí chỉ bằng một phần nhỏ.
Từ OCR đến trích xuất trường dữ liệu
Hồi tháng 4, Dharma-AI đã phát hành DharmaOCR-LITE, mô hình chuyên OCR cho nhiều loại tài liệu như hợp đồng, hồ sơ tòa án, hóa đơn, giấy tờ tùy thân và biểu mẫu. OCR trả về toàn bộ văn bản trên trang, đúng định dạng gốc — phù hợp khi cần cả tài liệu. Nhưng nhiều trường hợp chỉ cần một số trường cụ thể theo dạng hệ thống phía sau có thể xử lý, ví dụ từng dòng hàng trên hóa đơn, tên bệnh nhân và loại xét nghiệm trên phiếu yêu cầu, hay các trường trên giấy tờ tùy thân ánh xạ vào cột của hồ sơ nhân viên.
Với OCR, vẫn phải viết thêm code để gán từng giá trị vào đúng trường trước khi đưa vào cơ sở dữ liệu. LLM đa dụng có thể làm việc này bằng prompt cẩn thận, nhưng với giá và độ trễ của API frontier, ở khối lượng lớn thì đây là cách tốn kém để giải một bài toán đã được định nghĩa rõ.
Hai cách yêu cầu trích xuất
Field Extractor nhận ảnh tài liệu kèm yêu cầu lấy mọi thứ tìm được hoặc một schema chính xác cần điền, rồi trả về JSON có kiểu dữ liệu, theo từng trường, lồng nhau đúng như tài liệu. Cùng một checkpoint xử lý tất cả, không cần fine-tuning riêng cho từng loại.
- Chế độ mở: không cần schema, mô hình tự nhận diện phần nào là trường có cấu trúc dựa trên ngữ cảnh và bố cục, rồi trả về dạng key-value.
- Chế độ theo schema: chỉ định chính xác từng trường với kiểu (string, number, boolean) theo tên khóa hệ thống đang dùng; trường không có trên tài liệu sẽ trả về null thay vì bịa giá trị.
Khi gửi schema, đầu ra tuân thủ đúng schema, cùng khóa và không có trường thừa, nên có thể đưa thẳng vào hệ thống tiếp theo.
Cách huấn luyện
Mô hình nền là DharmaOCR-LITE v1.1, phiên bản 2 tỷ tham số tối ưu từ bản trong bài báo và đã chuyên biệt cho OCR qua supervised fine-tuning và DPO. Trên checkpoint đó, nhóm huấn luyện một LoRA adapter với 43.384 ví dụ, chia thành ba luồng dữ liệu:
- Dữ liệu đa lĩnh vực tiếng Anh thu thập từ web công khai.
- Dữ liệu miền Brazil thực tế bằng tiếng Bồ Đào Nha.
- Dữ liệu đa ngôn ngữ tỷ lệ nhỏ hơn, gồm các ngôn ngữ châu Âu và châu Á khác.
Cả ba luồng đều gán nhãn ở mức trường, trộn nhiều loại tài liệu như biên lai, hóa đơn thương mại, biểu mẫu, sao kê ngân hàng, giấy tờ tùy thân và tài liệu tổng hợp.
Kết quả benchmark
Benchmark gồm 546 tài liệu với ba kịch bản yêu cầu, tổng 1.638 trường hợp: trích mọi trường không schema, schema một phần chỉ gồm trường thật, và schema có thêm trường cố ý không tồn tại. Điểm số là F1 ở mức trường nhân với độ tương đồng Levenshtein trên giá trị khớp và tỷ lệ đầu ra là JSON hợp lệ.
So với các LLM đa dụng frontier, khoảng cách chất lượng từ 1,8 điểm (Claude Opus 5, gần nhất) đến 9,3 điểm (GPT-5.6 Luna, xa nhất). Chi phí thấp hơn khoảng 6 lần (GPT-5.6 Luna) đến khoảng 147 lần (GPT-5.6 Sol). Con số frontier tính từ token đo được mỗi trang theo giá niêm yết của từng nhà cung cấp; mô hình của Dharma-AI chạy tự host nên chi phí là thời gian GPU trên một L40S với 2,24 USD/giờ. Nhóm lưu ý đây không phải giá bán, mà là minh chứng rằng một SSLM tự triển khai trên hạ tầng riêng là lựa chọn thay thế thực tế cho API frontier.
Kiểm tra khả năng tổng quát hóa
SROIE và FUNSD là hai bộ dữ liệu công khai không dùng khi huấn luyện. Trên một biên lai SROIE, mô hình trả đúng cả 18 trường, gồm địa chỉ thanh toán nhiều dòng không nhãn gộp thành một trường, hai trường trống trả về null, mọi con số khớp đến từng cent. Trên một biểu mẫu photocopy FUNSD gồm 12 trường boolean với một nhóm lồng năm tùy chọn con, mô hình đánh dấu đúng ô duy nhất được tick là true, 11 ô còn lại là false, đọc đúng mã Bates viết tay và trả null cho hai trường để trống.
Chất lượng và chi phí cùng lúc
Mô hình 2 tỷ tham số đạt 0,834, cao hơn mọi cấu hình frontier được thử, từ Claude Opus 5 với 0,816 đến GPT-5.6 Luna với 0,741, trong khi chạy trên một L40S với chi phí mỗi lần trích xuất thấp hơn mọi API trong so sánh. Nhóm nhấn mạnh đây là kết quả nối tiếp kết quả trước đó của DharmaOCR-LITE trên tiếng Bồ Đào Nha Brazil, củng cố luận điểm: với một tác vụ có giới hạn, mô hình nhỏ huấn luyện sát tác vụ sẽ đánh bại mô hình frontier được yêu cầu làm việc đó một cách tổng quát. Số tham số đặt ra giới hạn trên, còn cách huấn luyện quyết định mô hình đạt được bao nhiêu phần giới hạn đó cho bài toán của bạn.
Nguồn: Hugging Face Blog
Trích nguồn từ: Hugging Face Blog
Bài viết liên quan
StateBench: Đánh giá khả năng theo dõi thay đổi trạng thái của mô hình ngôn ngữ trong tài liệu dài
Nhóm nghiên cứu giới thiệu StateBench, bộ đánh giá bốn mức độ về khả năng theo dõi trạng thái thực thể trong ngữ cảnh dài, cho thấy mô hình hồi quy và hybrid tổng quát hóa tốt hơn transformer còn các mô hình tiên tiến vẫn suy giảm ở mức khó.
Đọc thêm
Biến .NET API thành AI Agent: Vì sao MCP Server sẽ là kỹ năng quan trọng của .NET Developer trong giai đoạn AI Agent?
AI Agent đang thay thế Mobile App như một client mới của API. Tìm hiểu vì sao MCP Server là kỹ năng .NET Developer không thể bỏ qua trong giai đoạn này.
Đọc thêm
BMAD Framework: Review Thực Tế Sau Khi Áp Dụng Vào Dự Án
BMAD Framework là gì và hoạt động ra sao trong thực tế? Review từ TEDU sau khi áp dụng vào dự án AI Driven Development — từ agent team đến docs-as-code.
Đọc thêm
Làm việc với Claude AI hiệu quả: 4 tầng bạn cần setup
Muốn Claude AI thực sự hữu ích? Chỉ nhắn tin thôi chưa đủ. Bài này hướng dẫn 4 tầng setup từ cơ bản đến nâng cao, kèm ví dụ thực tế cho developer và indie hacker.
Đọc thêm
Máy bạn chạy được AI nào? Dùng CanIRun.ai để biết ngay
Muốn chạy AI local nhưng không biết máy có đủ sức? CanIRun.ai giúp bạn kiểm tra ngay — không cần cài đặt, không cần đoán mò.
Đọc thêm
Xây dựng trợ lý AI (Copilot) bằng cách sử dụng Semantic Kernel framework với C#.NET
Semantic Kernel (SK) là một SDK mã nguồn mở, giúp bạn dễ dàng xây dựng các AI agent có thể gọi code hiện có của bạn. SK hỗ trợ các model từ OpenAI, Azure OpenAI, Hugging Face, v.v.
Đọc thêm
Bài 1: ML.NET là gì? Tổng quan về Machine Learning trong .NET
ML.NET là một framework Machine Learning dành riêng cho .NET, giúp các lập trình viên C# có thể xây dựng mô hình ML một cách dễ dàng mà không cần kiến thức chuyên sâu về AI.
Đọc thêm
Cách Sử Dụng Trí Tuệ Nhân Tạo (AI) trong Business Analytics
Trong bài viết này, chúng ta sẽ khám phá sức mạnh của trí tuệ nhân tạo (AI) trong lĩnh vực Business Analytics và cách nó đã thay đổi cách chúng ta hiểu và thực hiện phân tích dữ liệu.
Đọc thêm
Khám phá Phind: Đối tác lập trình AI hoàn hảo và hoàn toàn miễn phí
Giới thiệu công cụ AI Phind, một trợ lý lập trình miễn phí giúp viết mã nhanh chóng và hiệu quả dựa trên ngữ cảnh và ý định của mã bạn đang viết.
Đọc thêm
Khám phá GitHub Copilot: Đối tác lập trình AI tốt nhất hiện nay
Hướng dẫn sử dụng công cụ AI lập trình Github Copilot thông qua Visual Stdio Code
Đọc thêm