

3 hiểu lầm khiến dev học AI Engineer sai hướng
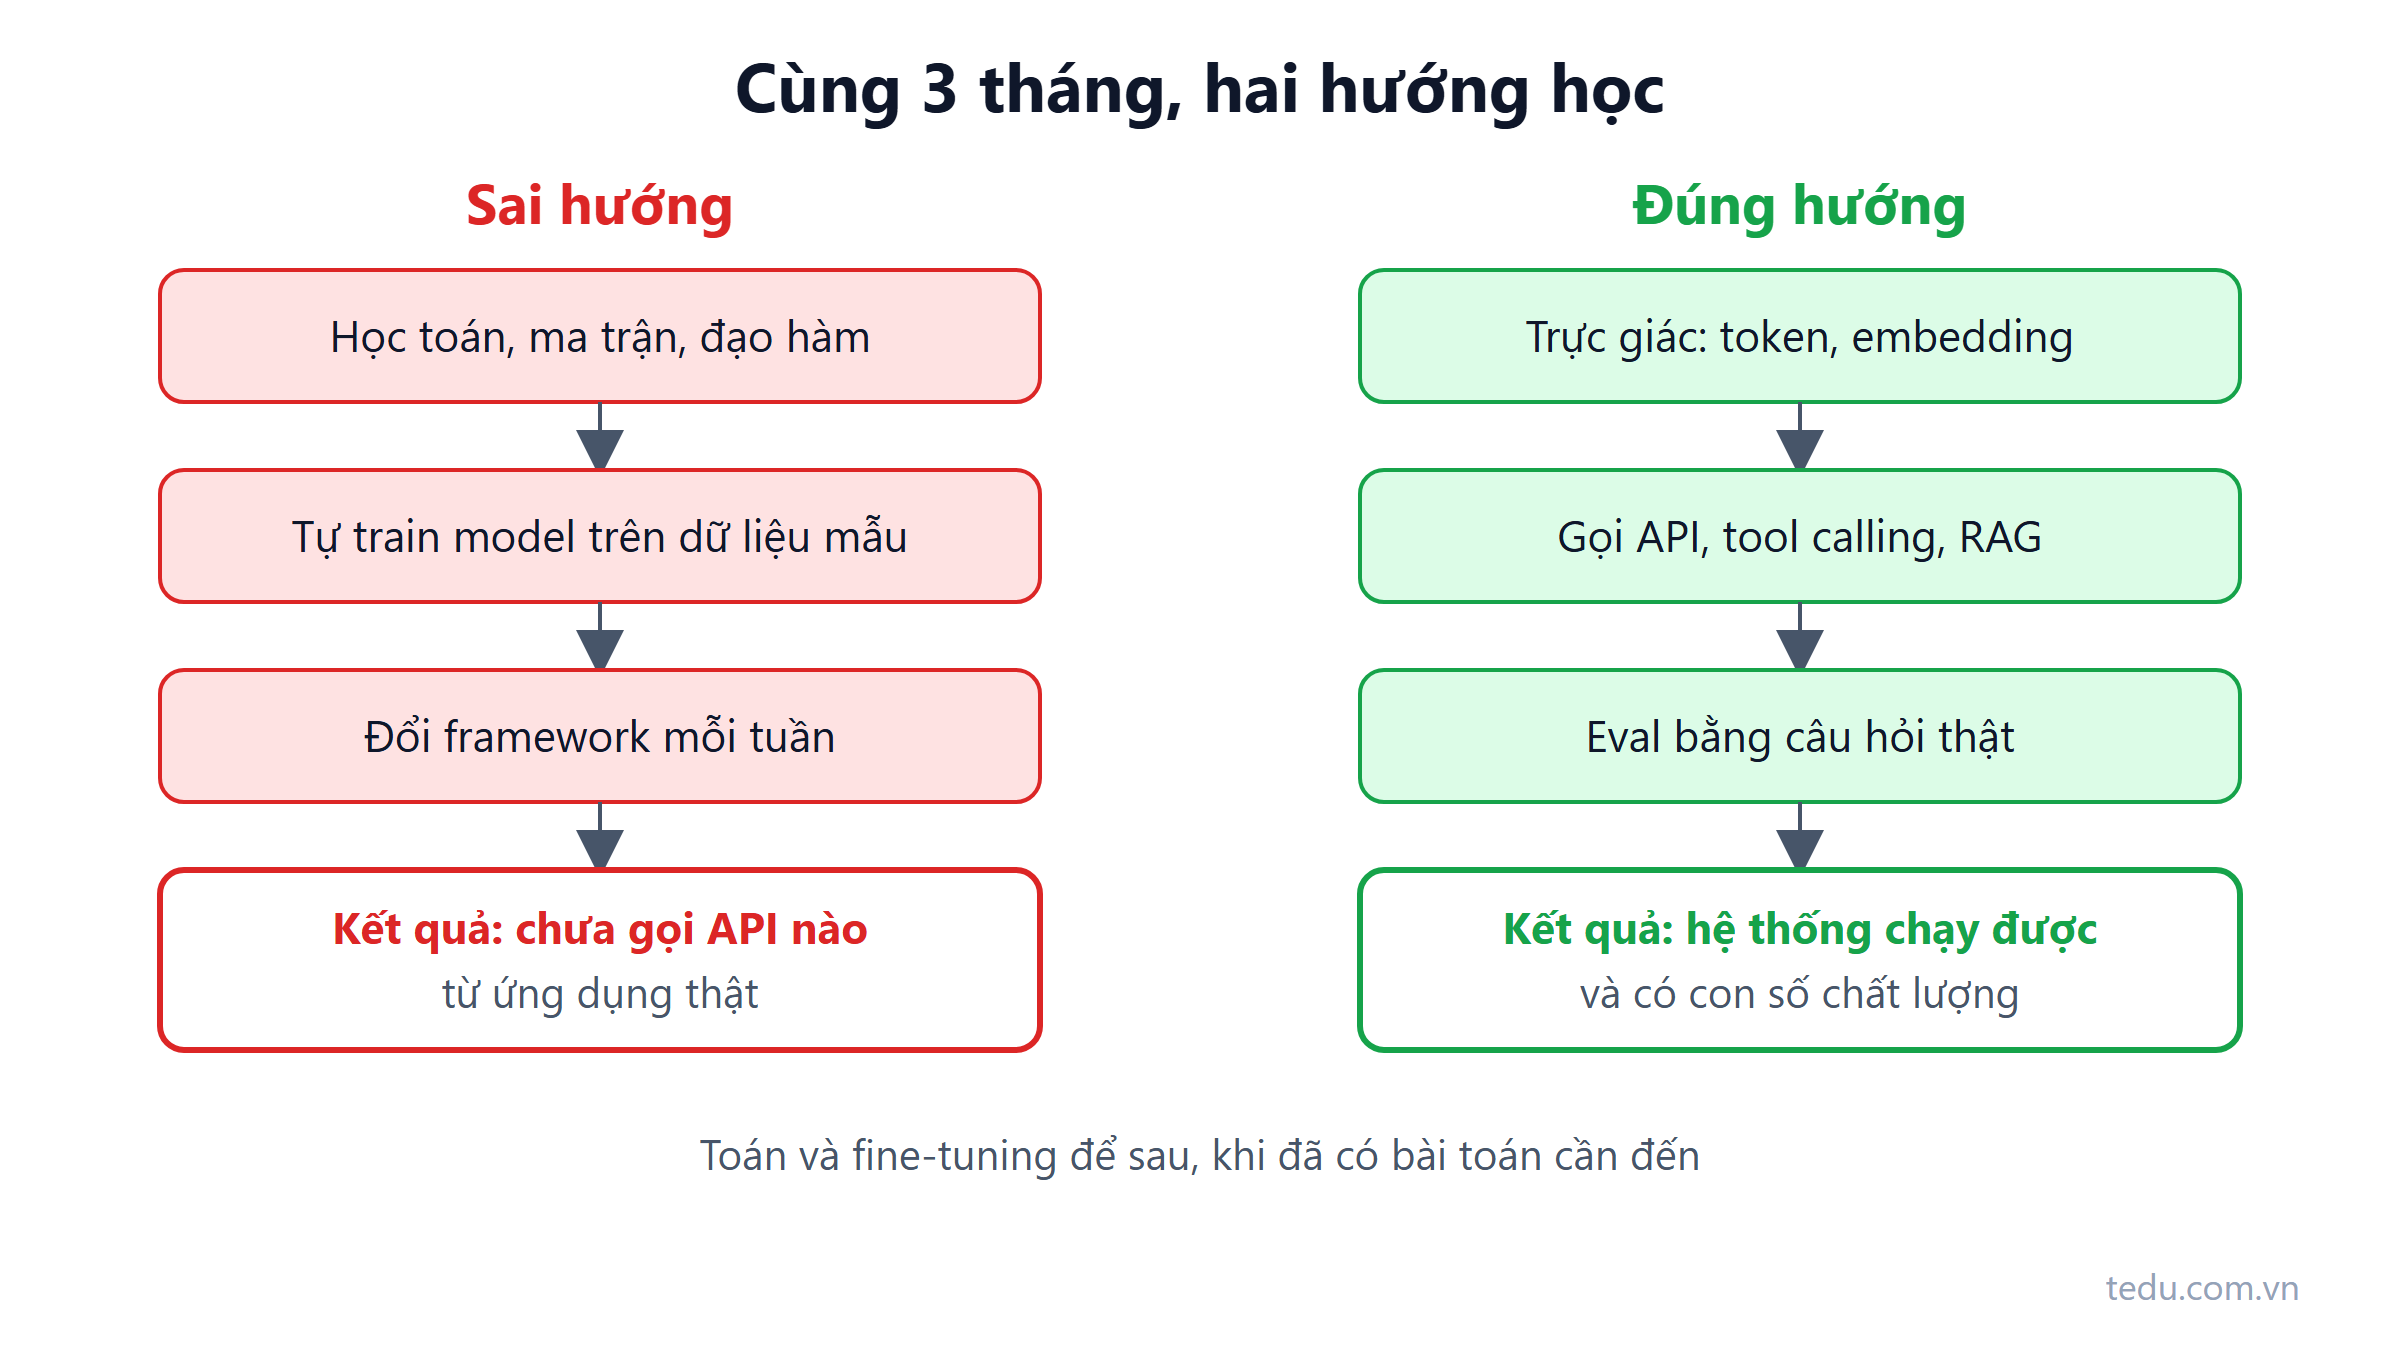
Một dev Java 6 năm kinh nghiệm quyết tâm chuyển sang AI. Tháng đầu, anh mua sách đại số tuyến tính. Tháng thứ hai, anh cài PyTorch và huấn luyện một mạng neural nhận dạng chữ số viết tay. Tháng thứ ba, anh chuyển qua lại giữa ba framework agent vì mỗi tuần lại có một cái "hot" hơn. Hết quý, anh chưa gọi một LLM API nào từ ứng dụng thật, và bắt đầu nghĩ mình không hợp với AI.
Vấn đề không nằm ở năng lực. Vấn đề nằm ở hướng đi. Bài này phân tích 3 hiểu lầm khi học AI Engineer phổ biến nhất ở dev backend: phải học toán trước, phải biết train model, và phải theo kịp mọi framework. Với mỗi hiểu lầm, bạn sẽ thấy vì sao nó hấp dẫn, nó tốn bạn những gì, và nên học gì thay vào đó.
Vì sao dev backend hay học AI sai hướng
Phần lớn tài liệu "học AI" trên mạng được viết cho con đường Machine Learning truyền thống: thống kê, toán, huấn luyện model, rồi mới đến ứng dụng. Con đường đó đúng cho ML Engineer và nhà nghiên cứu. Nó không đúng cho người muốn làm AI Engineer, tức là người xây sản phẩm trên model có sẵn.
Thêm một yếu tố tâm lý: dev giỏi thường muốn hiểu "từ gốc". Đó là thói quen tốt khi học database hay hệ điều hành. Nhưng với AI, "gốc" sâu tới mức bạn có thể đào cả năm mà vẫn chưa chạm tới phần công việc người ta trả lương.
Hiểu lầm 1: Phải học toán trước rồi mới làm AI
Vì sao nghe hợp lý
LLM được xây trên đại số tuyến tính, giải tích và xác suất. Các khóa ML kinh điển mở đầu bằng ma trận và đạo hàm. Từ đó dễ suy ra: không có toán thì không làm AI được.
Thực tế công việc cần gì
AI Engineer dùng toán ở mức trực giác, không ở mức tính toán. So sánh hai cách hiểu cùng một khái niệm:
| Khái niệm | Hiểu ở mức toán | Hiểu ở mức AI Engineer cần |
|---|---|---|
| Embedding | Vector trong không gian nhiều chiều, học qua hàm mất mát | Chữ được biến thành tọa độ, hai câu cùng nghĩa thì nằm gần nhau |
| Cosine similarity | Tích vô hướng chia tích độ dài hai vector | Con số càng gần 1 thì hai đoạn càng giống nghĩa, dùng để tìm tài liệu liên quan |
| Softmax, temperature | Chia logit cho T rồi chuẩn hóa thành phân phối | Temperature thấp thì model chọn từ "chắc ăn", cao thì đa dạng hơn và dễ lệch hơn |
| Attention | Q, K, V và phép nhân ma trận | Mỗi token "nhìn" các token khác để hiểu ngữ cảnh, và context dài làm sự chú ý bị loãng |
Cột thứ ba đủ để bạn ra quyết định thiết kế đúng: chọn temperature thấp cho chatbot tra cứu quy chế, không nhồi 200 trang tài liệu vào một prompt, dùng embedding để tìm đoạn văn liên quan. Bạn không cần tự tính đạo hàm để làm những việc đó.
Một phép thử đơn giản: nếu bạn đã dùng PostgreSQL nhiều năm mà chưa đọc lý thuyết đại số quan hệ, bạn vẫn viết được query tốt. Với LLM cũng vậy.
Khi nào toán thật sự cần
Toán trở nên hữu ích khi bạn đọc paper để chọn kỹ thuật mới, khi fine-tune model và cần hiểu vì sao loss không giảm, hoặc khi chuyển hẳn sang hướng ML Engineer. Đó là giai đoạn sau, và lúc đó bạn đã có ngữ cảnh để học toán có mục đích thay vì học suông.
Thay vào đó: học trực giác về cách LLM hoạt động (đoán token tiếp theo), token, embedding, context window. Mỗi khái niệm một buổi tối, kèm một thí nghiệm nhỏ bằng code.
Hiểu lầm 2: Phải biết train model mới gọi là làm AI
Vì sao nghe hợp lý
"AI" trong đầu nhiều người gắn với hình ảnh huấn luyện: dữ liệu, GPU, epoch, độ chính xác tăng dần. Tự train một model cảm giác "thật" hơn là gọi API của người khác.
Chi phí thật của việc tự train
Lấy bài toán phổ biến nhất ở doanh nghiệp: chatbot trả lời câu hỏi về quy chế nhân sự. Một dev nghĩ: "Mình sẽ fine-tune model trên bộ quy chế để nó thuộc lòng". Hãy xem điều gì xảy ra:
| Tiêu chí | Fine-tune model trên quy chế | Dùng model có sẵn + RAG |
|---|---|---|
| Chuẩn bị | Cần hàng trăm, hàng nghìn cặp hỏi đáp mẫu chất lượng | Cần file quy chế gốc |
| Quy chế đổi tháng sau | Phải tạo lại dữ liệu và train lại | Cập nhật file, index lại |
| Dẫn nguồn điều khoản | Khó, model không biết câu trả lời lấy từ đâu | Dễ, biết đoạn nào được đưa vào prompt |
| Phân quyền theo phòng ban | Gần như không làm được, kiến thức đã nằm trong model | Lọc tài liệu theo quyền trước khi đưa vào prompt |
| Model vẫn có thể bịa | Có | Có, nhưng ít hơn và kiểm tra được |
Trong phần lớn bài toán "cho model biết dữ liệu công ty", RAG và context tốt thắng fine-tuning trên gần như mọi dòng. Đây là lý do tin tuyển dụng AI Engineer hỏi về RAG, eval, tool calling nhiều hơn hỏi về huấn luyện.
Khi nào train hoặc fine-tune có lý
Fine-tuning có chỗ đứng: ép model theo một định dạng đầu ra rất cố định, phân loại văn bản với model nhỏ để giảm chi phí, hoặc khi dữ liệu không được phép rời khỏi mạng nội bộ và phải chạy model nhỏ tự host. Các bài về pre-training, fine-tuning, RLHF và LoRA trong series sẽ đi vào chi tiết. Điểm chính: đó là công cụ chuyên biệt dùng sau khi prompt, context và RAG đã không đủ, không phải bước đầu tiên.
Thay vào đó: học cách gọi API, quản lý context, dựng RAG trên tài liệu thật, và đo chất lượng bằng bộ câu hỏi mẫu.
Hiểu lầm 3: Phải theo kịp mọi framework mới
Vì sao nghe hợp lý
Mỗi tuần lại có framework agent mới, thư viện RAG mới, "cách làm chuẩn" mới. Tin tuyển dụng ghi tên framework, video hướng dẫn dùng framework. Không học thì sợ lạc hậu. (Cảm giác này quen với dev JavaScript từ mười năm trước.)
Framework bọc cái gì bên trong
Gần như mọi framework LLM đều bọc quanh cùng vài cơ chế: một HTTP request gửi danh sách message, một vòng lặp xử lý tool call, một bước tìm tài liệu. Khi hiểu cơ chế, bạn đọc framework nào cũng nhanh. Khi chỉ biết framework, bạn kẹt mỗi khi nó đổi API hoặc gặp lỗi mà tài liệu không nói.
Đây là toàn bộ "phép màu" của một lời gọi LLM, viết bằng HttpClient thuần. Endpoint, tên model và tên field là minh họa theo dạng chung; mỗi nhà cung cấp đặt tên hơi khác, hãy đối chiếu tài liệu của bên bạn dùng:
using System.Net.Http.Json;
using System.Text.Json;

var http = new HttpClient();
http.DefaultRequestHeaders.Add("Authorization",
    $"Bearer {Environment.GetEnvironmentVariable("LLM_API_KEY")}");

var request = new
{
    model = "ten-model-cua-ban",
    temperature = 0.2,
    messages = new object[]
    {
        new { role = "system", content = "Bạn là trợ lý CSKH của shop. Trả lời ngắn gọn." },
        new { role = "user", content = "Shop có cho đổi size trong 7 ngày không?" }
    }
};

var resp = await http.PostAsJsonAsync("https://dia-chi-api-cua-ban/v1/chat", request);
resp.EnsureSuccessStatusCode();

using var doc = JsonDocument.Parse(await resp.Content.ReadAsStringAsync());
Console.WriteLine(doc.RootElement.ToString()); // xem cấu trúc response, tìm phần text và usage
Hai mươi dòng. Mọi framework đều bắt đầu từ đây rồi thêm retry, streaming, tool calling, lưu lịch sử. Nếu bạn tự viết được agent loop trong khoảng 30 dòng code, bạn sẽ thấy framework agent chỉ là lớp tiện ích quanh cùng vòng lặp đó.
Cách chọn framework khi thật sự cần
Framework vẫn có ích khi dự án lớn dần. Lúc chọn, hỏi bốn câu:
Nó giải quyết vấn đề gì mà 50 dòng code tự viết không giải quyết được?
Khi có lỗi, bạn có xem được request thật gửi tới model không?
Nó có khóa bạn vào một nhà cung cấp model không?
Nếu bỏ nó sau 6 tháng, phải viết lại bao nhiêu code?
Thay vào đó: học cơ chế bằng code thuần trước, chọn framework sau khi đã biết mình cần gì ở nó.
Học đúng hướng trông như thế nào: kế hoạch 4 tuần
Dưới đây là một kế hoạch mẫu cho dev backend có khoảng 1–2 giờ mỗi tối. Không phải lộ trình duy nhất, nhưng mỗi tuần đều kết thúc bằng thứ chạy được và đo được:
| Tuần | Học | Làm ra |
|---|---|---|
| 1 | Token, context window, temperature, cấu trúc request | Console app gọi LLM, in số token, thử 3 mức temperature trên cùng câu hỏi |
| 2 | Structured output, tool calling | Bot tra trạng thái đơn hàng giả lập: model gọi tool, app chạy SQL |
| 3 | Embedding, RAG cơ bản, pgvector | Hỏi đáp trên 10 file quy chế, câu trả lời kèm nguồn |
| 4 | Eval | 50 câu hỏi mẫu, script chấm điểm, so trước và sau khi sửa prompt |
Không có tuần nào dành cho đạo hàm hay huấn luyện model. Cũng không có tuần nào dành cho việc so sánh năm framework.
Checklist: bạn có đang học sai hướng không?
Đã học hơn 2 tuần mà chưa gọi LLM API từ code của mình.
Đang huấn luyện model trên bộ dữ liệu mẫu không liên quan tới công việc thật.
Biết dùng framework X nhưng không giải thích được request nó gửi đi trông thế nào.
Chưa có một con số nào đo chất lượng cho thứ mình đã làm.
Mỗi tuần đổi công cụ một lần vì "cái mới tốt hơn".
Tích từ 2 dòng trở lên, hãy quay về kế hoạch 4 tuần ở trên.
Tóm lại
Ba hiểu lầm có chung một gốc: lấy lộ trình của ML Engineer để học nghề AI Engineer. Toán ở mức trực giác là đủ để bắt đầu, train model là công cụ chuyên biệt chứ không phải bước đầu, và framework dễ học khi bạn đã hiểu cơ chế. Bản đồ đầy đủ các tầng cần học nằm ở bài AI Engineer cần học gì.
Bài tiếp theo trong series bắt đầu phần kỹ thuật: LLM hoạt động thế nào, và vì sao nó chỉ làm đúng một việc là đoán token tiếp theo.
Xem bản tóm tắt dưới một phút trên YouTube @teduco hoặc TikTok @teducolabs, và đọc thêm các bài khác trong chuyên mục AI Engineer.
Bài viết liên quan
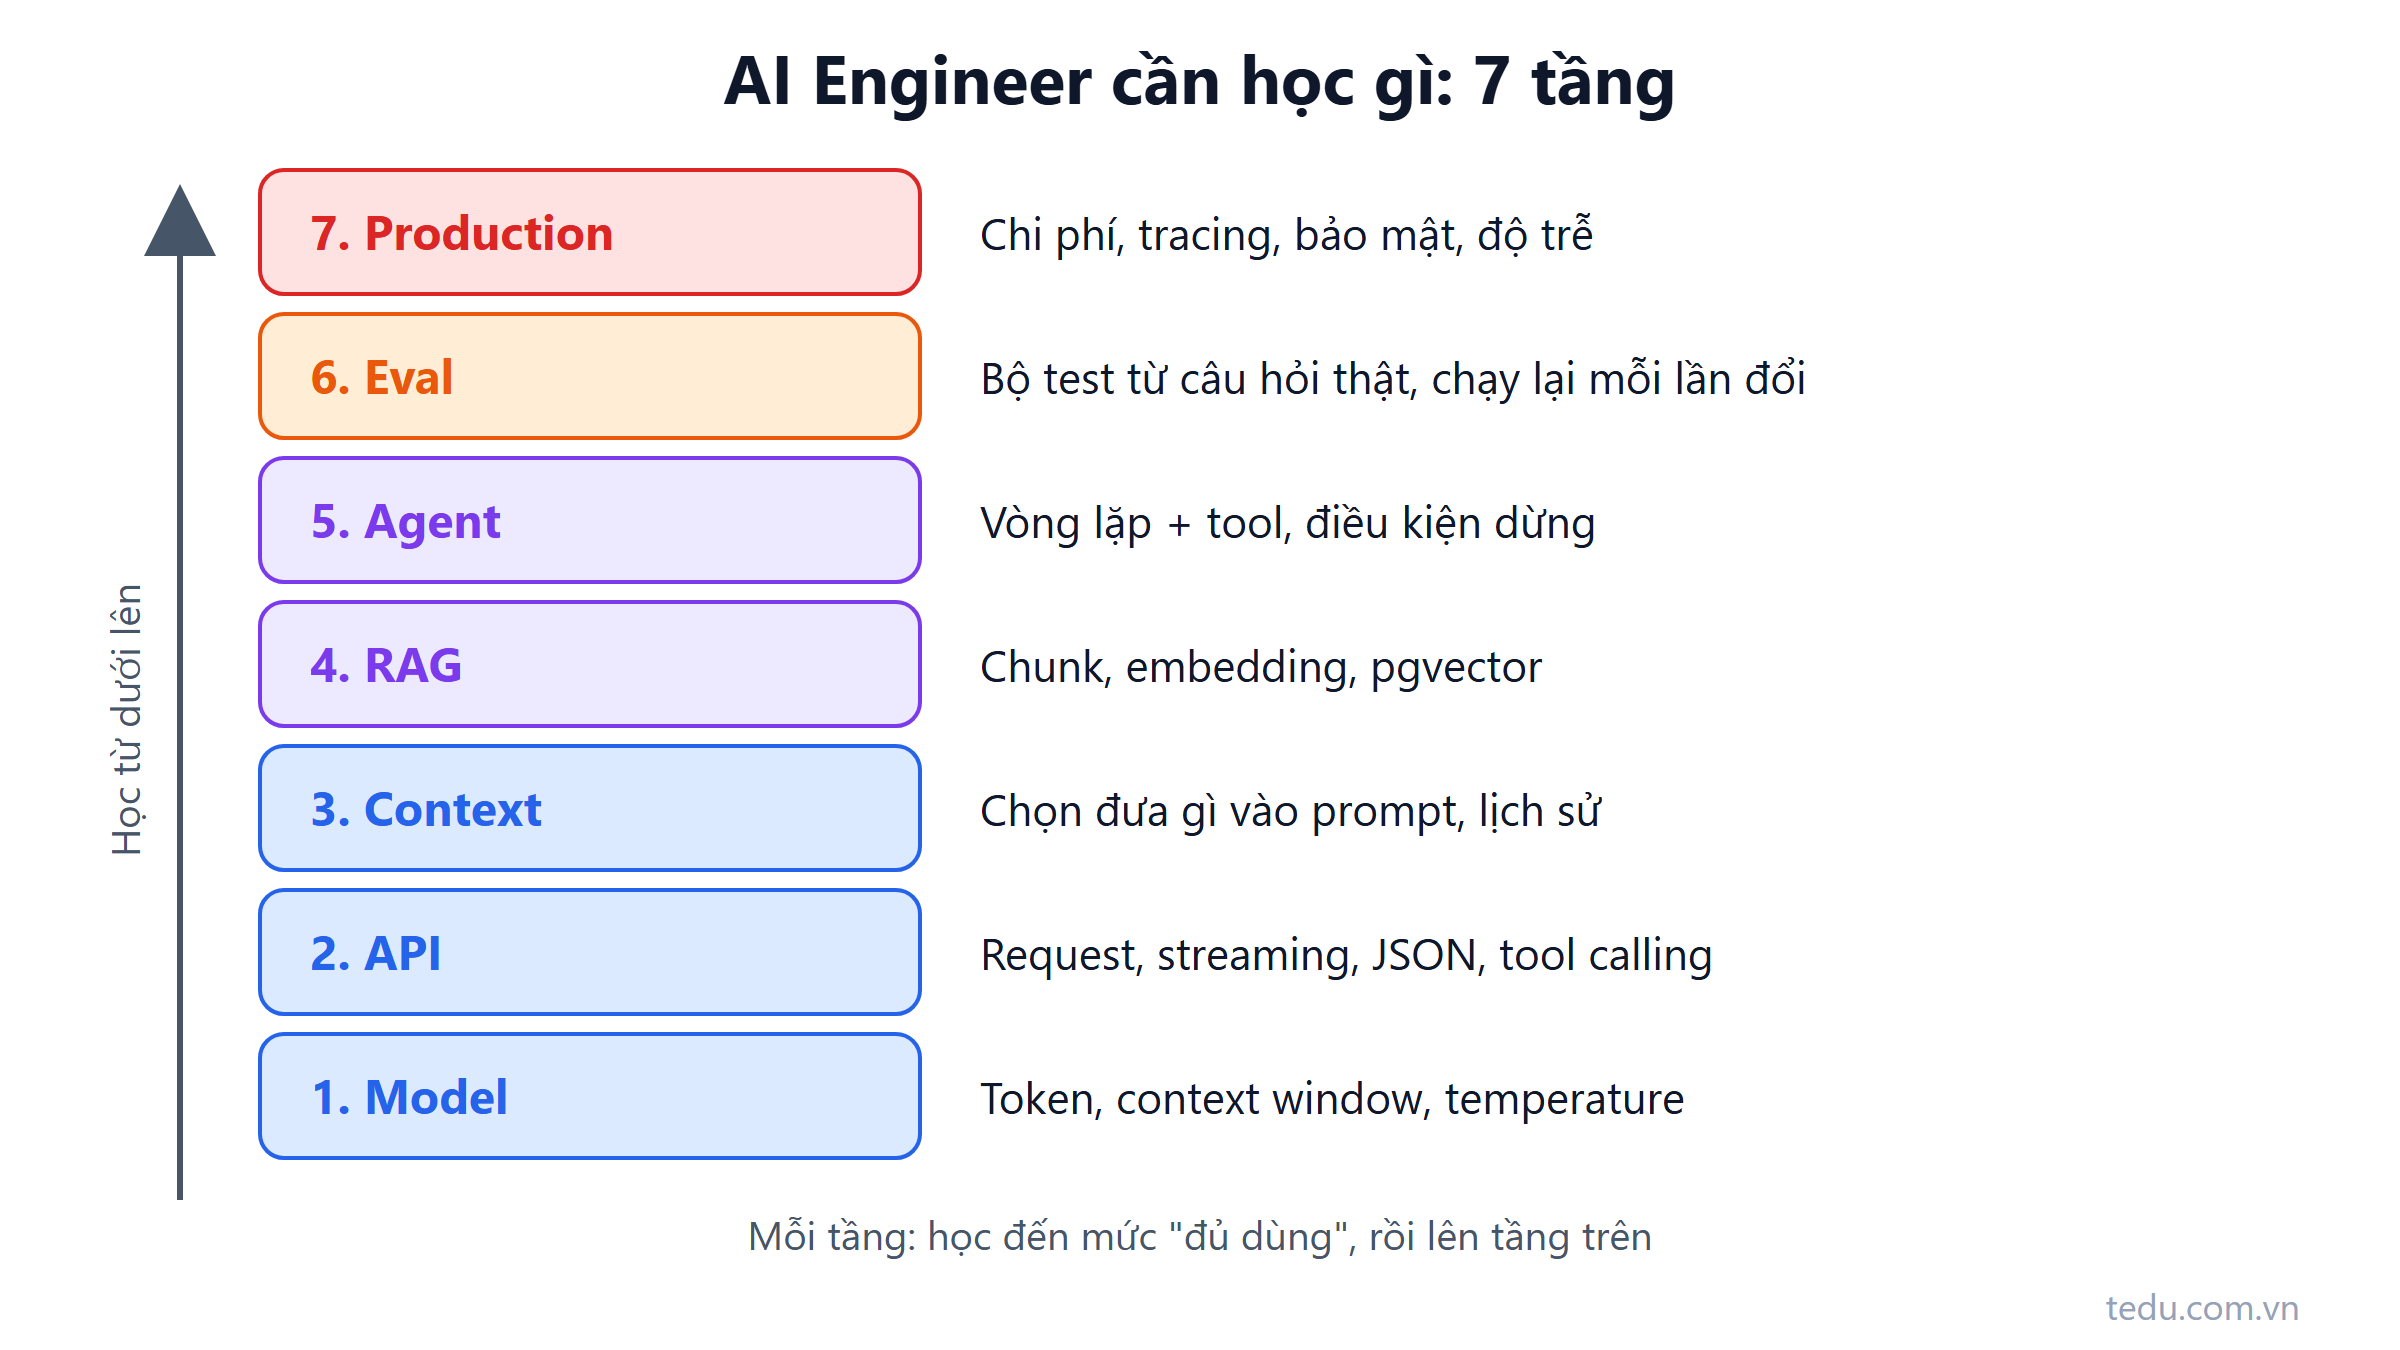
AI Engineer cần học gì? Bản đồ từ Model đến Production
Checklist kỹ năng AI Engineer theo 7 tầng từ Model đến Production, mỗi tầng có phần đủ dùng và phần chưa cần học, dành cho backend developer.
Đọc thêm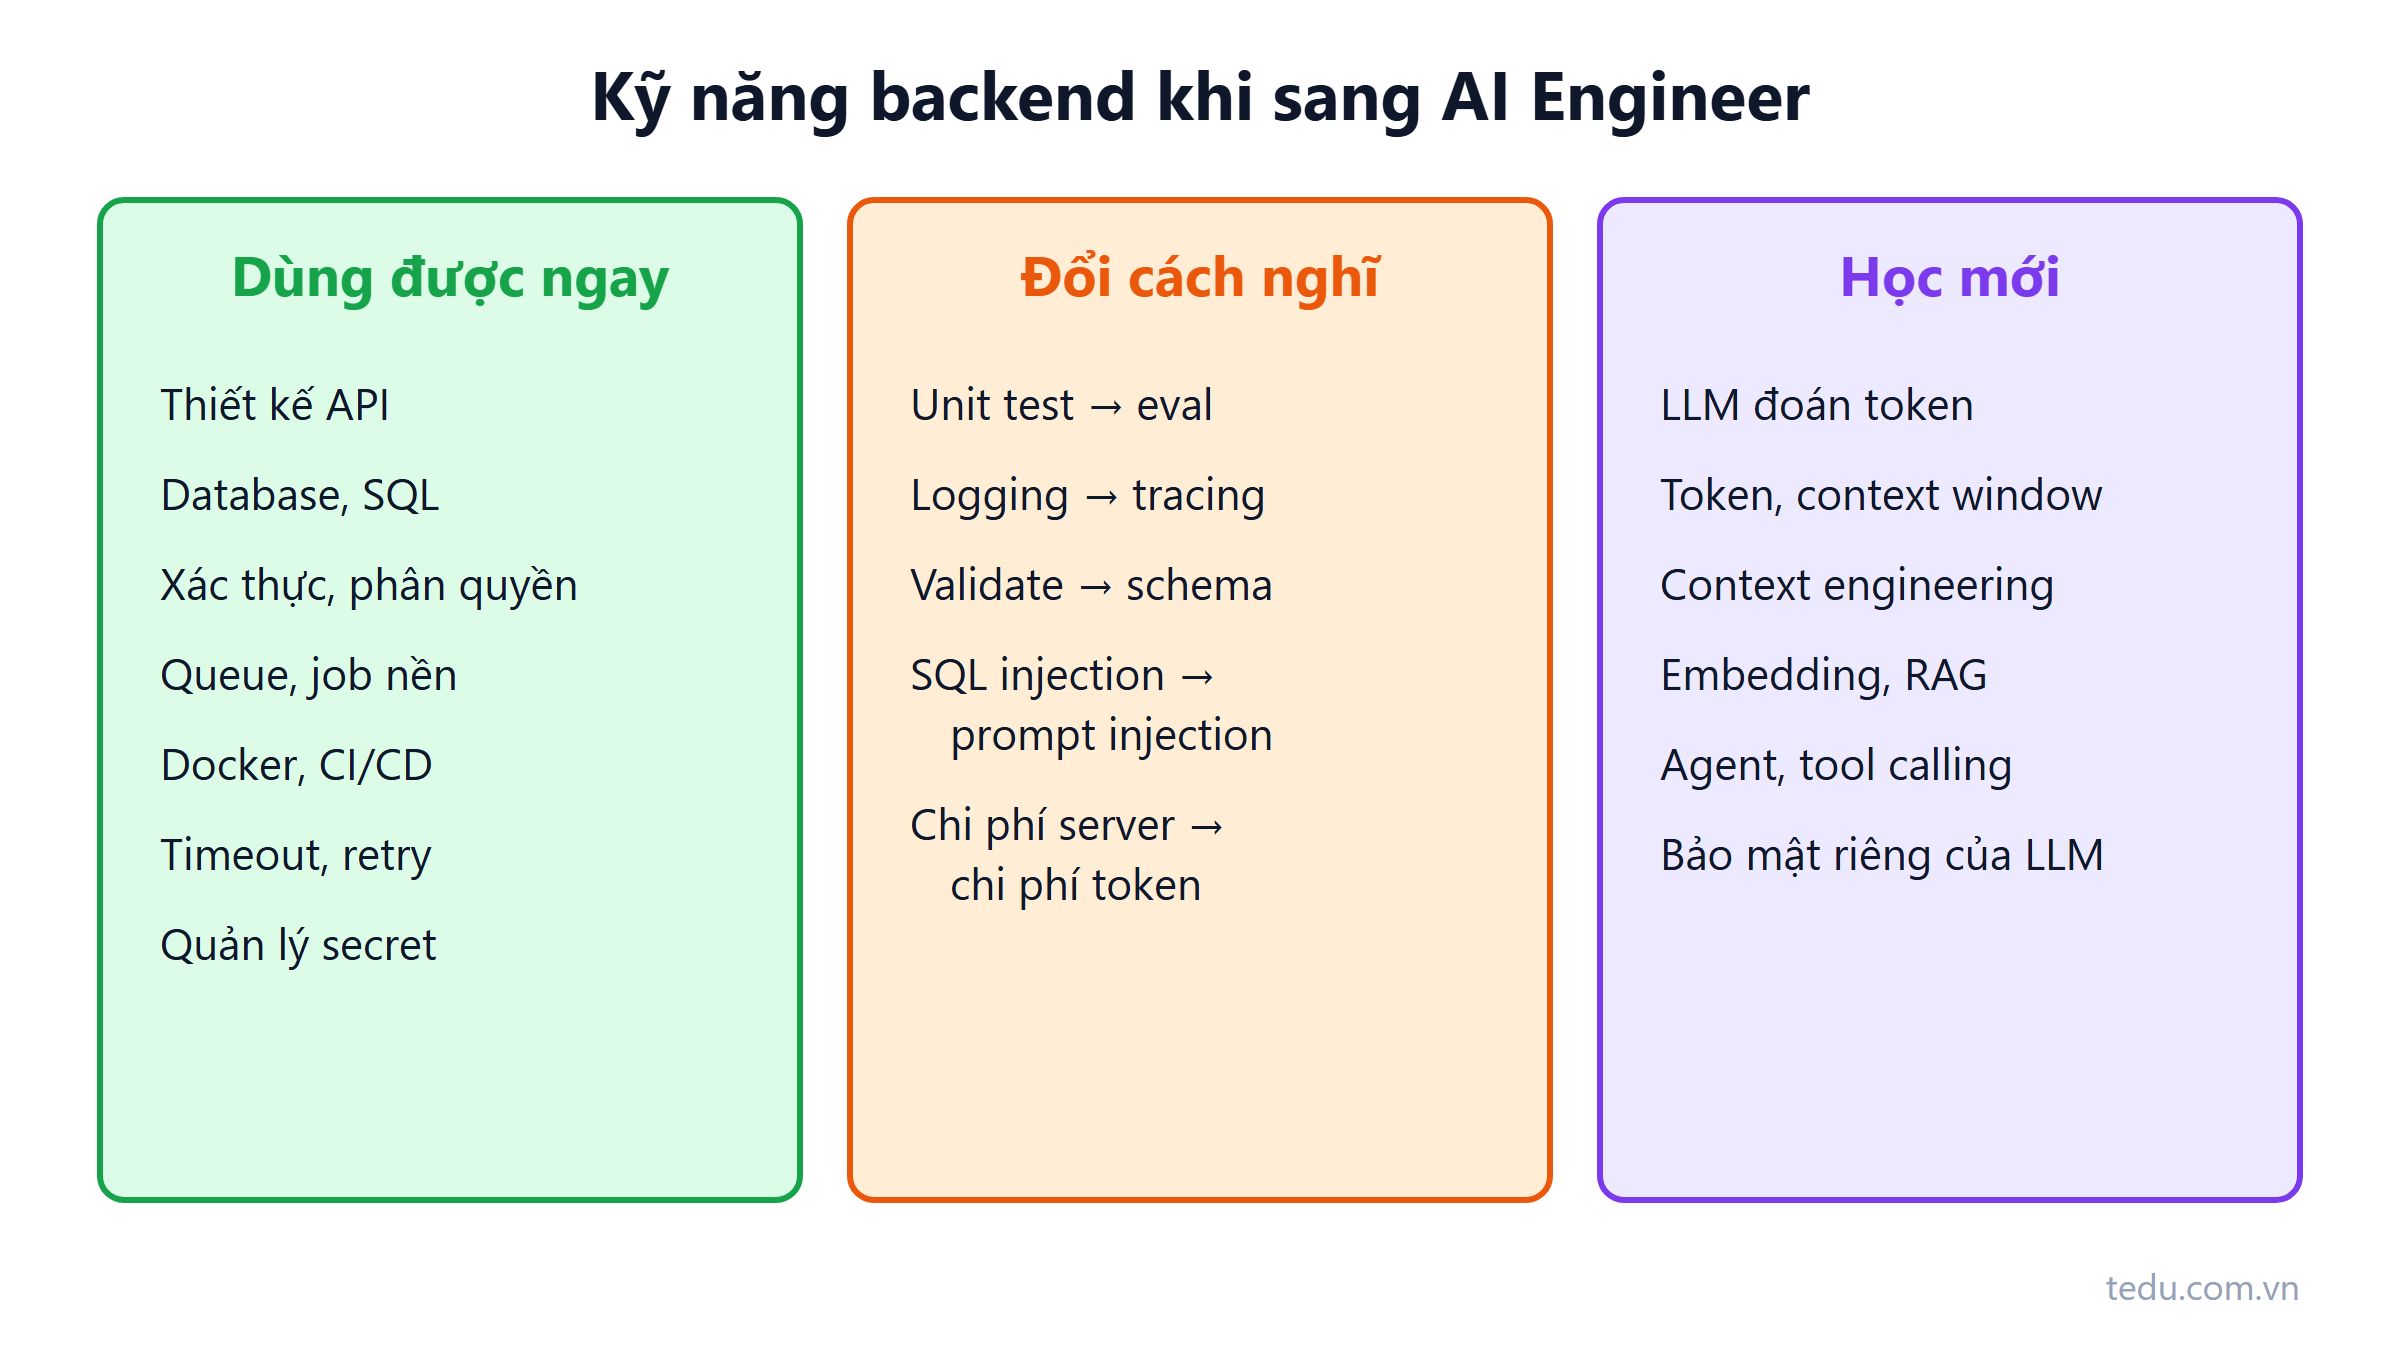
Backend Developer sang AI Engineer: đã có sẵn 70% kỹ năng
Dev backend chuyển sang AI Engineer không phải học lại từ đầu. Bài liệt kê kỹ năng đã dùng được ngay, kỹ năng cần đổi cách nghĩ và phần còn thiếu cần bù.
Đọc thêm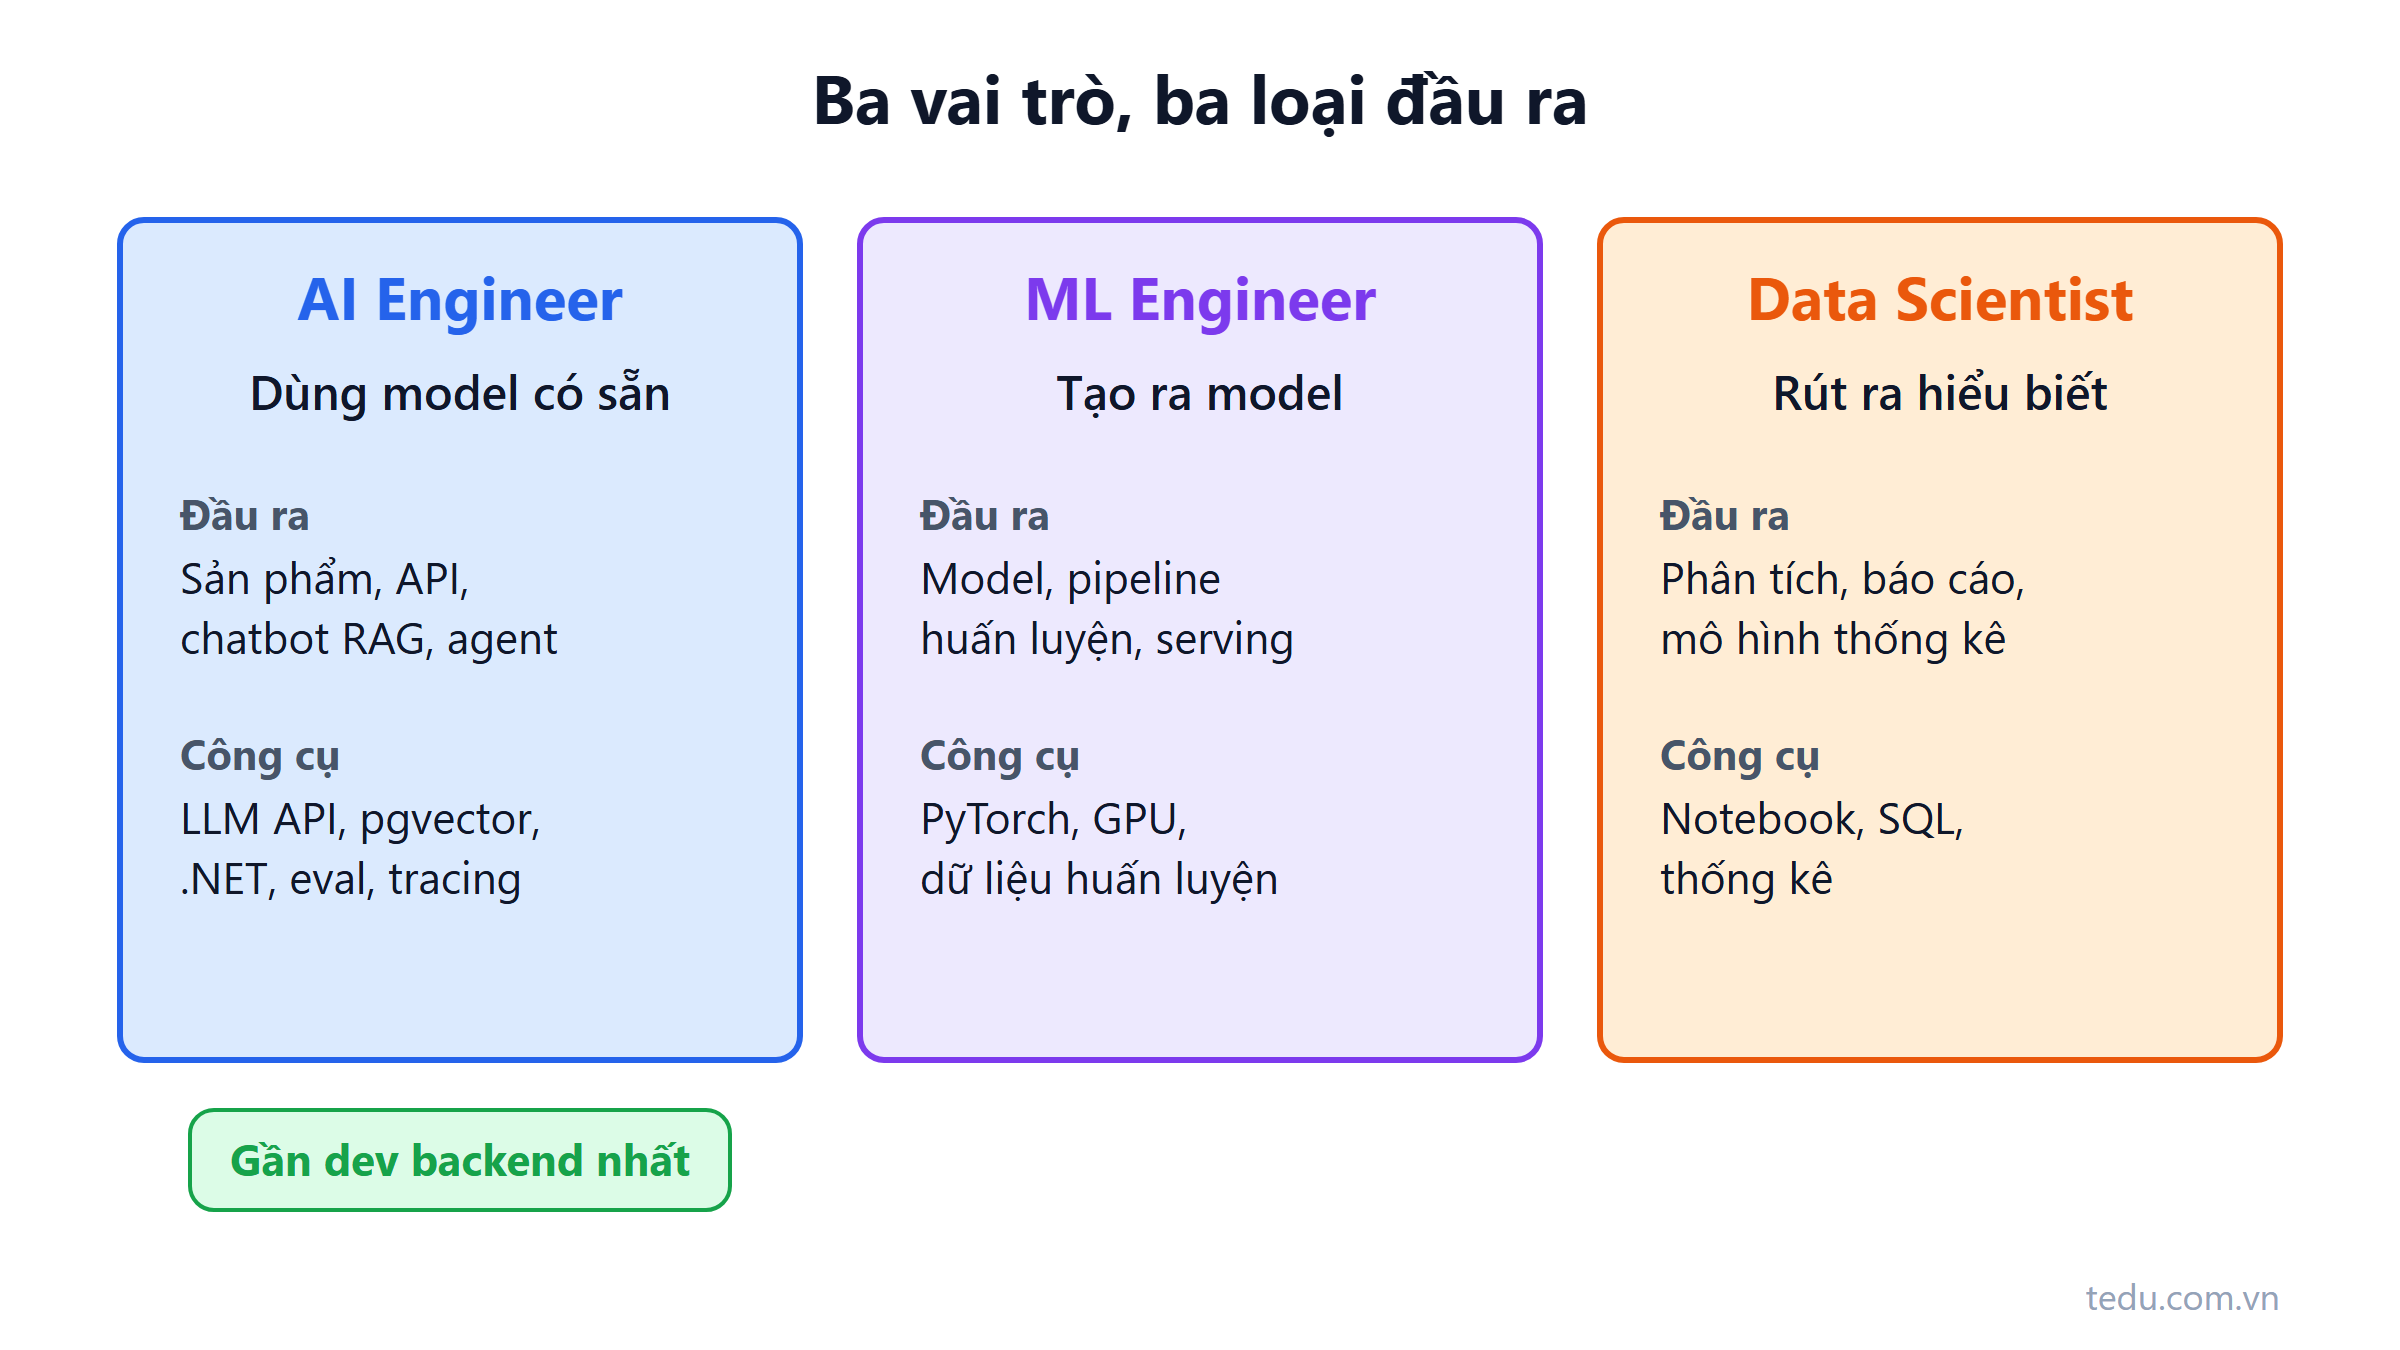
AI Engineer là gì? Khác ML Engineer ở đâu
AI Engineer là kỹ sư xây ứng dụng bằng model AI có sẵn qua API. Bài này giải thích công việc hằng ngày và điểm khác với ML Engineer, Data Scientist.
Đọc thêm