

LLM hoạt động thế nào? Chỉ đoán token tiếp theo
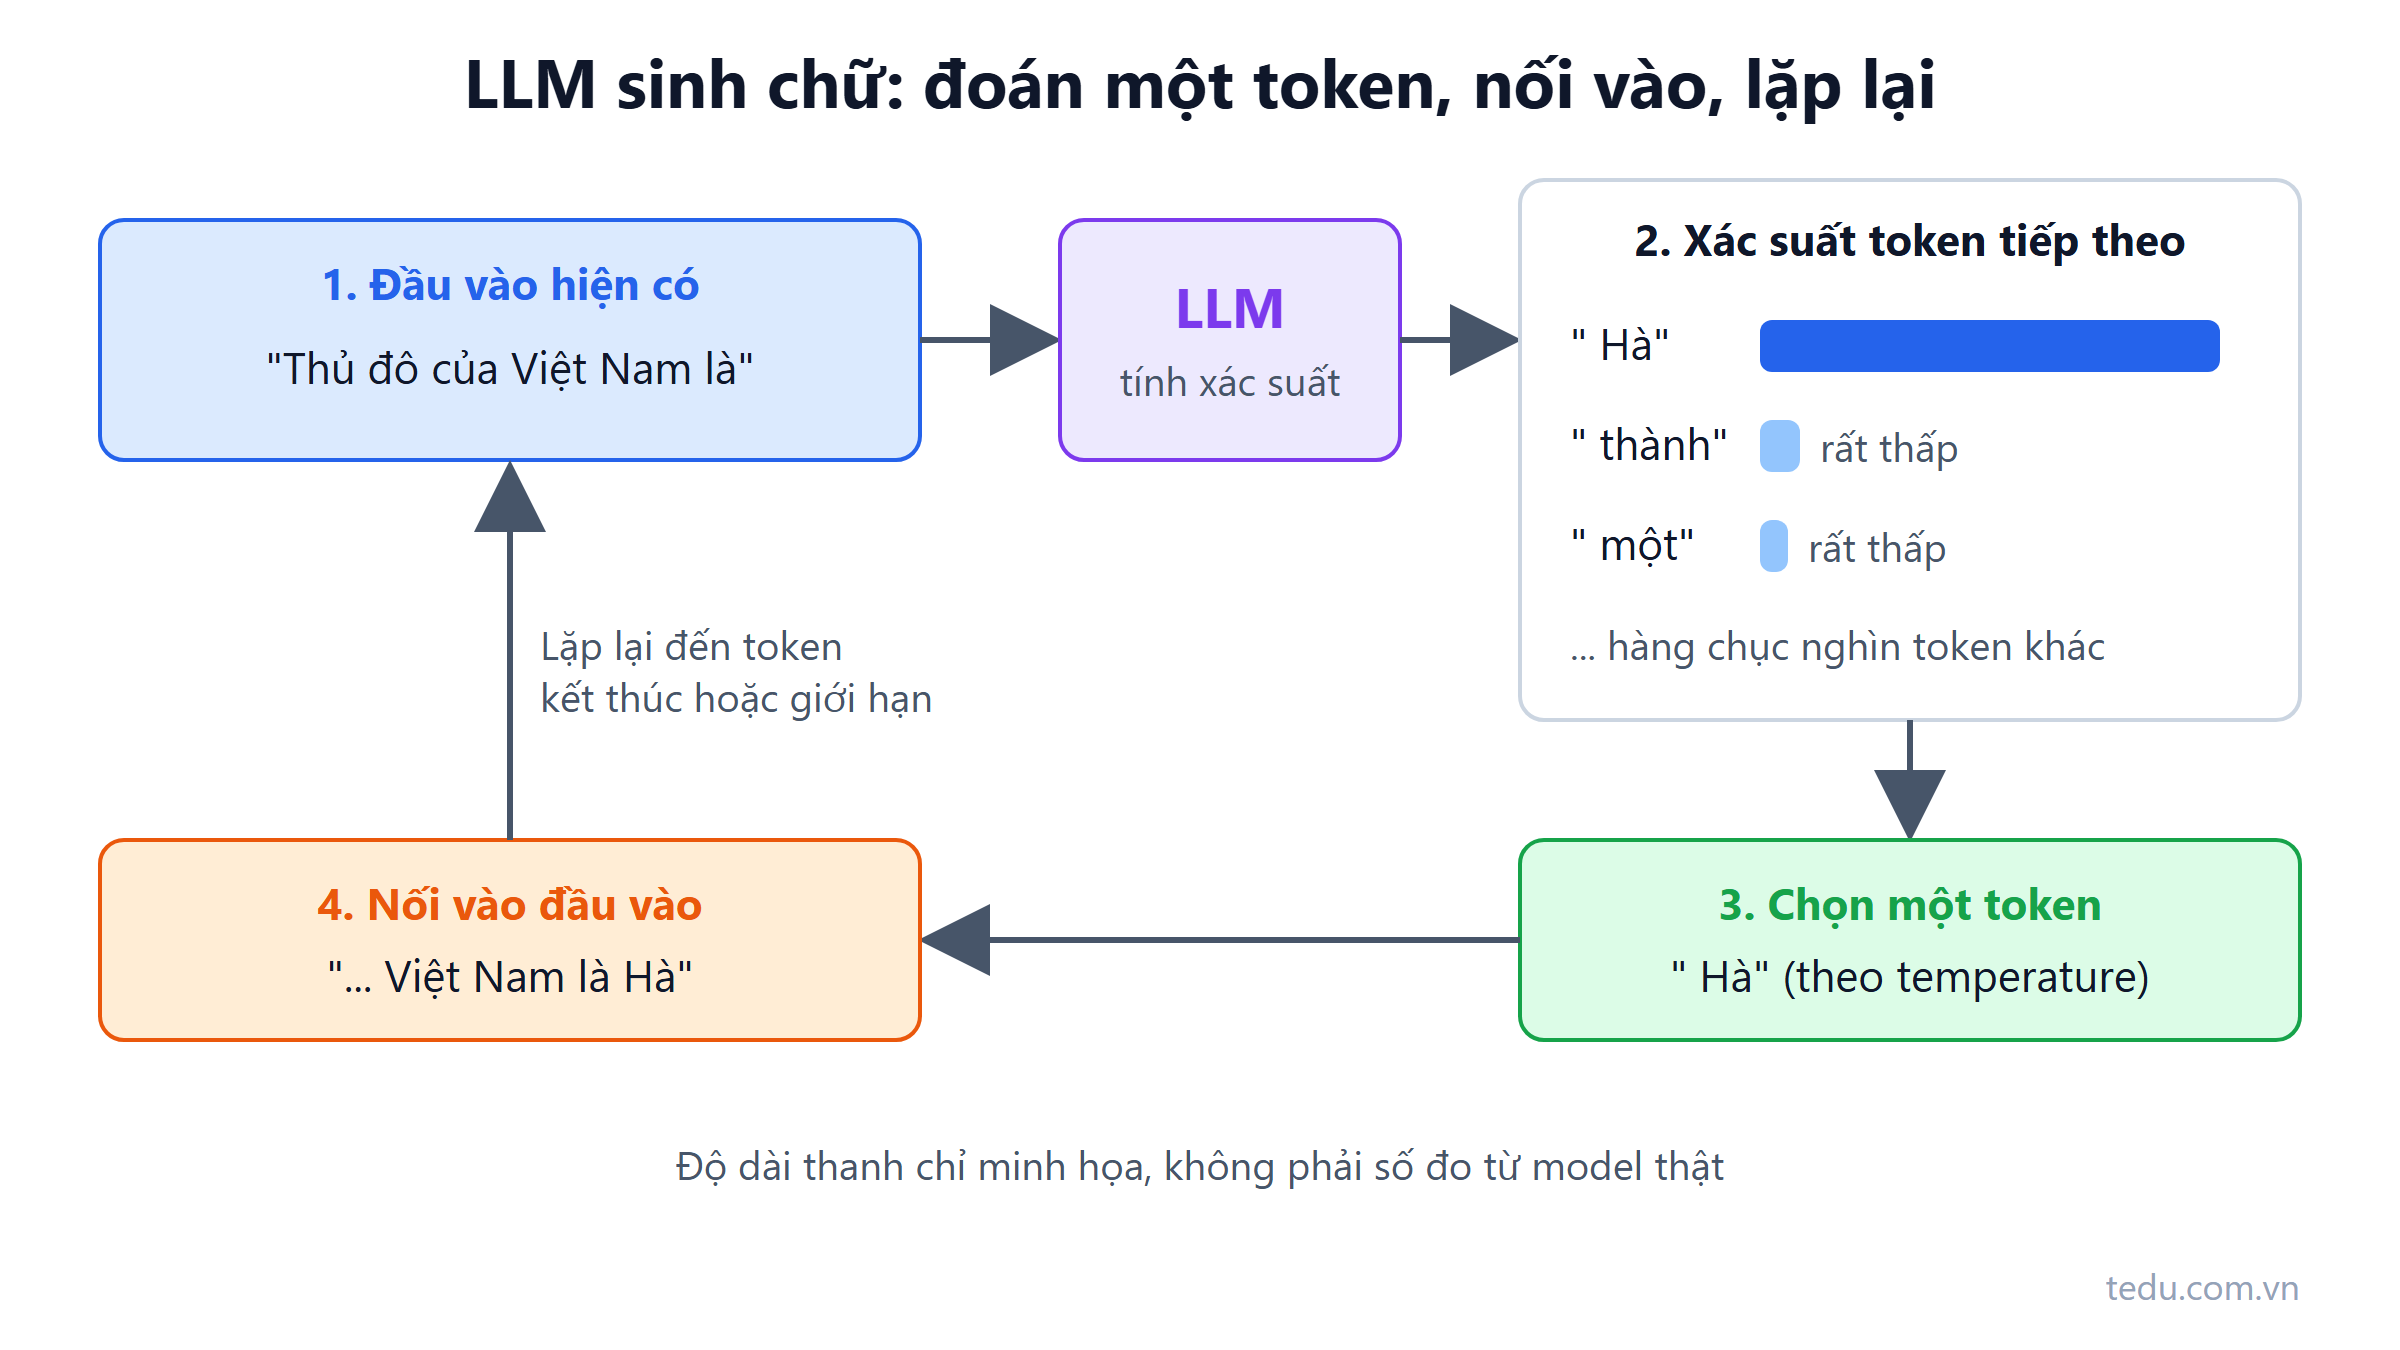
Bàn phím điện thoại của bạn có tính năng gợi ý từ. Gõ "em đang", nó gợi ý "làm", "ở", "đi". Bấm liên tục vào gợi ý đầu tiên, bạn sẽ có một câu đọc được nhưng hơi vô nghĩa. Bây giờ hãy tưởng tượng bàn phím đó được huấn luyện trên một lượng văn bản khổng lồ, đủ để gợi ý ra cả một email xin nghỉ phép, một đoạn code C#, một bản tóm tắt hợp đồng. Đó gần như là toàn bộ câu trả lời cho câu hỏi LLM hoạt động thế nào.
LLM (large language model) chỉ làm đúng một việc: nhìn vào đoạn văn bản hiện có và đoán token tiếp theo. Mọi thứ khác bạn thấy, từ trả lời câu hỏi đến viết code hay gọi tool, đều xây trên việc đó lặp đi lặp lại. Bài này giải thích cơ chế ở mức dev cần biết, và quan trọng hơn: cơ chế này kéo theo những hệ quả gì khi bạn đưa LLM vào hệ thống thật.
LLM hoạt động thế nào: đoán token tiếp theo
Trước hết, model không đọc chữ như bạn. Văn bản được cắt thành các mảnh gọi là token, mỗi token ứng với một con số. Một token có thể là cả từ, một phần của từ hoặc vài ký tự.
Với một dãy token đầu vào, model trả ra một bảng xác suất cho mọi token nó biết (thường hàng chục nghìn đến vài trăm nghìn token). Ví dụ minh họa với đầu vào "Thủ đô của Việt Nam là":
| Token ứng viên | Xác suất (minh họa) |
|---|---|
| " Hà" | 0,92 |
| " thành" | 0,03 |
| " một" | 0,02 |
| " TP" | 0,01 |
| (hàng chục nghìn token khác) | phần còn lại |
Các con số trên là minh họa để thấy hình dạng của kết quả, không phải số đo từ model thật. Điểm cần nhớ: model không trả về "câu trả lời". Nó trả về một phân phối xác suất, và một bước khác (gọi là sampling) chọn ra một token từ phân phối đó.
Token được chọn ("Hà") được nối vào cuối đầu vào. Đầu vào mới là "Thủ đô của Việt Nam là Hà". Model chạy lại, đoán token tiếp theo (" Nội"), nối vào, chạy lại. Vòng lặp dừng khi model sinh ra một token đặc biệt báo kết thúc, hoặc khi chạm giới hạn số token đầu ra bạn đặt.
Vòng lặp sinh chữ, viết bằng code
Nếu viết vòng lặp đó bằng C#, nó trông như sau. Đây là mã giả để hiểu cơ chế: Tokenizer, Model.PredictNext và Sample là tên minh họa, bạn không gọi chúng trực tiếp khi dùng API, nhà cung cấp chạy vòng lặp này trên máy chủ của họ.
List<int> tokens = Tokenizer.Encode(prompt);
var output = new List<int>();

for (int step = 0; step < maxTokens; step++)
{
    // 1. Model nhìn TOÀN BỘ dãy token hiện có, trả về xác suất cho mọi token
    float[] probabilities = Model.PredictNext(tokens);

    // 2. Chọn một token theo xác suất (temperature, top-p ảnh hưởng ở bước này)
    int next = Sample(probabilities, temperature);

    // 3. Gặp token kết thúc thì dừng
    if (next == Tokenizer.EndOfText) break;

    // 4. Nối vào và lặp lại
    tokens.Add(next);
    output.Add(next);
}

return Tokenizer.Decode(output);
Ba chi tiết trong vòng lặp này giải thích rất nhiều hành vi bạn sẽ gặp:
Mỗi bước chỉ sinh một token. Câu trả lời 500 token nghĩa là 500 lần chạy model. Đó là lý do câu trả lời dài thì chậm, và vì sao các ứng dụng chat hiển thị chữ hiện dần (streaming).
Mỗi bước nhìn lại toàn bộ đầu vào. Đầu vào càng dài, mỗi bước càng tốn tài nguyên. Giới hạn độ dài này chính là context window.
Bước chọn token có yếu tố ngẫu nhiên. Cùng một đầu vào, lần này chọn token xác suất 0,6, lần sau có thể chọn token xác suất 0,3. Hai câu trả lời bắt đầu khác nhau từ đó và càng đi càng xa.
Vậy vì sao chatbot "trả lời" được câu hỏi?
Nếu model chỉ viết tiếp văn bản, tại sao gõ câu hỏi lại nhận được câu trả lời mà không phải thêm năm câu hỏi khác viết tiếp?
Lý do thứ nhất: cuộc hội thoại được biến thành một đoạn văn bản có đánh dấu vai trò. Khi bạn gửi danh sách message gồm system, user, assistant qua API, phía nhà cung cấp ghép chúng thành một chuỗi dạng như sau (định dạng thật khác nhau theo model, đây là minh họa):
[system] Bạn là trợ lý CSKH của shop thời trang. Trả lời ngắn gọn, lịch sự.
[user] Shop có cho đổi size không ạ?
[assistant]
Model được yêu cầu viết tiếp sau dòng [assistant]. Văn bản "hợp lý nhất" ở vị trí đó là một câu trả lời của trợ lý CSKH.
Lý do thứ hai: sau giai đoạn đọc lượng lớn văn bản (pre-training), model được huấn luyện thêm trên các cuộc hội thoại mẫu và phản hồi của con người, để "viết tiếp hợp lý nhất" trùng với "trả lời hữu ích". Bài pre-training, fine-tuning, RLHF giải thích các giai đoạn này. Ở đây chỉ cần nhớ: dù được huấn luyện thêm thế nào, cơ chế lúc chạy vẫn là đoán token tiếp theo.
Hệ quả cho dev: giải thích hành vi kỳ lạ bằng một cơ chế
Đây là phần đáng tiền nhất của bài. Rất nhiều "lỗi" bạn gặp khi làm ứng dụng LLM thực ra là hệ quả trực tiếp của cơ chế đoán token:
| Hành vi bạn thấy | Giải thích bằng cơ chế | Việc nên làm |
|---|---|---|
| Hỏi hai lần, hai câu trả lời khác nhau | Bước sampling có ngẫu nhiên | Giảm temperature cho tác vụ cần ổn định, test nhiều lần thay vì một lần |
| Trả lời trôi chảy nhưng sai sự thật | Model chọn token "nghe hợp lý", không có bước kiểm tra sự thật | Đưa dữ liệu thật vào context (RAG), cho phép trả lời "không tìm thấy" |
| Đếm sai số chữ cái, cộng sai số lớn | Model nhìn token, không nhìn từng ký tự hay chữ số | Giao phép tính, đếm, so sánh cho code qua tool calling |
| Không biết chính sách mới của công ty | Model chỉ biết dữ liệu tới thời điểm huấn luyện | Đưa tài liệu hiện hành vào prompt |
| Câu trả lời bị cụt giữa chừng | Chạm giới hạn số token đầu ra | Tăng giới hạn hoặc yêu cầu trả lời ngắn hơn, theo dõi lý do dừng trong response |
| Trả lời dài thì chậm và đắt | Mỗi token đầu ra là một bước chạy model | Yêu cầu định dạng gọn, đặt giới hạn đầu ra |
Dòng thứ hai đáng nói thêm. Model không có "chế độ nói dối". Khi bạn hỏi về điều khoản số 15 trong quy chế công ty mà nó chưa từng đọc, token "hợp lý nhất" tiếp theo vẫn là một đoạn văn trông giống điều khoản quy chế. Không có cơ chế nào bên trong dừng lại và nói "tôi không biết", trừ khi context và chỉ dẫn khiến câu "tôi không biết" trở thành phần viết tiếp hợp lý nhất. Bài vì sao model bịa đi sâu hơn vào chuyện này.
Prompt tệ và prompt tốt, nhìn bằng con mắt "đoán tiếp"
Hiểu model đang viết tiếp văn bản, bạn sẽ thấy prompt không phải là "ra lệnh", mà là dựng phần đầu của một văn bản sao cho phần viết tiếp hợp lý nhất chính là thứ bạn cần.
Prompt tệ cho chatbot CSKH:
Trả lời khách hàng: "Đơn em giao chậm quá, hủy được không?"Phần viết tiếp "hợp lý" có thể là bất cứ thứ gì: một lời xin lỗi chung chung, một lời hứa hoàn tiền mà shop không có chính sách, thậm chí một đoạn hướng dẫn cách hủy đơn trên một sàn thương mại điện tử khác.
Prompt tốt hơn:
Bạn là nhân viên CSKH của shop thời trang ABC.
Chính sách hủy đơn: chỉ hủy được khi đơn chưa bàn giao cho đơn vị vận chuyển.
Trạng thái đơn #A1023: đã bàn giao vận chuyển ngày 18/11, dự kiến giao 21/11.
Quy tắc: không hứa hoàn tiền, không đưa thông tin ngoài dữ liệu trên.
Nếu không hủy được, giải thích ngắn và đề xuất từ chối nhận hàng khi shipper giao.

Khách: "Đơn em giao chậm quá, hủy được không?"
Trả lời:
Với đầu vào này, phần viết tiếp có xác suất cao nhất là một câu trả lời đúng chính sách, đúng trạng thái đơn. Bạn không làm model "thông minh hơn". Bạn chỉ thu hẹp không gian những gì "hợp lý để viết tiếp". Đây cũng là nền móng của context engineering ở các bài sau.
Bốn hiểu lầm phổ biến về LLM
"Model tra cứu database khi trả lời." Không. Khi chạy, model chỉ có trọng số đã học và đoạn văn bản bạn gửi. Nếu có tra cứu, đó là ứng dụng của bạn tra rồi đưa kết quả vào prompt.
"Model nhớ cuộc trò chuyện hôm qua." Không. Mỗi lần gọi là độc lập. Cảm giác "nhớ" đến từ việc ứng dụng gửi lại lịch sử.
"Temperature bằng 0 thì kết quả luôn giống hệt." Thường ổn định hơn nhiều, nhưng nhiều nhà cung cấp không cam kết giống hệt tuyệt đối giữa các lần gọi. Đừng viết test dựa vào điều đó.
"Model tự chạy code hoặc gọi API." Không. Model chỉ sinh ra văn bản mô tả lời gọi, app của bạn mới là bên chạy.
Thí nghiệm 15 phút để thấy tận mắt
Đọc thì dễ quên, tự chạy thì nhớ lâu. Ba thí nghiệm dưới đây chỉ cần một console app gọi API bất kỳ:
Cùng câu hỏi, chạy 5 lần. Hỏi "Viết một câu slogan cho quán cà phê" với temperature cao (ví dụ 1,0), rồi chạy lại với temperature 0. So độ khác nhau giữa các lần.
Xem xác suất token. Một số nhà cung cấp cho phép trả về xác suất của các token ứng viên (thường gọi là logprobs). Kiểm tra tài liệu của bên bạn dùng; nếu có, hãy bật lên cho câu "Thủ đô của Việt Nam là" và một câu mơ hồ hơn như "Lương trung bình của dev .NET là", để thấy phân phối "chắc chắn" và "phân vân" khác nhau thế nào.
Đặt giới hạn đầu ra rất nhỏ. Đặt giới hạn 10 token và hỏi một câu cần trả lời dài. Xem câu trả lời bị cắt ra sao và trường nào trong response cho biết lý do dừng.
// Thí nghiệm 1: llm là lớp bọc minh họa của bạn quanh HTTP client
foreach (var temp in new[] { 1.0, 0.0 })
{
    Console.WriteLine($"--- temperature = {temp}");
    for (int i = 0; i < 5; i++)
    {
        var text = await llm.CompleteAsync("Viết một câu slogan cho quán cà phê", temperature: temp);
        Console.WriteLine(text);
    }
}
Chạy xong ba thí nghiệm, bạn sẽ không bao giờ viết Assert.Equal cho output của LLM nữa. (Và có thể có thêm vài slogan dùng được cho quán cà phê của bạn bè.)
Tóm lại
LLM hoạt động bằng cách đoán token tiếp theo, chọn một token theo xác suất, nối vào rồi lặp lại. Từ một cơ chế đó suy ra được gần hết hành vi bạn sẽ gặp: kết quả không cố định, bịa trôi chảy, chậm khi viết dài, kém với phép đếm, không biết dữ liệu mới. Việc của AI Engineer là thiết kế hệ thống quanh những đặc điểm này: đưa đúng dữ liệu vào context, giao phép tính cho code, và đo chất lượng bằng nhiều lần chạy.
Bài tiếp theo trong series đi vào đơn vị nhỏ nhất của mọi thứ ở trên: token là gì, và vì sao tiếng Việt tốn token hơn tiếng Anh. Sau đó, bài về temperature và top-p giải thích kỹ bước chọn token trong vòng lặp.
Xem bản tóm tắt dưới một phút trên YouTube @teduco hoặc TikTok @teducolabs, và đọc thêm các bài khác trong chuyên mục AI cho Backend Developer.
Bài viết liên quan
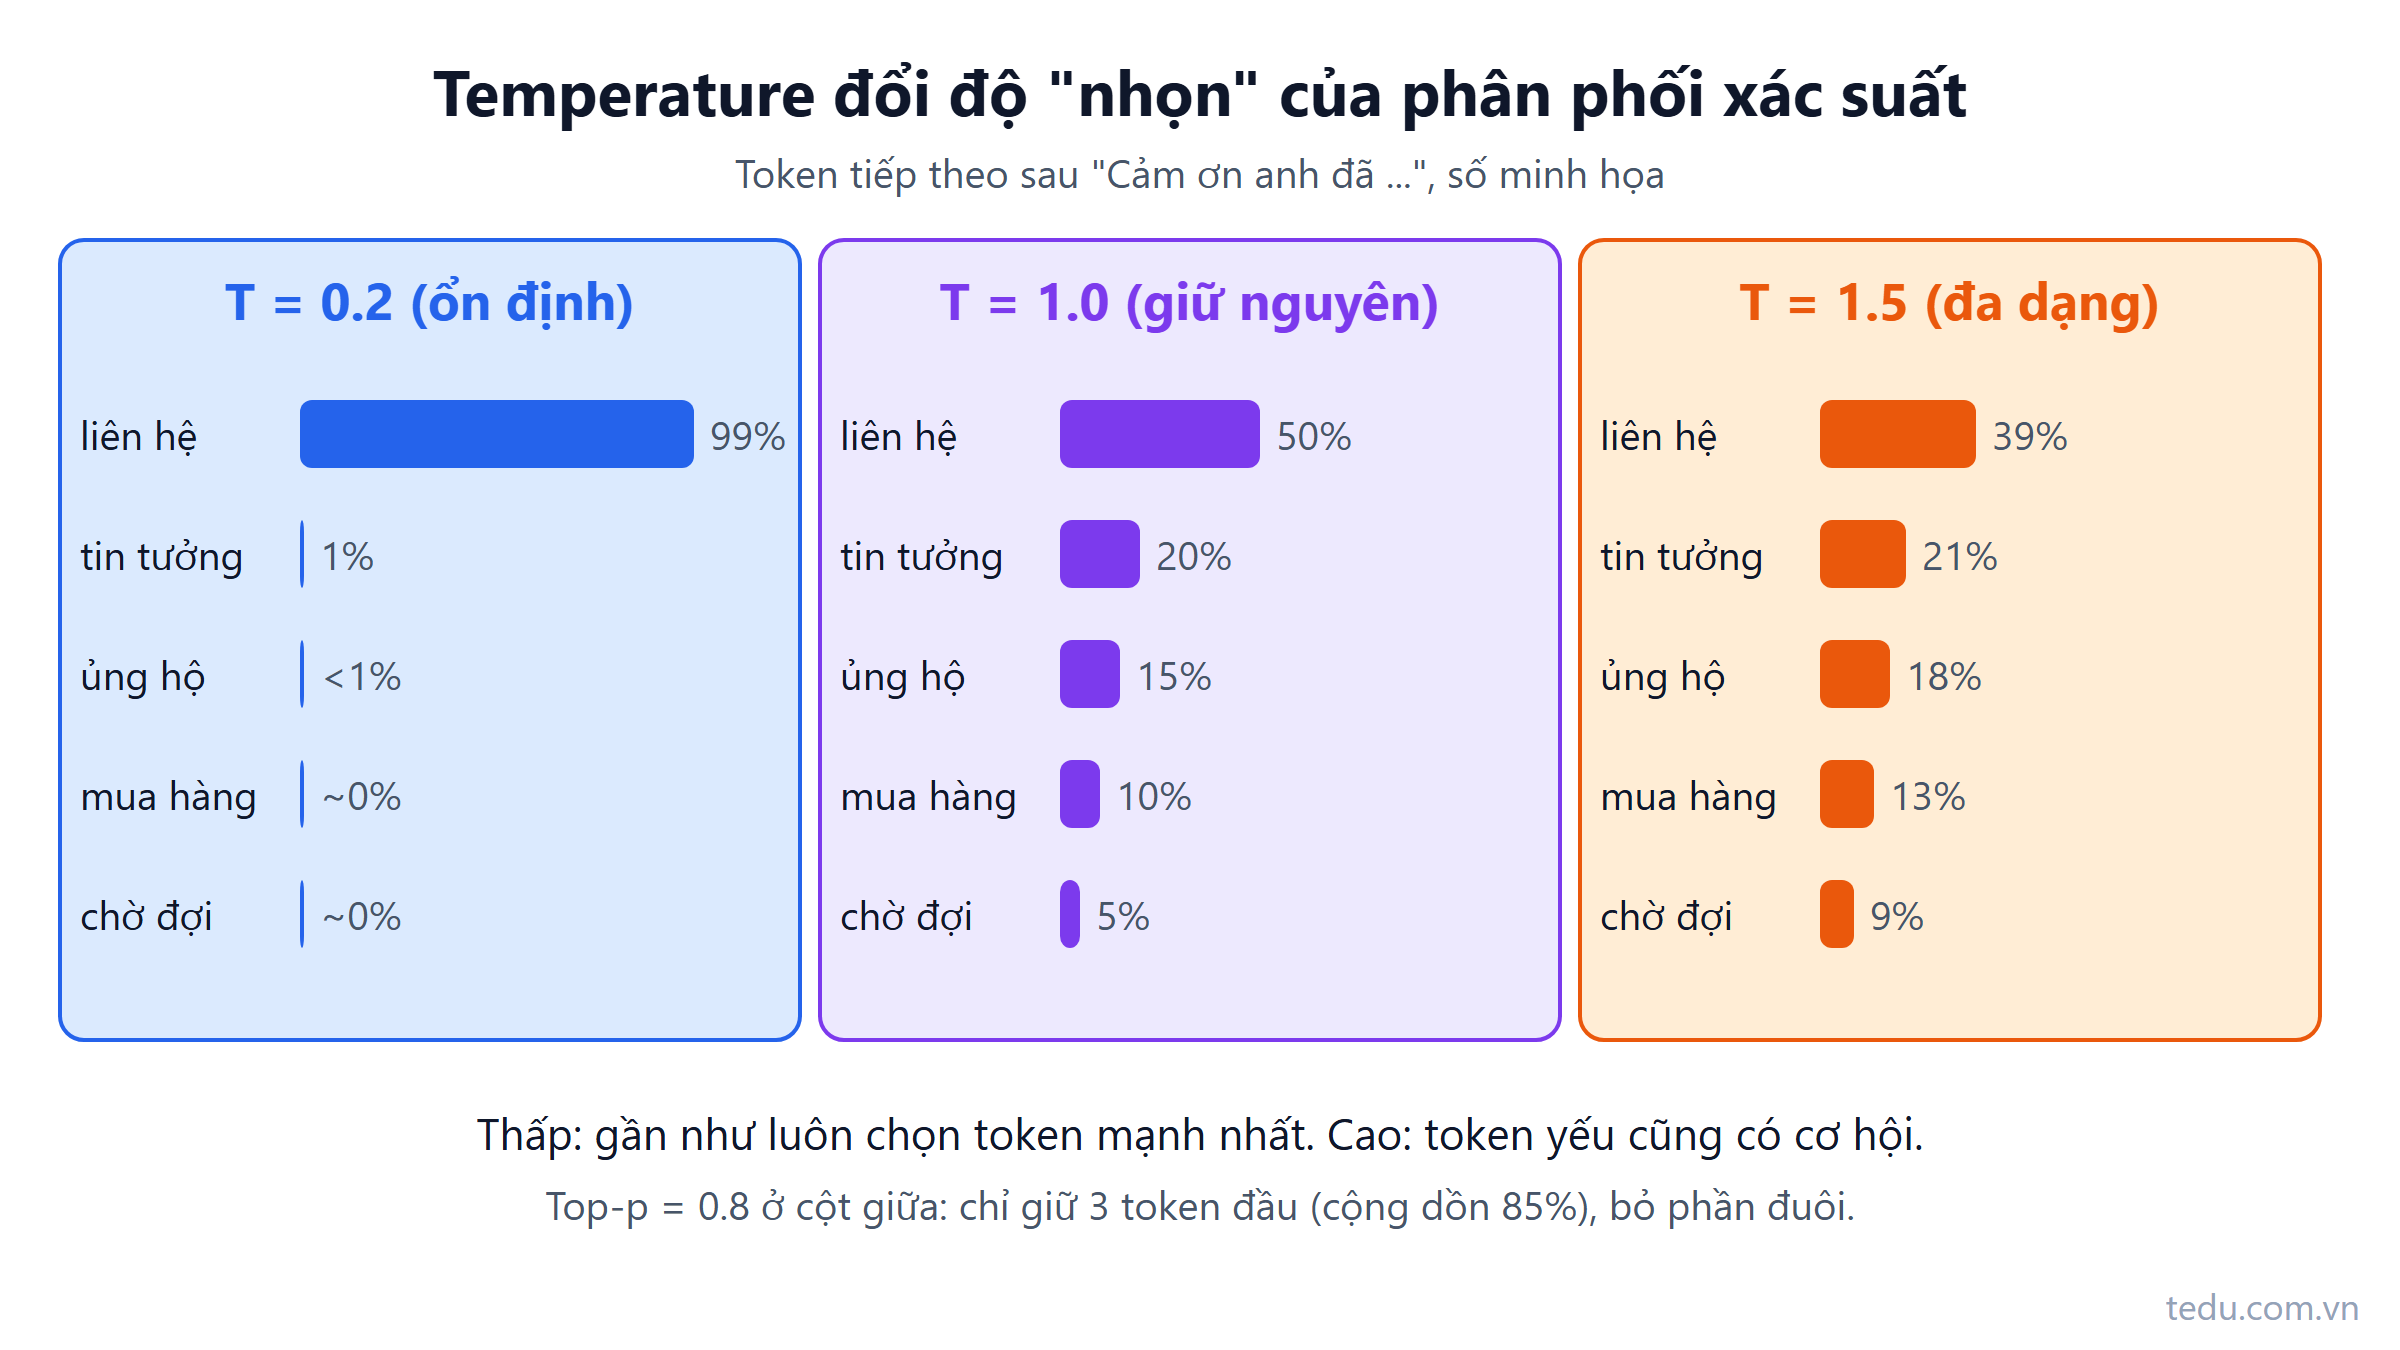
Temperature và top-p là gì? Chỉnh độ sáng tạo của LLM đúng cách
Temperature và top-p quyết định model chọn token tiếp theo an toàn hay phiêu lưu. Bài giải thích cơ chế bằng số cụ thể, code C# mô phỏng và cách chọn theo từng tác vụ.
Đọc thêm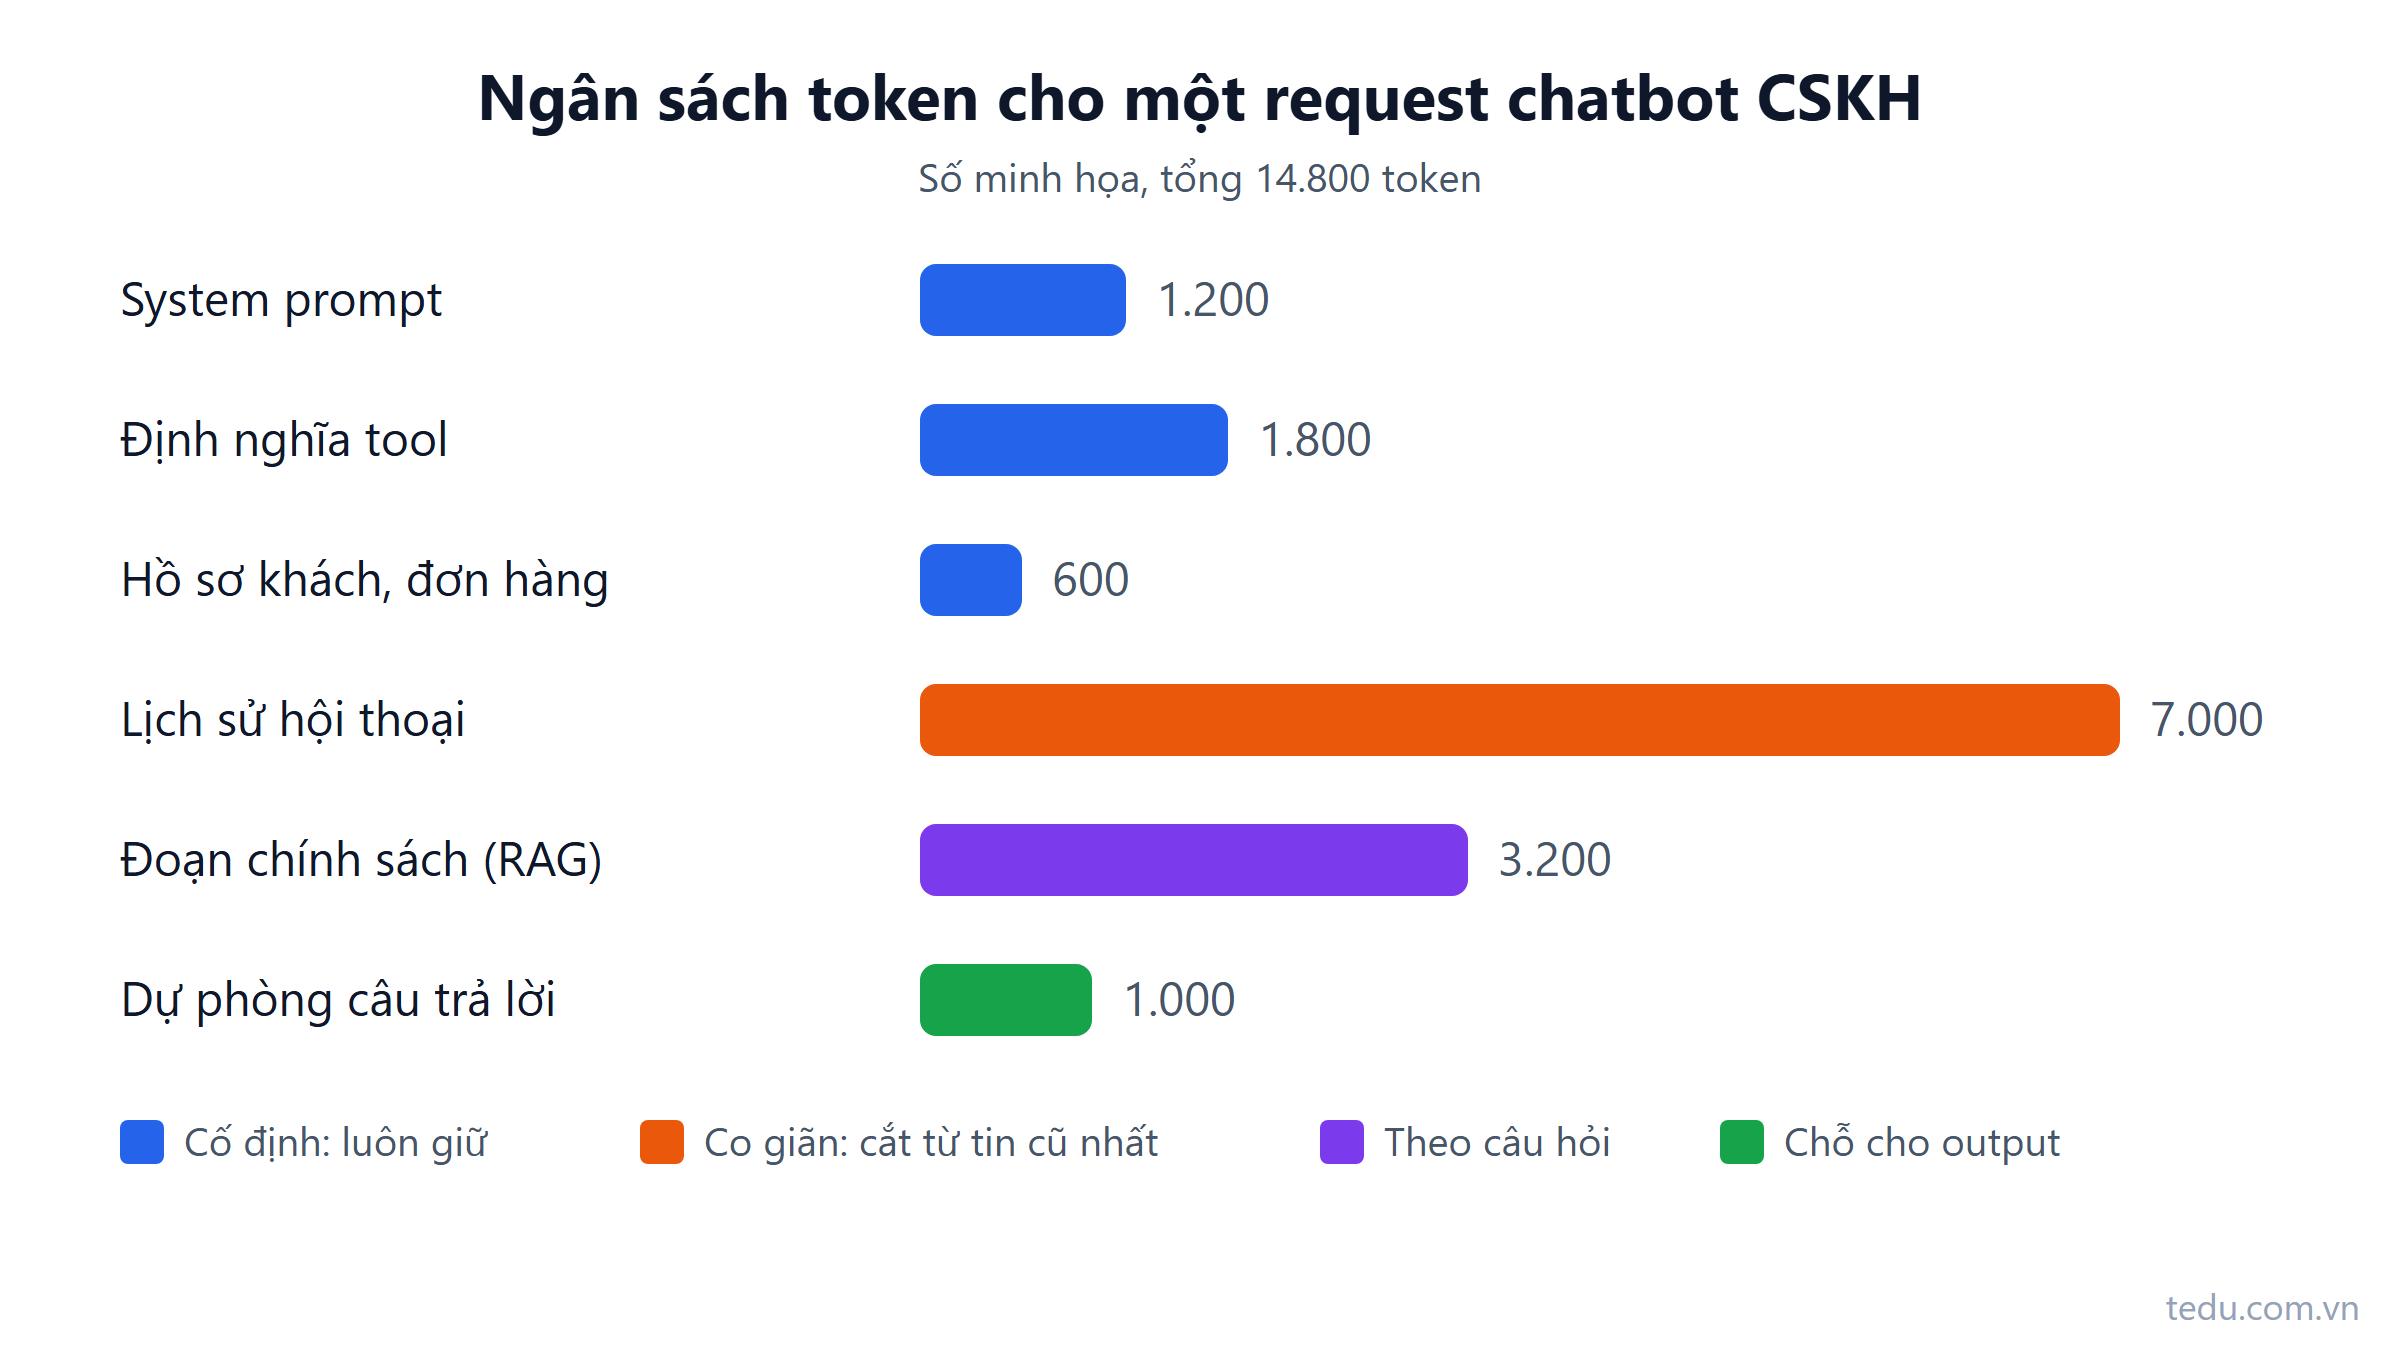
Context window là gì? Hiểu "RAM" của model để không tràn bộ nhớ
Context window là giới hạn số token model đọc và viết trong một request. Bài giải thích cách chia ngân sách token, xử lý khi tràn và vì sao cửa sổ lớn chưa chắc tốt.
Đọc thêm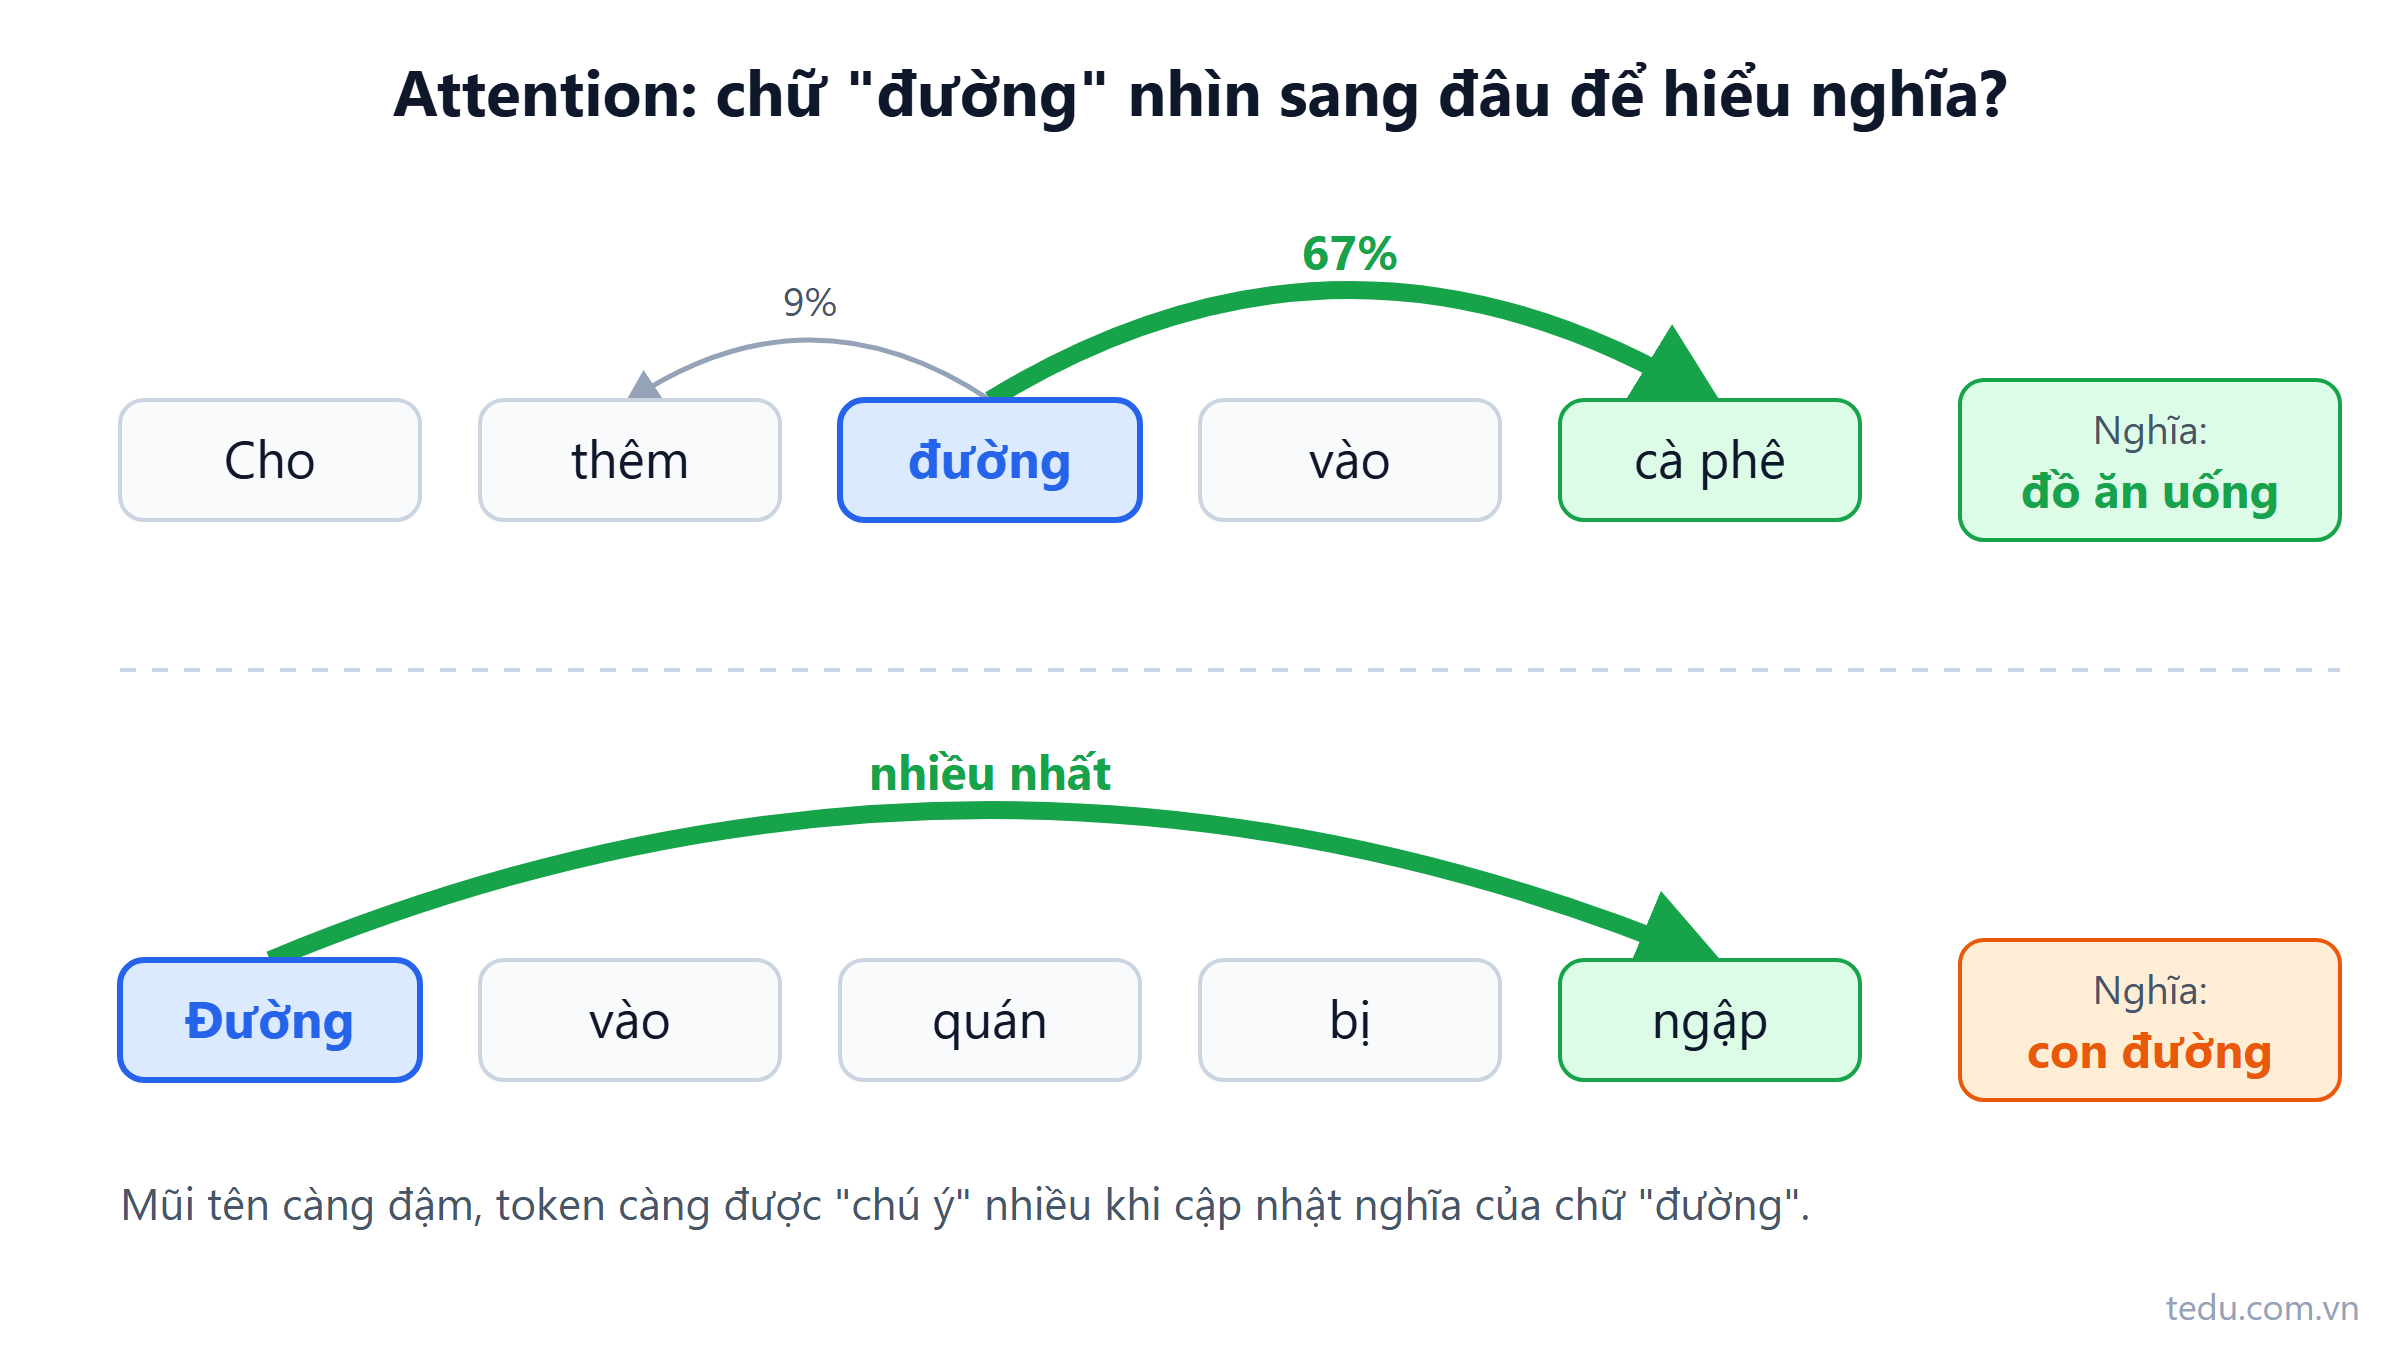
Attention là gì? Giải thích bằng trực giác cho dev backend
Attention là cơ chế giúp mỗi token nhìn sang các token khác để hiểu nghĩa theo ngữ cảnh. Giải thích bằng trực giác, ví dụ C# và hệ quả khi làm sản phẩm.
Đọc thêm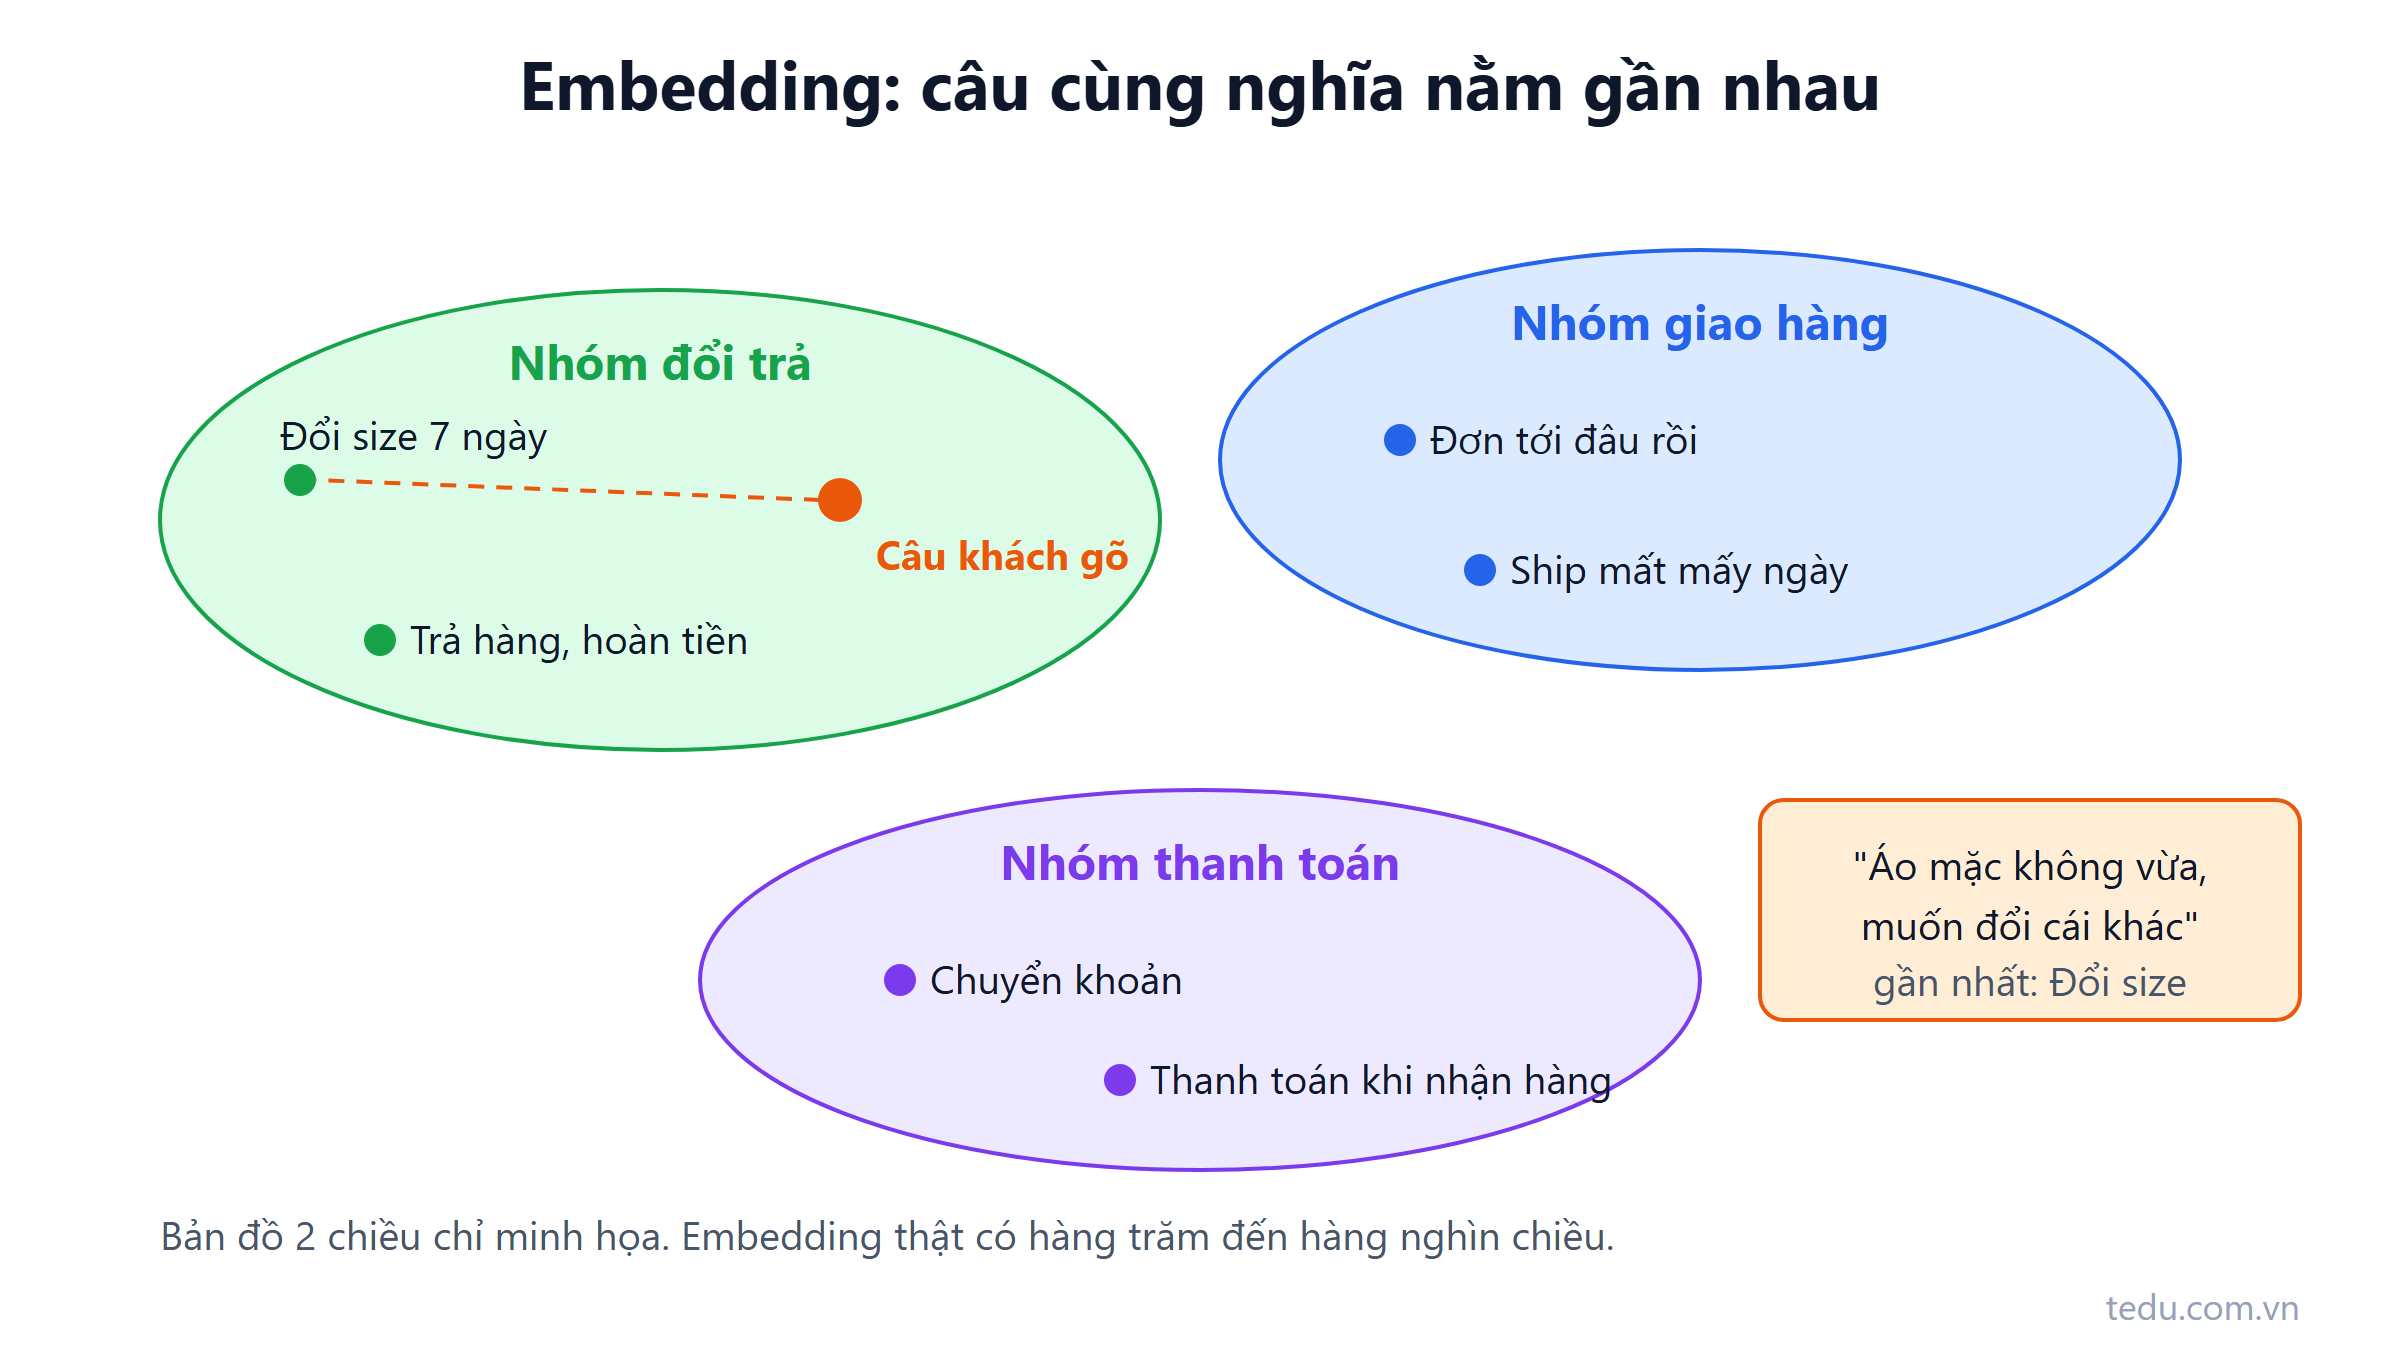
Embedding là gì? Biến chữ thành tọa độ để tìm theo nghĩa
Embedding biến một đoạn chữ thành dãy số như tọa độ, để câu cùng nghĩa nằm gần nhau. Bài giải thích cơ chế, cosine similarity, pgvector và các lỗi hay gặp.
Đọc thêm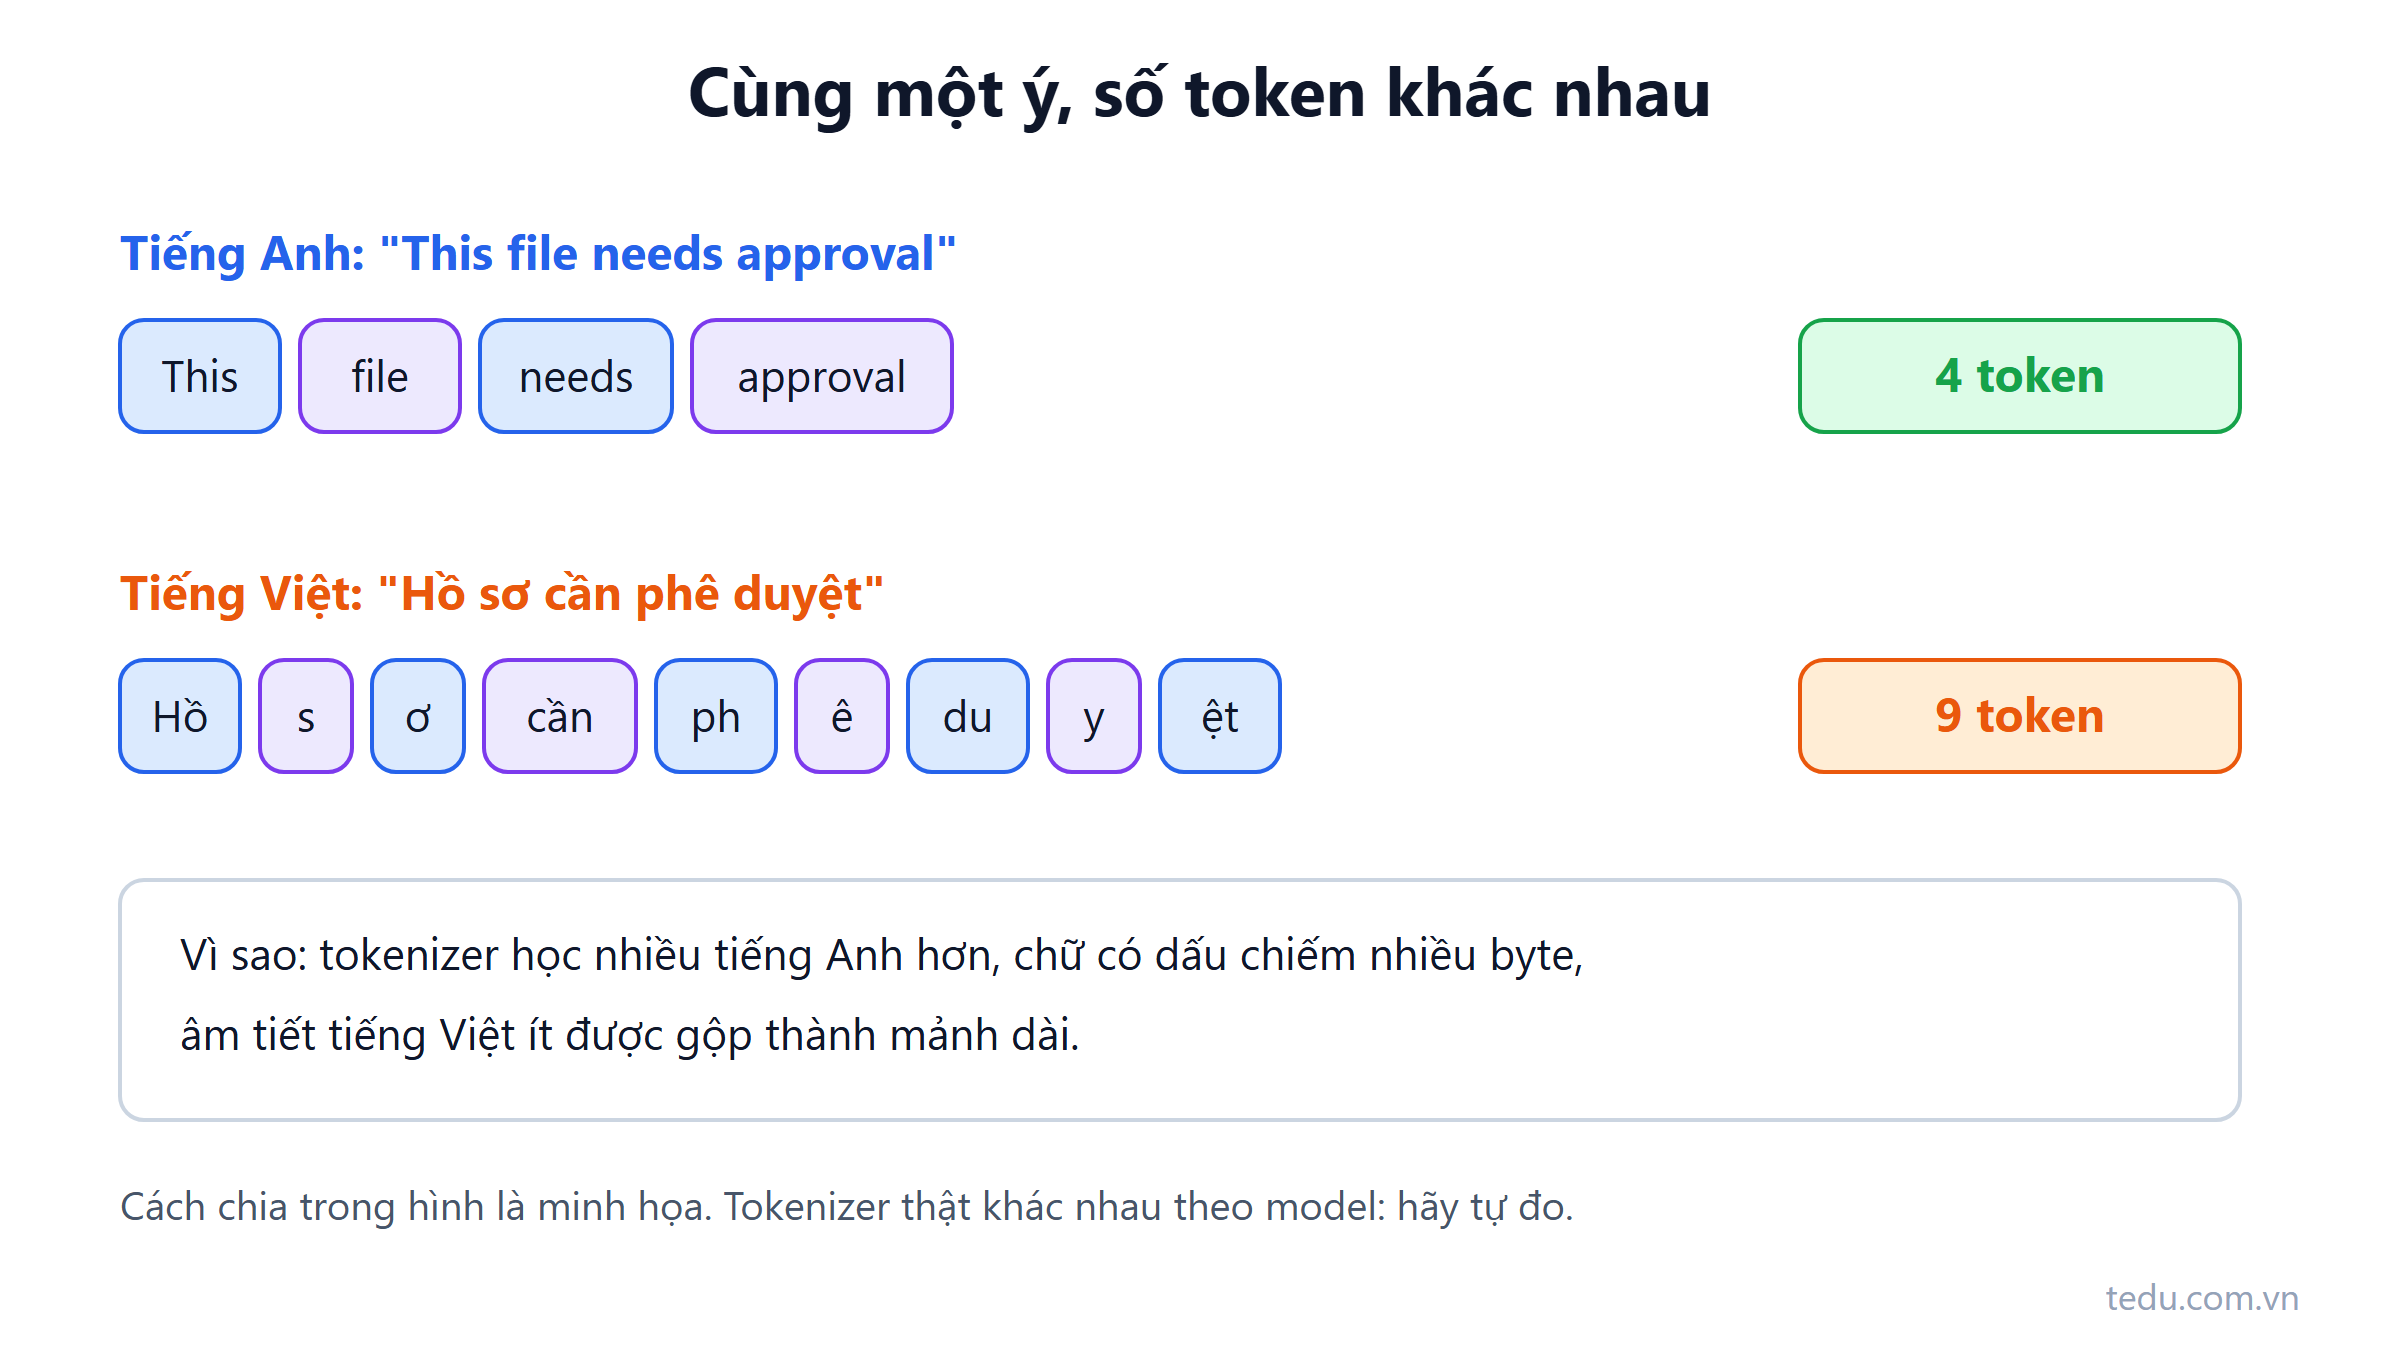
Token là gì? Vì sao tiếng Việt tốn token hơn tiếng Anh
Token là gì, tokenizer chia chữ thế nào và vì sao tiếng Việt thường tốn token hơn. Kèm cách ước lượng chi phí và code C# tự đo token bằng trường usage.
Đọc thêm