

Token là gì? Vì sao tiếng Việt tốn token hơn tiếng Anh
Hãy tưởng tượng một dev đưa tính năng "tóm tắt hồ sơ" lên môi trường thử nghiệm. Bản demo bằng tiếng Anh chạy mượt, chi phí gọn gàng. Chuyển sang hồ sơ tiếng Việt thật, hóa đơn gọi API tăng lên rõ rệt dù số trang không đổi. Không có bug nào cả. Chỉ là tiếng Việt tốn nhiều token hơn.
Bài này giải thích token là gì, vì sao tiếng Việt thường tốn nhiều token hơn tiếng Anh, hệ quả tới chi phí và context window, cách ước lượng chi phí cho một tính năng thật, và quan trọng nhất: cách tự đo trên đúng model bạn đang dùng, thay vì tin vào một con số ai đó đưa ra.
Token là gì?
Token là đơn vị nhỏ nhất mà LLM đọc và viết. Model không nhìn thấy chữ cái hay từ như bạn, nó nhìn thấy một dãy số nguyên, mỗi số đại diện cho một mảnh văn bản. Mảnh đó có thể là cả một từ ("hello"), một phần của từ ("ing"), một ký tự, hoặc một dấu cách kèm chữ.
Phần chuyển văn bản thành dãy số này gọi là tokenizer. Nó chạy trước khi model nhận được gì, và chạy lại ở chiều ngược để biến số thành chữ khi model trả lời. Như bài LLM hoạt động thế nào đã nói, model sinh ra từng token một, nên token cũng là "nhịp bước" của mọi câu trả lời.
Điều cần nhớ: mọi thứ liên quan tới LLM đều tính bằng token, không tính bằng ký tự hay từ.
Tiền: nhà cung cấp tính phí theo số token đầu vào và đầu ra.
Bộ nhớ làm việc: context window là giới hạn số token model nhìn được trong một lần gọi.
Tốc độ: model sinh từng token một, nên đầu ra càng nhiều token thì càng lâu.
Tokenizer chia chữ thế nào: trực giác về BPE
Hầu hết tokenizer hiện nay dựa trên một ý tưởng gọi là BPE (byte pair encoding) hoặc các biến thể gần với nó. Cách hiểu đơn giản nhất: bắt đầu từ các byte rời rạc, rồi lặp đi lặp lại việc gộp cặp xuất hiện nhiều nhất trong dữ liệu huấn luyện thành một mảnh mới.
Chuỗi thường gặp sẽ được gộp thành mảnh dài, một token duy nhất. Chuỗi hiếm gặp không có mảnh dài sẵn, nên bị cắt thành nhiều mảnh ngắn. Hệ quả đáng chú ý: chữ nào xuất hiện nhiều trong dữ liệu dùng để xây tokenizer thì rẻ, chữ nào ít thì đắt.
Giống như gõ tắt trên điện thoại: cụm bạn dùng hằng ngày chỉ cần hai ký tự, còn từ hiếm thì phải gõ đủ từng chữ.
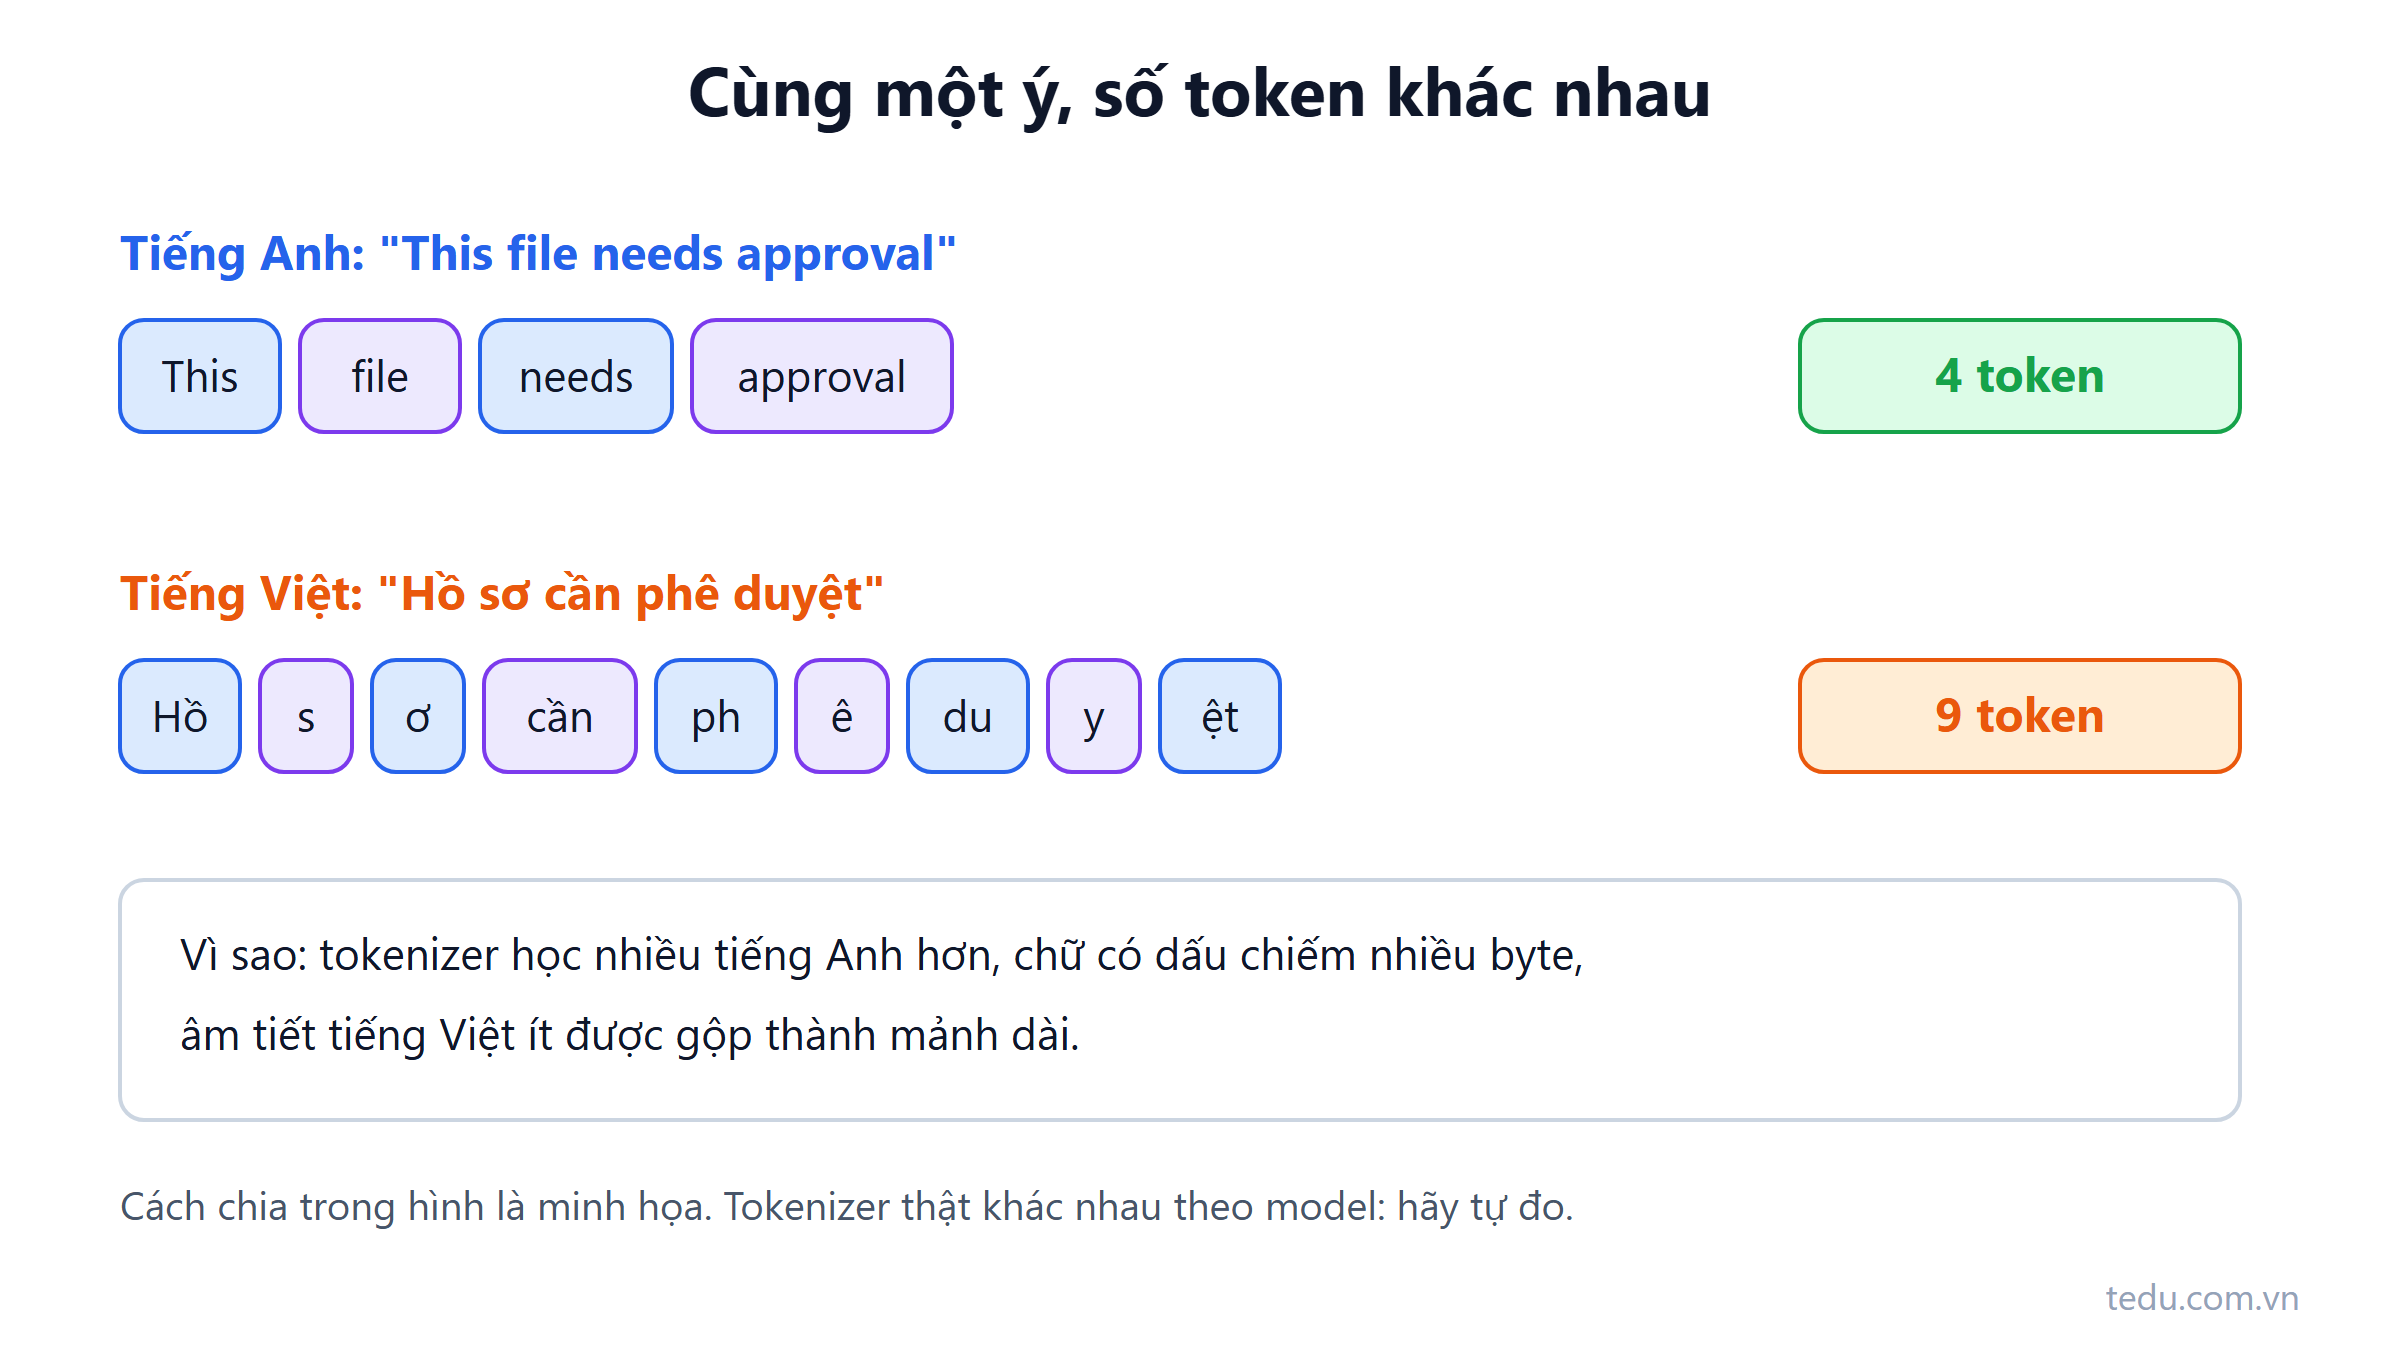
Ví dụ minh họa trong hình (không phải kết quả của một tokenizer cụ thể): "approval" có thể là một mảnh sẵn có, còn "phê duyệt" thì tokenizer cắt thành nhiều mảnh như "ph", "ê", " du", "y", "ệt". Cùng nghĩa, nhưng số mảnh khác nhau.
Vì sao tiếng Việt thường tốn token hơn tiếng Anh?
Có ba lý do cộng lại. Mức độ ảnh hưởng thay đổi theo từng tokenizer, vì vậy bài này không nêu một tỷ lệ cố định.
Dữ liệu xây tokenizer nghiêng về tiếng Anh
Phần lớn văn bản trên internet là tiếng Anh, nên các mảnh dài được gộp ra chủ yếu là mảnh tiếng Anh. Tiếng Việt chiếm phần nhỏ hơn nên có ít mảnh dài của riêng nó.
Dấu tiếng Việt nằm trên ký tự nhiều byte
Tiếng Anh dùng ký tự ASCII, mỗi ký tự là một byte. Các chữ như "ệ", "ữ", "ờ" trong UTF-8 chiếm nhiều byte. Khi tokenizer làm việc ở mức byte và chưa có mảnh gộp sẵn cho chúng, một chữ có dấu có thể bị chia thành nhiều token.
Bạn tự kiểm tra được phần byte bằng một dòng C#: Encoding.UTF8.GetByteCount("ệ") trả về 3, trong khi Encoding.UTF8.GetByteCount("e") trả về 1. Còn có một chi tiết dễ bỏ qua: cùng một chữ "ệ" có thể được lưu ở dạng dựng sẵn (một ký tự) hoặc dạng tổ hợp (chữ "e" cộng dấu nặng cộng dấu mũ). Văn bản copy từ file Word, PDF cũ hay nhập từ các bộ gõ khác nhau có thể trộn cả hai dạng, và dạng tổ hợp thường tốn byte hơn. Chuẩn hóa bằng text.Normalize(NormalizationForm.FormC) trước khi gửi là một bước rẻ, đồng thời giúp tìm kiếm và so khớp chuỗi ổn định hơn.
Tiếng Việt viết cách nhau từng âm tiết
Mỗi âm tiết là một đơn vị riêng, ngăn cách bằng dấu cách. Nhiều âm tiết tiếng Việt không có dạng quen thuộc trong dữ liệu tiếng Anh, nên khó gộp thành mảnh dài.
Nên nhớ đây là xu hướng chung, không phải quy tắc tuyệt đối. Model đời mới thường có tokenizer đa ngôn ngữ tốt hơn bản cũ, và khoảng cách giữa các tokenizer khác nhau có thể lớn. Cách duy nhất để biết là đo.
Hệ quả: tiền, context window và độ trễ
| Khía cạnh | Điều xảy ra khi số token tăng | Ví dụ trong ứng dụng |
|---|---|---|
| Chi phí | Hóa đơn tăng theo số token vào và ra, giá hai chiều thường khác nhau | Tóm tắt hồ sơ tiếng Việt tốn hơn tóm tắt hồ sơ tiếng Anh cùng độ dài |
| Context window | Cùng một giới hạn nhưng chứa được ít nội dung tiếng Việt hơn | Hội thoại dài hoặc tài liệu RAG đầy context sớm hơn dự tính |
| Độ trễ | Model sinh từng token nên câu trả lời nhiều token hiện chậm hơn | Chatbot streaming tiếng Việt chạy chậm hơn bản thử bằng tiếng Anh |
| Giới hạn đầu ra | Tham số max_tokens cắt ngang câu trả lời khi hết ngân sách | Câu trả lời tiếng Việt bị cụt giữa chừng dù ngắn hơn khi viết bằng tiếng Anh |
Vì vậy bước ước lượng chi phí cho một tính năng AI tiếng Việt không thể sao chép từ ví dụ tiếng Anh trong tài liệu của nhà cung cấp. Con số đó có thể đúng với bản thử, và lệch khi lên production.
Token trong một request không chỉ là câu hỏi
Một lỗi ước lượng hay gặp là chỉ đếm câu hỏi của người dùng. Với chatbot hỏi đáp quy chế nội bộ, một request thật thường gồm:
| Phần | Ví dụ | Đặc điểm |
|---|---|---|
| System prompt | Vai trò, quy tắc trả lời, định dạng | Lặp lại ở mọi request |
| Lịch sử hội thoại | Các lượt hỏi đáp trước | Tăng dần theo độ dài cuộc trò chuyện |
| Tài liệu RAG | 4–5 đoạn quy chế liên quan | Thường là phần lớn nhất |
| Câu hỏi | "Đi công tác có được tạm ứng không?" | Thường là phần nhỏ nhất |
| Định nghĩa tool | Schema JSON của các hàm model được gọi | Cũng tính là token đầu vào |
Câu hỏi 15 chữ có thể đi kèm vài nghìn token context. Muốn giảm chi phí, hãy nhìn vào phần lớn nhất trước.
Ước lượng chi phí cho một tính năng: làm phép tính trước khi làm demo
Phép tính sau dùng giá minh họa, không phải giá thật của nhà cung cấp nào. Hãy kiểm tra bảng giá hiện tại của nhà cung cấp bạn dùng, vì giá thay đổi thường xuyên.
Giả sử:
Giá minh họa: 1 USD cho 1 triệu token đầu vào, 4 USD cho 1 triệu token đầu ra (đầu ra thường đắt hơn đầu vào).
Mỗi câu hỏi: 3.000 token đầu vào (system prompt, tài liệu RAG, lịch sử) và 300 token đầu ra.
500 nhân viên, mỗi người hỏi 4 câu một ngày làm việc, 22 ngày một tháng: 44.000 câu hỏi.
Tính:
Đầu vào: 44.000 × 3.000 = 132 triệu token, nhân giá minh họa ra 132 USD.
Đầu ra: 44.000 × 300 = 13,2 triệu token, nhân giá minh họa ra khoảng 53 USD.
Hai điều đáng chú ý từ phép tính này. Thứ nhất, đầu vào chiếm phần lớn chi phí dù đơn giá thấp hơn, vì context nhiều hơn câu trả lời rất nhiều. Thứ hai, nếu số token thật của tài liệu tiếng Việt cao hơn con số bạn ước theo tiếng Anh, toàn bộ phép tính lệch theo. Vì vậy số 3.000 phải đến từ việc đo, không phải từ việc đoán. Bài tính chi phí LLM theo token đi sâu hơn vào phần này.
Tự đo token tiếng Việt bằng code C#
Cách chính xác nhất là đọc trường usage trong response của API. Hầu hết nhà cung cấp trả về số token đầu vào và đầu ra đã tính, tên trường khác nhau tùy bên (ví dụ prompt_tokens hay input_tokens). Đoạn code dưới đây thử cả hai tên.
Đoạn code chỉ minh họa ý tưởng: địa chỉ endpoint, tên model và dạng request cần chỉnh theo nhà cung cấp bạn dùng, vì mỗi bên có định dạng riêng.
using System.Net.Http.Headers;
using System.Text;
using System.Text.Json;

// Chỉnh 3 giá trị này theo nhà cung cấp của bạn.
const string endpoint = "https://dia-chi-api-cua-ban/v1/chat";
const string model = "ten-model-cua-ban";
var apiKey = Environment.GetEnvironmentVariable("LLM_API_KEY")!;

using var http = new HttpClient();
http.DefaultRequestHeaders.Authorization =
    new AuthenticationHeaderValue("Bearer", apiKey);

async Task<(int input, int output)> CountTokensAsync(string text)
{
    var body = JsonSerializer.Serialize(new
    {
        model,
        max_tokens = 1, // chỉ cần đo đầu vào, nên hạn chế đầu ra
        messages = new[] { new { role = "user", content = text } }
    });

    var resp = await http.PostAsync(endpoint,
        new StringContent(body, Encoding.UTF8, "application/json"));
    resp.EnsureSuccessStatusCode();

    using var doc = JsonDocument.Parse(await resp.Content.ReadAsStringAsync());
    var usage = doc.RootElement.GetProperty("usage");

    int Read(params string[] names)
    {
        foreach (var n in names)
            if (usage.TryGetProperty(n, out var v)) return v.GetInt32();
        return -1; // không thấy tên trường nào
    }

    return (Read("prompt_tokens", "input_tokens"),
            Read("completion_tokens", "output_tokens"));
}

var vi = "Hồ sơ này cần được phê duyệt trước ngày cuối tháng.".Normalize(NormalizationForm.FormC);
var en = "This file needs to be approved before the end of the month.";

var (viIn, _) = await CountTokensAsync(vi);
var (enIn, _) = await CountTokensAsync(en);
Console.WriteLine($"Tiếng Việt: {viIn} token đầu vào");
Console.WriteLine($"Tiếng Anh : {enIn} token đầu vào");
Nếu bạn dùng model có tokenizer công khai, có thể đếm offline mà không tốn tiền gọi API. Ví dụ với Python, thư viện tiktoken đếm token cho các bảng mã của một số model OpenAI. Kết quả chỉ đúng với những model dùng đúng bảng mã đó, không dùng để suy ra cho model của nhà cung cấp khác:
import tiktoken

enc = tiktoken.get_encoding("cl100k_base")  # chọn bảng mã khớp với model bạn dùng
for text in ["Hồ sơ này cần được phê duyệt trước ngày cuối tháng.",
             "This file needs to be approved before the end of the month."]:
    print(len(enc.encode(text)), text)
Vài lưu ý để phép đo không đánh lừa bạn:
Số token đầu vào qua API gồm cả phần định dạng tin nhắn mà nhà cung cấp tự thêm. Phần này gần như cố định, nên với câu ngắn nó làm tỷ lệ bị méo. Hãy đo bằng một đoạn dài vài đoạn văn, hoặc trừ đi số token của một tin nhắn rỗng.
So sánh hai câu cùng nghĩa, không phải hai câu cùng độ dài ký tự.
Dùng văn bản thật của bạn: hồ sơ, email, câu hỏi của người dùng, không dùng câu mẫu đẹp.
Đo lại khi đổi model, vì tokenizer có thể khác nhau giữa các đời.
Làm gì để bớt tốn token
Không có cách nào xóa hẳn chênh lệch, nhưng có vài việc rẻ nên làm:
Đo trước khi ước lượng ngân sách. Dùng văn bản tiếng Việt thật và đọc trường usage, đừng nhân hệ số lấy từ bài viết.
Cắt bớt phần thừa trong prompt. Lời chào hỏi, đoạn lặp, hướng dẫn mơ hồ đều là token trả tiền mỗi lần gọi.
Gửi ít tài liệu hơn nhưng đúng hơn. Năm đoạn quy chế đúng tốt hơn hai mươi đoạn "có vẻ liên quan", cả về chi phí lẫn chất lượng.
Cắt tỉa lịch sử hội thoại. Giữ vài lượt gần nhất, tóm tắt phần cũ, thay vì gửi lại toàn bộ.
Dùng prompt caching cho phần cố định như system prompt dài, để giảm chi phí và độ trễ khi gọi lặp.
Cân nhắc viết chỉ dẫn hệ thống bằng tiếng Anh và để model trả lời bằng tiếng Việt. Cách này đôi khi giảm token nhưng có thể đổi chất lượng, nên kiểm tra bằng bộ eval nhỏ rồi mới áp dụng, không làm theo cảm giác.
Đặt max_tokens và theo dõi tỷ lệ bị cắt cụt để người dùng không nhận câu trả lời đứt giữa chừng.
Checklist trước khi đưa tính năng tiếng Việt lên production
Đã đo số token của 20–50 mẫu dữ liệu thật bằng trường usage.
Đã tách số token theo từng phần: system prompt, lịch sử, tài liệu, câu hỏi, tool.
Đã tính chi phí tháng theo số người dùng dự kiến, với giá lấy từ bảng giá hiện tại.
Đã chuẩn hóa Unicode văn bản đầu vào.
Đã đặt giới hạn đầu ra và có log khi câu trả lời bị cắt.
Có dashboard token theo ngày để phát hiện hóa đơn tăng bất thường.
Tóm lại
Token là đơn vị tính tiền, tính bộ nhớ và tính độ trễ của LLM. Tiếng Việt thường tốn nhiều token hơn tiếng Anh vì dữ liệu xây tokenizer và việc mã hóa ký tự có dấu, nhưng mức chênh thay đổi theo từng model, nên đo trực tiếp là cách duy nhất đáng tin.
Bài tiếp theo trong series chuyển từ token sang một cách biểu diễn khác của chữ: embedding, biến chữ thành tọa độ, nền móng của tìm kiếm ngữ nghĩa và RAG.
Xem bản tóm tắt dưới một phút trên YouTube @teduco hoặc TikTok @teducolabs, và đọc thêm các bài khác trong chuyên mục AI cho Backend Developer.
Bài viết liên quan
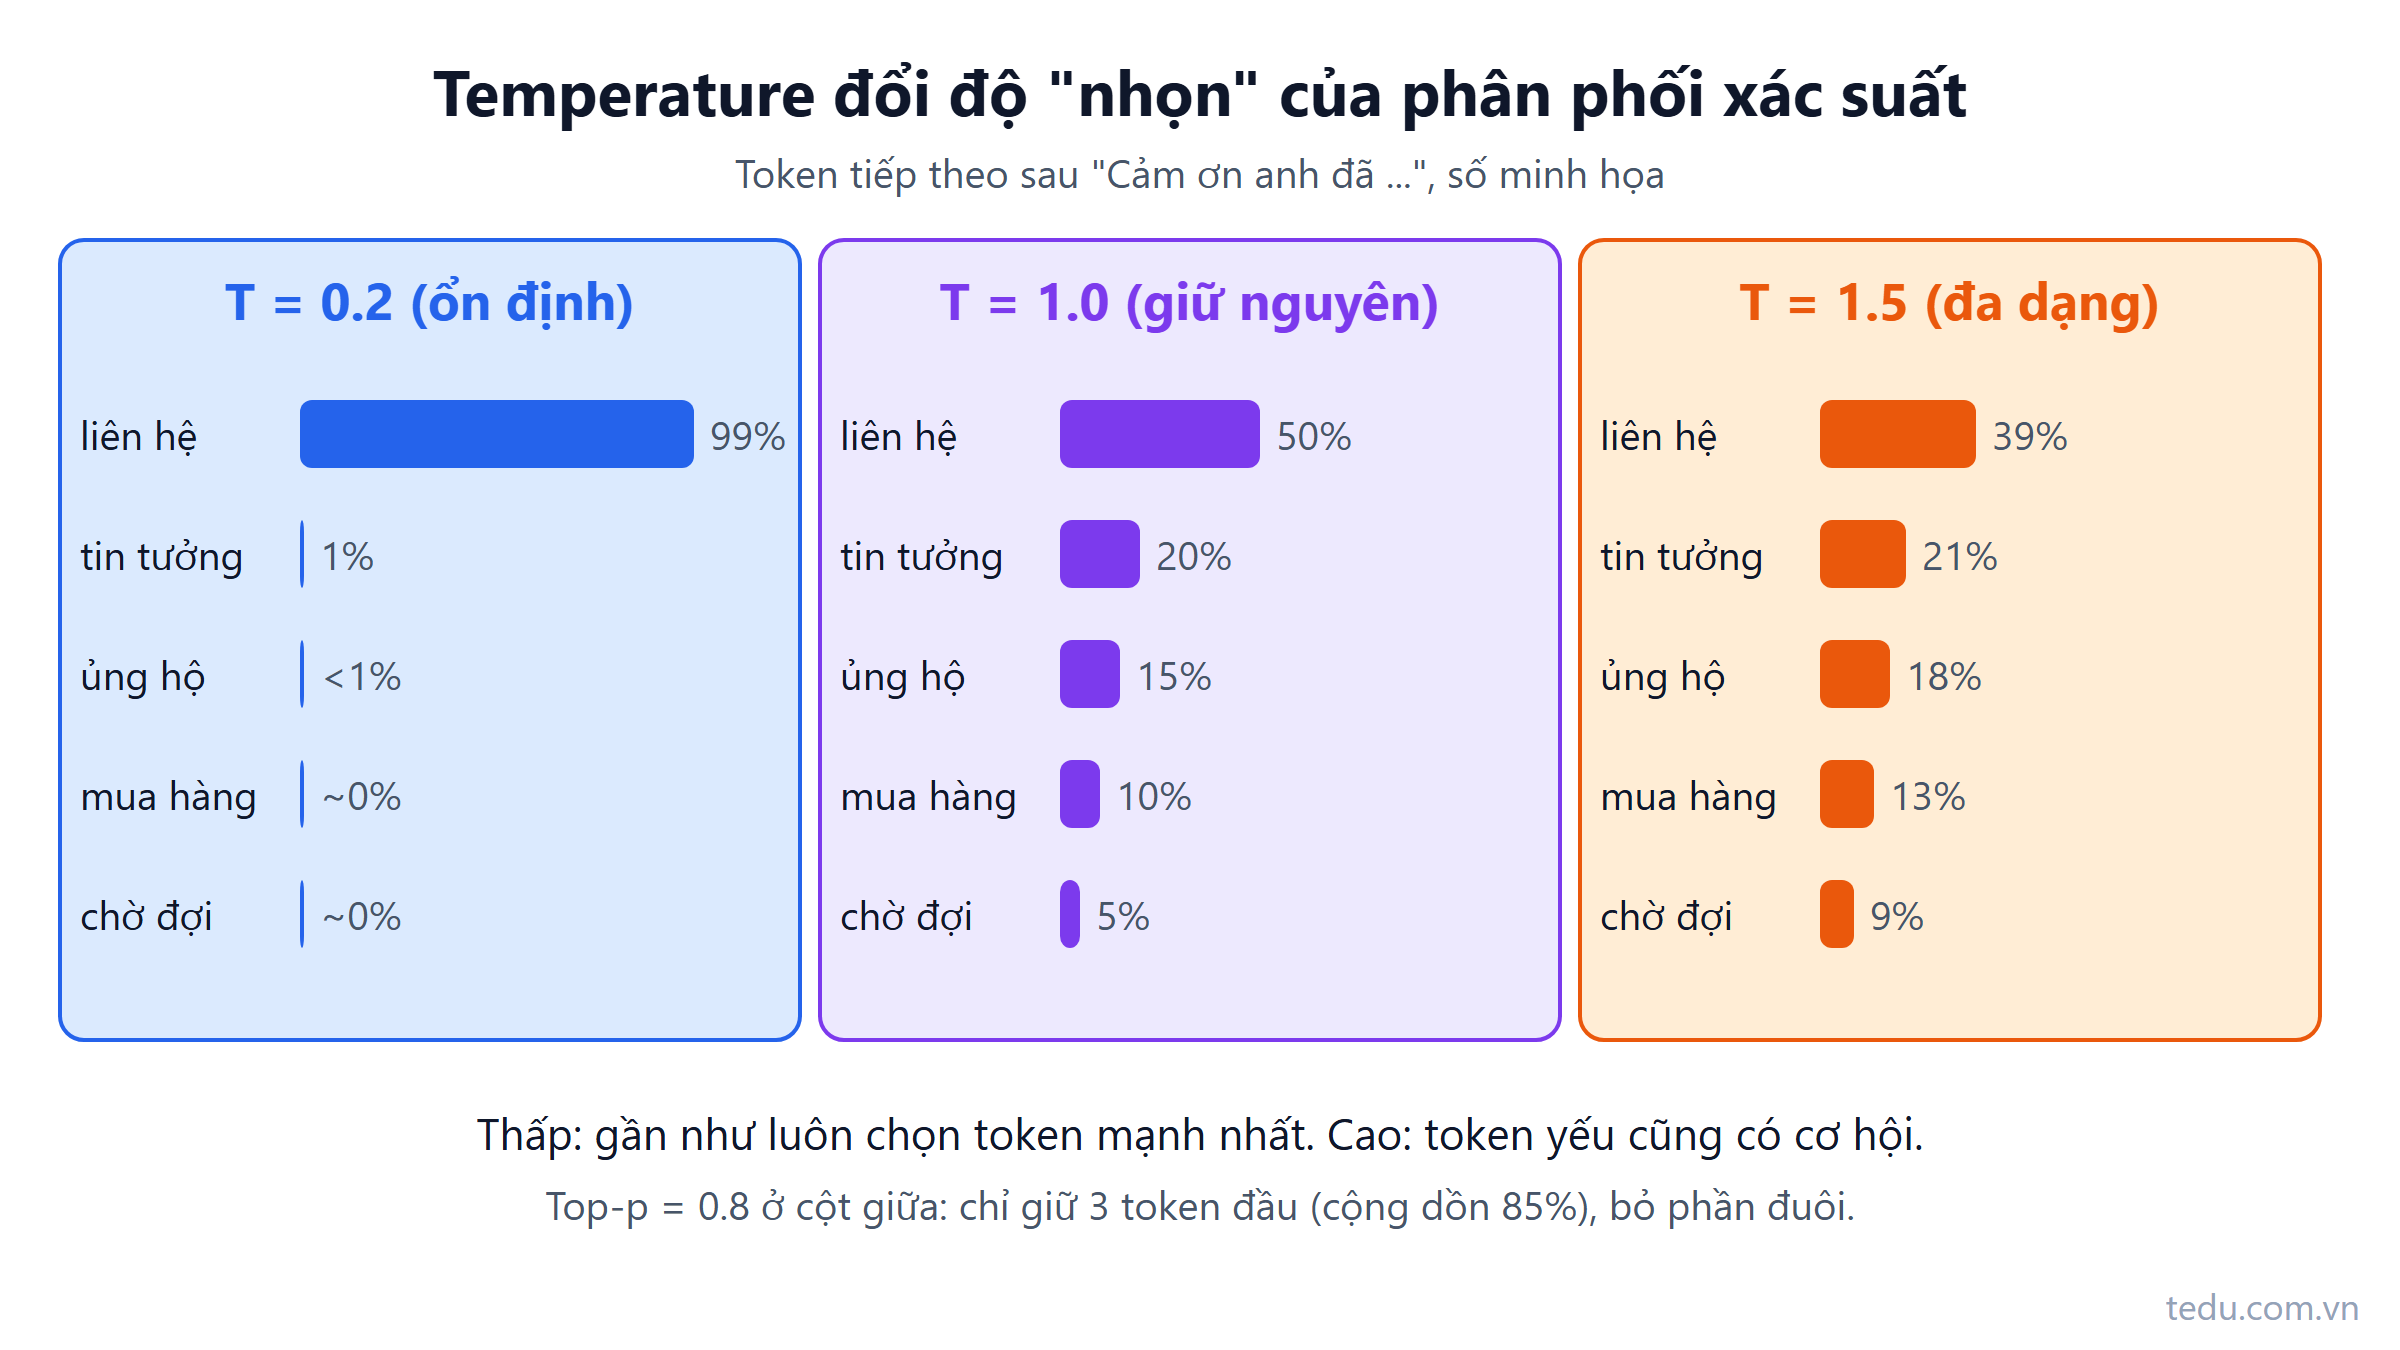
Temperature và top-p là gì? Chỉnh độ sáng tạo của LLM đúng cách
Temperature và top-p quyết định model chọn token tiếp theo an toàn hay phiêu lưu. Bài giải thích cơ chế bằng số cụ thể, code C# mô phỏng và cách chọn theo từng tác vụ.
Đọc thêm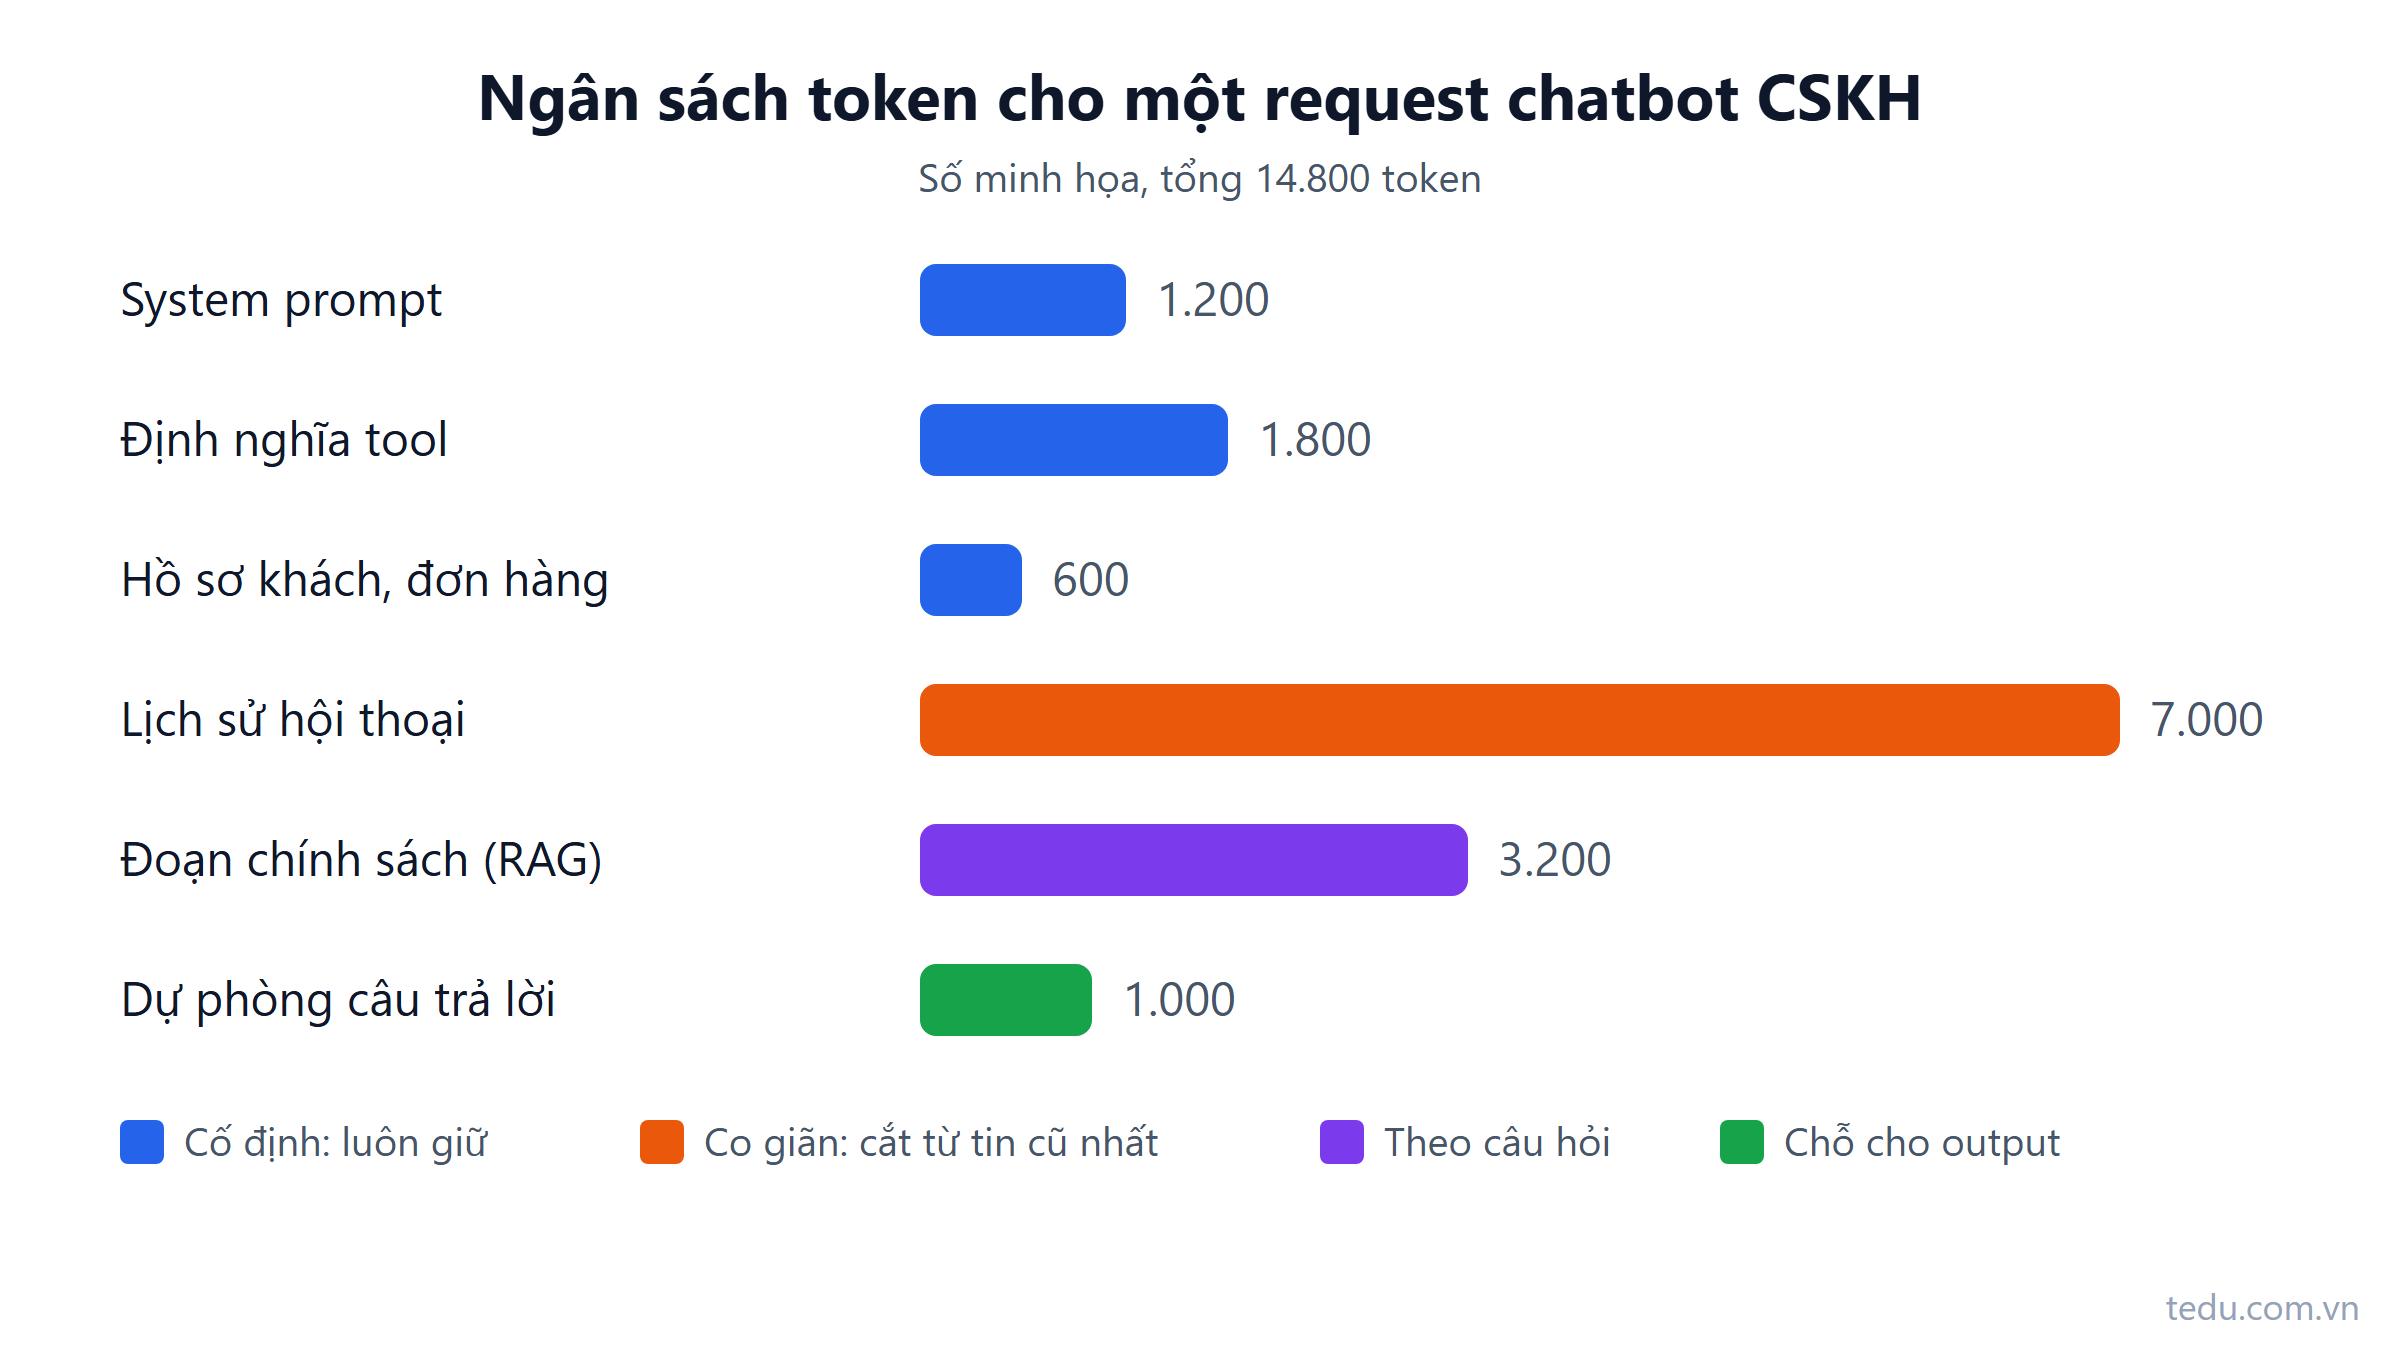
Context window là gì? Hiểu "RAM" của model để không tràn bộ nhớ
Context window là giới hạn số token model đọc và viết trong một request. Bài giải thích cách chia ngân sách token, xử lý khi tràn và vì sao cửa sổ lớn chưa chắc tốt.
Đọc thêm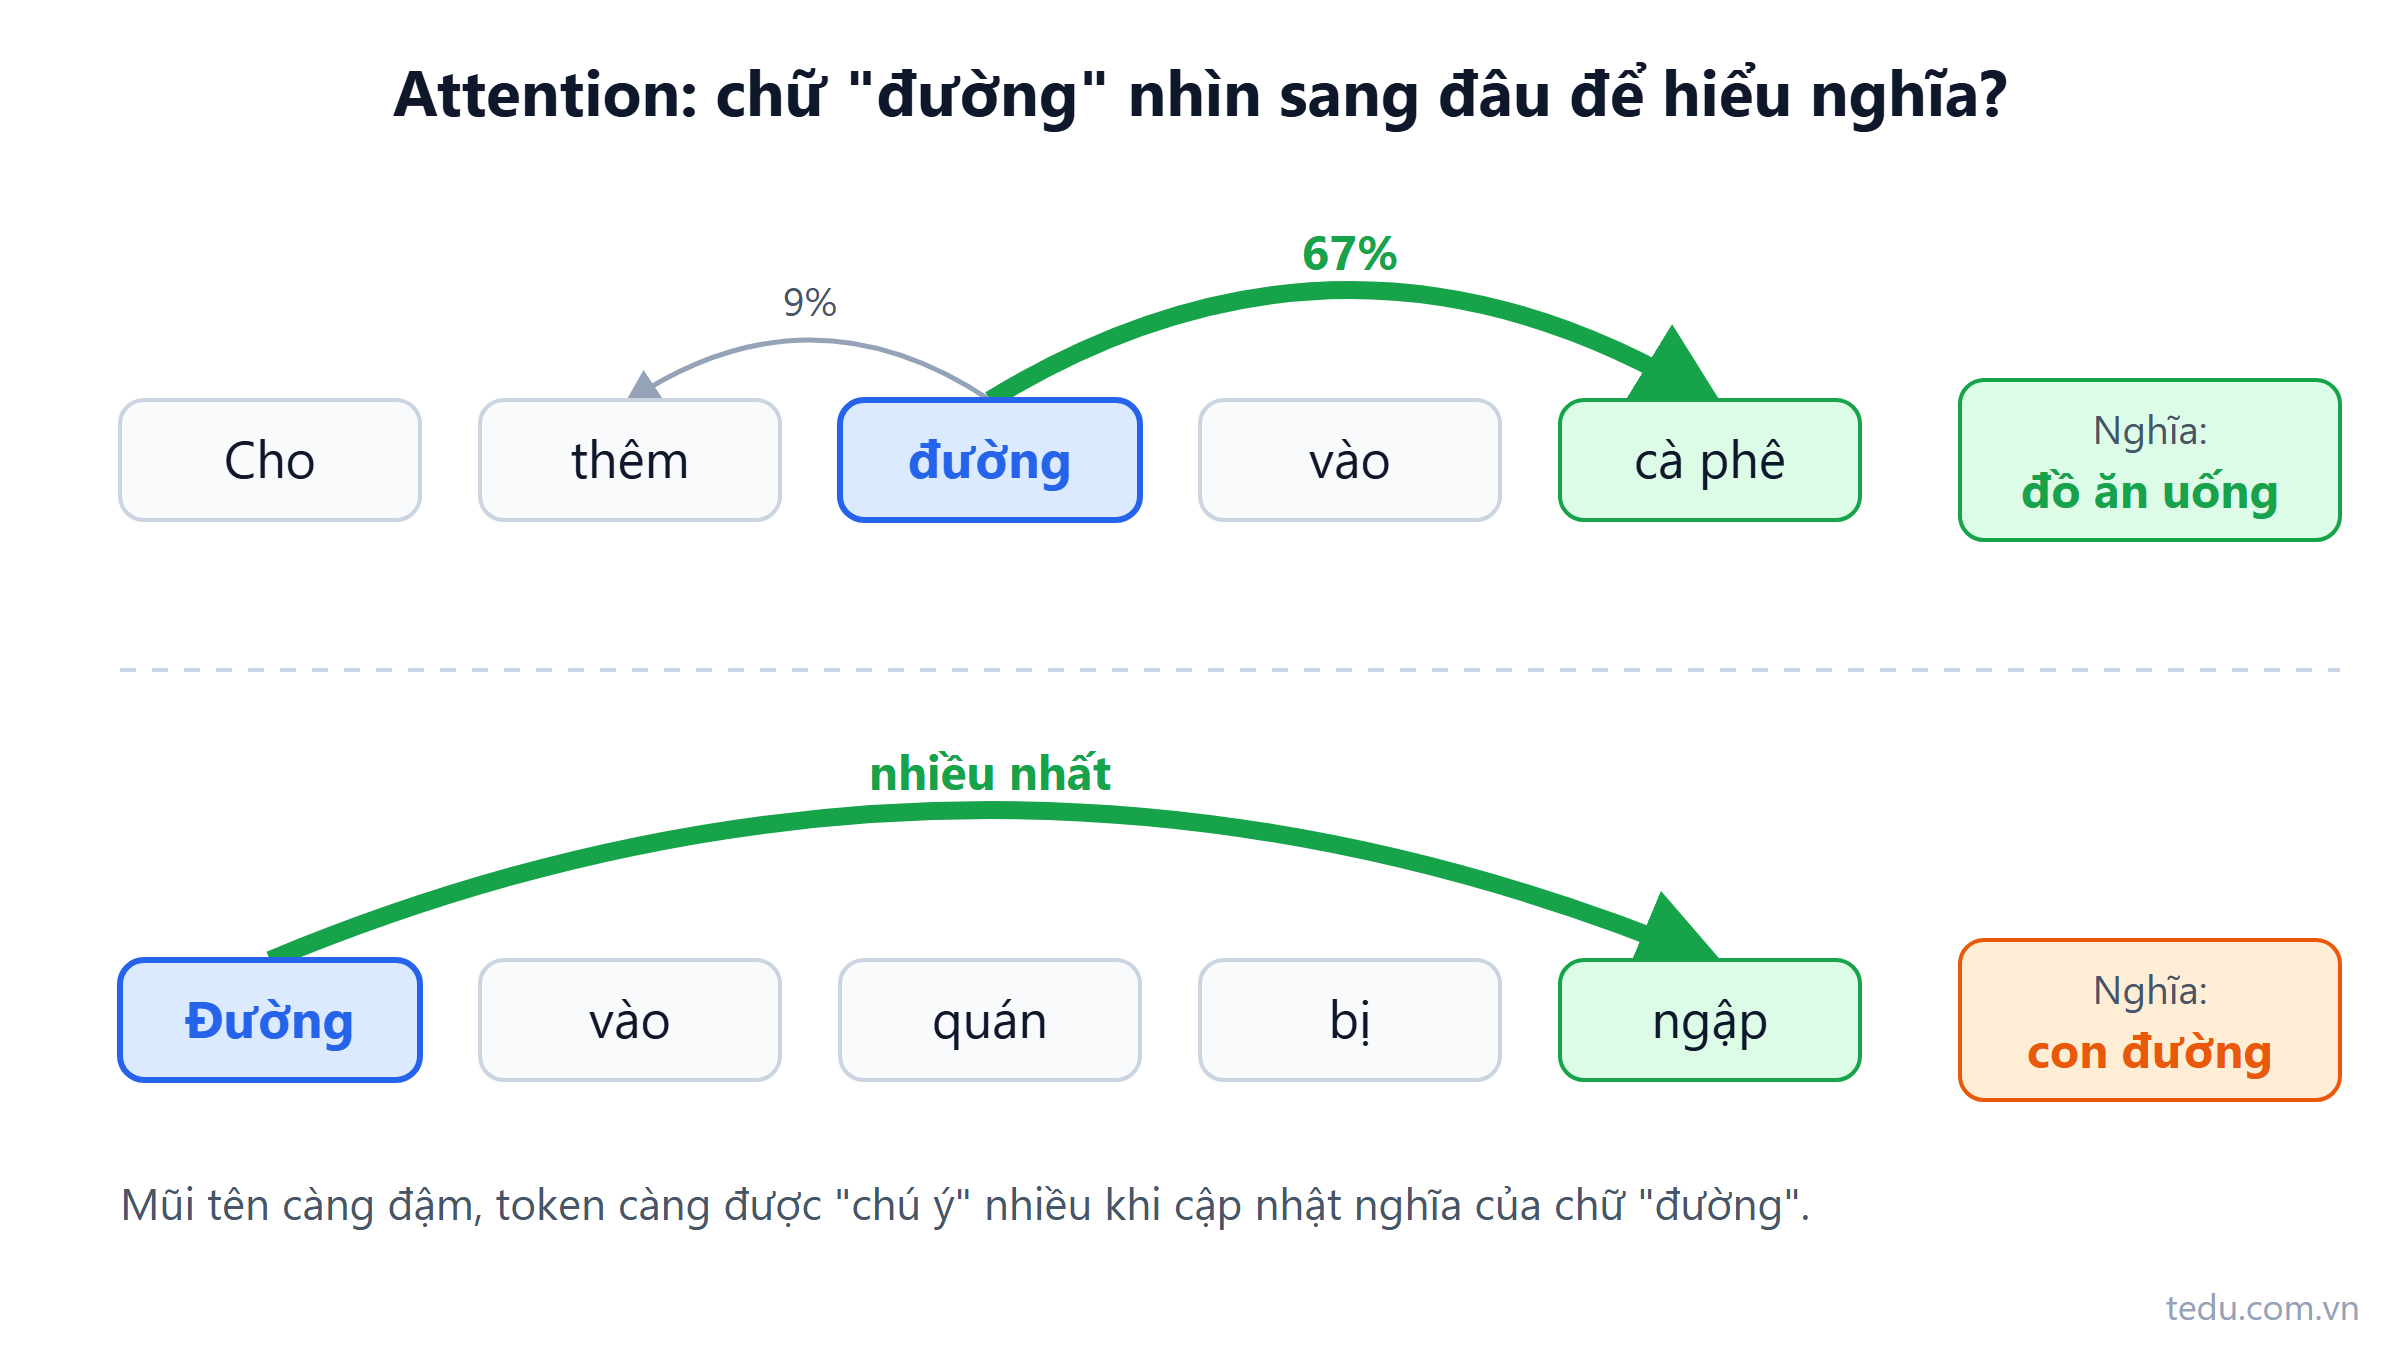
Attention là gì? Giải thích bằng trực giác cho dev backend
Attention là cơ chế giúp mỗi token nhìn sang các token khác để hiểu nghĩa theo ngữ cảnh. Giải thích bằng trực giác, ví dụ C# và hệ quả khi làm sản phẩm.
Đọc thêm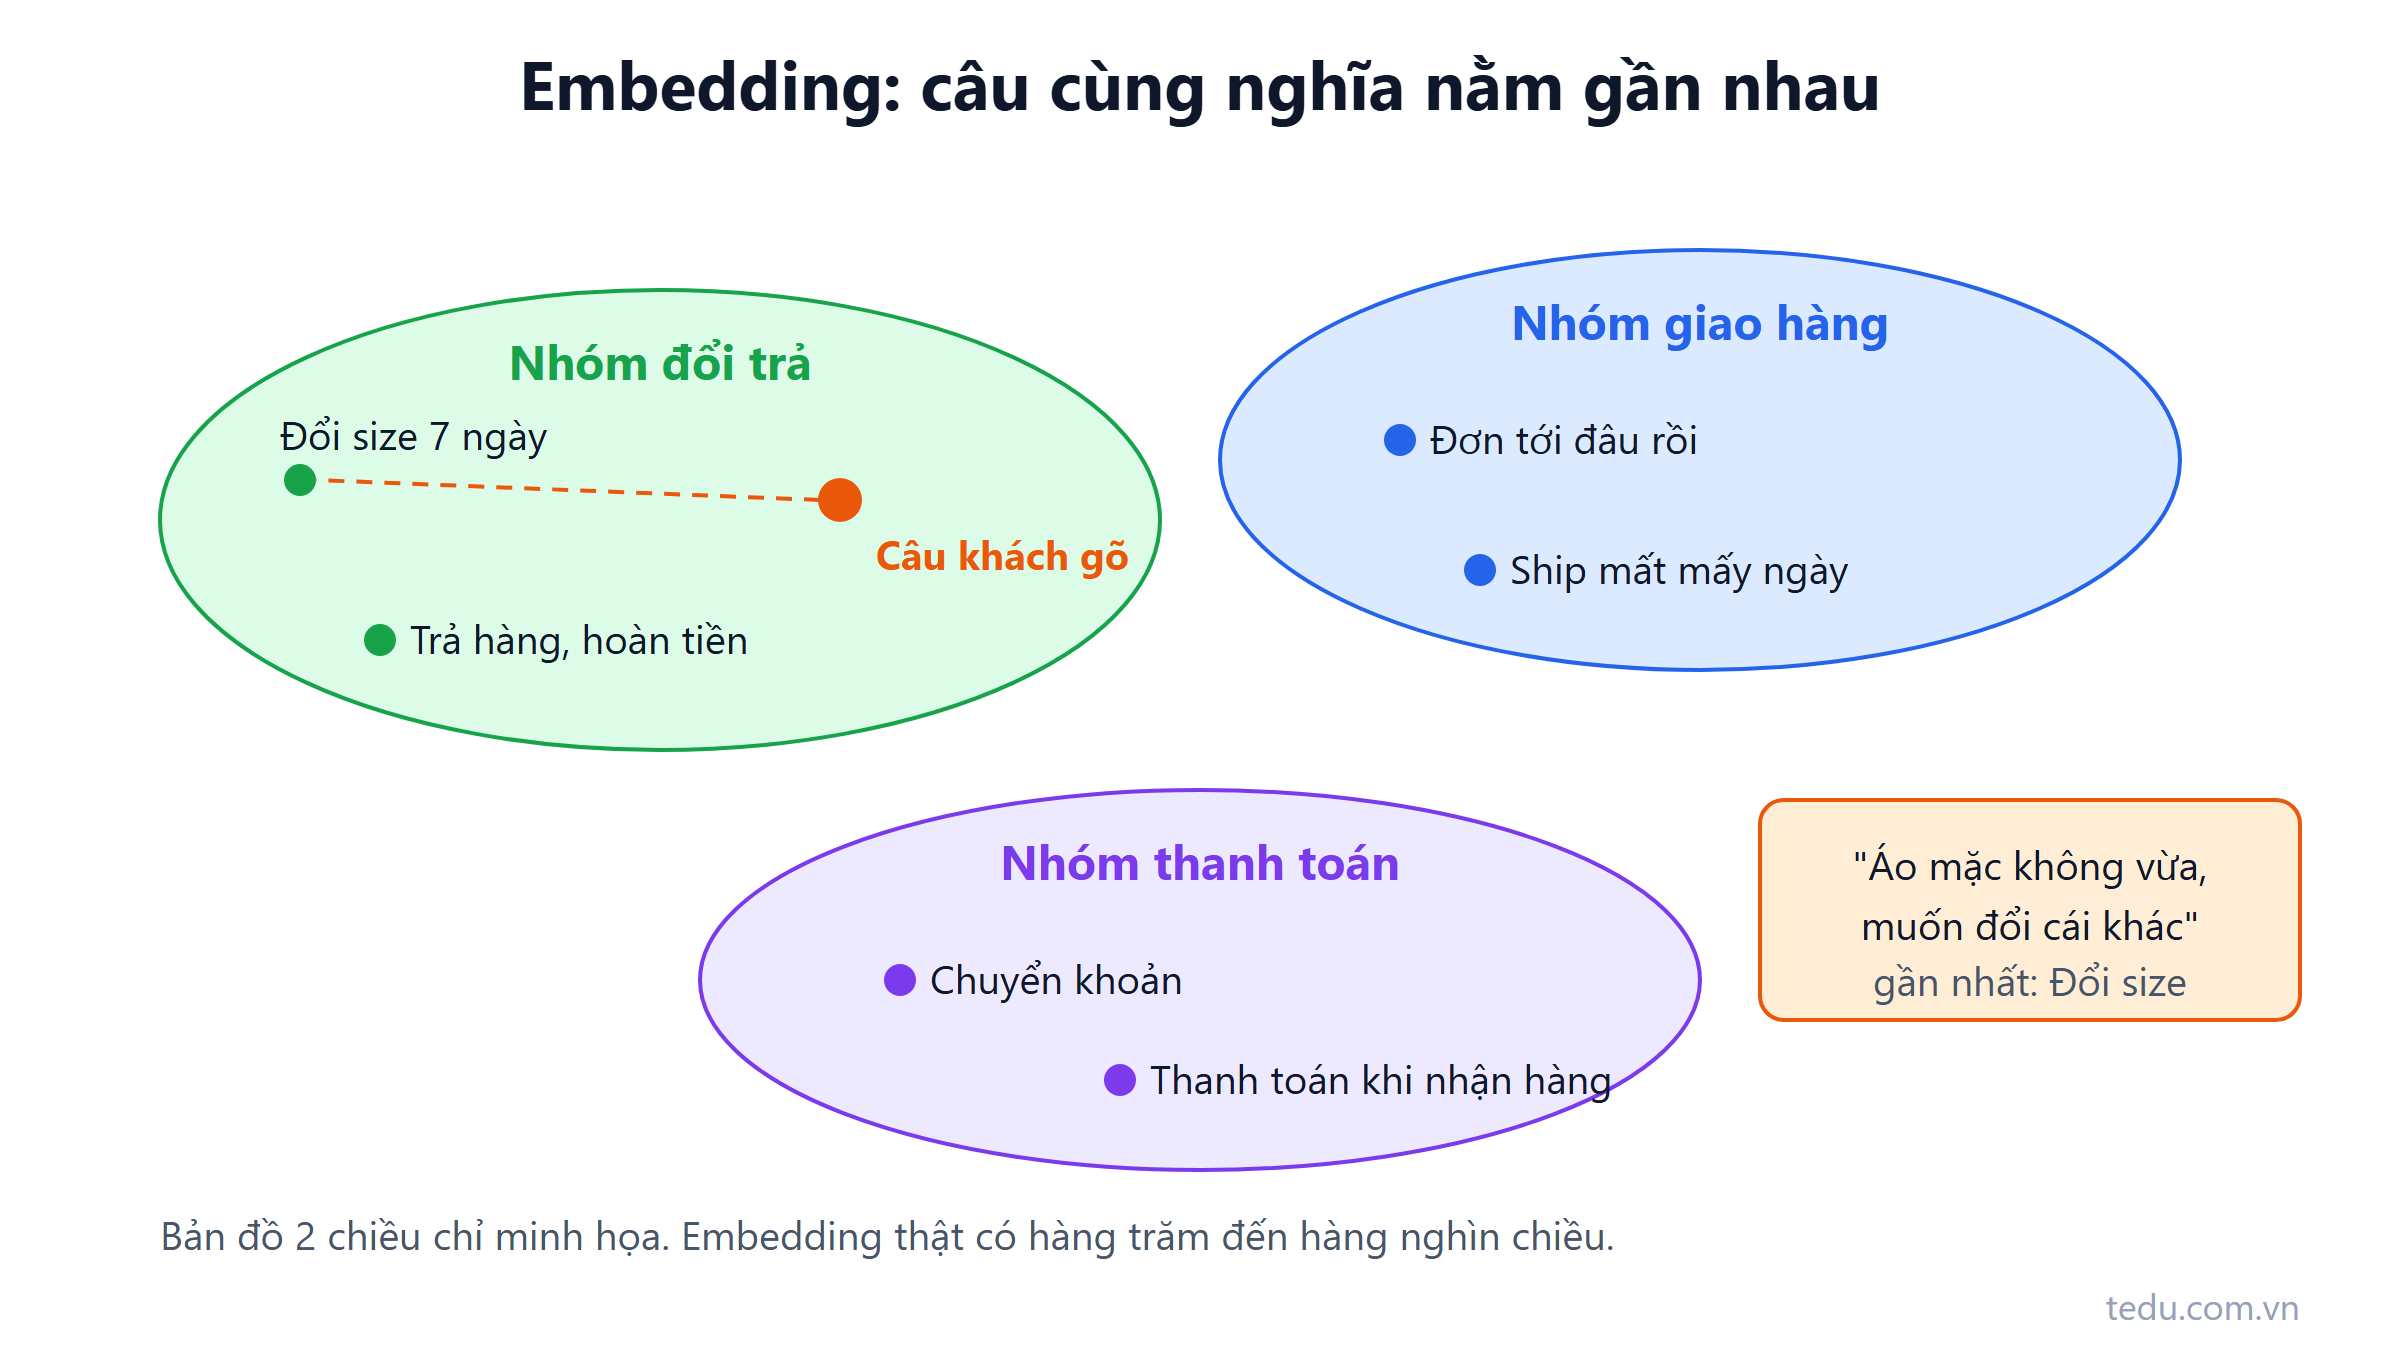
Embedding là gì? Biến chữ thành tọa độ để tìm theo nghĩa
Embedding biến một đoạn chữ thành dãy số như tọa độ, để câu cùng nghĩa nằm gần nhau. Bài giải thích cơ chế, cosine similarity, pgvector và các lỗi hay gặp.
Đọc thêm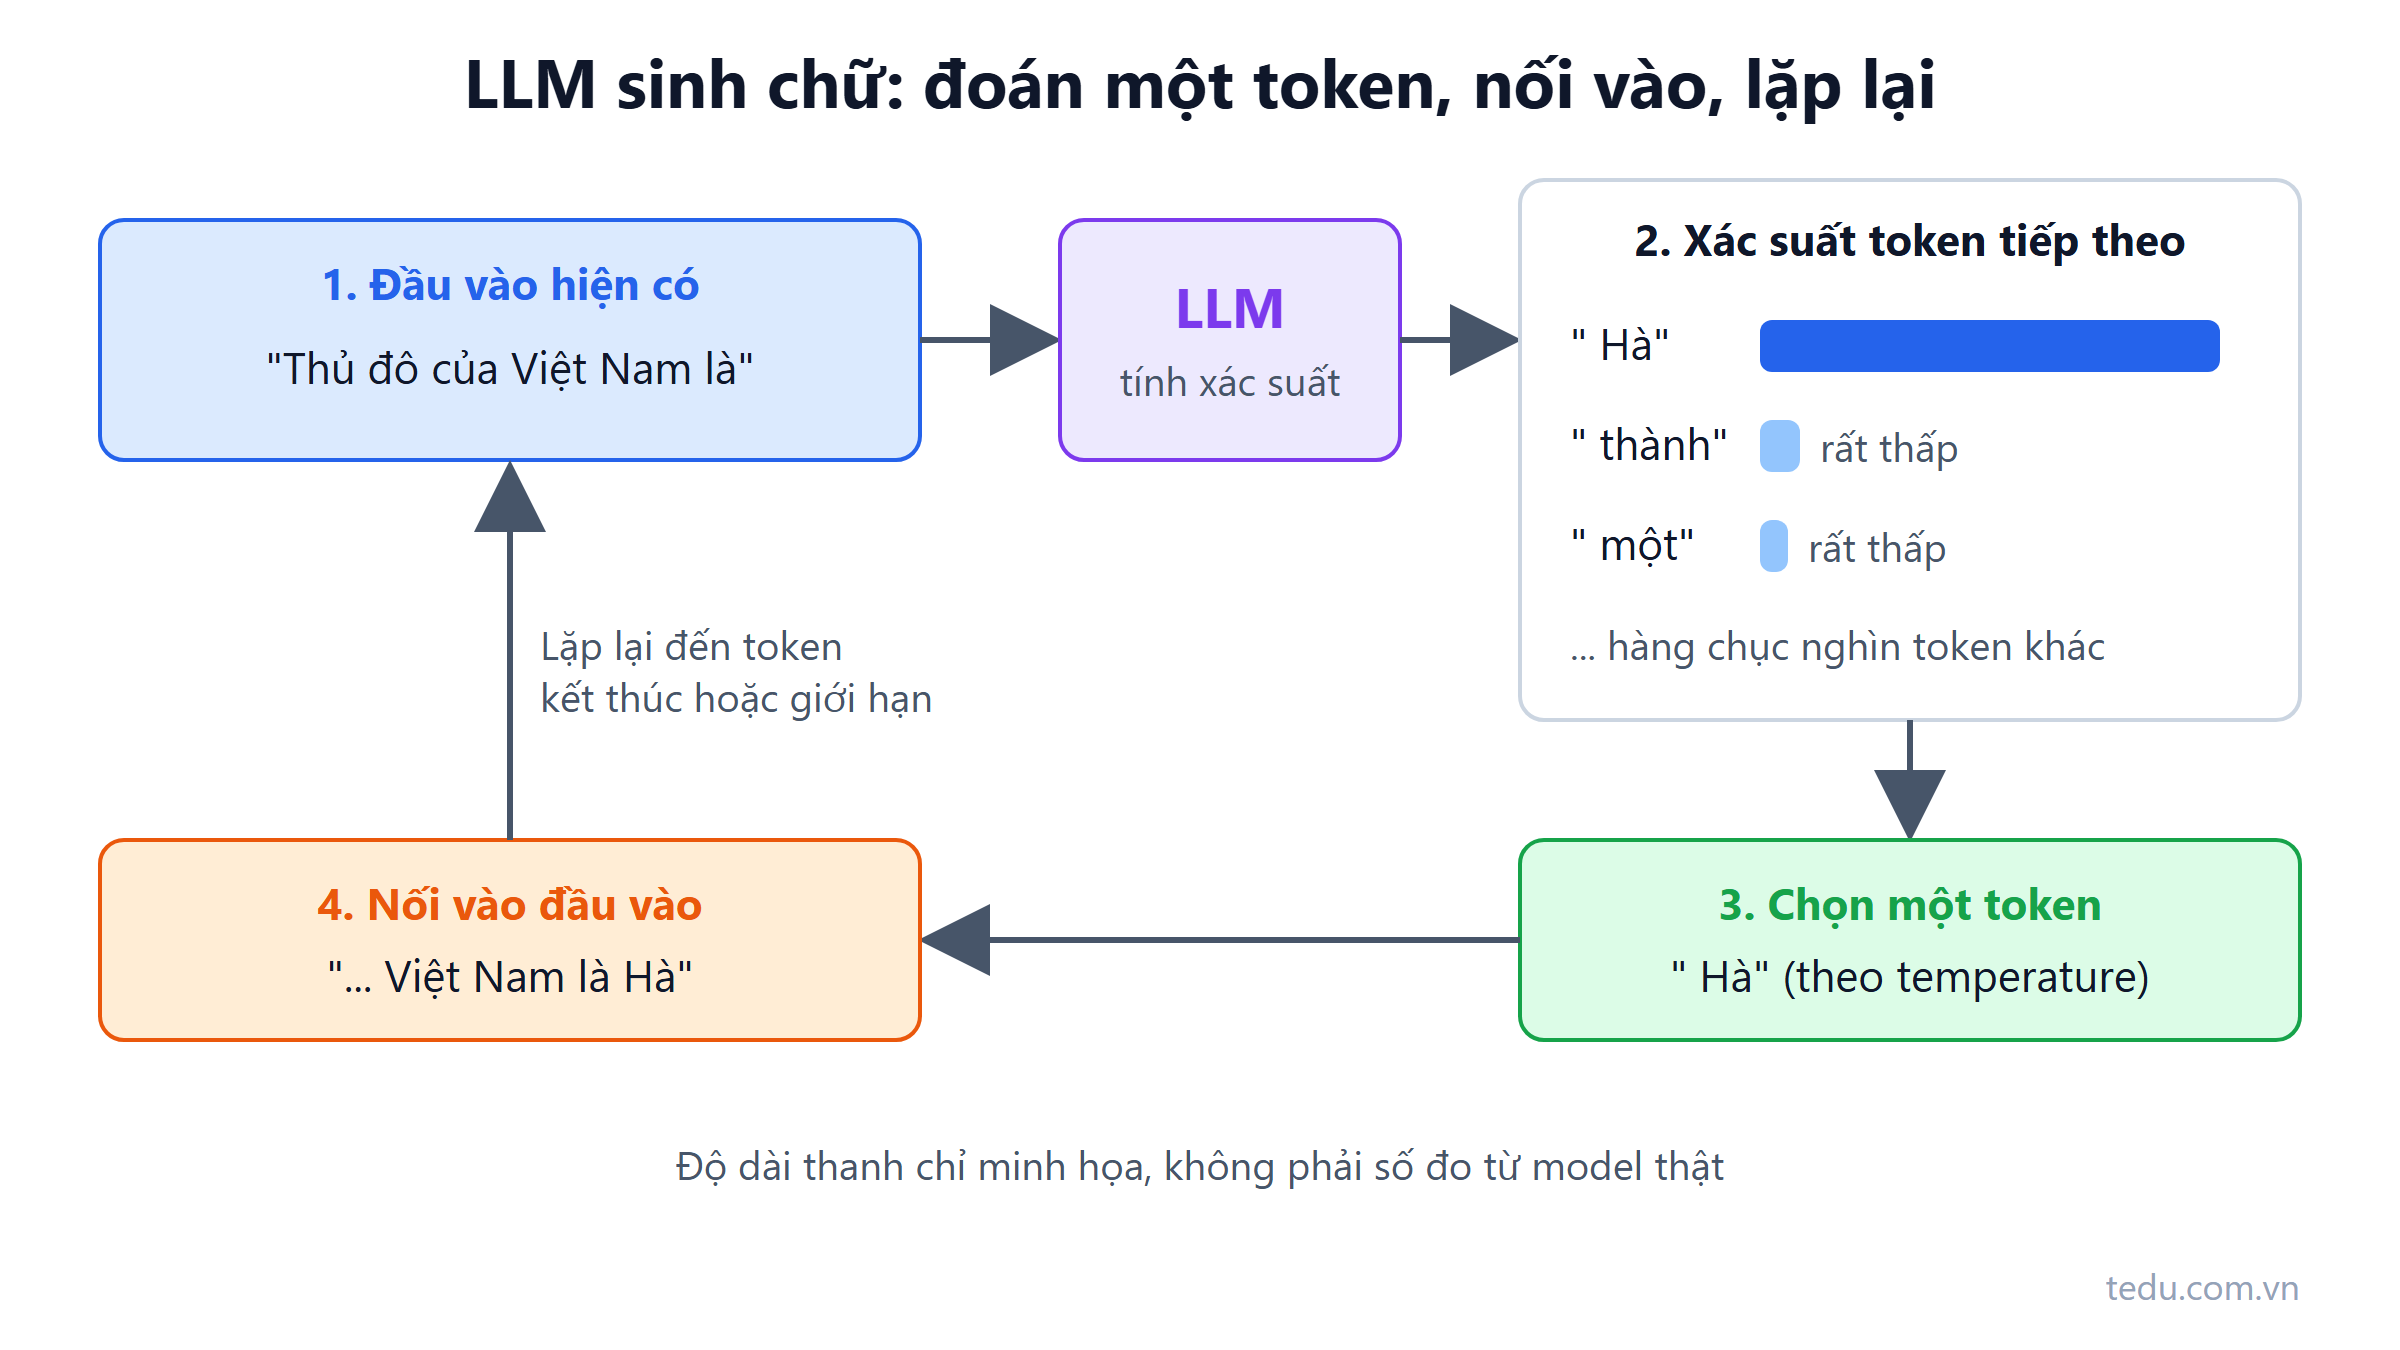
LLM hoạt động thế nào? Chỉ đoán token tiếp theo
LLM chỉ làm một việc: đoán token tiếp theo rồi lặp lại. Hiểu cơ chế này giải thích được vì sao model bịa, trả lời khác nhau mỗi lần và chậm khi viết dài.
Đọc thêm