

Temperature và top-p là gì? Chỉnh độ sáng tạo của LLM đúng cách
Team của bạn làm tính năng đọc hóa đơn đầu vào cho phòng kế toán: chụp ảnh hóa đơn, model trích ra mã số thuế, ngày lập, tổng tiền. Chạy thử 100 hóa đơn thì 97 cái đúng. Chạy lại đúng 100 hóa đơn đó, lần này chỉ đúng 93, và có 4 hóa đơn trước đúng giờ lại sai. Không ai sửa code, không ai đổi prompt.
Thủ phạm thường nằm ở một dòng cấu hình mà ai đó copy từ ví dụ trên mạng: "temperature": 1. Bài này giải thích temperature và top-p là gì, chúng tác động vào đâu trong quá trình model sinh chữ, và cách chọn giá trị hợp lý cho từng loại tác vụ thay vì để mặc định rồi cầu may.
Model không chọn một từ, nó tung xúc xắc có trọng số
Như bài LLM hoạt động thế nào đã nói, ở mỗi bước model không đưa ra "một từ đúng". Nó đưa ra một phân phối xác suất cho mọi token có thể xuất hiện tiếp theo. Sau đó một bước gọi là sampling sẽ bốc một token từ phân phối đó.
Ví dụ chatbot CSKH đang viết dở câu: "Cảm ơn anh đã ...". Model có thể cho ra phân phối như sau (số minh họa, đã rút gọn còn 5 lựa chọn):
| Token tiếp theo | Xác suất |
|---|---|
| liên hệ | 50% |
| tin tưởng | 20% |
| ủng hộ | 15% |
| mua hàng | 10% |
| chờ đợi | 5% |
Nếu luôn chọn token cao nhất (gọi là greedy), câu trả lời lúc nào cũng là "Cảm ơn anh đã liên hệ", ổn định nhưng đều đều. Nếu bốc ngẫu nhiên theo đúng tỷ lệ, cứ 20 lần thì khoảng 1 lần ra "Cảm ơn anh đã chờ đợi", nghe vẫn hợp lý. Nhưng với phân phối thật gồm hàng chục nghìn token, phần đuôi dài chứa cả những lựa chọn vô nghĩa, và thỉnh thoảng bốc trúng một cái.
Temperature và top-p là hai núm vặn can thiệp vào đúng bước bốc thăm này.
Temperature: làm phân phối nhọn hơn hoặc phẳng hơn
Temperature chia điểm số thô (logit) của mọi token cho một số T trước khi chuyển thành xác suất. Bạn không cần nhớ công thức, chỉ cần nhớ tác dụng:
T nhỏ (gần 0): chênh lệch được khuếch đại. Token mạnh nhất gần như luôn thắng.
T = 1: giữ nguyên phân phối model đưa ra.
T lớn hơn 1: chênh lệch bị san phẳng. Token yếu có cơ hội ngang ngửa token mạnh.
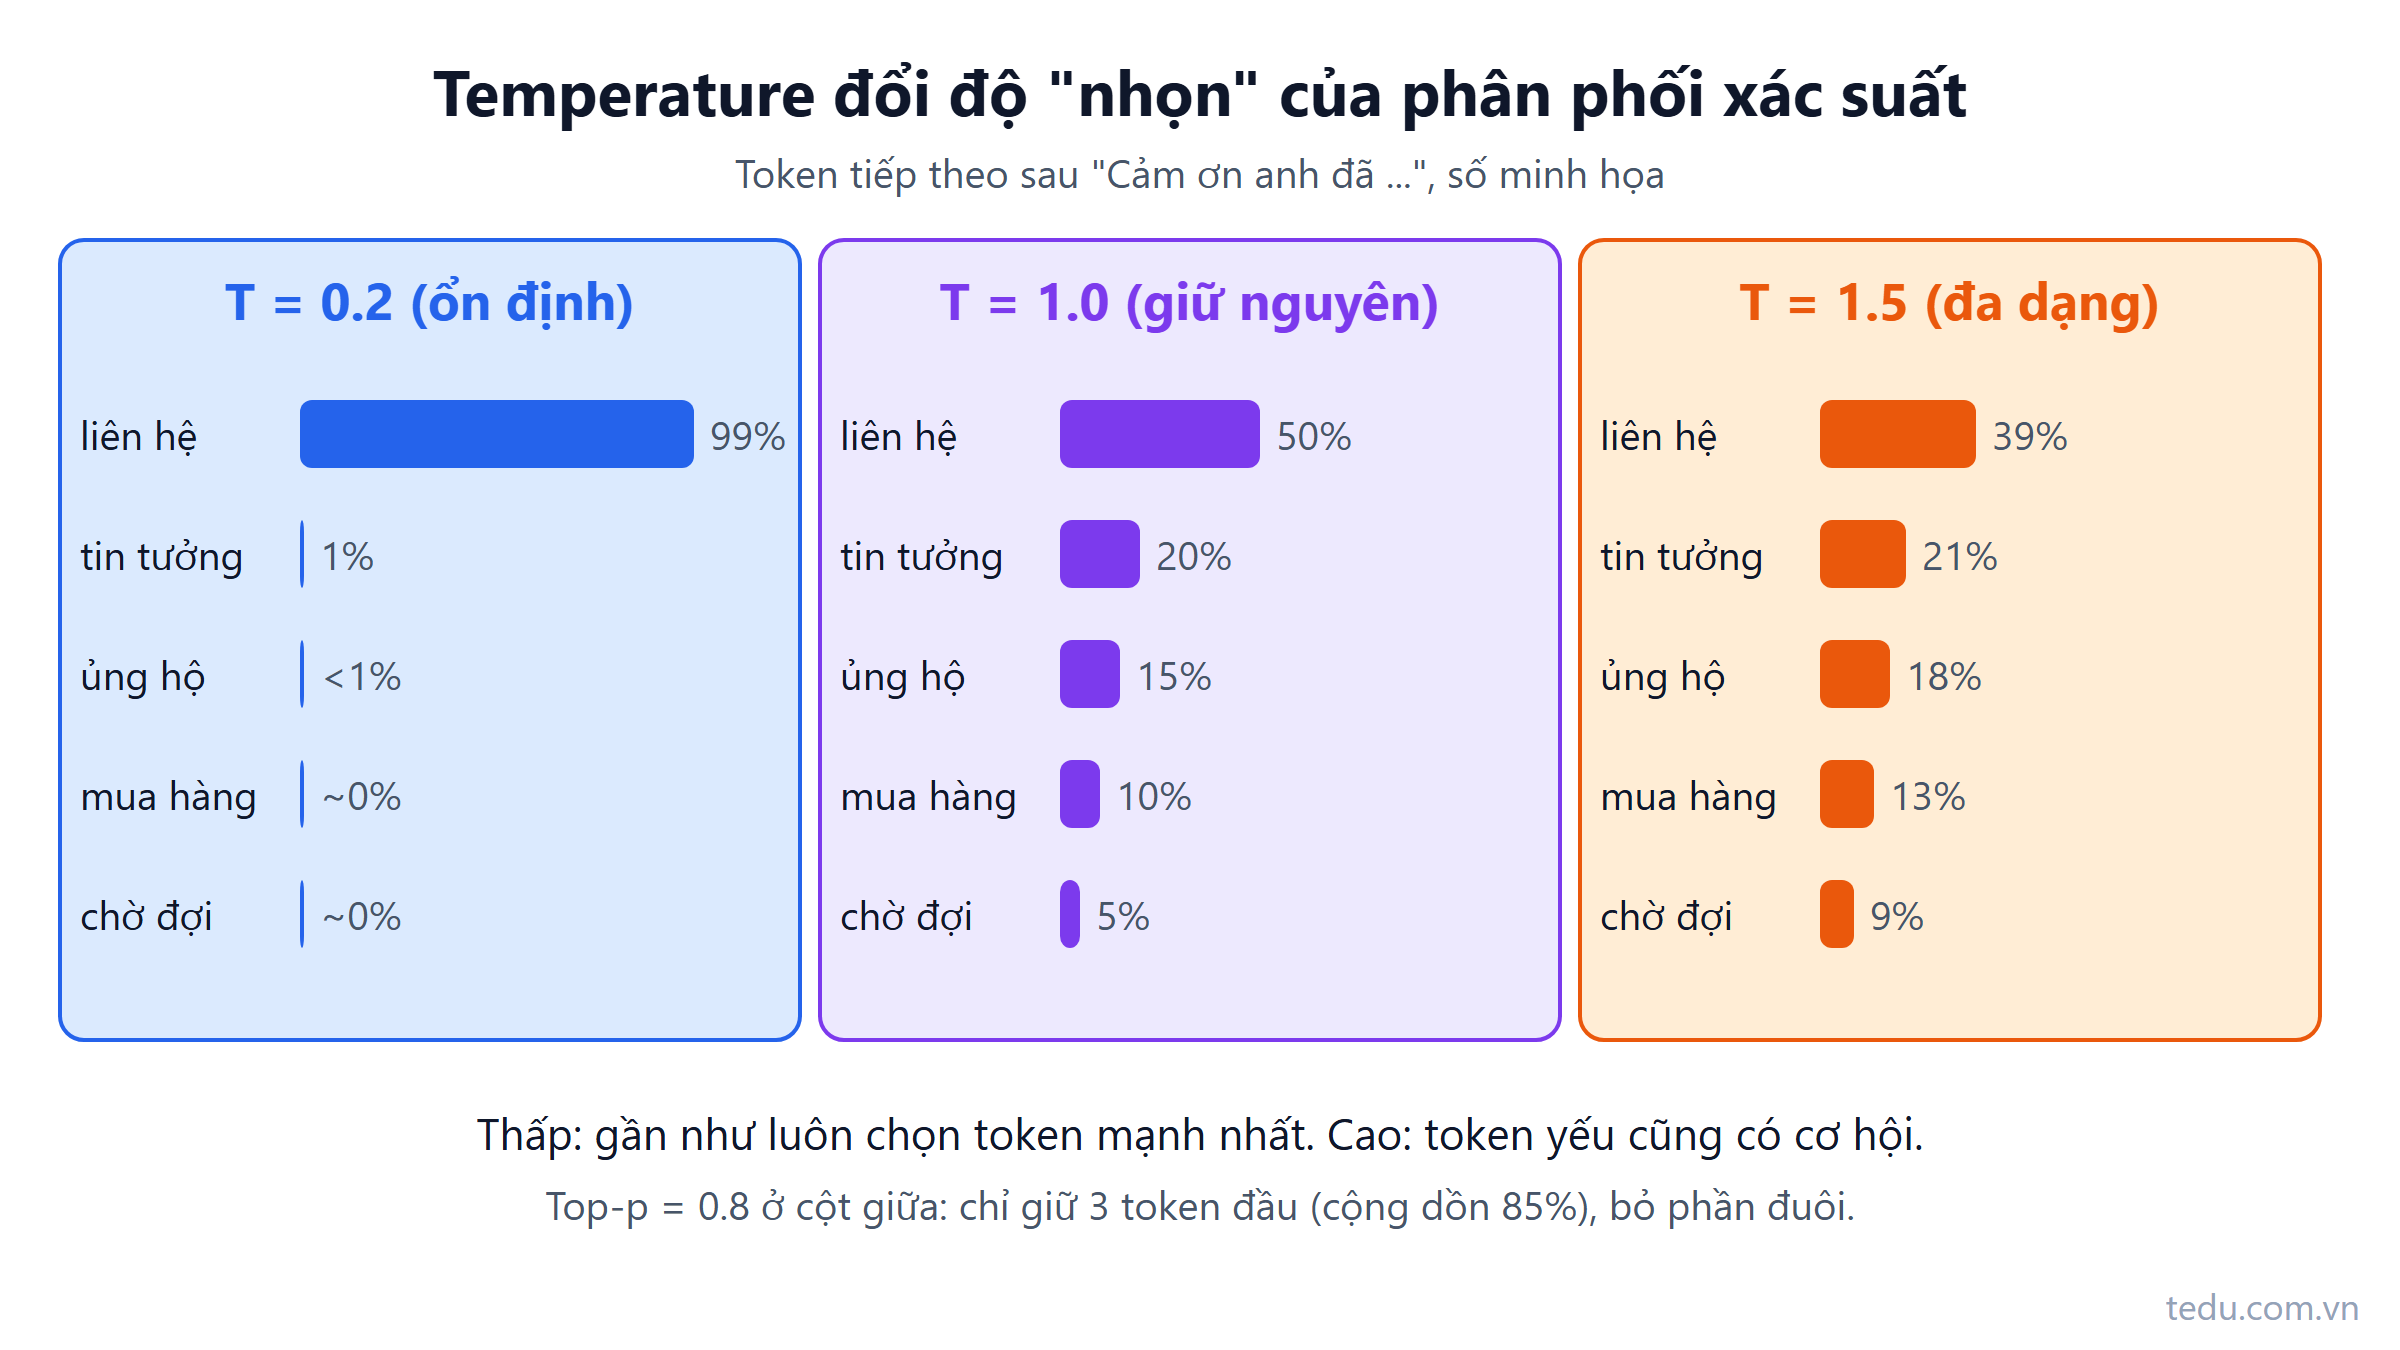
Áp vào ví dụ trên, đây là phân phối sau khi chỉnh temperature (tính từ bảng xác suất ở trên):
| Token | T = 0.2 | T = 0.5 | T = 1.0 | T = 1.5 |
|---|---|---|---|---|
| liên hệ | 98,7% | 76,9% | 50% | 39,2% |
| tin tưởng | 1,0% | 12,3% | 20% | 21,3% |
| ủng hộ | 0,2% | 6,9% | 15% | 17,6% |
| mua hàng | gần 0 | 3,1% | 10% | 13,4% |
| chờ đợi | gần 0 | 0,8% | 5% | 8,5% |
Ở T = 0.2, câu trả lời gần như cố định. Ở T = 1.5, "chờ đợi" từ 5% lên 8,5%. Nghe không nhiều, nhưng một câu trả lời dài vài trăm token là vài trăm lần bốc thăm liên tiếp. Chỉ cần lệch một lần ở token quan trọng (một chữ số trong mã số thuế chẳng hạn) là cả kết quả sai.
Đó chính là chuyện của tính năng đọc hóa đơn ở đầu bài: T = 1 khiến mỗi lần chạy là một lần bốc thăm khác nhau.
Top-p: cắt bỏ phần đuôi rủi ro
Top-p (còn gọi là nucleus sampling) làm việc khác. Thay vì đổi hình dạng phân phối, nó giới hạn tập ứng viên: sắp token theo xác suất giảm dần, cộng dồn cho đến khi đạt ngưỡng p, rồi chỉ bốc trong nhóm đó.
Với bảng gốc (T = 1):
top-p = 0.8: liên hệ (50%) + tin tưởng (cộng dồn 70%) + ủng hộ (cộng dồn 85%, vượt 80%). Còn lại 3 ứng viên, "mua hàng" và "chờ đợi" bị loại hẳn.
top-p = 0.9: thêm "mua hàng" (cộng dồn 95%). Còn 4 ứng viên.
top-p = 1.0: không cắt gì cả.
Điểm hay của top-p là nó tự thích nghi. Khi model rất chắc chắn (một token chiếm 95%), nhóm ứng viên chỉ còn một hai token. Khi model phân vân giữa nhiều lựa chọn ngang nhau, nhóm rộng ra. Temperature thì tác động đều lên mọi bước, bất kể model chắc hay không.
Một số nhà cung cấp còn có top-k: chỉ giữ k token xác suất cao nhất. Ý tưởng tương tự nhưng cứng hơn, vì k không đổi theo độ tự tin của model.
Mô phỏng sampling bằng C#
Đoạn code dưới đây mô phỏng đúng hai bước trên với 5 token ví dụ. Đây là code minh họa để hiểu cơ chế, không phải cách gọi API: khi dùng API, bạn chỉ truyền tham số, server làm phần này.
var tokens = new[] { "liên hệ", "tin tưởng", "ủng hộ", "mua hàng", "chờ đợi" };
var probs  = new[] { 0.50, 0.20, 0.15, 0.10, 0.05 };

var rng = new Random(42);
var counts = new Dictionary<string, int>();
for (var i = 0; i < 1000; i++)
{
    var t = Sample(tokens, probs, temperature: 0.5, topP: 0.9, rng);
    counts[t] = counts.GetValueOrDefault(t) + 1;
}
foreach (var (token, n) in counts.OrderByDescending(x => x.Value))
    Console.WriteLine($"{token,-10} {n}");

static string Sample(string[] tokens, double[] probs,
    double temperature, double topP, Random rng)
{
    // 1. Temperature: chia log-xác suất cho T rồi chuẩn hóa lại (softmax)
    var logits = probs.Select(p => Math.Log(p) / temperature).ToArray();
    var max = logits.Max();
    var exps = logits.Select(l => Math.Exp(l - max)).ToArray();
    var sum = exps.Sum();
    var adjusted = exps.Select(e => e / sum).ToArray();

    // 2. Top-p: giữ nhóm token nhỏ nhất có tổng xác suất >= topP
    var ranked = adjusted.Select((p, i) => (p, i)).OrderByDescending(x => x.p).ToList();
    var nucleus = new List<(double p, int i)>();
    var cumulative = 0.0;
    foreach (var item in ranked)
    {
        nucleus.Add(item);
        cumulative += item.p;
        if (cumulative >= topP) break;
    }

    // 3. Bốc thăm trong nhóm còn lại
    var roll = rng.NextDouble() * cumulative;
    foreach (var (p, i) in nucleus)
    {
        roll -= p;
        if (roll <= 0) return tokens[i];
    }
    return tokens[nucleus[^1].i];
}
Chạy thử với vài cặp giá trị, bạn sẽ thấy ngay: T = 0.2 cho ra "liên hệ" gần như 1000/1000 lần; T = 1.5 với top-p = 1.0 thì cả 5 token đều xuất hiện đáng kể.
Chọn temperature và top-p theo tác vụ
Không có giá trị đúng cho mọi trường hợp. Bảng dưới là điểm khởi đầu hợp lý, sau đó bạn chỉnh dựa trên bộ eval của mình. Lưu ý thang đo khác nhau giữa các nhà cung cấp (có nơi cho temperature từ 0 đến 1, có nơi từ 0 đến 2), nên hãy đọc docs của model bạn dùng.
| Tác vụ | Temperature gợi ý | Vì sao |
|---|---|---|
| Trích xuất dữ liệu (hóa đơn, CCCD, đơn hàng) | 0 hoặc rất thấp | Chỉ có một đáp án đúng, không cần sáng tạo |
| Phân loại ticket, gán nhãn | 0 hoặc rất thấp | Cần kết quả ổn định để đo và so sánh |
| Gọi tool, sinh JSON theo schema | Thấp | Tên tool và tham số phải chính xác |
| Chatbot CSKH, trả lời theo tài liệu | Thấp đến trung bình | Đúng nội dung là chính, câu chữ hơi khác nhau cũng được |
| Viết mô tả sản phẩm, caption, ý tưởng marketing | Trung bình đến cao | Cần đa dạng, tránh 50 sản phẩm có mô tả giống hệt nhau |
| Brainstorm tên chiến dịch | Cao | Muốn nhiều phương án khác nhau để chọn |
Một lời khuyên nhiều nhà cung cấp đưa ra: chỉnh một trong hai, không chỉnh cả hai cùng lúc. Thường người ta chỉnh temperature và để top-p mặc định. Chỉnh cả hai làm bạn khó biết thay đổi nào gây ra kết quả nào.
Trong JSON request, hai tham số này nằm ngang hàng với messages (tên field có thể khác nhau giữa các nhà cung cấp):
{
  "model": "ten-model",
  "temperature": 0,
  "max_tokens": 500,
  "messages": [
    { "role": "system", "content": "Trích các trường từ hóa đơn VAT. Chỉ trả JSON." },
    { "role": "user", "content": "...nội dung hóa đơn..." }
  ]
}
Những hiểu lầm hay gặp
"Temperature = 0 thì kết quả giống hệt nhau 100%." Gần như vậy, nhưng không được đảm bảo. Tính toán song song trên GPU, cách server gom request, hay việc nhà cung cấp cập nhật model đều có thể làm kết quả lệch nhẹ. Nếu hệ thống cần tái lập kết quả tuyệt đối, hãy lưu output lại thay vì hy vọng gọi lại sẽ ra y hệt.
"Temperature thấp thì model không bịa." Sai. Temperature thấp chỉ làm model chọn lựa chọn nó tự tin nhất. Nếu điều nó tự tin nhất là sai, bạn nhận một câu sai rất ổn định. Chuyện model bịa có nguyên nhân sâu hơn, được giải thích ở bài hallucination là gì.
"Temperature cao thì thông minh, sáng tạo hơn." Không. Nó chỉ đa dạng hơn. Ở mức quá cao, câu chữ bắt đầu lạc đề, sai chính tả, thậm chí ra chuỗi vô nghĩa.
"Model nào cũng chỉnh được." Một số model, nhất là các model suy luận (reasoning), cố định hoặc bỏ qua temperature và top-p. Gửi tham số không được hỗ trợ có thể bị báo lỗi hoặc bị bỏ qua âm thầm. Kiểm tra docs trước khi giả định.
Checklist áp dụng
Đặt temperature tường minh trong code cho mọi lời gọi, đừng dựa vào giá trị mặc định.
Tác vụ trích xuất, phân loại, gọi tool: bắt đầu từ 0 hoặc rất thấp.
Tác vụ viết nội dung: bắt đầu ở mức trung bình, tăng dần nếu thấy kết quả lặp lại.
Chỉ chỉnh một núm (thường là temperature) mỗi lần, đo bằng bộ eval, rồi mới chỉnh tiếp.
Đưa temperature vào cấu hình được versioning cùng prompt, để khi kết quả thay đổi bạn biết vì sao.
Khi chạy eval, chạy mỗi case vài lần để thấy độ dao động, không chỉ nhìn một lần chạy.
Tóm lại
Temperature làm phân phối xác suất nhọn hơn (ổn định) hoặc phẳng hơn (đa dạng). Top-p cắt bỏ phần đuôi các token ít khả năng. Cả hai chỉ tác động vào bước bốc thăm token, không làm model biết thêm hay hiểu đúng hơn. Với dev backend, quy tắc thực dụng là: tác vụ có một đáp án đúng thì để thấp, tác vụ cần đa dạng thì tăng dần và đo kết quả.
Nếu bạn đã đọc bài context window, giờ bạn biết thêm một tham số nữa cần đặt tường minh trong mọi request. Bài tiếp theo: Vì sao model "bịa" (hallucination), và vì sao hạ temperature không chữa được bệnh này.
Xem bản tóm tắt dưới một phút trên YouTube @teduco hoặc TikTok @teducolabs, và đọc thêm các bài khác trong chuyên mục AI cho Backend Developer.
Bài viết liên quan
Context window là gì? Hiểu "RAM" của model để không tràn bộ nhớ
Context window là giới hạn số token model đọc và viết trong một request. Bài giải thích cách chia ngân sách token, xử lý khi tràn và vì sao cửa sổ lớn chưa chắc tốt.
Đọc thêm
Attention là gì? Giải thích bằng trực giác cho dev backend
Attention là cơ chế giúp mỗi token nhìn sang các token khác để hiểu nghĩa theo ngữ cảnh. Giải thích bằng trực giác, ví dụ C# và hệ quả khi làm sản phẩm.
Đọc thêm
Embedding là gì? Biến chữ thành tọa độ để tìm theo nghĩa
Embedding biến một đoạn chữ thành dãy số như tọa độ, để câu cùng nghĩa nằm gần nhau. Bài giải thích cơ chế, cosine similarity, pgvector và các lỗi hay gặp.
Đọc thêm
Token là gì? Vì sao tiếng Việt tốn token hơn tiếng Anh
Token là gì, tokenizer chia chữ thế nào và vì sao tiếng Việt thường tốn token hơn. Kèm cách ước lượng chi phí và code C# tự đo token bằng trường usage.
Đọc thêm
LLM hoạt động thế nào? Chỉ đoán token tiếp theo
LLM chỉ làm một việc: đoán token tiếp theo rồi lặp lại. Hiểu cơ chế này giải thích được vì sao model bịa, trả lời khác nhau mỗi lần và chậm khi viết dài.
Đọc thêm