

Attention là gì? Giải thích bằng trực giác cho dev backend
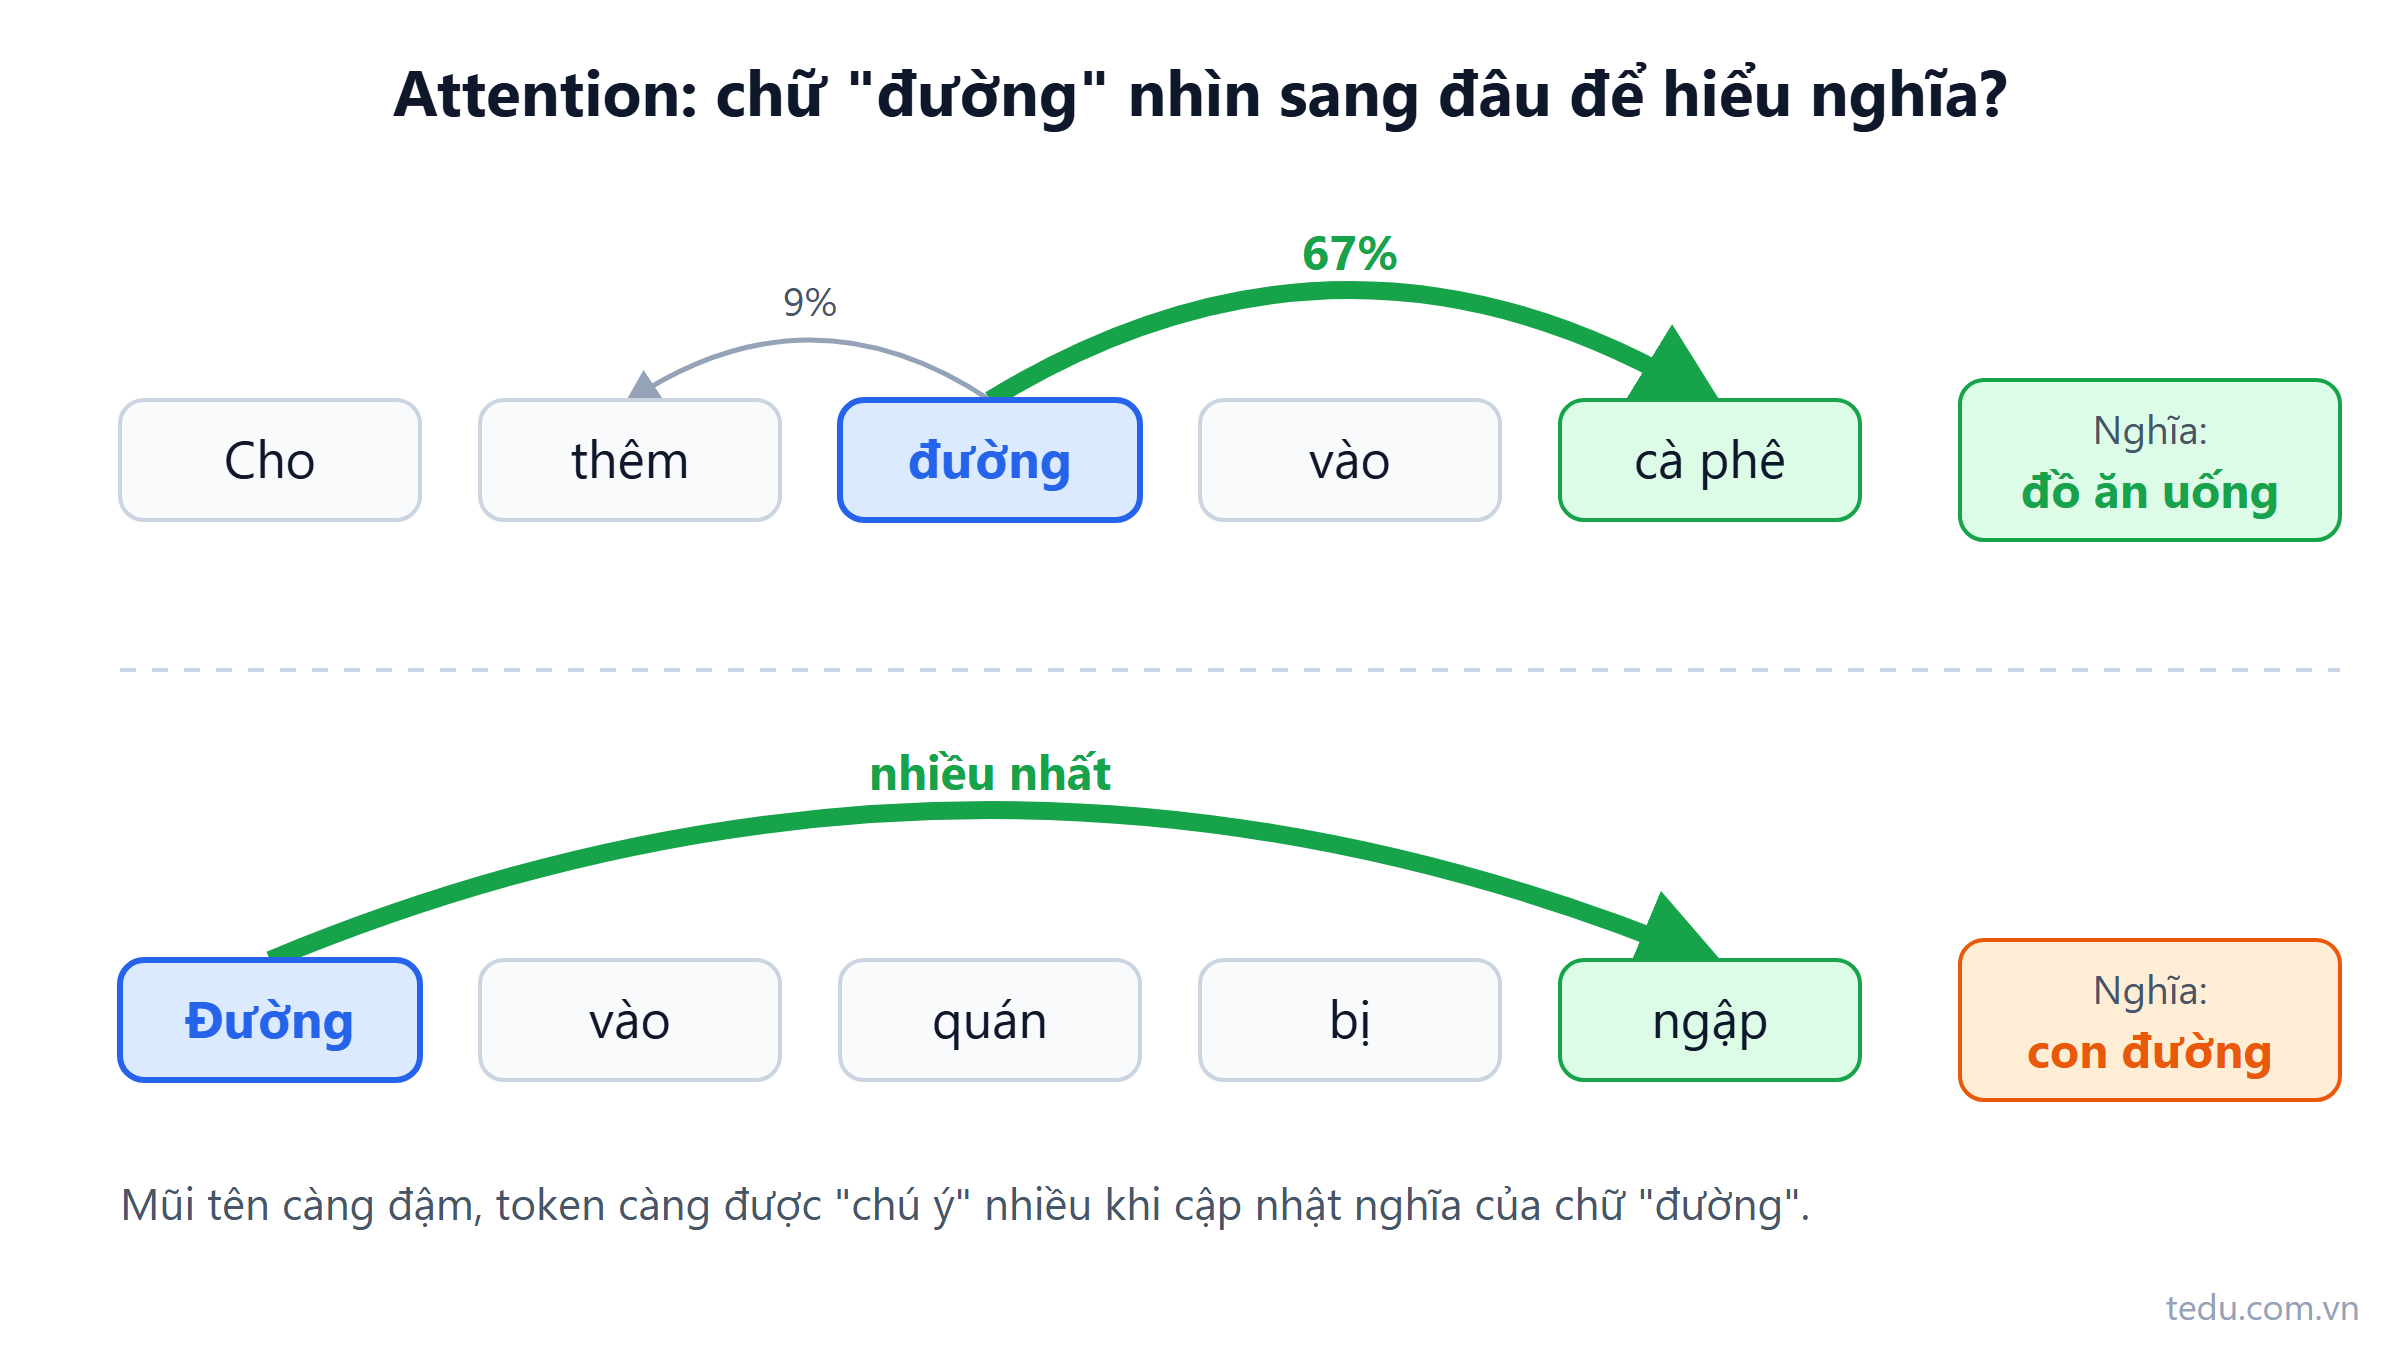
Hai khách nhắn vào fanpage một quán cà phê. Khách thứ nhất: "Cho em thêm đường vào cà phê nhé". Khách thứ hai: "Đường vào quán bị ngập, có ship không shop?". Cùng một chữ "đường", nhưng bạn đọc là hiểu ngay một bên là đồ ngọt, một bên là con đường. Bạn hiểu được vì mắt bạn tự liếc sang "cà phê" và "ngập".
Attention là cơ chế giúp model làm đúng việc liếc mắt đó. Nó là trái tim của kiến trúc Transformer, nền tảng của hầu hết LLM hiện nay. Bài này giải thích attention là gì bằng trực giác, không có công thức nào cần thuộc, và quan trọng hơn: nó ảnh hưởng thế nào tới cách bạn viết prompt, thiết kế context và trả tiền token.
Attention là gì: mỗi token tự đi hỏi các token khác
Ở bài embedding là gì, mỗi token được biến thành một vector, một tọa độ trong không gian nghĩa. Vấn đề là vector ban đầu của "đường" chỉ có một: nó không biết mình đang đứng cạnh "cà phê" hay cạnh "ngập".
Attention sửa chuyện đó. Với từng token, model làm ba bước:
Token đó đặt ra một câu hỏi: "Trong câu này, ai giúp mình hiểu rõ nghĩa của mình?"
Nó chấm điểm mức liên quan với từng token còn lại trong context.
Nó trộn thông tin của các token khác theo tỷ lệ điểm, rồi cập nhật vector của chính mình.
Sau bước này, vector của "đường" trong câu thứ nhất đã nghiêng về phía "đồ ăn uống", còn trong câu thứ hai nghiêng về phía "giao thông". Cùng một chữ, hai biểu diễn khác nhau tùy ngữ cảnh.
Điều đáng chú ý: mọi token làm việc này cùng lúc và lặp lại qua nhiều tầng (layer). Tầng đầu có thể nắm quan hệ gần như "thêm đường" là cụm động từ. Tầng sau có thể nắm quan hệ xa hơn, kiểu "anh ấy" ở câu cuối đang trỏ tới "khách hàng" ở câu đầu. Model không được ai lập trình sẵn quan hệ nào cả, nó tự học ra từ dữ liệu huấn luyện.
Query, Key, Value: phép tra cứu "mềm" mà dev nào cũng hiểu
Tài liệu về attention luôn nhắc ba chữ Query, Key, Value. Nghe học thuật, nhưng dev backend dùng thứ tương tự hằng ngày: Dictionary<string, T>.
Với Dictionary, bạn đưa một key, nó so khớp chính xác và trả về đúng một value. Không khớp thì KeyNotFoundException. Attention là phiên bản "mềm" của phép tra cứu đó:
| Dictionary trong C# | Attention | |
|---|---|---|
| Đầu vào | Một key cần tìm | Query của token hiện tại |
| So khớp | Bằng nhau hay không (true/false) | Mức giống nhau, ra một điểm số |
| Kết quả | Đúng một value | Trộn tất cả value theo tỷ lệ điểm |
| Khi không khớp | Ném exception | Vẫn trả về hỗn hợp, phần lớn từ token điểm cao |
Cụ thể, mỗi token sinh ra ba vector:
Query: "mình đang tìm thông tin gì". Với "đường", có thể hiểu là "mình là đồ ăn hay con đường?".
Key: "mình có thể cung cấp loại thông tin gì", như nhãn dán trên ngăn tủ.
Value: nội dung thật sự sẽ được trao đi nếu được chọn.
Query của token này nhân với key của các token khác để ra điểm. Điểm đi qua hàm softmax để thành tỷ lệ cộng lại bằng 1. Cuối cùng, lấy value của mọi token nhân với tỷ lệ tương ứng rồi cộng lại.
Chạy thử bằng C#
Đoạn code dưới đây mô phỏng một bước attention cho chữ "đường" trong câu "Cho thêm đường vào cà phê". Điểm số và value là số minh họa do mình đặt tay, value chỉ có 2 chiều ("ăn uống", "giao thông") cho dễ nhìn. Model thật dùng vector hàng nghìn chiều và tự học các con số này.
var tokens = new[] { "Cho", "thêm", "đường", "vào", "cà phê" };

// Điểm giữa query của "đường" và key của từng token (số minh họa)
double[] scores = { 0.2, 1.0, 1.5, 0.3, 3.0 };

// Value 2 chiều: [ăn uống, giao thông]
double[][] values =
[
    [0.0, 0.0], [0.3, 0.0], [0.5, 0.5], [0.0, 0.2], [1.0, 0.0]
];

var weights = Softmax(scores);
var output = new double[2];
for (var i = 0; i < tokens.Length; i++)
    for (var d = 0; d < 2; d++)
        output[d] += weights[i] * values[i][d];

for (var i = 0; i < tokens.Length; i++)
    Console.WriteLine($"{tokens[i],-8} {weights[i]:P0}");
Console.WriteLine($"Ăn uống: {output[0]:F2}, Giao thông: {output[1]:F2}");

static double[] Softmax(double[] xs)
{
    var max = xs.Max();
    var exps = xs.Select(x => Math.Exp(x - max)).ToArray();
    var sum = exps.Sum();
    return exps.Select(e => e / sum).ToArray();
}
Kết quả: "cà phê" chiếm khoảng 67% sự chú ý, "đường" tự nhìn chính nó khoảng 15%, các token còn lại chia nhau phần nhỏ. Vector mới của "đường" ra khoảng [0.78, 0.08], nghiêng hẳn về "ăn uống". Đổi "cà phê" thành "ngập" với value [0, 1] thì kết quả lật ngược sang "giao thông".
Đó là toàn bộ ý tưởng. Phần còn lại của Transformer là làm việc này với vector lớn hơn, nhiều lần hơn, và học các con số từ hàng nghìn tỷ token văn bản.
Multi-head và causal mask: hai chi tiết đáng biết
Nhiều "đầu" nhìn cùng lúc
Một câu có nhiều kiểu quan hệ: ngữ pháp (chủ ngữ nào đi với động từ nào), tham chiếu ("nó" là ai), chủ đề (đang nói về hóa đơn hay về giao hàng). Một phép attention duy nhất khó bắt hết. Vì vậy Transformer chạy nhiều phép attention song song, gọi là multi-head attention, mỗi head có bộ query/key/value riêng.
Đừng hiểu theo kiểu "head 3 chuyên lo đại từ". Một số nghiên cứu soi vào model thấy có head thể hiện hành vi khá rõ ràng, nhưng phần lớn là hỗn hợp khó gọi tên. Trực giác đúng là: nhiều góc nhìn tốt hơn một góc nhìn.
Chỉ được nhìn về phía trước
Khi sinh văn bản, model đoán token tiếp theo (xem LLM hoạt động thế nào). Nếu cho token hiện tại nhìn thấy token tương lai thì lúc huấn luyện coi như được xem đáp án. Do đó các model sinh văn bản dùng causal mask: mỗi token chỉ attention tới chính nó và các token đứng trước.
Hệ quả thực tế: thứ tự trong prompt có ý nghĩa. Model đọc câu hỏi đặt ở cuối thì lúc đó đã "thấy" toàn bộ tài liệu phía trên. Đặt câu hỏi ở đầu và tài liệu ở sau cũng chạy được, nhưng nhiều người thấy kết quả ổn định hơn khi nhắc lại câu hỏi hoặc yêu cầu chính ở cuối prompt. Cách chắc nhất là thử cả hai trên bộ eval của bạn.
Attention ảnh hưởng gì tới công việc của AI Engineer
Bạn không cần tự cài attention. Nhưng hiểu nó giải thích được một loạt hiện tượng bạn sẽ gặp khi làm sản phẩm.
Context càng dài càng đắt và càng chậm
Ở dạng cơ bản, mỗi token phải chấm điểm với mọi token đứng trước nó. Context 1.000 token thì số cặp cần so cỡ một triệu chia đôi; context 100.000 token thì cỡ năm tỷ. Chi phí tính toán tăng theo bình phương độ dài, không phải tuyến tính.
Các nhà cung cấp có nhiều kỹ thuật tối ưu để giảm gánh nặng này, nên con số thực tế không tệ đến vậy. Nhưng xu hướng không đổi: nhét thêm 50 trang tài liệu vào prompt thì request chậm hơn và hóa đơn dày hơn. Đây là lý do context window có giới hạn, và vì sao RAG chỉ lấy vài đoạn liên quan thay vì đưa nguyên kho tài liệu.
Sự chú ý bị chia mỏng
Softmax buộc tổng tỷ lệ bằng 1. Có 5 token thì mỗi token liên quan nhận phần lớn. Có 50.000 token, trong đó chỉ 3 câu thật sự cần, thì 3 câu đó phải giành phần chú ý với cả đống token nhiễu. Hiện tượng "lost in the middle" (model bỏ sót thông tin nằm giữa context dài) là một biểu hiện quen thuộc.
Ví dụ thật: chatbot quy chế nội bộ được nhồi cả 40 trang quy chế cho chắc. Nhân viên hỏi "nghỉ cưới được mấy ngày", đoạn trả lời nằm ở trang 23. Model trả lời theo đoạn "nghỉ phép năm" ở trang 2, vì đoạn đó cũng nói về nghỉ và nằm ở vị trí dễ được chú ý hơn. Cắt còn 3 đoạn liên quan nhất thì trả lời đúng ngay.
KV cache: vì sao token đầu tiên chậm, các token sau nhanh
Khi sinh token mới, key và value của các token cũ không đổi. Server lưu lại chúng (gọi là KV cache) để khỏi tính lại. Vì vậy:
Thời gian chờ token đầu tiên phụ thuộc nhiều vào độ dài prompt: server phải xử lý toàn bộ input trước.
Sau đó các token tiếp theo ra đều đều, đó là lý do chữ hiện ra từng chút khi streaming.
Nếu nhiều request có chung phần đầu (cùng system prompt, cùng tài liệu), nhà cung cấp có thể tái dùng phần tính toán đó. Đây là nền tảng của prompt caching ở bài 19.
Prompt mơ hồ thì attention cũng mơ hồ
Attention chỉ trộn được thông tin có trong context. Nếu prompt viết "xử lý đơn này" mà không nói "đơn" là đơn hàng, đơn nghỉ phép hay đơn khiếu nại, model phải đoán dựa trên các token xung quanh.
| Prompt | Vấn đề |
|---|---|
| Tệ: "Kiểm tra cái này giúp tôi, nó có hợp lệ không?" | "Cái này", "nó" không có gì rõ ràng để trỏ tới; model đoán theo ngữ cảnh gần nhất |
| Tốt: "Kiểm tra hóa đơn VAT dưới đây có đủ mã số thuế người mua và ngày lập không. Trả lời: hợp lệ / thiếu trường nào." | Mọi tham chiếu đều có đích rõ; model biết cần chú ý vào trường nào |
Viết prompt rõ ràng, đặt tên đối tượng cụ thể, dùng tiêu đề hoặc thẻ để chia các khối tài liệu: tất cả đều là cách giúp attention tìm đúng chỗ cần nhìn.
Lỗi hiểu sai hay gặp về attention
"Attention là model hiểu như người." Không. Đó là phép tính điểm tương đồng và trộn vector. Kết quả trông như hiểu, nhưng nó vẫn có thể chú ý nhầm chỗ một cách rất tự tin.
"Context window lớn thì cứ nhét hết vào." Model nhận được không có nghĩa là model dùng tốt. Chi phí tăng, độ chính xác có thể giảm.
"Trọng số attention cho biết vì sao model trả lời như vậy." Chỉ một phần. Soi attention có ích để gợi ý, nhưng không phải lời giải thích đầy đủ cho quyết định của model.
"Phải học toán Transformer mới làm AI Engineer được." Bạn cần trực giác như trong bài này để ra quyết định thiết kế. Phần đạo hàm để dành cho người huấn luyện model.
Checklist áp dụng
Giữ context gọn: chỉ đưa vào những gì cần cho câu hỏi hiện tại.
Chia tài liệu thành khối có tiêu đề rõ ràng, tránh một bức tường chữ.
Đặt yêu cầu chính ở vị trí dễ thấy, cân nhắc nhắc lại ở cuối prompt; kiểm chứng bằng eval thay vì tin cảm giác.
Dùng danh từ cụ thể thay cho "cái này", "nó", "như trên".
Đo độ trễ token đầu tiên khi tăng độ dài prompt, để thấy chi phí attention bằng số của chính hệ thống bạn.
Tóm lại
Attention là cách mỗi token tự đi hỏi các token khác "ai giúp mình hiểu mình", rồi trộn thông tin theo mức liên quan. Nó giống một Dictionary tra cứu mềm: không cần khớp chính xác, trả về hỗn hợp có trọng số. Từ trực giác này, bạn giải thích được vì sao context dài vừa đắt vừa dễ làm model bỏ sót, vì sao thứ tự và độ rõ ràng của prompt quan trọng, và vì sao token đầu tiên luôn ra chậm nhất.
Bài tiếp theo: Context window: "RAM" của model, nơi bạn sẽ tính ngân sách token cho một chatbot thật.
Xem bản tóm tắt dưới một phút trên YouTube @teduco hoặc TikTok @teducolabs, và đọc thêm các bài khác trong chuyên mục AI cho Backend Developer.
Bài viết liên quan
Temperature và top-p là gì? Chỉnh độ sáng tạo của LLM đúng cách
Temperature và top-p quyết định model chọn token tiếp theo an toàn hay phiêu lưu. Bài giải thích cơ chế bằng số cụ thể, code C# mô phỏng và cách chọn theo từng tác vụ.
Đọc thêm
Context window là gì? Hiểu "RAM" của model để không tràn bộ nhớ
Context window là giới hạn số token model đọc và viết trong một request. Bài giải thích cách chia ngân sách token, xử lý khi tràn và vì sao cửa sổ lớn chưa chắc tốt.
Đọc thêm
Embedding là gì? Biến chữ thành tọa độ để tìm theo nghĩa
Embedding biến một đoạn chữ thành dãy số như tọa độ, để câu cùng nghĩa nằm gần nhau. Bài giải thích cơ chế, cosine similarity, pgvector và các lỗi hay gặp.
Đọc thêm
Token là gì? Vì sao tiếng Việt tốn token hơn tiếng Anh
Token là gì, tokenizer chia chữ thế nào và vì sao tiếng Việt thường tốn token hơn. Kèm cách ước lượng chi phí và code C# tự đo token bằng trường usage.
Đọc thêm
LLM hoạt động thế nào? Chỉ đoán token tiếp theo
LLM chỉ làm một việc: đoán token tiếp theo rồi lặp lại. Hiểu cơ chế này giải thích được vì sao model bịa, trả lời khác nhau mỗi lần và chậm khi viết dài.
Đọc thêm