

Embedding là gì? Biến chữ thành tọa độ để tìm theo nghĩa
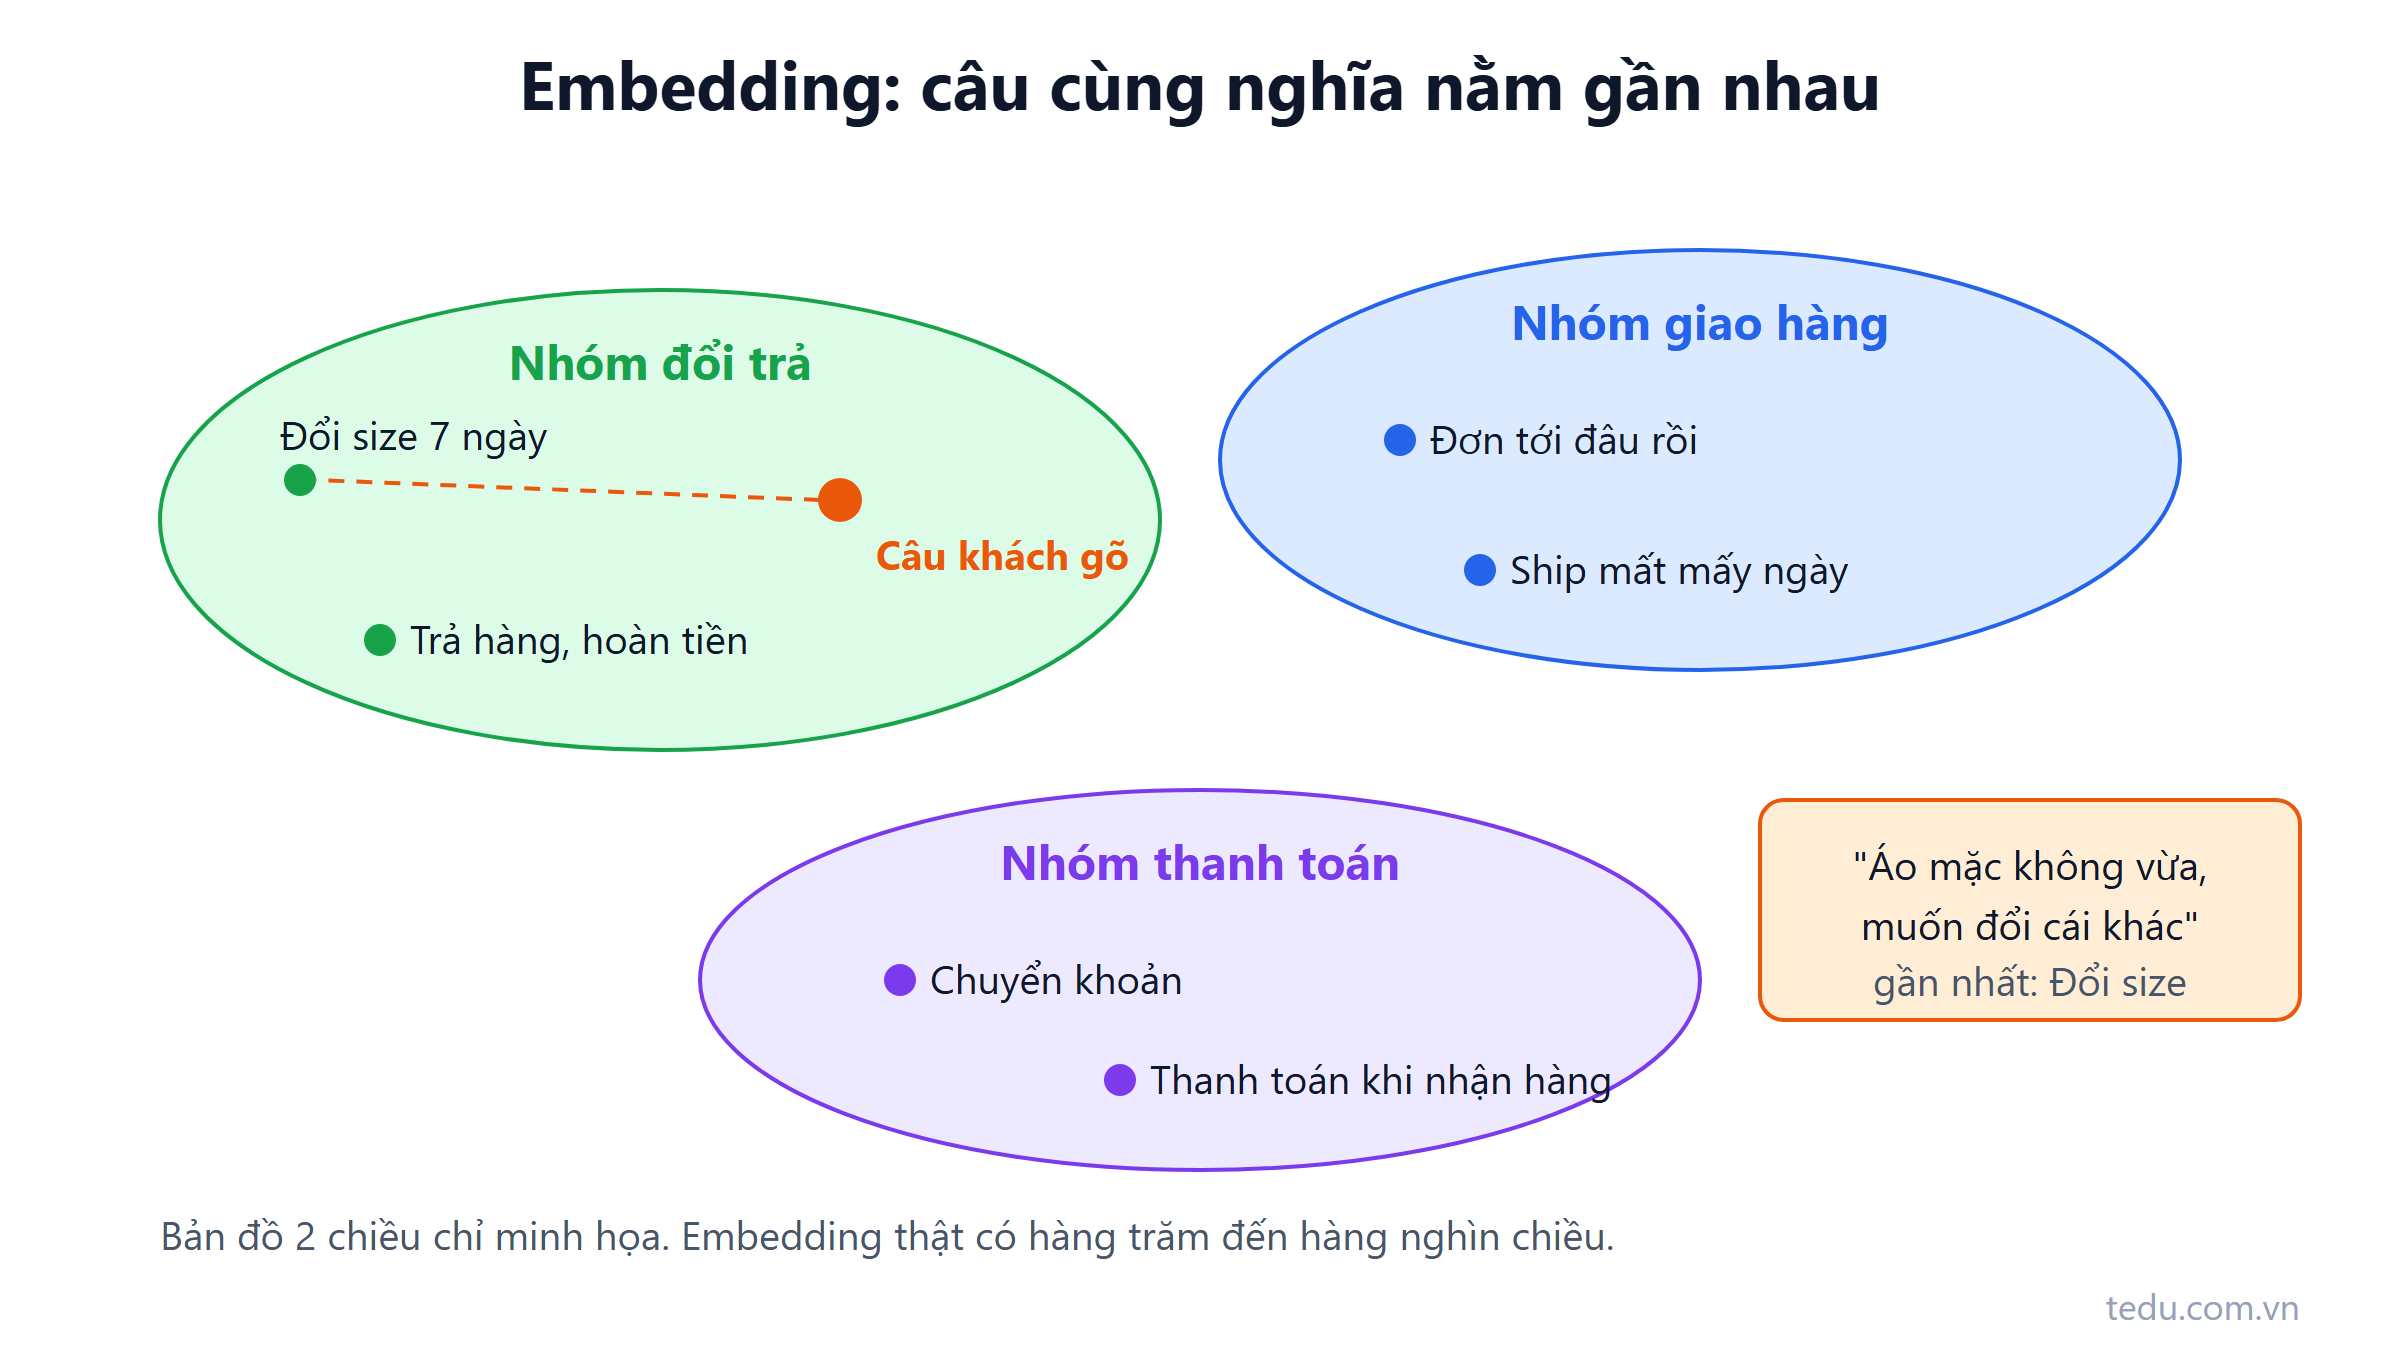
Một shop thời trang online có trang câu hỏi thường gặp với 80 mục. Khách gõ vào ô tìm kiếm: "áo mặc không vừa, muốn đổi cái khác". Hệ thống tìm theo từ khóa trả về... không có kết quả nào, vì mục cần tìm có tiêu đề "Chính sách đổi size trong 7 ngày". Không có chữ "vừa", không có chữ "cái khác". Khách thoát ra và nhắn tin hỏi nhân viên, đúng câu hỏi lần thứ 200 trong tháng.
Bài toán ở đây là tìm theo nghĩa, không theo chữ. Công cụ để làm việc đó là embedding. Bài này giải thích embedding là gì, đo "giống nghĩa" bằng cách nào, lưu và tìm trong PostgreSQL ra sao, và những chỗ embedding sẽ làm bạn thất vọng nếu dùng sai.
Embedding là gì: mỗi đoạn chữ thành một tọa độ
Embedding là một dãy số (vector) đại diện cho nghĩa của một đoạn văn bản. Một model chuyên dụng, gọi là embedding model, đọc đoạn văn và trả về dãy số đó. Các đoạn có nghĩa gần nhau sẽ cho ra dãy số gần nhau.
Cách hình dung dễ nhất là bản đồ. Mỗi quán ăn trên bản đồ có tọa độ kinh độ, vĩ độ. Hai quán gần nhau thì tọa độ gần nhau, bạn tính được khoảng cách mà không cần biết quán bán gì. Embedding làm điều tương tự cho chữ: "áo không vừa muốn đổi" và "chính sách đổi size" được đặt gần nhau trên "bản đồ nghĩa", còn "phí ship nội thành" nằm ở một khu khác.
Khác bản đồ ở chỗ: bản đồ có 2 chiều, còn embedding có hàng trăm đến vài nghìn chiều, tùy model. Bạn không vẽ được không gian đó, nhưng phép tính khoảng cách vẫn y như vậy. Mỗi chiều cũng không có tên rõ ràng kiểu "chiều thời trang" hay "chiều giao hàng"; model tự học cách sắp xếp sao cho câu cùng nghĩa nằm gần nhau.
Hai điểm dev hay nhầm ở bước đầu:
Embedding model khác chat model. Chat model sinh ra chữ bằng cách đoán token tiếp theo. Embedding model không sinh chữ, nó chỉ trả về một vector cố định số chiều. Hai loại thường có endpoint và bảng giá riêng.
Embedding không phải mã hóa hay nén. Bạn không giải ngược vector ra được câu gốc một cách đáng tin. Vector chỉ dùng để so sánh với vector khác.
Đo "gần nghĩa" bằng cosine similarity
Có vector rồi, cần một cách đo hai vector gần nhau bao nhiêu. Cách phổ biến nhất là cosine similarity: đo góc giữa hai vector. Hai vector cùng hướng cho kết quả gần 1, càng lệch hướng thì càng nhỏ.
Bạn không cần nhớ công thức để dùng, nhưng viết ra bằng C# thì nó chỉ vài dòng:
static double CosineSimilarity(float[] a, float[] b)
{
    if (a.Length != b.Length)
        throw new ArgumentException("Hai vector phải cùng số chiều, tức là cùng một embedding model.");

    double dot = 0, normA = 0, normB = 0;
    for (int i = 0; i < a.Length; i++)
    {
        dot   += a[i] * b[i];
        normA += a[i] * a[i];
        normB += b[i] * b[i];
    }
    return dot / (Math.Sqrt(normA) * Math.Sqrt(normB));
}
Trong thực tế bạn ít khi tự viết hàm này, vì database hoặc thư viện số học đã có sẵn (ví dụ gói System.Numerics.Tensors của .NET có hàm tính cosine similarity tối ưu). Nhưng viết một lần giúp bạn thấy embedding chẳng có gì bí ẩn: chỉ là phép nhân và cộng trên hai mảng số.
Ví dụ minh họa kết quả cho câu khách gõ "áo mặc không vừa, muốn đổi cái khác" so với ba mục FAQ. Con số chỉ để thấy thứ tự, không phải kết quả đo từ một model cụ thể, và giá trị tuyệt đối thay đổi rất nhiều giữa các model:
| Mục FAQ | Độ giống (minh họa) | Nhận xét |
|---|---|---|
| Chính sách đổi size trong 7 ngày | 0,82 | Đúng mục cần tìm, dù không trùng từ nào quan trọng |
| Hướng dẫn trả hàng và hoàn tiền | 0,71 | Liên quan, xếp thứ hai là hợp lý |
| Phí ship nội thành và ngoại thành | 0,35 | Khác chủ đề |
Tìm kiếm từ khóa trả về không kết quả. Tìm kiếm theo embedding trả về đúng mục ở vị trí đầu. Đó là toàn bộ lý do embedding có mặt trong mọi hệ thống RAG.
Lấy embedding qua API
Gọi embedding model qua API đơn giản hơn gọi chat model: gửi một hoặc nhiều đoạn văn, nhận về một mảng số cho mỗi đoạn. Dạng request và response phổ biến trông như sau; tên field (input, data, embedding) khác nhau giữa các nhà cung cấp, hãy đối chiếu tài liệu của bên bạn dùng:
POST /v1/embeddings
{
  "model": "ten-embedding-model",
  "input": [
    "Chính sách đổi size trong 7 ngày",
    "Hướng dẫn trả hàng và hoàn tiền"
  ]
}

Response:
{
  "data": [
    { "index": 0, "embedding": [0.0123, -0.0456, 0.0789, ...] },
    { "index": 1, "embedding": [0.0101, -0.0398, 0.0655, ...] }
  ],
  "usage": { "input_tokens": 18 }
}
Vài điều thực tế khi gọi:
Gửi theo lô. Embed 5.000 mục FAQ hay đoạn tài liệu thì gửi nhiều đoạn mỗi request, có giới hạn kích thước lô theo nhà cung cấp, thay vì 5.000 request riêng lẻ.
Embedding cũng tính tiền theo token, thường rẻ hơn nhiều so với chat model, nhưng vẫn nên đo. Tiếng Việt tốn token hơn ở đây cũng như ở chat.
Embed tài liệu một lần, embed câu hỏi mỗi lần. Tài liệu được embed lúc nạp dữ liệu và lưu lại; mỗi câu hỏi của người dùng chỉ cần một lần gọi embedding ngắn.
Lưu và tìm embedding bằng PostgreSQL và pgvector
Nếu bạn đã dùng PostgreSQL, không cần thêm một hệ cơ sở dữ liệu mới để bắt đầu. Extension pgvector thêm kiểu dữ liệu vector và các toán tử khoảng cách. Ví dụ cho bảng FAQ của shop (số chiều 1024 là minh họa, phải khớp đúng số chiều của embedding model bạn dùng):
CREATE EXTENSION IF NOT EXISTS vector;

CREATE TABLE faq (
    id         bigserial PRIMARY KEY,
    title      text NOT NULL,
    body       text NOT NULL,
    model_name text NOT NULL,          -- ghi lại model đã tạo embedding
    embedding  vector(1024) NOT NULL
);

-- Index HNSW cho tìm kiếm gần đúng theo cosine distance
CREATE INDEX ON faq USING hnsw (embedding vector_cosine_ops);

-- Tìm 5 mục gần nhất với vector câu hỏi ($1)
SELECT id, title, 1 - (embedding <=> $1) AS similarity
FROM faq
ORDER BY embedding <=> $1
LIMIT 5;
Toán tử <=> trả về cosine distance (khoảng cách), nên 1 - distance cho ra độ giống. Cột model_name trông thừa nhưng sẽ cứu bạn vào ngày đổi embedding model, lý do ở phần lỗi hay gặp bên dưới. Bài pgvector trên PostgreSQL đi sâu vào index, hiệu năng và khi nào cần vector database riêng.
Embedding dùng vào những việc gì
| Việc | Ví dụ trong doanh nghiệp | Ghi chú |
|---|---|---|
| Tìm kiếm ngữ nghĩa | Khách tìm FAQ bằng lời của mình, nhân viên tìm quy chế bằng câu hỏi tự nhiên | Ứng dụng phổ biến nhất |
| Bước truy xuất trong RAG | Tìm 5 đoạn quy chế liên quan rồi đưa vào prompt | Xem bài RAG là gì |
| Gom nhóm, phát hiện trùng | Gom ticket CSKH cùng một vấn đề, phát hiện câu hỏi lặp lại | Giúp biết nên viết thêm FAQ nào |
| Phân loại, định tuyến | Ticket mới gần nhóm "hoàn tiền" thì chuyển cho bộ phận kế toán | So với vector trung bình của từng nhóm |
| Gợi ý nội dung tương tự | "Bài viết liên quan", "sản phẩm tương tự theo mô tả" | Kết hợp thêm dữ liệu hành vi nếu có |
Và một việc không nên dùng embedding: tra cứu chính xác. "Đơn hàng DH-20481 đang ở đâu" cần một câu SELECT ... WHERE order_code = 'DH-20481', không cần tìm "đơn hàng gần nghĩa nhất".
Giới hạn và lỗi hay gặp với embedding
Mã số, con số và tên riêng
"Đơn DH-20481" và "đơn DH-20418" có vector gần như giống hệt nhau, vì về nghĩa chúng đều là "một mã đơn hàng". Với câu hỏi có mã sản phẩm, số hợp đồng, tên người, tìm theo từ khóa chính xác thường tốt hơn. Đây là lý do hybrid search kết hợp cả từ khóa lẫn vector.
Phủ định và chi tiết nhỏ
"Sản phẩm sale được đổi trả" và "sản phẩm sale không được đổi trả" nằm rất gần nhau trên bản đồ nghĩa, vì chúng nói về cùng một chủ đề. Embedding giỏi tìm đúng chủ đề, không giỏi phân biệt "được" với "không được". Phần đó để model sinh câu trả lời đọc kỹ đoạn văn, hoặc thêm bước xếp hạng lại.
Trộn vector từ hai model khác nhau
Vector của model A và model B nằm trên hai "bản đồ" khác nhau, kể cả khi trùng số chiều. So sánh chéo cho ra kết quả vô nghĩa mà không báo lỗi gì. Khi đổi embedding model, bạn phải embed lại toàn bộ dữ liệu. Cột model_name trong bảng giúp phát hiện và xử lý việc này từ từ thay vì vỡ trận trong một đêm.
Văn bản quá dài trong một vector
Nén cả quy chế 30 trang vào một vector giống như ghi tọa độ "Việt Nam" cho mọi quán ăn trong nước: đúng, nhưng vô dụng khi cần tìm một quán cụ thể. Tài liệu dài phải được cắt thành đoạn trước khi embed. Cắt thế nào cho đúng là chủ đề của bài chunking.
Tiếng Việt không dấu, viết tắt, teencode
Khách gõ "ao ko vua muon doi" thay vì "áo không vừa muốn đổi". Có model xử lý tốt, có model không. Đừng giả định, hãy đưa những câu kiểu này vào bộ test.
Không có ngưỡng chung cho "đủ giống"
Ngưỡng 0,8 có thể là "rất giống" với model này và "bình thường" với model khác. Nếu cần ngưỡng để quyết định "không tìm thấy", hãy chọn bằng dữ liệu thật: lấy 50 câu hỏi có đáp án biết trước, xem điểm của kết quả đúng và sai phân bố thế nào, rồi chọn ngưỡng.
Checklist khi đưa embedding vào hệ thống
Chọn embedding model bằng bộ câu hỏi tiếng Việt thật của bạn, có cả câu không dấu và viết tắt.
Lưu tên model và số chiều cùng với vector.
Cắt tài liệu dài thành đoạn trước khi embed.
Chuẩn hóa văn bản (Unicode, khoảng trắng) giống nhau ở cả lúc nạp dữ liệu và lúc tìm.
Câu hỏi có mã số, tên riêng: kết hợp tìm từ khóa hoặc truy vấn SQL trực tiếp.
Đo chất lượng tìm kiếm bằng con số: trong top 5 kết quả có đoạn đúng không, với bao nhiêu phần trăm câu hỏi.
Có kế hoạch embed lại toàn bộ khi đổi model.
Tóm lại
Embedding biến chữ thành tọa độ trên một "bản đồ nghĩa", để câu cùng ý nằm gần nhau dù không trùng từ. Đo độ gần bằng cosine similarity, lưu và tìm bằng pgvector ngay trong PostgreSQL. Embedding giỏi tìm đúng chủ đề, kém với mã số, phủ định và văn bản quá dài, nên trong hệ thống thật nó thường đi cùng tìm từ khóa, chunking và bước xếp hạng lại.
Bài tiếp theo trong series giải thích cơ chế giúp model hiểu một từ dựa vào các từ xung quanh: attention, giải thích bằng trực giác và không cần công thức.
Xem bản tóm tắt dưới một phút trên YouTube @teduco hoặc TikTok @teducolabs, và đọc thêm các bài khác trong chuyên mục AI cho Backend Developer.
Bài viết liên quan
Temperature và top-p là gì? Chỉnh độ sáng tạo của LLM đúng cách
Temperature và top-p quyết định model chọn token tiếp theo an toàn hay phiêu lưu. Bài giải thích cơ chế bằng số cụ thể, code C# mô phỏng và cách chọn theo từng tác vụ.
Đọc thêm
Context window là gì? Hiểu "RAM" của model để không tràn bộ nhớ
Context window là giới hạn số token model đọc và viết trong một request. Bài giải thích cách chia ngân sách token, xử lý khi tràn và vì sao cửa sổ lớn chưa chắc tốt.
Đọc thêm
Attention là gì? Giải thích bằng trực giác cho dev backend
Attention là cơ chế giúp mỗi token nhìn sang các token khác để hiểu nghĩa theo ngữ cảnh. Giải thích bằng trực giác, ví dụ C# và hệ quả khi làm sản phẩm.
Đọc thêm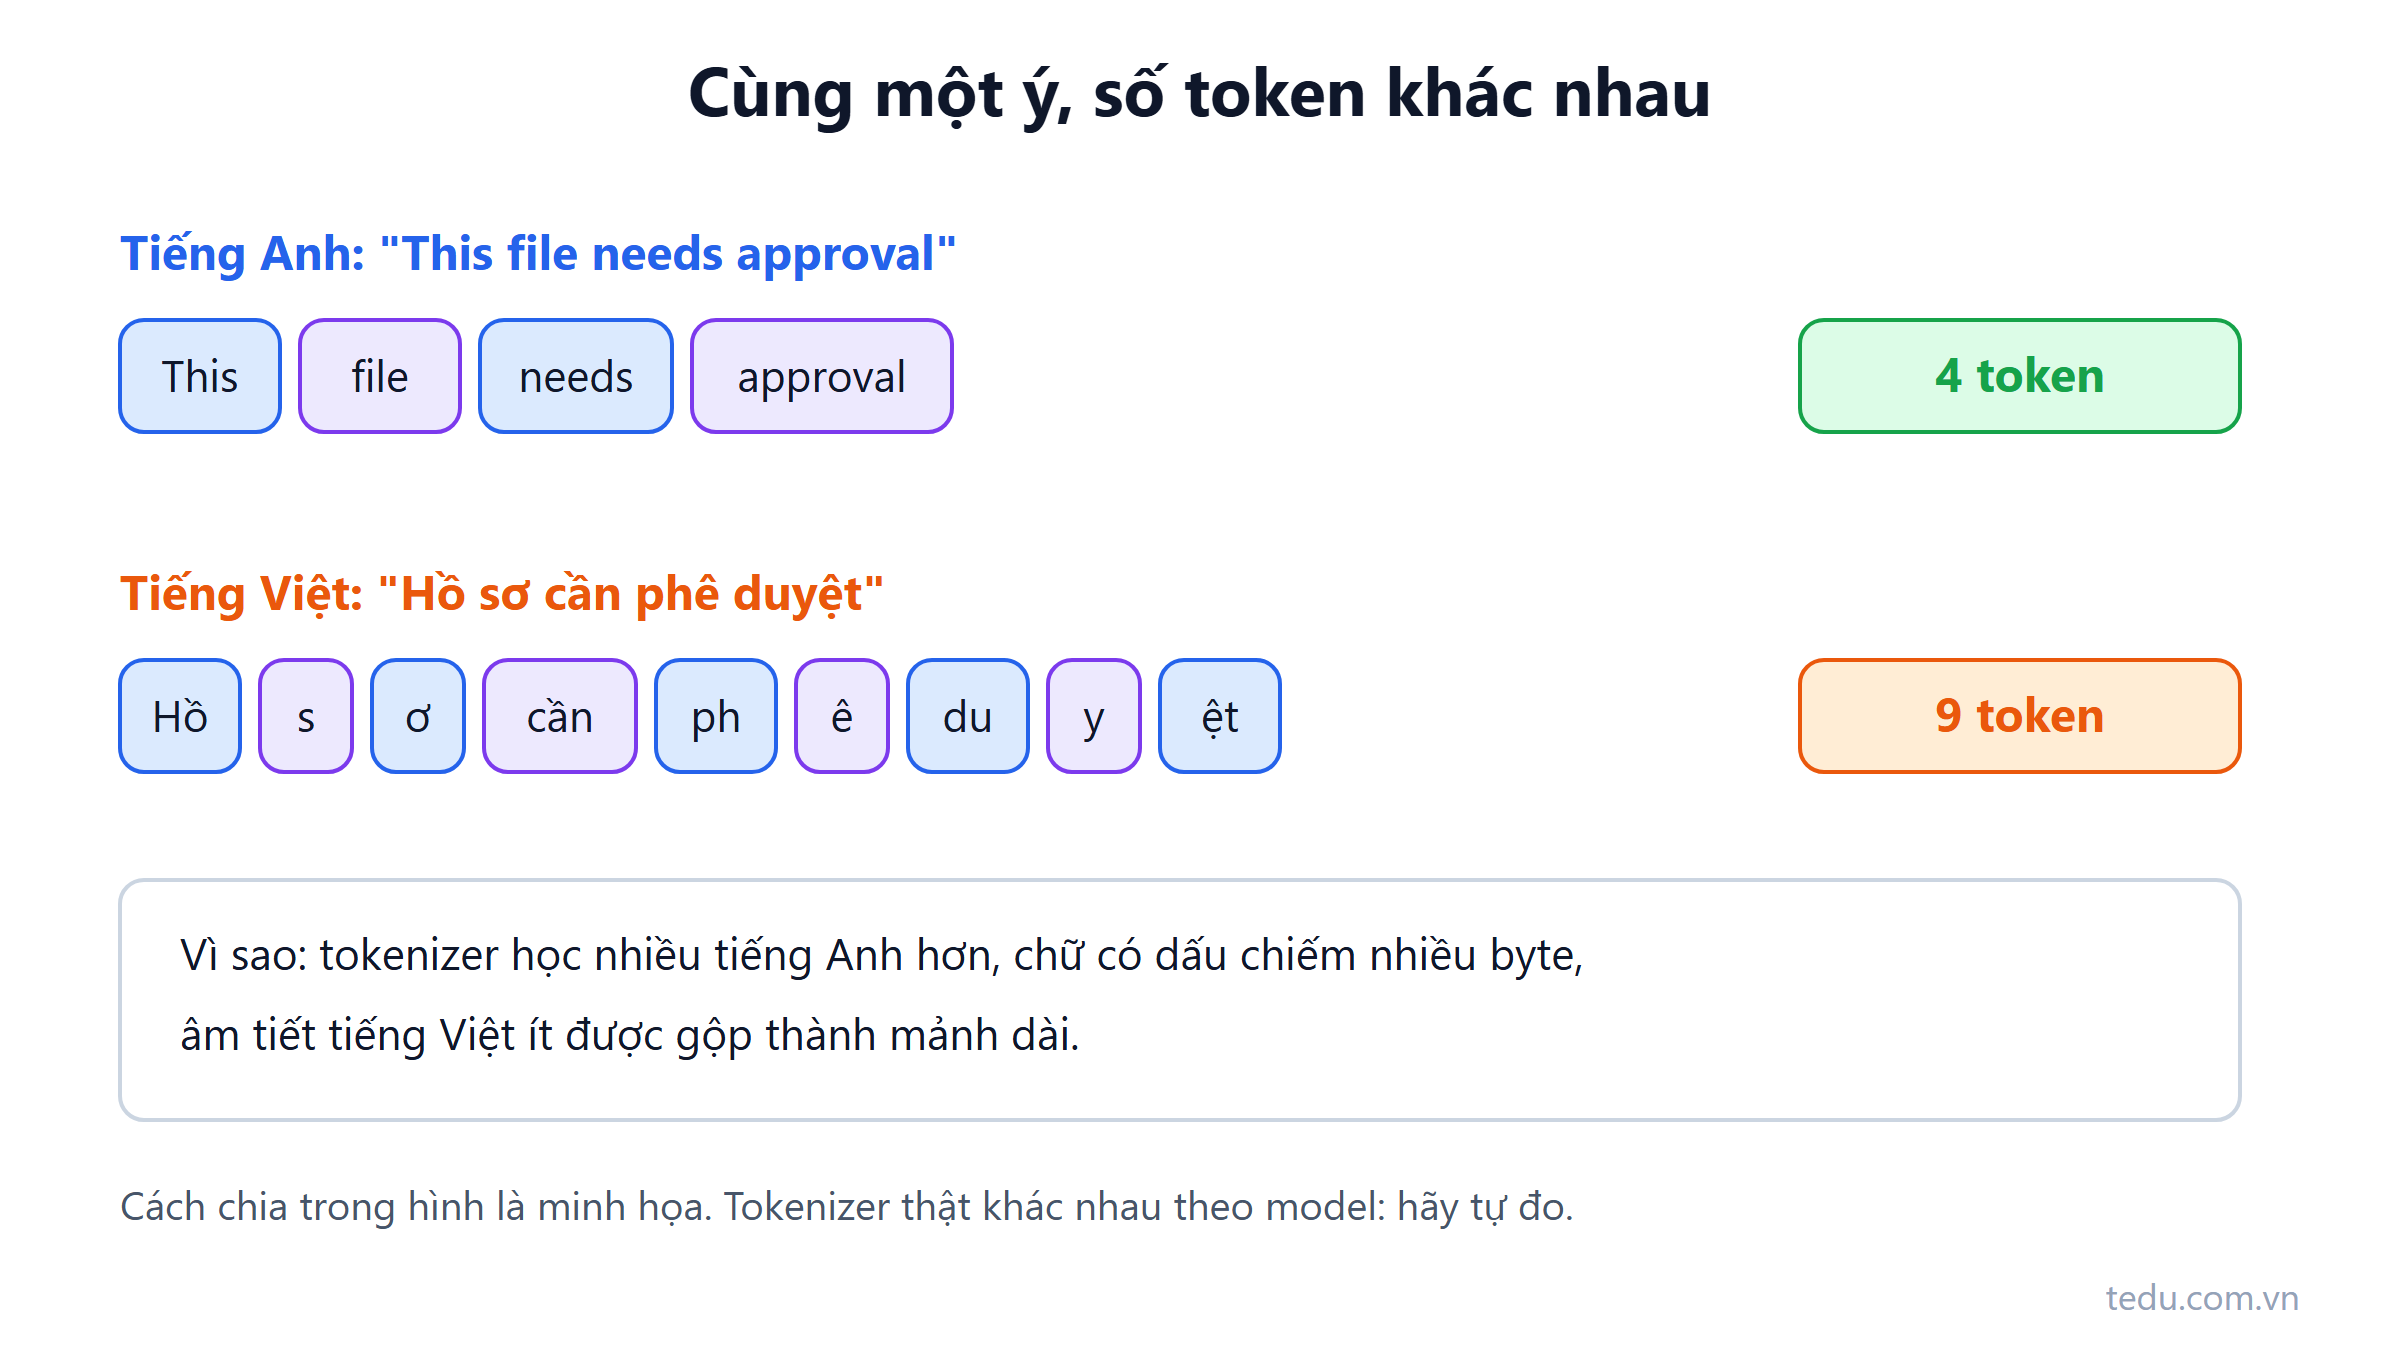
Token là gì? Vì sao tiếng Việt tốn token hơn tiếng Anh
Token là gì, tokenizer chia chữ thế nào và vì sao tiếng Việt thường tốn token hơn. Kèm cách ước lượng chi phí và code C# tự đo token bằng trường usage.
Đọc thêm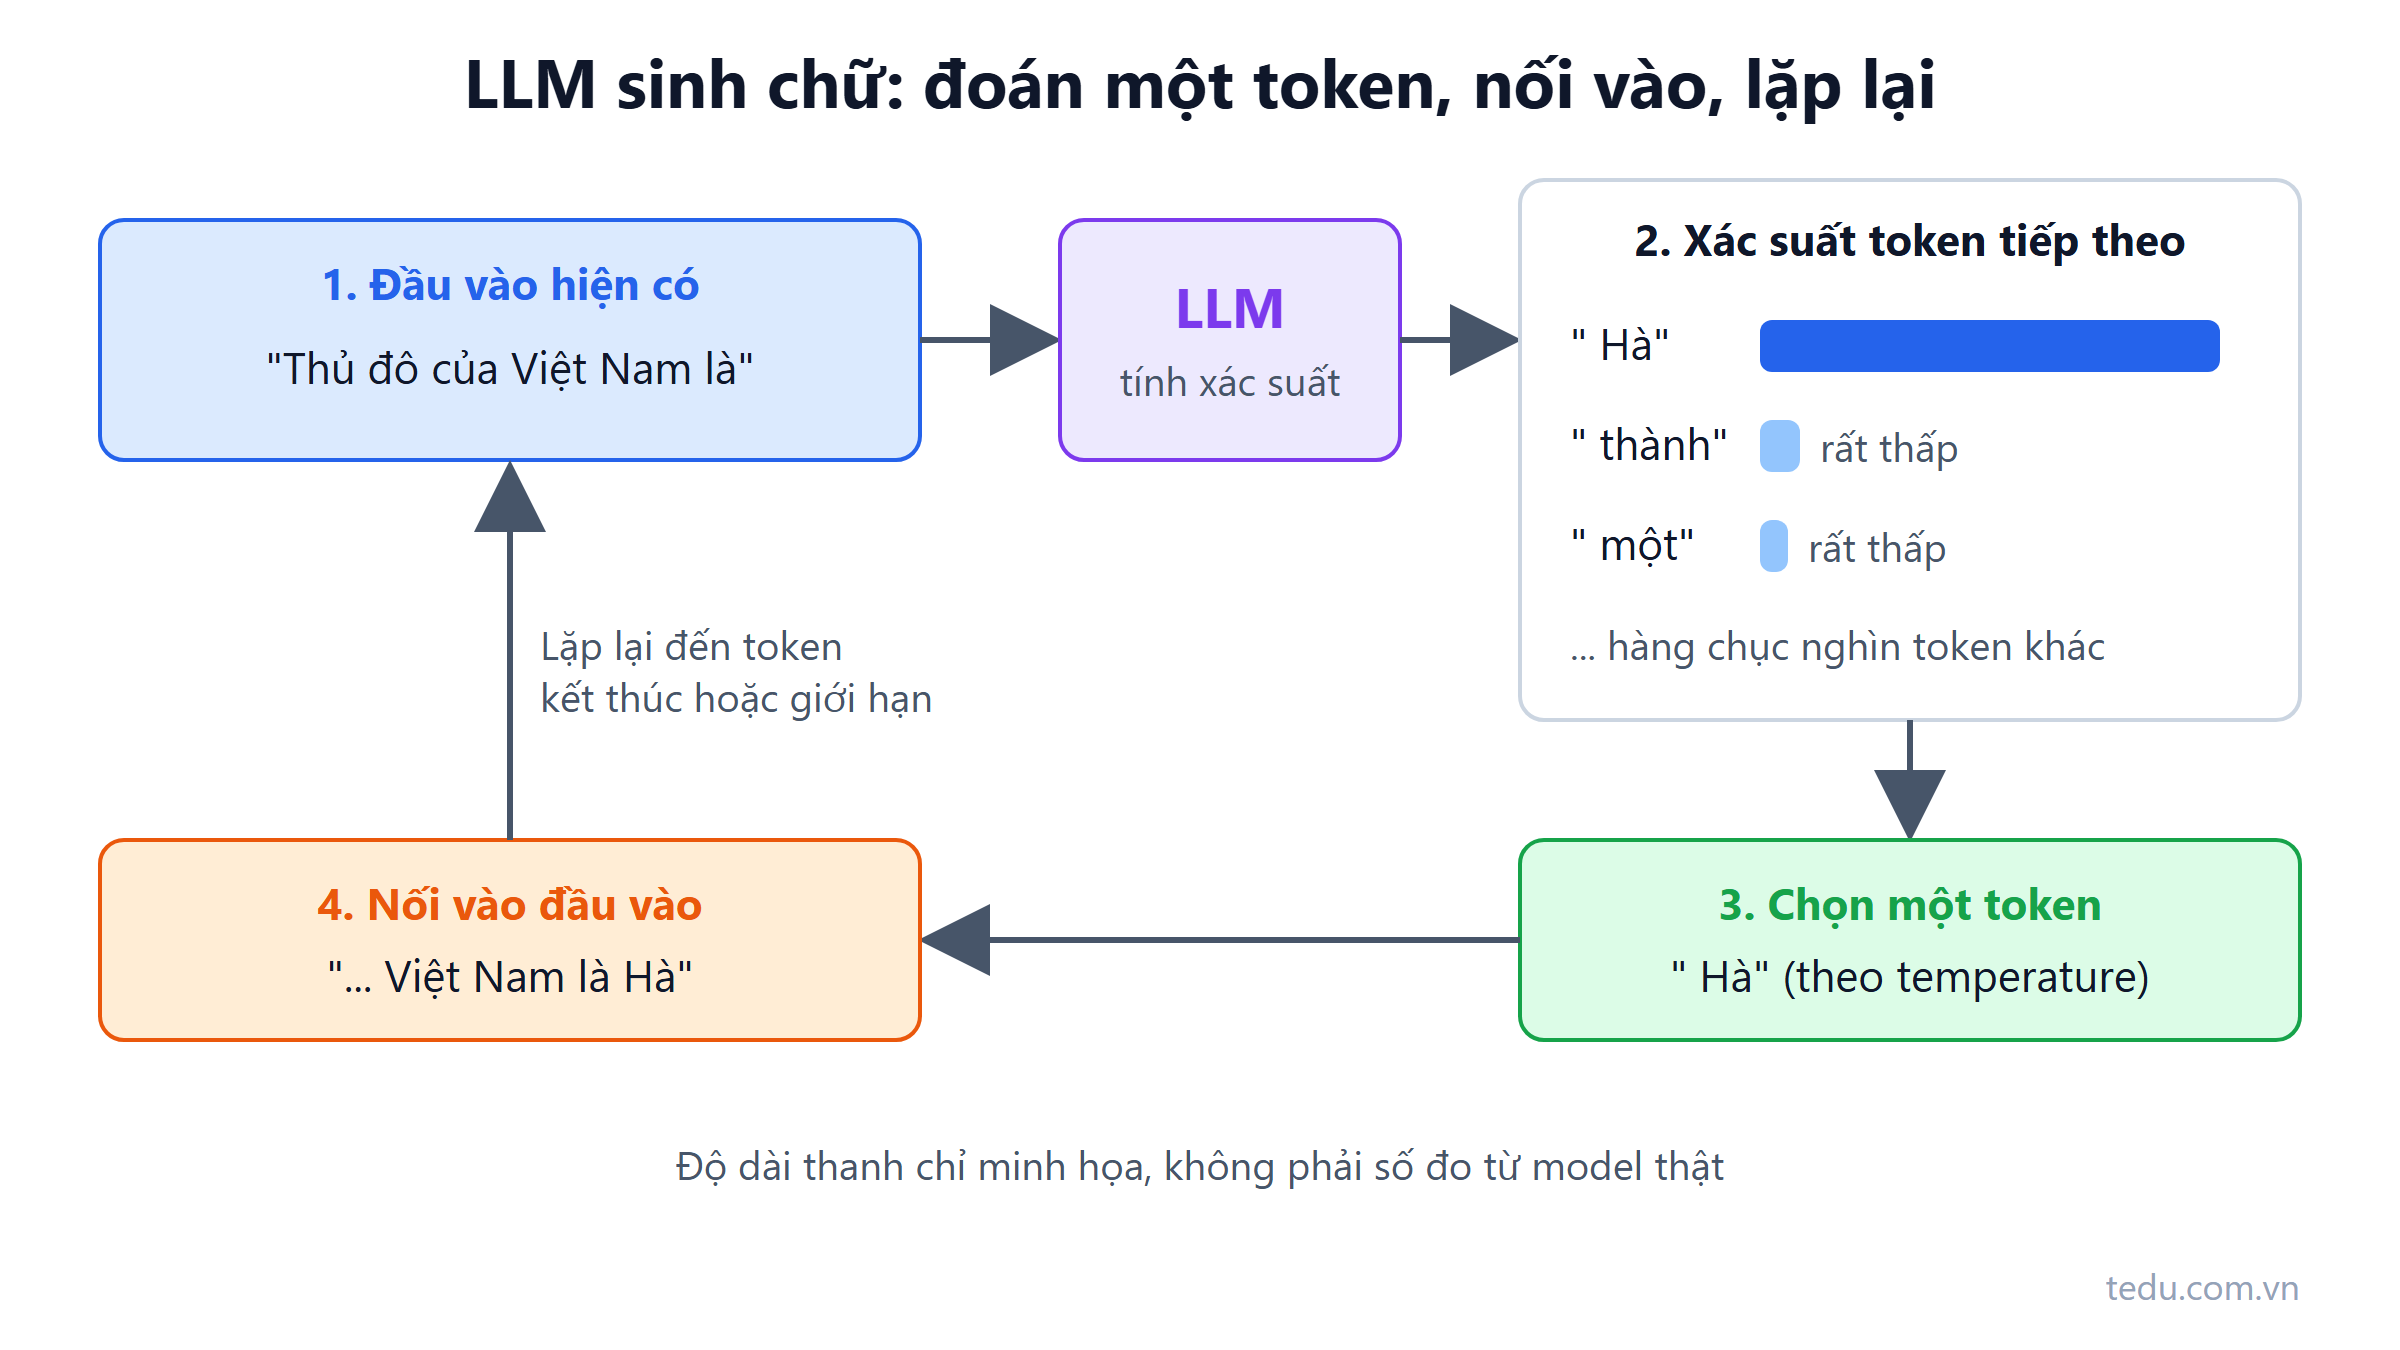
LLM hoạt động thế nào? Chỉ đoán token tiếp theo
LLM chỉ làm một việc: đoán token tiếp theo rồi lặp lại. Hiểu cơ chế này giải thích được vì sao model bịa, trả lời khác nhau mỗi lần và chậm khi viết dài.
Đọc thêm