

Context window là gì? Hiểu "RAM" của model để không tràn bộ nhớ
Một shop thời trang online gắn chatbot vào fanpage. Tuần đầu chạy ổn. Đến tuần thứ hai, vài khách "ruột" chat liên tục từ sáng đến tối để hỏi size, đổi màu, đổi địa chỉ. Đến tin nhắn thứ 80, chatbot bắt đầu trả lời kiểu lạ: quên mất mình là nhân viên của shop, xưng "tôi là một mô hình ngôn ngữ", rồi tư vấn một chính sách đổi trả mà shop chưa từng có.
Không có gì bí ẩn ở đây. Cuộc hội thoại đã vượt quá context window của model, và đoạn code nối lịch sử chat đã cắt bỏ phần đầu, trong đó có luôn system prompt. Bài này giải thích context window là gì, vì sao nên coi nó như "RAM" của model, và cách chia ngân sách token sao cho chatbot không "mất trí nhớ" giữa chừng.
Context window là gì
Context window là số token tối đa mà model xử lý được trong một request, tính cả phần bạn gửi vào (input) lẫn phần model viết ra (output). Nếu bạn chưa rõ token là gì, đọc trước bài token là gì, vì sao tiếng Việt tốn token.
Ví von dễ nhớ nhất với dev backend: context window là RAM, không phải ổ cứng.
| RAM của máy chủ | Context window của LLM | |
|---|---|---|
| Dung lượng | Cố định theo cấu hình | Cố định theo model |
| Chứa gì | Dữ liệu chương trình đang xử lý | Mọi thứ model đang "nhìn thấy" ở request này |
| Hết chỗ thì sao | Swap, chậm, hoặc OOM | Báo lỗi, hoặc bị cắt bớt nội dung |
| Sau khi xong việc | Được giải phóng | Bị quên sạch, request sau bắt đầu lại từ đầu |
| Lưu lâu dài ở đâu | Ổ cứng, database | Database, vector store, rồi nạp lại khi cần |
Dòng cuối là chỗ nhiều người hiểu sai. Model không có ổ cứng riêng cho cuộc hội thoại của bạn. Thứ gì muốn model "nhớ" thì app của bạn phải lưu ở database và gửi lại vào context ở mỗi request. Chủ đề này được nói kỹ ở bài LLM là stateless.
Trong context window có những gì
Nhiều dev nghĩ context window chỉ chứa câu hỏi của người dùng. Thực tế, câu hỏi thường là phần nhỏ nhất. Một request của chatbot chăm sóc khách hàng (CSKH) thường chứa:
System prompt: vai trò, giọng văn, chính sách shop, các điều cấm.
Định nghĩa tool: tên, mô tả, schema tham số của các hàm như tra đơn, tra tồn kho. Phần này cũng tính token.
Dữ liệu người dùng: tên khách, hạng thành viên, đơn gần nhất.
Lịch sử hội thoại: các lượt hỏi đáp trước đó.
Tài liệu truy xuất (nếu dùng RAG): vài đoạn chính sách liên quan đến câu hỏi.
Kết quả tool: dữ liệu trả về từ lần tra cứu trước, đôi khi rất dài.
Câu hỏi hiện tại.
Chỗ trống cho câu trả lời: phần output model sẽ viết ra.
Mục 8 hay bị quên. Nếu input đã chiếm gần hết cửa sổ, model chỉ còn vài chục token để trả lời, và câu trả lời bị cụt giữa chừng.
Chia ngân sách token: ví dụ chatbot shop online
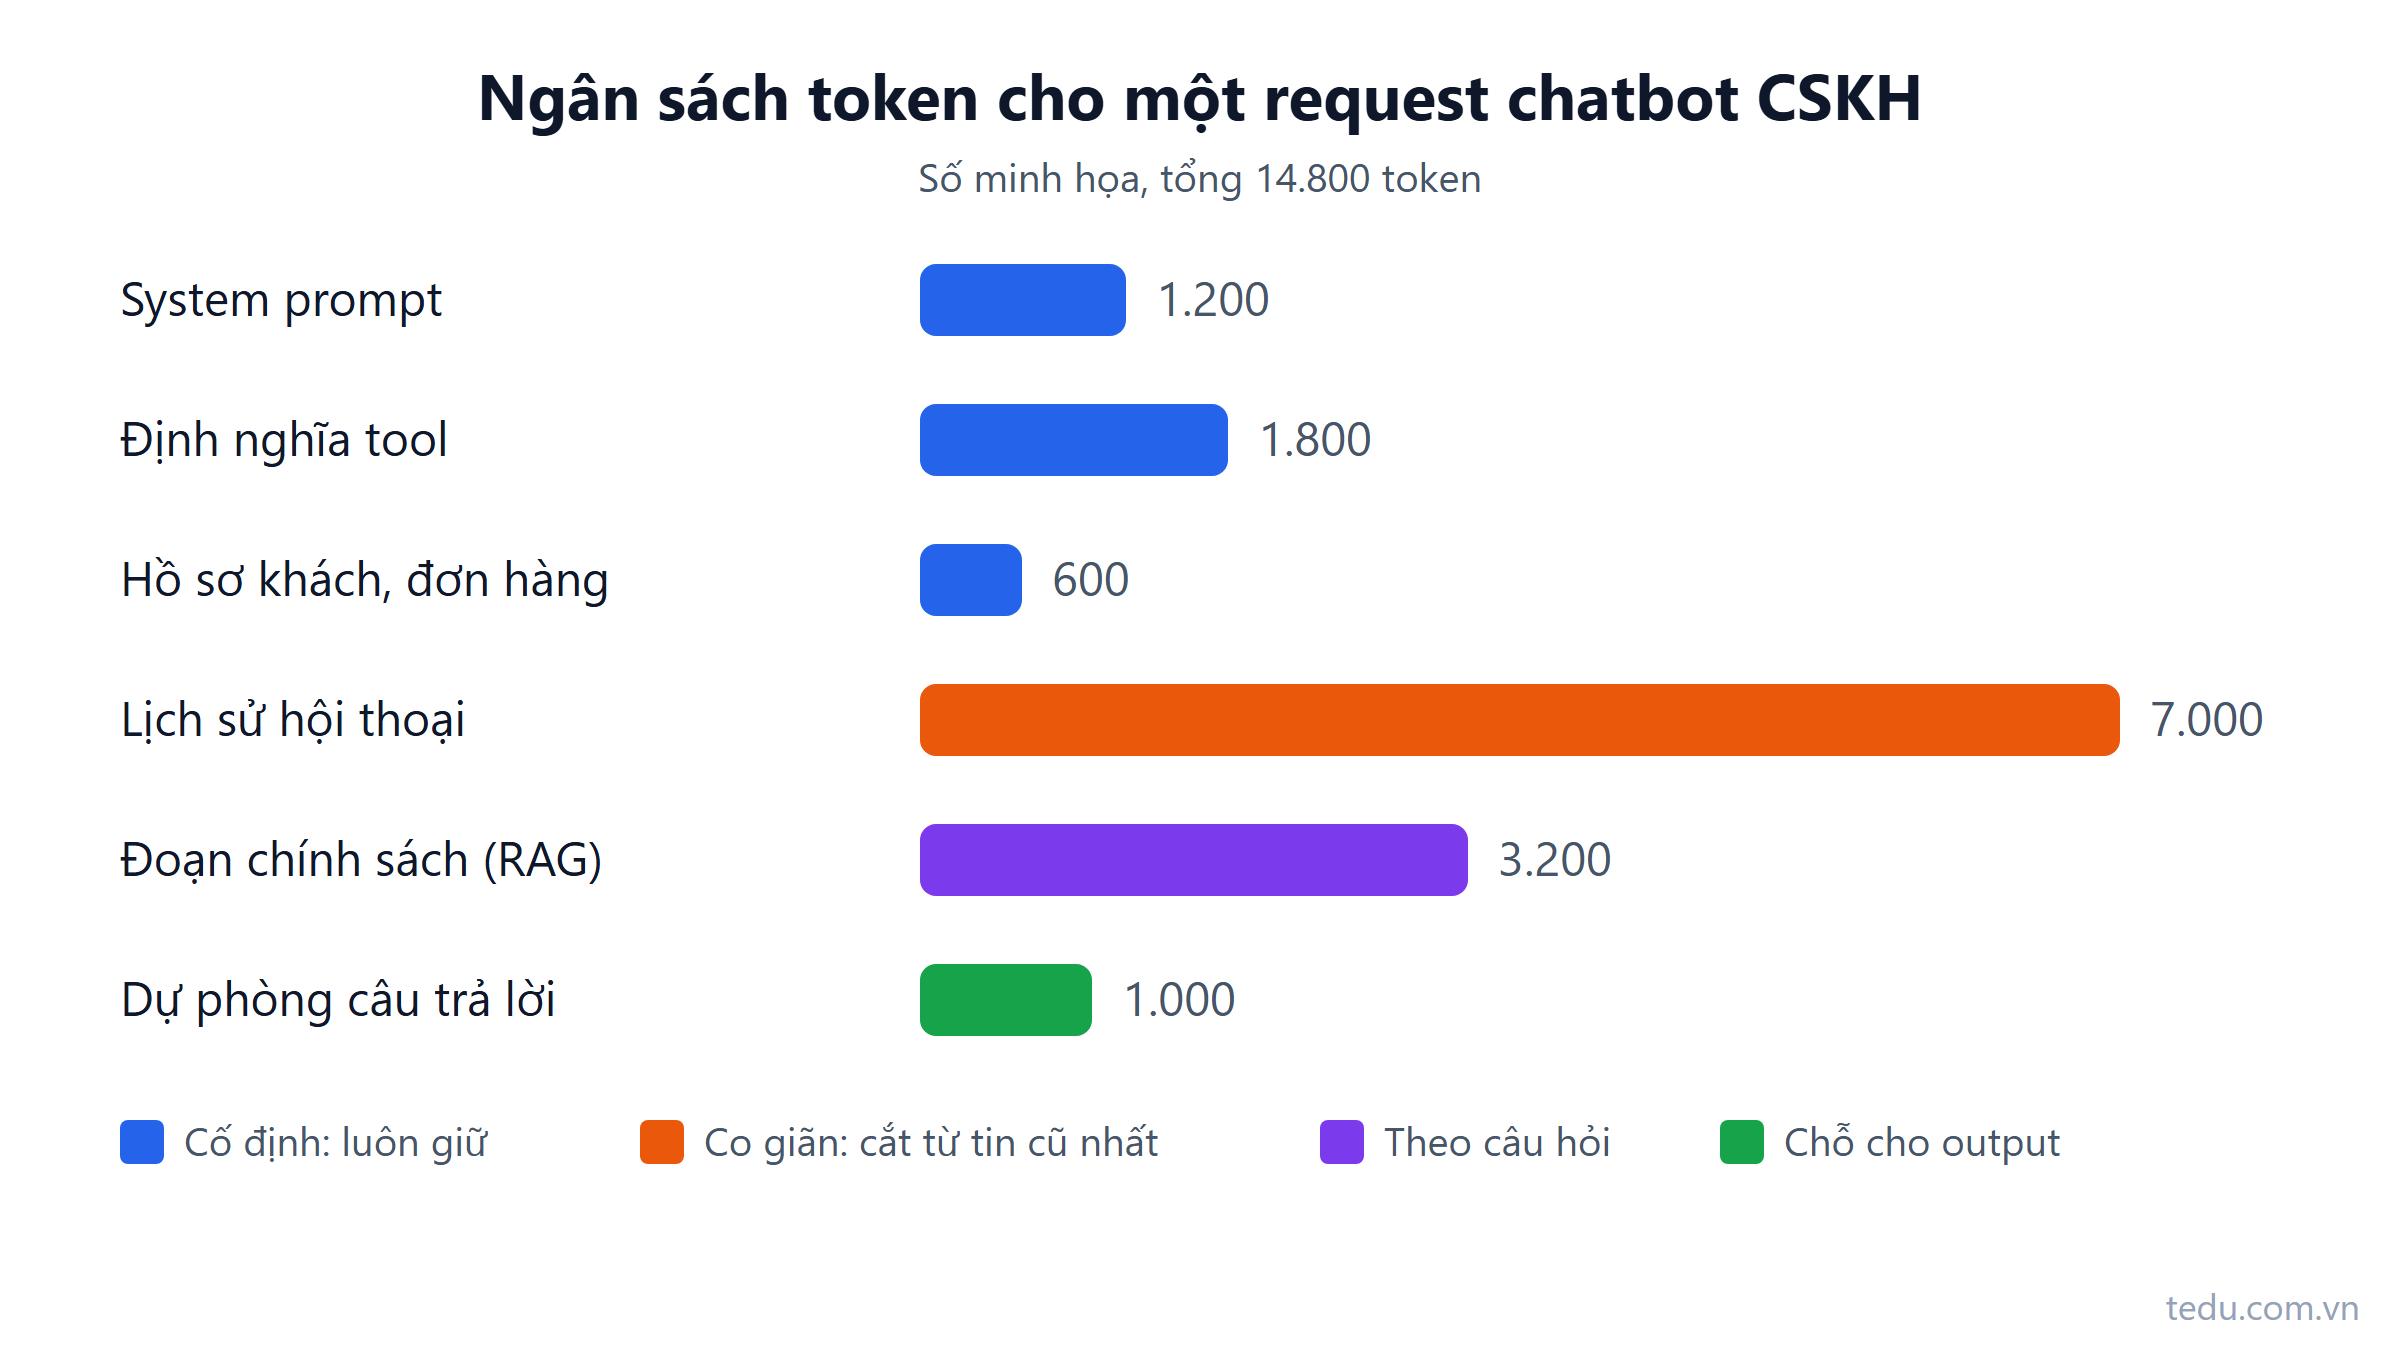
Cách làm của người có kinh nghiệm là đặt ngân sách token cho từng phần, giống như chia bộ nhớ cho từng service. Dưới đây là một bảng ngân sách cho chatbot CSKH của shop thời trang. Các con số là minh họa, bạn cần đo lại với tokenizer của model mình dùng.
| Thành phần | Ngân sách (token) | Ghi chú |
|---|---|---|
| System prompt | 1.200 | Cố định, ít thay đổi |
| Định nghĩa 6 tool | 1.800 | Cố định theo phiên bản app |
| Hồ sơ khách và đơn gần nhất | 600 | Lấy từ DB, chỉ các trường cần |
| Lịch sử hội thoại | 7.000 | Co giãn: cắt bớt khi vượt |
| Đoạn chính sách từ RAG | 3.200 | Tối đa 4 đoạn |
| Dự phòng cho câu trả lời | 1.000 | Khớp với tham số giới hạn output |
| Tổng | 14.800 | Thấp hơn nhiều so với giới hạn của model |
Bạn sẽ thắc mắc: model cho phép hàng trăm nghìn token, sao lại tự giới hạn ở mức khoảng 15 nghìn? Vì ba lý do:
Tiền: bạn trả tiền cho mọi token input ở mọi request. Lịch sử 7.000 token gửi đi 30 lần một ngày cho 1.000 khách là một con số đáng ngồi tính.
Độ trễ: prompt dài thì thời gian chờ chữ đầu tiên dài hơn. Khách hỏi "còn size M không" mà đợi 8 giây thì đã sang shop khác.
Chất lượng: thông tin quan trọng dễ bị chìm giữa context dài (hiện tượng "lost in the middle"). Xem thêm bài vì sao nhồi nhiều context lại làm model kém đi.
Chuyện gì xảy ra khi tràn context window
Có ba kịch bản, và kịch bản thứ ba nguy hiểm nhất vì nó im lặng.
1. API trả lỗi. Nhiều nhà cung cấp từ chối request khi input vượt giới hạn, kèm thông báo kiểu "context length exceeded". Ít ra bạn biết ngay mà sửa.
2. Câu trả lời bị cụt. Input vừa đủ, nhưng phần còn lại không đủ cho output. Response thường kèm một trường lý do kết thúc (tên trường khác nhau giữa các nhà cung cấp, kiểu finish_reason hoặc stop_reason) với giá trị cho biết bị dừng vì hết token. Nếu code không kiểm tra trường này, bạn sẽ gửi cho khách một câu trả lời đứt ngang, hoặc tệ hơn, một chuỗi JSON thiếu dấu đóng ngoặc làm parser nổ.
3. Bị cắt âm thầm. Một số thư viện hoặc đoạn code tự viết xử lý tràn bằng cách bỏ tin nhắn cũ nhất. Nếu tin nhắn cũ nhất là system prompt, chatbot mất luôn vai trò và chính sách. Đó chính là chuyện của shop thời trang ở đầu bài.
Cắt lịch sử đúng cách bằng C#
Nguyên tắc: phần cố định luôn được giữ, chỉ phần co giãn (lịch sử chat) bị cắt, và cắt từ tin cũ nhất. Đoạn code dưới đây minh họa ý đó. ITokenCounter là interface bạn tự định nghĩa; bên trong có thể gọi tokenizer của nhà cung cấp, API đếm token nếu họ có, hoặc tạm dùng ước lượng rồi hiệu chỉnh theo trường usage trong response.
public interface ITokenCounter
{
    int Count(string text);
}

public sealed record ChatMessage(string Role, string Content);

public static class ContextBuilder
{
    // Ước lượng chi phí phụ cho mỗi message (role, dấu phân cách)
    private const int PerMessageOverhead = 4;

    public static List<ChatMessage> FitHistory(
        IReadOnlyList<ChatMessage> history, int budget, ITokenCounter counter)
    {
        var kept = new List<ChatMessage>();
        var used = 0;

        // Đi từ tin mới nhất về tin cũ nhất
        for (var i = history.Count - 1; i >= 0; i--)
        {
            var cost = counter.Count(history[i].Content) + PerMessageOverhead;
            if (used + cost > budget)
                break;

            kept.Add(history[i]);
            used += cost;
        }

        kept.Reverse();
        return kept;
    }
}
Khi ghép request, thứ tự luôn là: system prompt, dữ liệu khách, tài liệu RAG, lịch sử đã cắt, câu hỏi mới. System prompt không bao giờ nằm trong danh sách có thể bị cắt.
Một chi tiết nhỏ nhưng hay gây lỗi: nếu lịch sử có lượt gọi tool, đừng cắt ngang giữa yêu cầu gọi tool và kết quả tool. Nhiều API sẽ báo lỗi khi thấy kết quả tool mà không có yêu cầu tương ứng phía trước. Hãy coi một cặp "gọi tool + kết quả" là một khối không tách rời.
Các chiến lược khi hội thoại dài hoặc tài liệu lớn
| Chiến lược | Cách làm | Hợp với | Đánh đổi |
|---|---|---|---|
| Cửa sổ trượt | Giữ N lượt gần nhất | Chat CSKH ngắn | Quên thông tin khách nói từ đầu |
| Tóm tắt dần | Gom các lượt cũ thành một đoạn tóm tắt | Tư vấn dài, nhiều bước | Tốn thêm một lần gọi model, có thể mất chi tiết |
| Trích thông tin quan trọng | Lưu "size M, giao Quận 7" vào hồ sơ phiên | Thông tin cần nhớ suốt phiên | Phải thiết kế schema cần lưu |
| RAG | Chỉ lấy đoạn tài liệu liên quan | Kho quy chế, catalog lớn | Thêm hạ tầng tìm kiếm |
| Rút gọn kết quả tool | Chỉ trả các trường cần thiết | Tool trả bản ghi lớn | Phải viết lớp map dữ liệu |
Với kho tài liệu lớn như bộ quy chế nội bộ hàng trăm trang, đừng dán cả bộ vào context chỉ vì model "chứa được". Hãy dùng RAG để chọn vài đoạn liên quan. Với thông tin cần nhớ lâu hơn một phiên (khách thích giao giờ hành chính, nhân viên thuộc phòng kế toán), hãy lưu thành bộ nhớ dài hạn ở database, đó là chủ đề của bài về memory của agent.
Ví dụ trước và sau
Trước: chatbot gửi nguyên lịch sử 80 lượt (khoảng 25.000 token) ở mỗi tin nhắn mới, kèm toàn bộ 12 trang chính sách đổi trả. Request chậm, tốn tiền, và thỉnh thoảng trả lời theo đoạn chính sách cũ nằm lẫn trong lịch sử.
Sau: giữ 10 lượt gần nhất, cộng một đoạn tóm tắt 300 token ("khách hỏi áo sơ mi trắng, đã chốt size M, giao Quận 7, muốn đổi sang màu xanh"), cộng 3 đoạn chính sách liên quan nhất. Input giảm còn vài nghìn token, câu trả lời bám đúng chính sách hiện hành. (Số liệu minh họa; hãy đo trên hệ thống của bạn bằng trường usage.)
Lỗi hay gặp và checklist
Những lỗi dev hay mắc khi mới làm việc với context window:
Ước lượng token bằng số ký tự hoặc số từ tiếng Anh. Tiếng Việt có dấu thường tốn token hơn, nên ước lượng thiếu.
Quên tính định nghĩa tool và kết quả tool vào ngân sách.
Đặt giới hạn output quá thấp cho tác vụ cần trả JSON dài, dẫn đến JSON bị cụt.
Không kiểm tra lý do kết thúc trong response.
Nghĩ rằng context window lớn hơn thì luôn tốt hơn, và đổi model chỉ vì "cửa sổ to hơn".
Lưu toàn bộ lịch sử chat của mọi phiên vào context của một phiên. Vừa tốn token, vừa có rủi ro lộ dữ liệu giữa các khách.
Checklist áp dụng:
Lập bảng ngân sách token cho từng thành phần và ghi vào tài liệu thiết kế.
Tách rõ phần cố định (không bao giờ cắt) và phần co giãn (được cắt).
Đếm token bằng tokenizer thật hoặc hiệu chỉnh theo
usage, không đoán.Kiểm tra lý do kết thúc của mọi response, xử lý trường hợp bị cắt.
Log số token input và output theo từng request để thấy xu hướng tăng.
Giữ cặp gọi tool và kết quả tool luôn đi cùng nhau khi cắt lịch sử.
Tóm lại
Context window là "RAM" của model: dung lượng cố định, chứa mọi thứ model nhìn thấy trong một request, và bị xóa sạch sau mỗi lần gọi. Việc của AI Engineer không phải là chọn model có cửa sổ lớn nhất, mà là chia ngân sách token hợp lý, giữ chắc phần quan trọng, cắt đúng phần có thể cắt, và đưa thông tin lâu dài ra database.
Bước tiếp theo: lấy chatbot bạn đang làm, in ra số token của từng thành phần trong một request thật. Thường bạn sẽ bất ngờ với phần định nghĩa tool hoặc kết quả tool. Bài tiếp theo trong series: Temperature và top-p là gì, hai núm vặn quyết định model trả lời "an toàn" hay "sáng tạo".
Xem bản tóm tắt dưới một phút trên YouTube @teduco hoặc TikTok @teducolabs, và đọc thêm các bài khác trong chuyên mục AI cho Backend Developer.
Bài viết liên quan
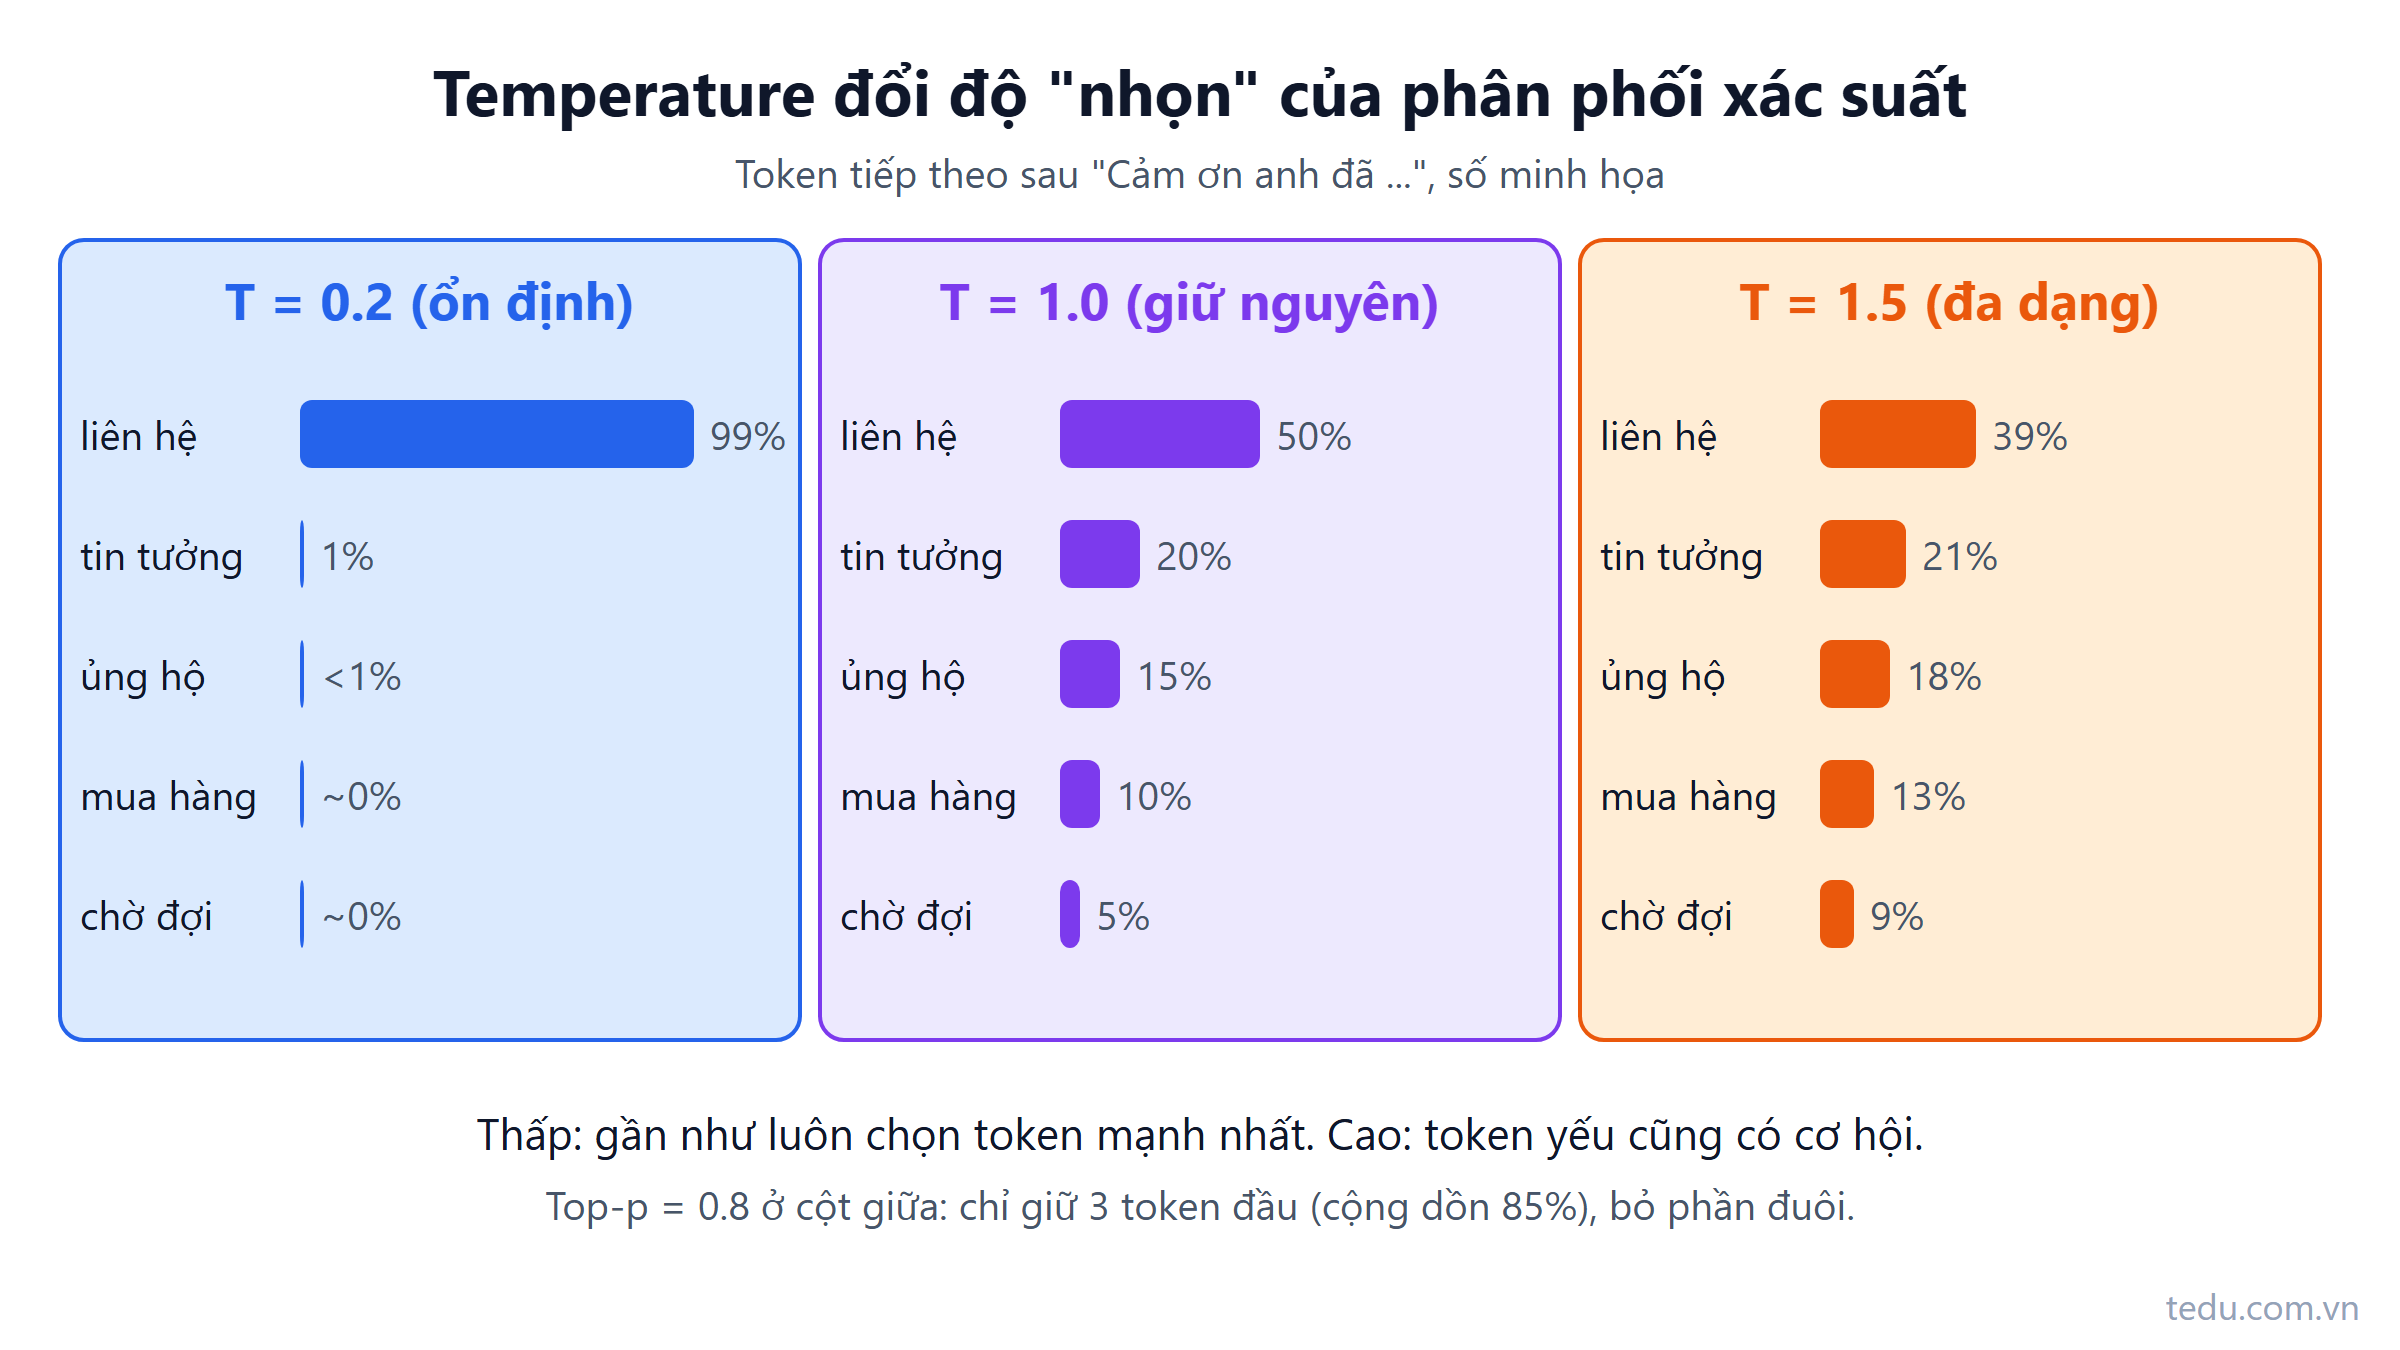
Temperature và top-p là gì? Chỉnh độ sáng tạo của LLM đúng cách
Temperature và top-p quyết định model chọn token tiếp theo an toàn hay phiêu lưu. Bài giải thích cơ chế bằng số cụ thể, code C# mô phỏng và cách chọn theo từng tác vụ.
Đọc thêm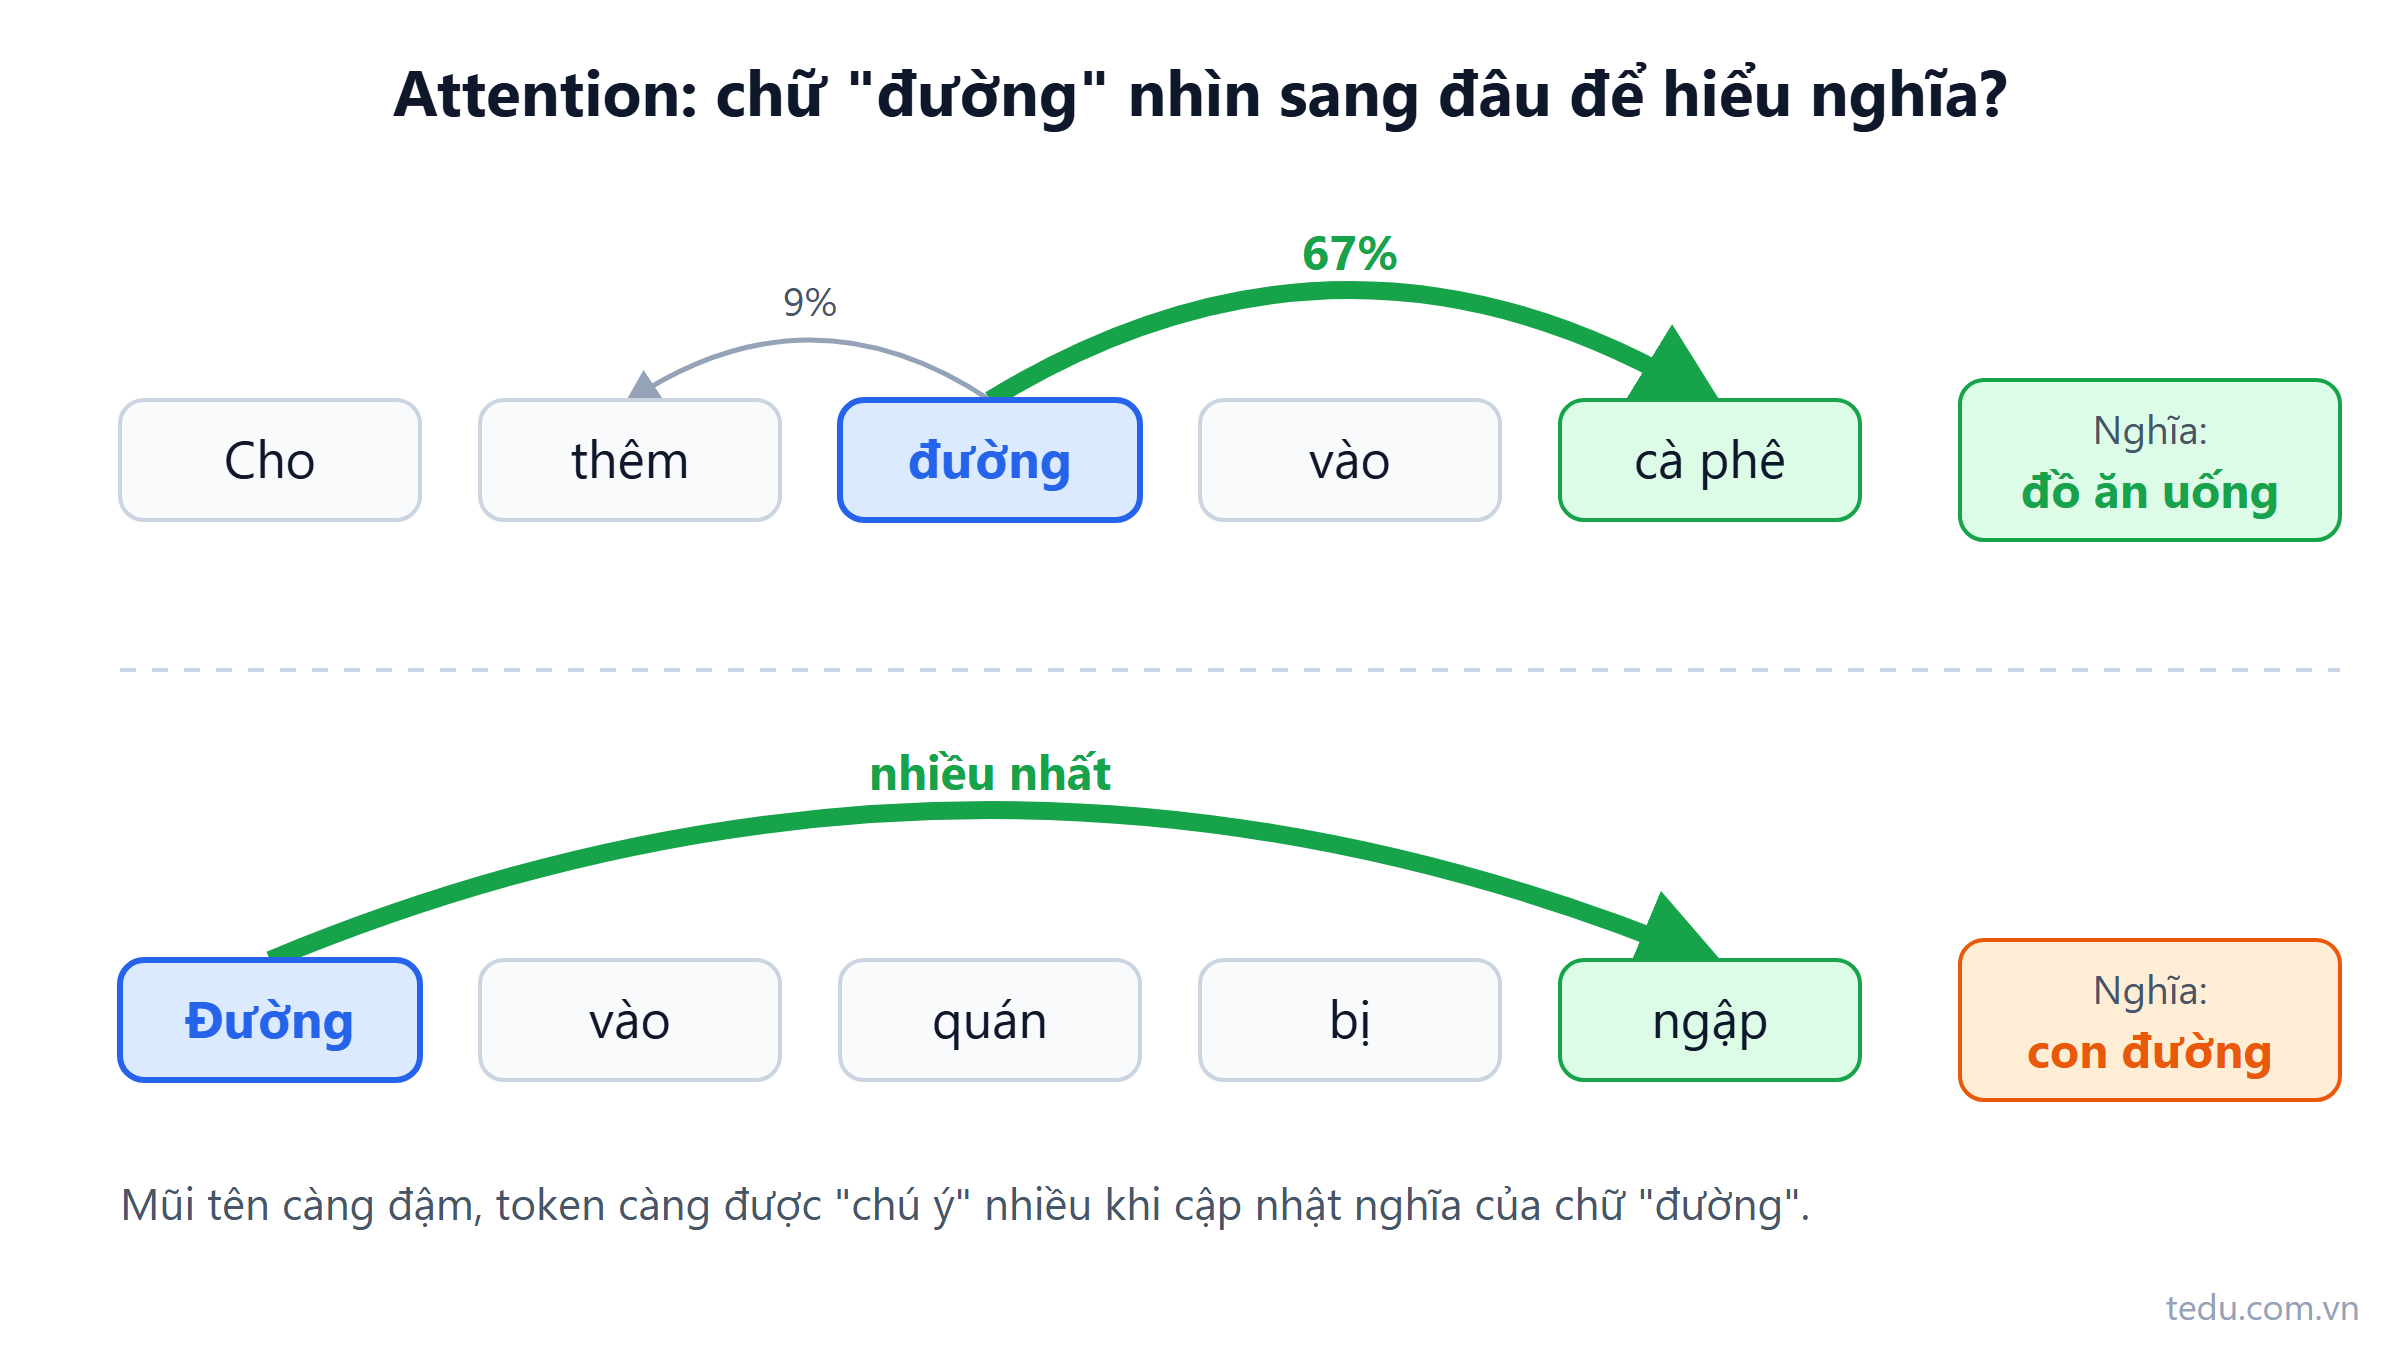
Attention là gì? Giải thích bằng trực giác cho dev backend
Attention là cơ chế giúp mỗi token nhìn sang các token khác để hiểu nghĩa theo ngữ cảnh. Giải thích bằng trực giác, ví dụ C# và hệ quả khi làm sản phẩm.
Đọc thêm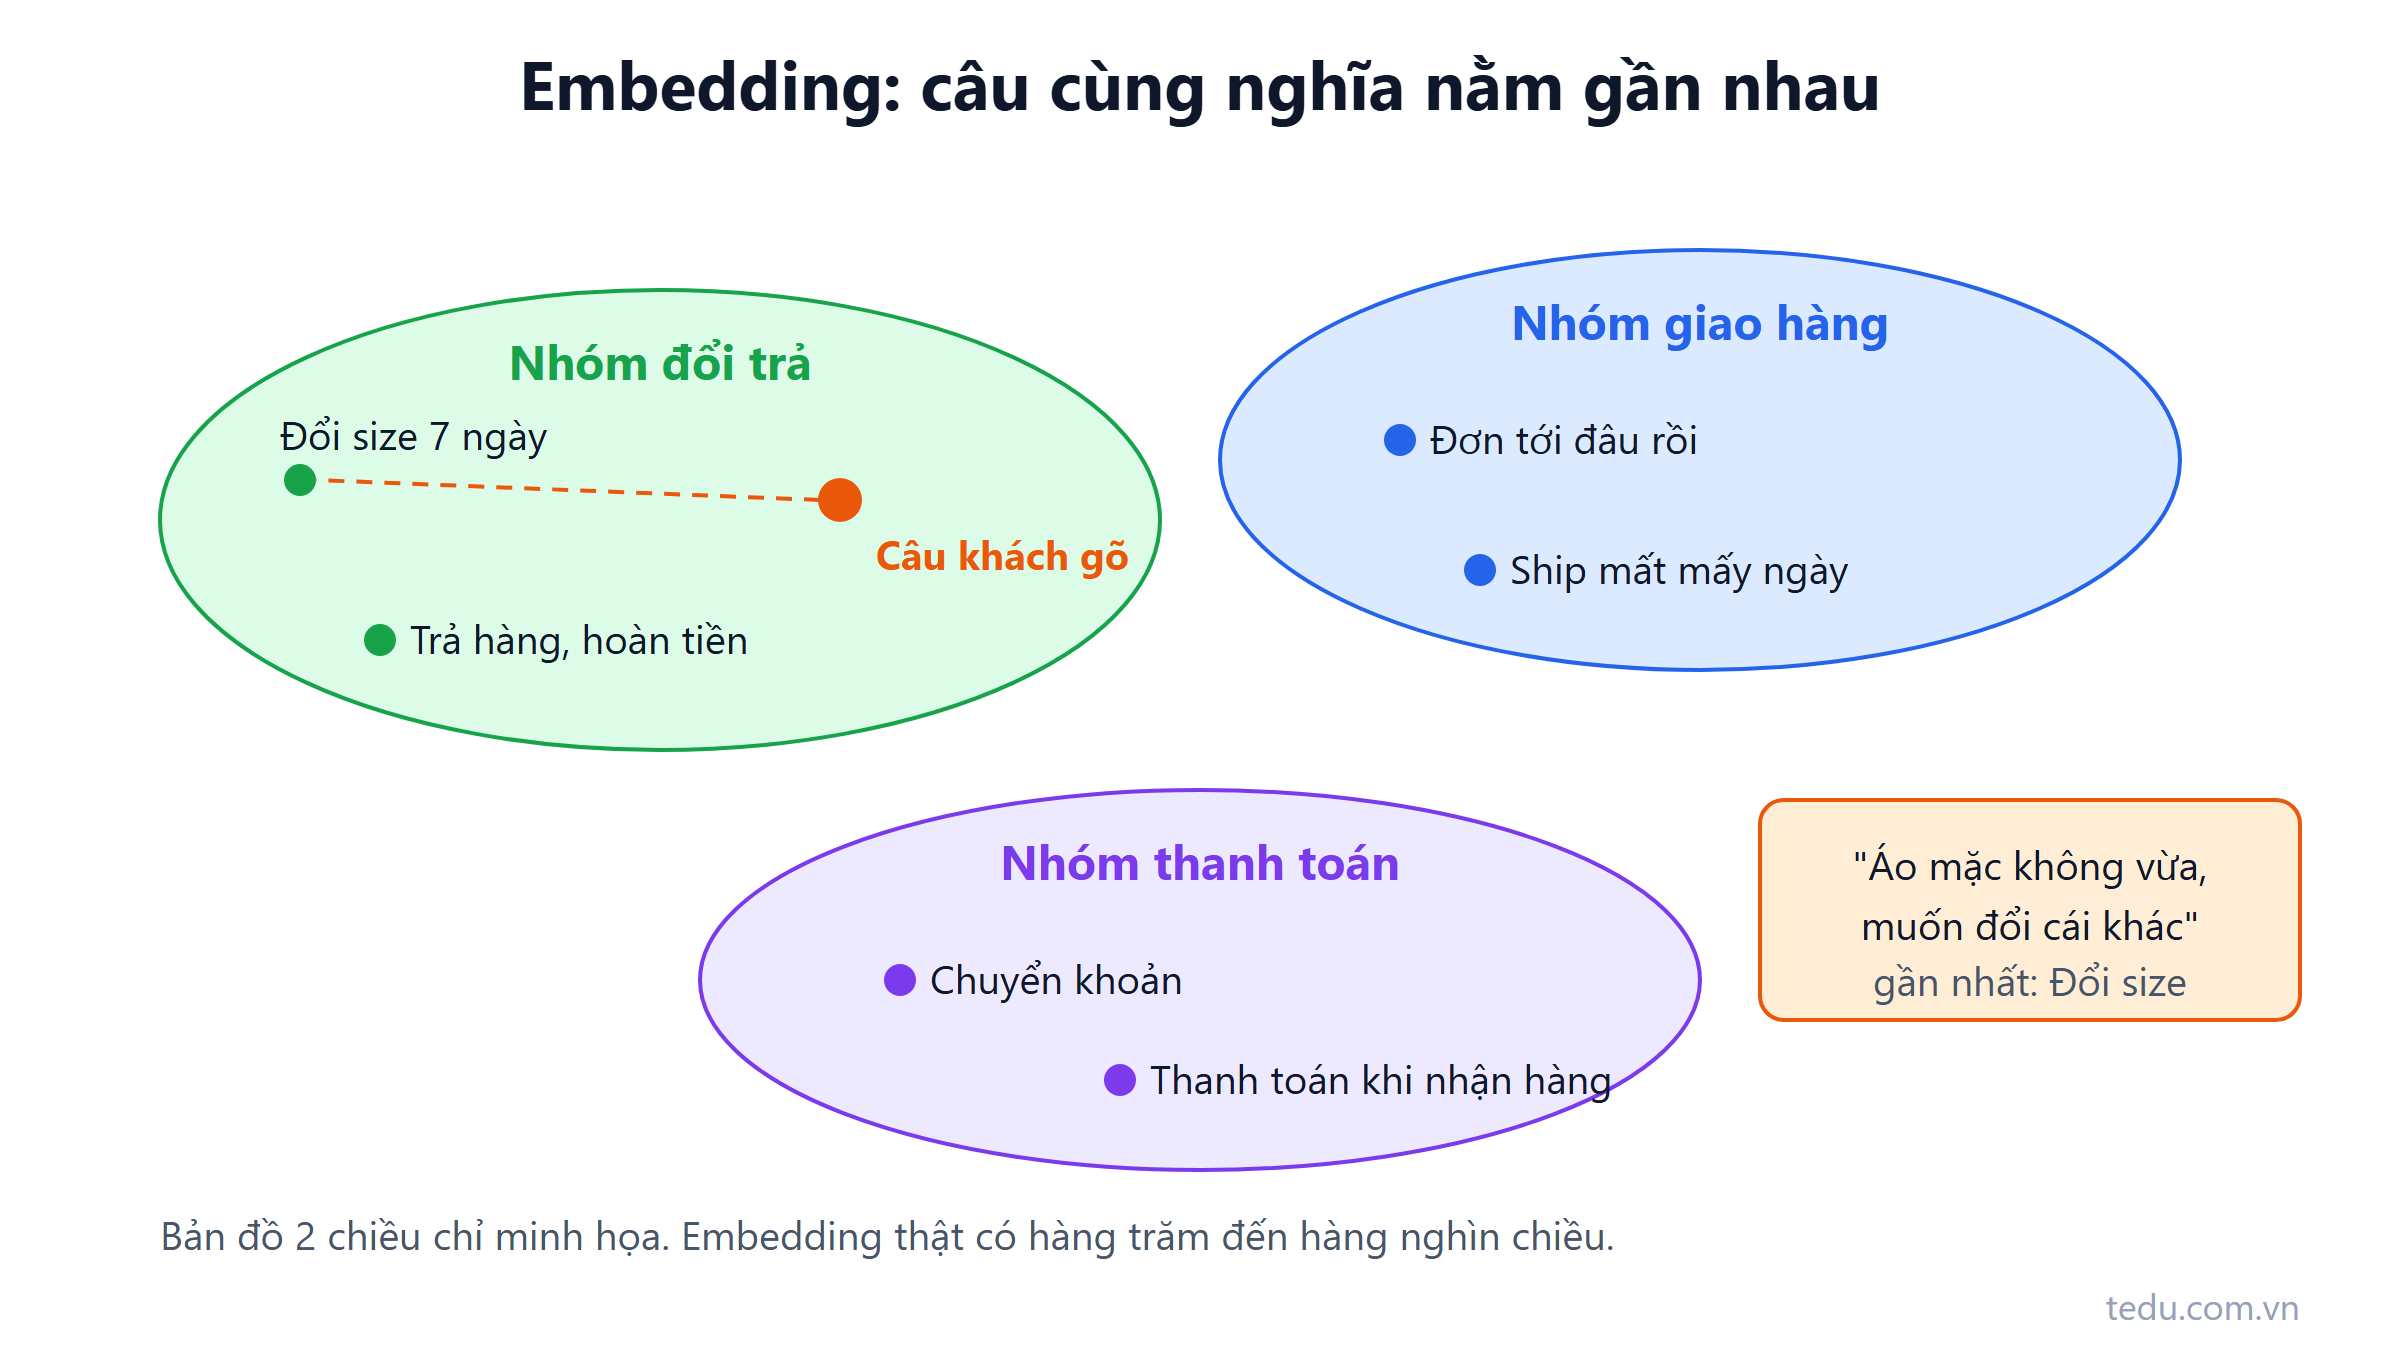
Embedding là gì? Biến chữ thành tọa độ để tìm theo nghĩa
Embedding biến một đoạn chữ thành dãy số như tọa độ, để câu cùng nghĩa nằm gần nhau. Bài giải thích cơ chế, cosine similarity, pgvector và các lỗi hay gặp.
Đọc thêm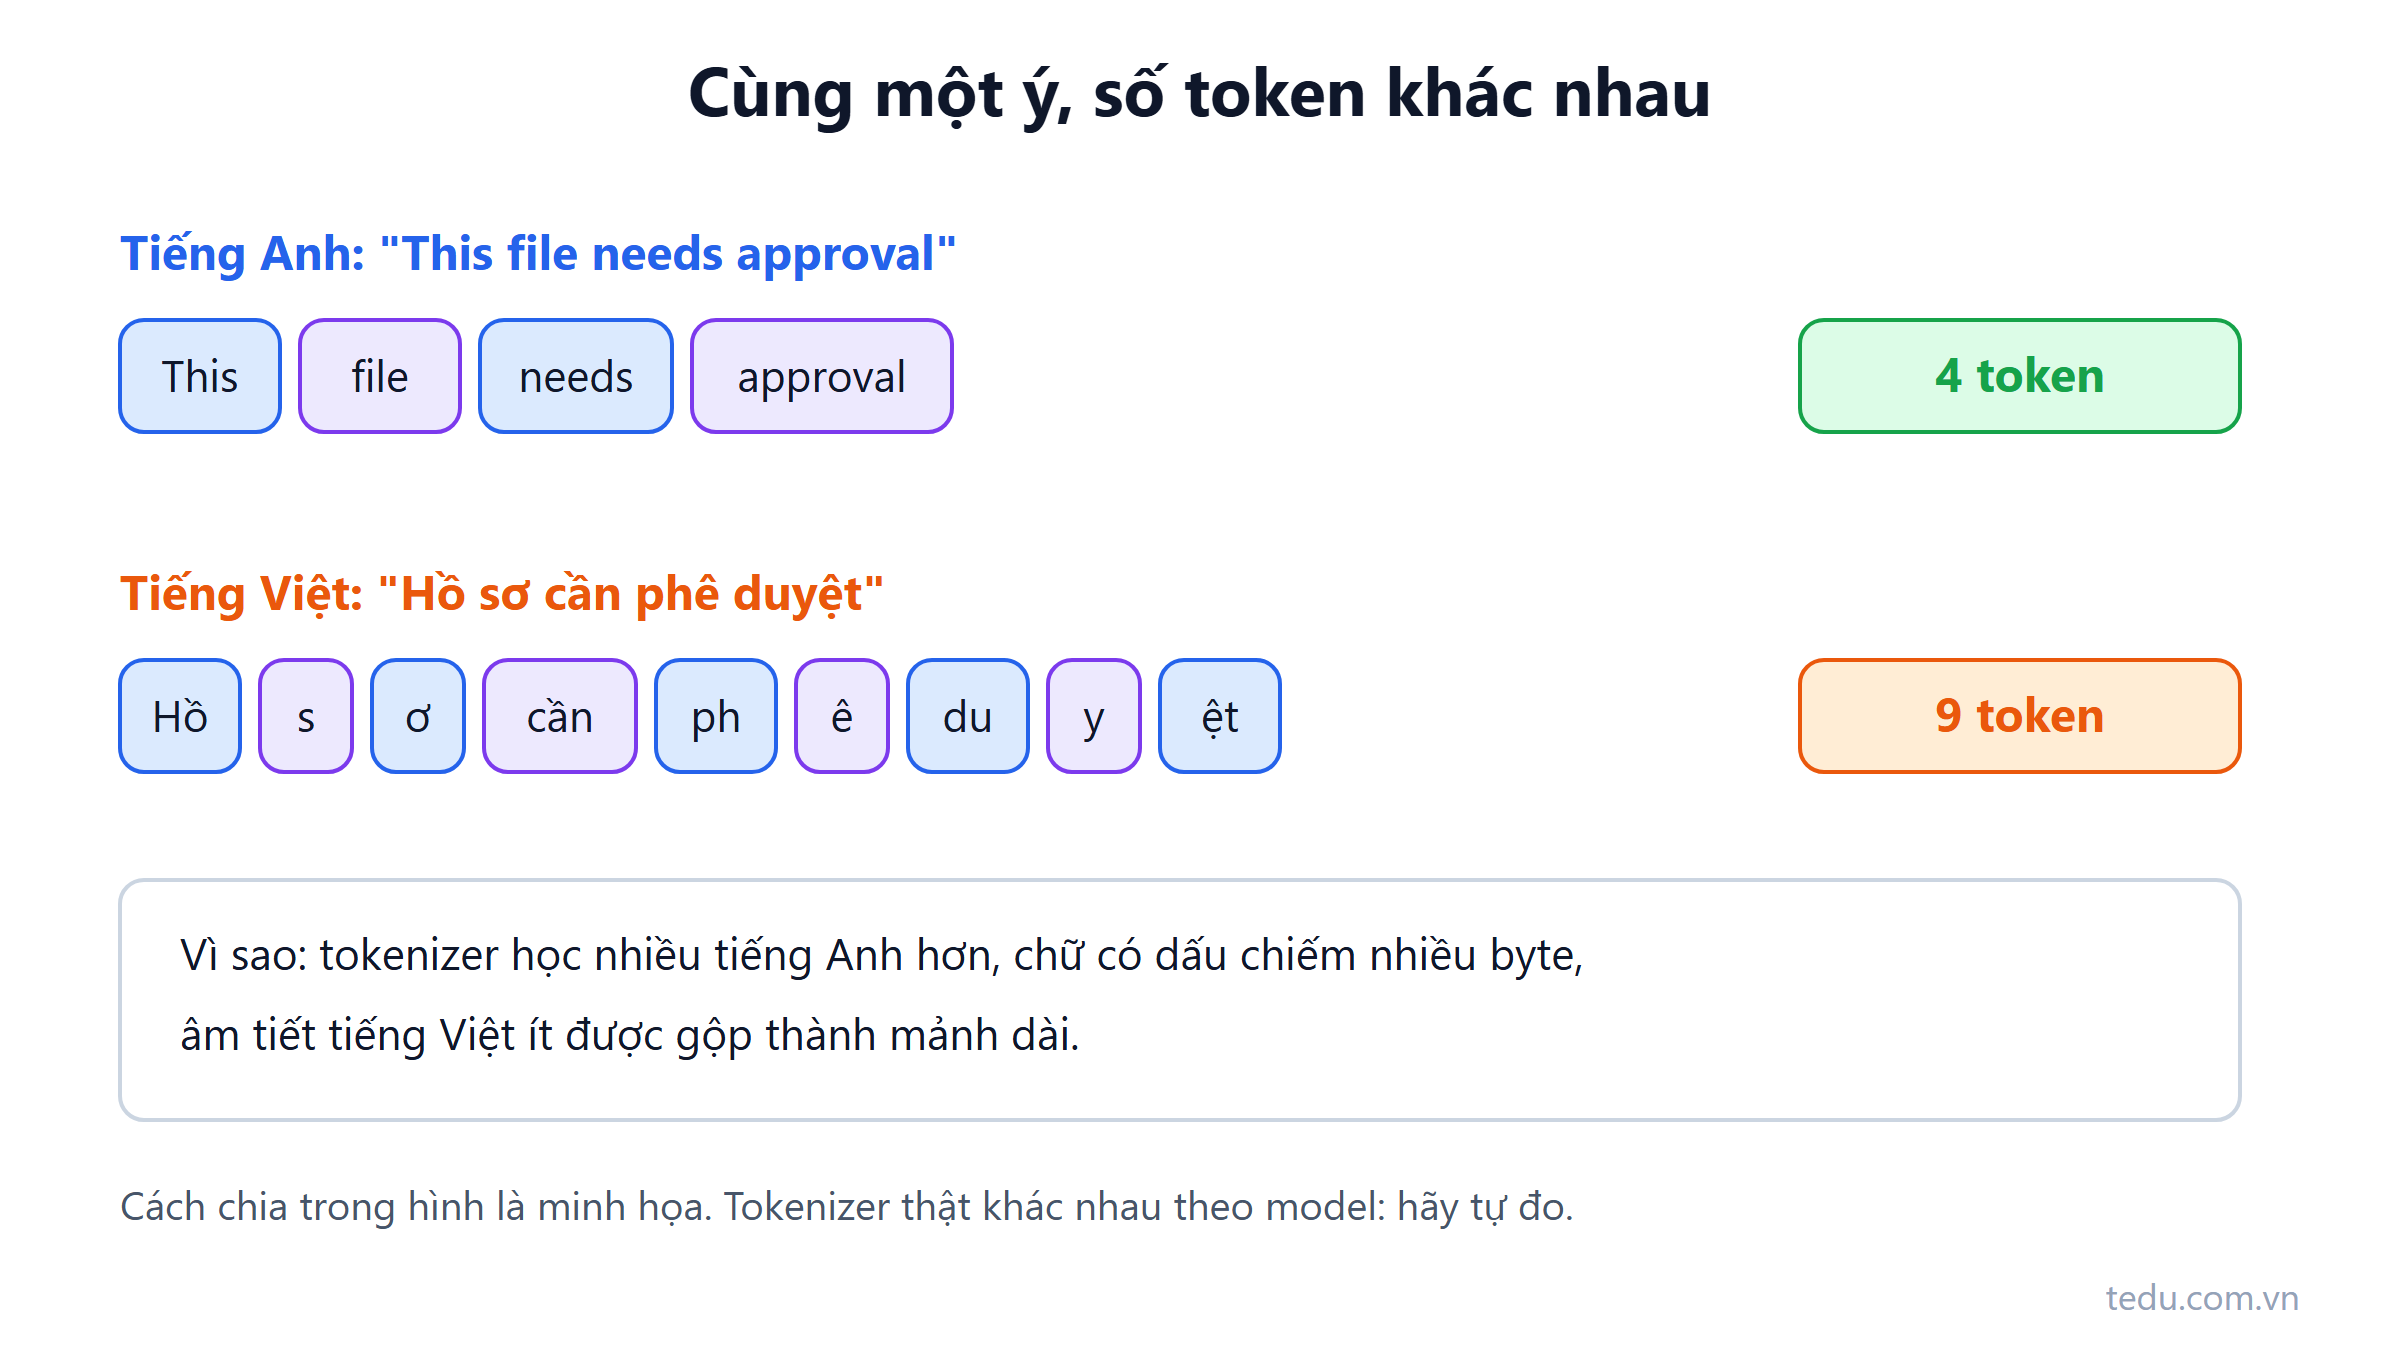
Token là gì? Vì sao tiếng Việt tốn token hơn tiếng Anh
Token là gì, tokenizer chia chữ thế nào và vì sao tiếng Việt thường tốn token hơn. Kèm cách ước lượng chi phí và code C# tự đo token bằng trường usage.
Đọc thêm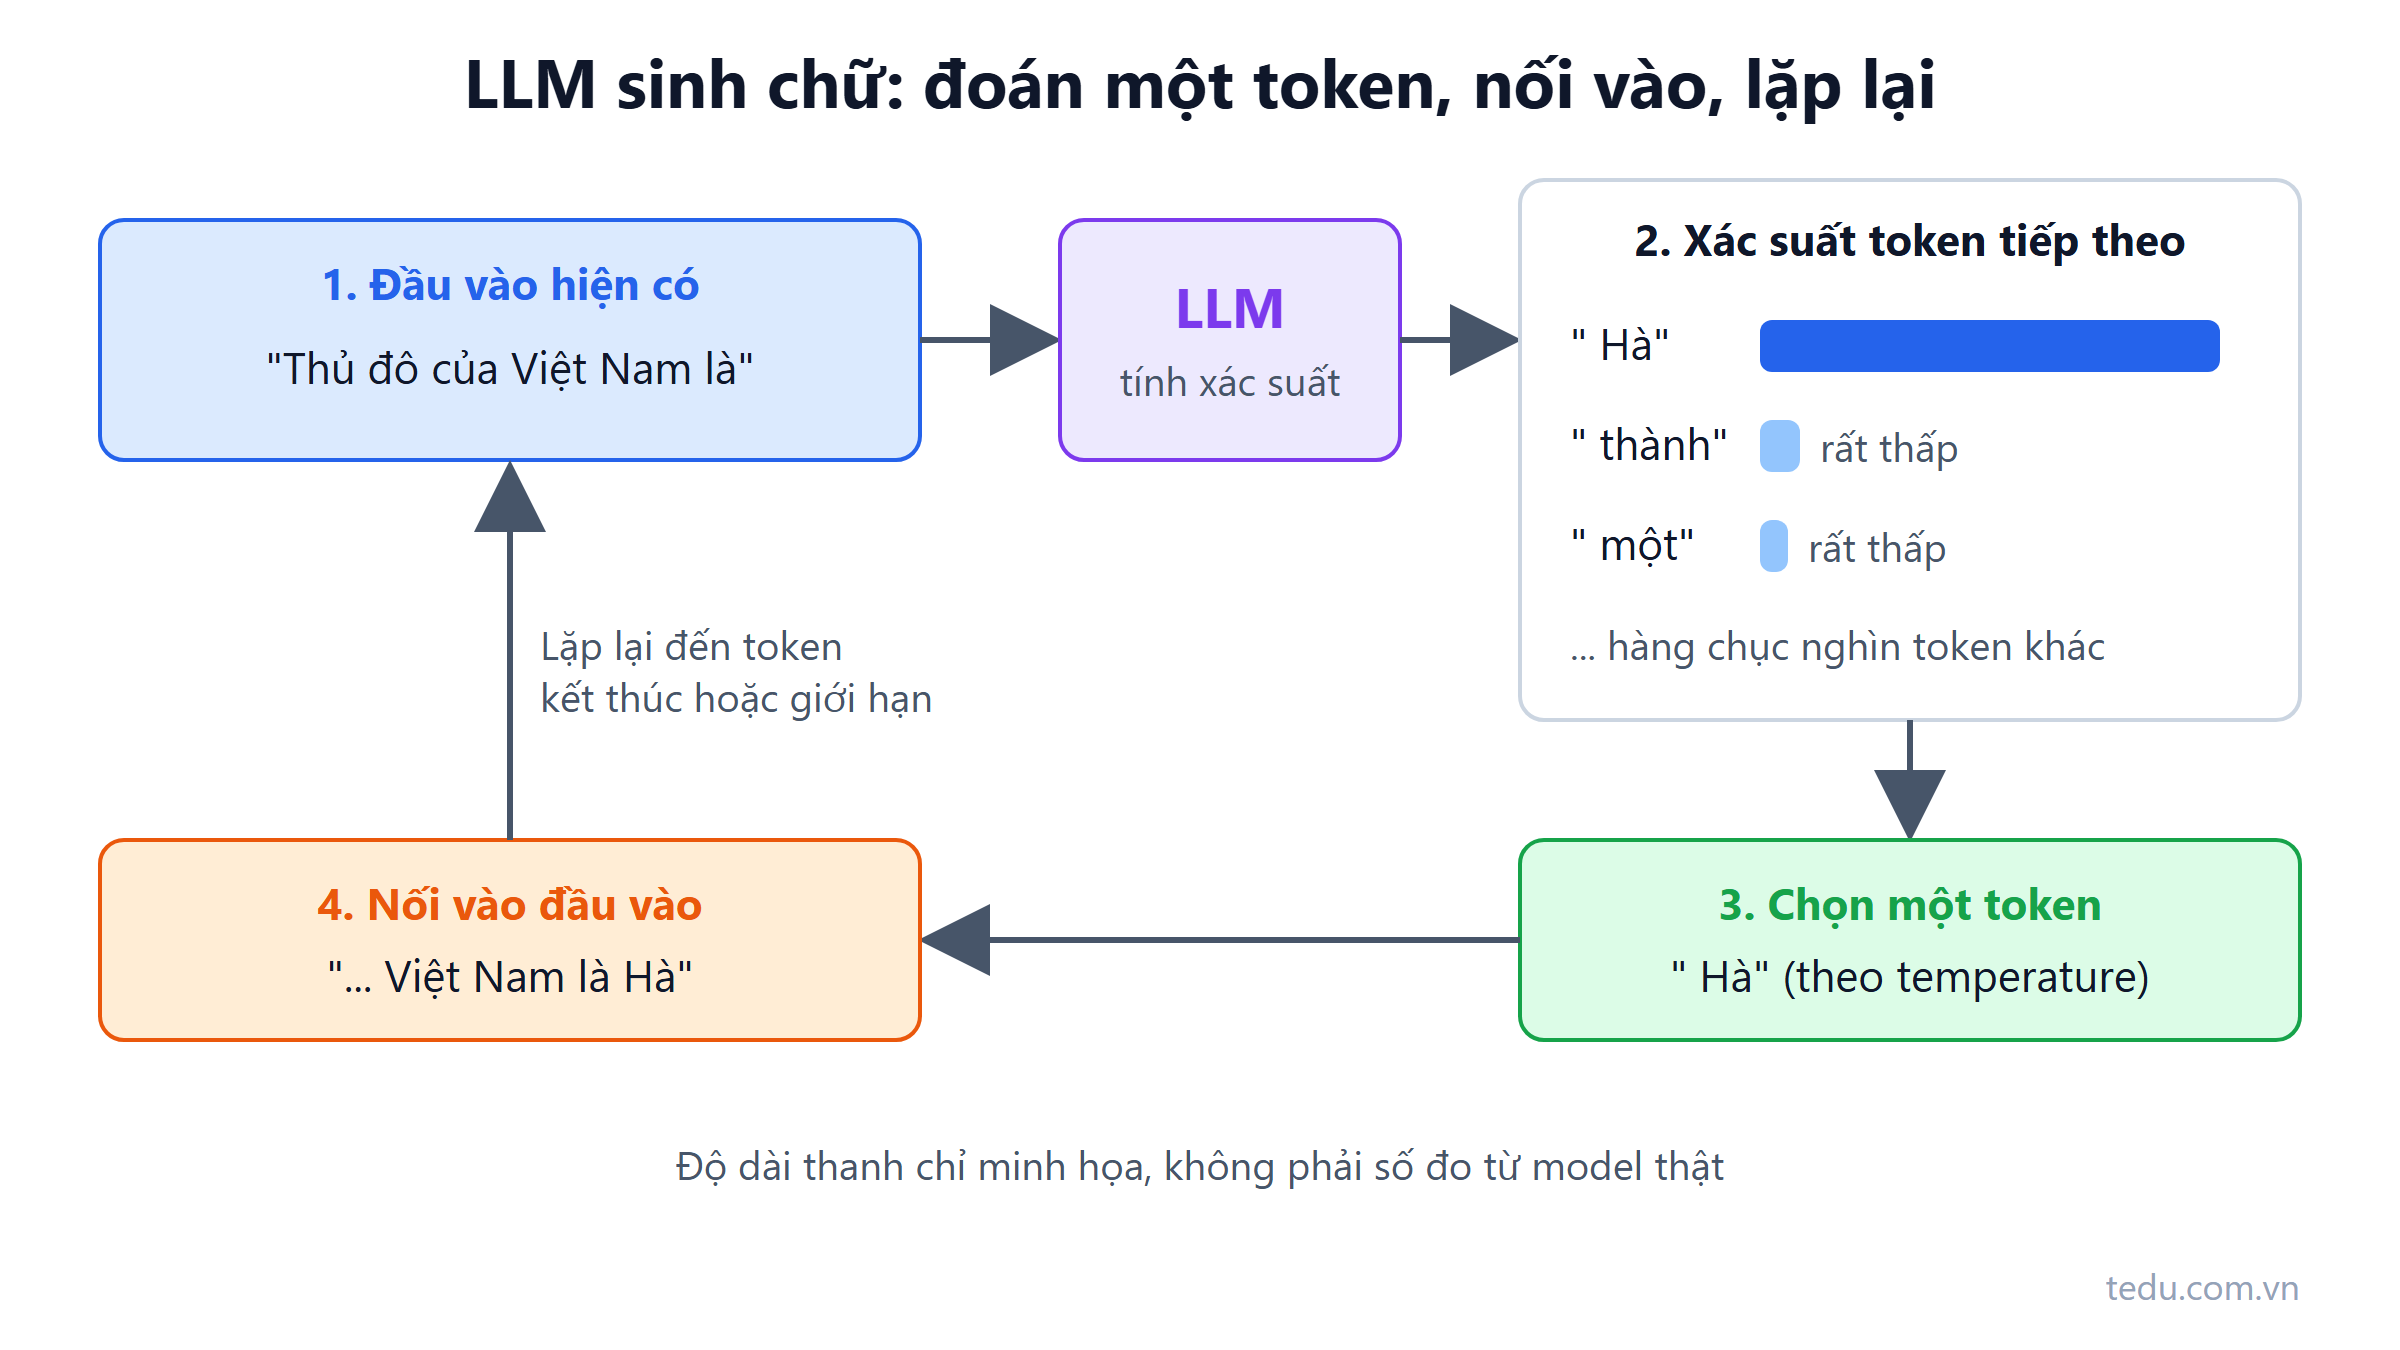
LLM hoạt động thế nào? Chỉ đoán token tiếp theo
LLM chỉ làm một việc: đoán token tiếp theo rồi lặp lại. Hiểu cơ chế này giải thích được vì sao model bịa, trả lời khác nhau mỗi lần và chậm khi viết dài.
Đọc thêm