

Backend Developer sang AI Engineer: đã có sẵn 70% kỹ năng
Hãy hình dung một dev .NET tên Minh (nhân vật minh họa), làm được năm năm ở một công ty giải pháp phần mềm. Hằng ngày anh viết API, tối ưu query, xử lý phân quyền, trực lỗi khi hệ thống chậm. Gần đây sếp giao thêm một việc: "tích hợp AI vào hệ thống". Anh mở vài khóa học AI ra xem, thấy toàn đại số tuyến tính với huấn luyện neural network, và đóng tab lại với cảm giác phải học lại từ đầu.
Cảm giác đó phần lớn là hiểu lầm. Nếu bạn là backend developer và muốn chuyển sang AI Engineer, bạn đã có sẵn một phần rất lớn kỹ năng cần thiết. Bài này liệt kê cụ thể phần đó gồm những gì, phần nào dùng được nhưng phải đổi cách nghĩ, và phần còn thiếu thật sự là gì.
"70%" là con số gì, và đừng hiểu nó như số đo
Con số 70% trong tiêu đề là ước lượng nghề nghiệp dựa trên cách một ứng dụng LLM được xây trong thực tế. Không có khảo sát hay phép đo nào đứng sau nó. Ý nghĩa của nó là: phần lớn công việc quanh một ứng dụng AI vẫn là kỹ thuật phần mềm quen thuộc, còn phần "chỉ có ở AI" là một lớp mỏng hơn bạn nghĩ.
Con số thật của bạn có thể là 50% hoặc 80%, tùy bạn đã làm gì trong năm năm qua. Một dev từng làm tích hợp cổng thanh toán, viết job xử lý nền và trực production sẽ thấy quen hơn nhiều so với người chỉ làm màn hình CRUD. Điều quan trọng là danh sách bên dưới, vì nó cho bạn biết mình mạnh ở đâu và cần bù ở đâu.
Nếu chưa rõ AI Engineer làm gì mỗi ngày, hãy đọc trước bài AI Engineer là gì, khác ML Engineer ở đâu.
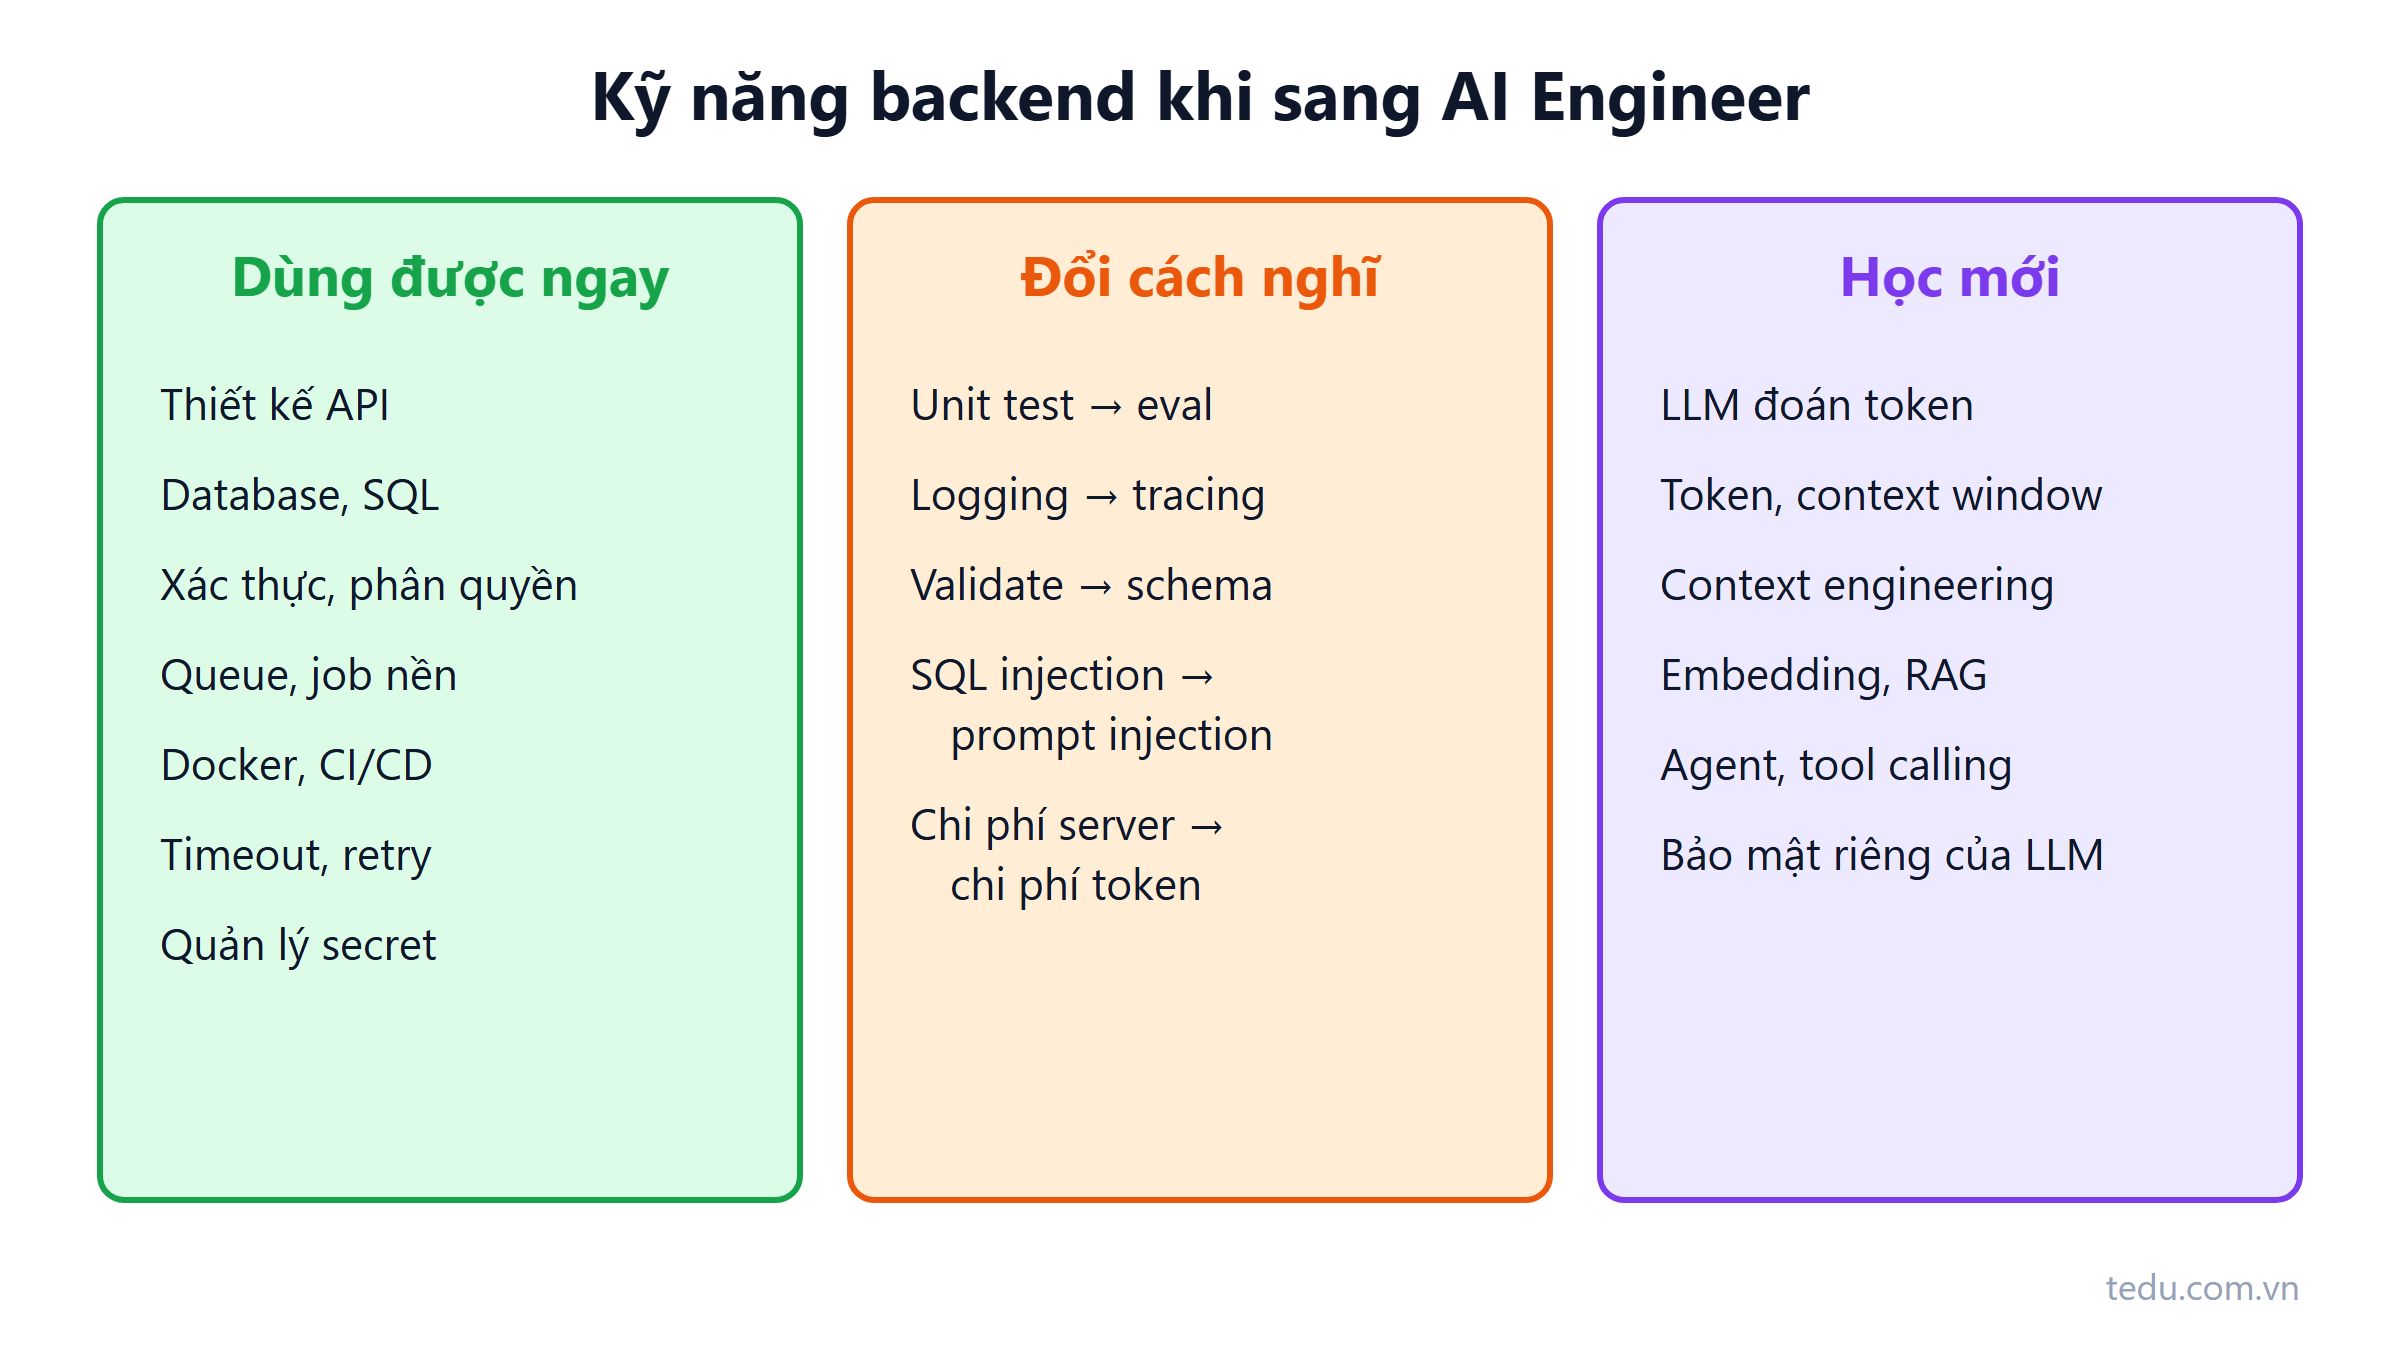
Những kỹ năng backend đã dùng được ngay
Hãy xem một ứng dụng LLM như một hệ thống backend mà trong đó có một dịch vụ bên ngoài, tên là LLM API. Các kỹ năng của bạn gần như đều có chỗ dùng:
| Kỹ năng backend | Dùng ở đâu trong ứng dụng LLM |
|---|---|
| Thiết kế API | Dựng endpoint chat, trả streaming, định nghĩa schema JSON cho kết quả của model |
| Database và SQL | Lưu lịch sử hội thoại, lưu vector bằng pgvector, truy vấn tài liệu |
| Xác thực và phân quyền | Quyết định người dùng nào được hỏi về tài liệu nào, một lỗi ở đây là lộ dữ liệu |
| Queue và xử lý nền | Xử lý tài liệu hàng loạt, gọi model cho tác vụ chạy lâu, retry khi lỗi |
| Logging và monitoring | Ghi lại prompt, câu trả lời, độ trễ và chi phí mỗi lần gọi |
| Kiểm thử | Nền tảng của eval: bộ câu hỏi mẫu và tiêu chí chấm điểm |
| Triển khai và vận hành | Docker, CI/CD, quản lý secret như API key, giới hạn tốc độ |
Một ví dụ cụ thể: gọi LLM API về bản chất giống gọi một dịch vụ HTTP bên ngoài. Nó có thể chậm, có thể lỗi và có thể trả dữ liệu sai định dạng. Bạn đã biết xử lý mấy chuyện này.
public async Task<string> AskAsync(string question, CancellationToken ct)
{
    // Timeout, retry và circuit breaker: cách làm quen thuộc với mọi dịch vụ ngoài
    using var cts = CancellationTokenSource.CreateLinkedTokenSource(ct);
    cts.CancelAfter(TimeSpan.FromSeconds(30));

    var response = await _resiliencePipeline.ExecuteAsync(
        async token => await _llmClient.CompleteAsync(question, token), cts.Token);

    _logger.LogInformation("LLM call done, tokens: {Tokens}", response.Usage.TotalTokens);
    return response.Text;
}
Đoạn code trên chỉ là phác thảo: _llmClient là lớp bọc do bạn tự định nghĩa quanh SDK hoặc HTTP client, _resiliencePipeline là pipeline retry/timeout bạn đang dùng cho các dịch vụ khác. Điểm cần thấy là cấu trúc: không có gì lạ so với một lời gọi dịch vụ ngoài thông thường.
Một tính năng thật, chia theo kỹ năng
Lấy bài toán chatbot tra cứu đơn hàng cho một shop online. Khách gõ "đơn em đặt hôm thứ Hai giao chưa, đổi size được không". Để trả lời câu đó, hệ thống phải làm sáu việc:
Xác thực khách qua số điện thoại hoặc phiên đăng nhập: kỹ năng auth bạn đã có.
Tra đơn hàng gần nhất của đúng khách đó: một câu SQL có điều kiện
customer_id.Đọc chính sách đổi size hiện hành: tìm đoạn tài liệu liên quan (RAG).
Ghép tất cả vào prompt và gọi model: phần mới.
Kiểm tra câu trả lời không hứa điều chính sách không cho: phần mới, nhưng giống validate đầu ra.
Ghi log hội thoại, số token, độ trễ: kỹ năng logging bạn đã có.
Hai trên sáu bước là mới. Bốn bước còn lại bạn làm được từ tuần đầu tiên, và chính bốn bước đó quyết định chatbot có lộ đơn hàng của khách khác hay không.
Kỹ năng dùng được, nhưng phải đổi cách nghĩ
Có một nhóm kỹ năng nằm giữa: bạn đã có nền, nhưng áp vào LLM thì phải chỉnh lại. Đây là chỗ dev backend hay chủ quan nhất.
| Kỹ năng quen | Phiên bản AI | Điểm phải đổi |
|---|---|---|
Unit test so sánh Assert.Equal | Eval chấm theo tiêu chí | Không so chuỗi bằng nhau, chấm "có nêu đúng điều khoản không", "có bịa không" |
| Validate request đầu vào | Structured output có schema | Model có thể trả JSON thiếu trường, phải validate và có đường lui |
| Logging theo request | Tracing từng bước của agent | Một câu hỏi có thể kéo theo 5 lần gọi model và 3 lần gọi tool, cần nhìn cả chuỗi |
| Chống SQL injection | Chống prompt injection | Không có câu lệnh tham số hóa cho ngôn ngữ tự nhiên, phải phòng thủ nhiều lớp |
| Tính chi phí theo server | Tính chi phí theo token | Hóa đơn tăng theo lượng chữ đi vào và đi ra, không theo số máy |
| Cache theo key chính xác | Cache prompt, cache ngữ nghĩa | Hai câu hỏi khác chữ nhưng cùng ý, cache theo key không bắt được |
Dòng về bảo mật là quan trọng nhất. Bạn đã quen nguyên tắc "không tin dữ liệu người dùng". Với LLM, nguyên tắc đó mở rộng ra: không tin cả nội dung tài liệu mà model đọc, vì tài liệu cũng có thể chứa câu lệnh. Bài prompt injection đi sâu vào chuyện này.
Phần còn thiếu: lớp mỏng nhưng bắt buộc phải học
Phần còn lại không nhiều, nhưng nó khác bản chất với những gì dev backend quen. Có sáu thứ đáng học, theo thứ tự nên đi:
Cách LLM hoạt động ở mức trực giác: model đoán token tiếp theo, nên kết quả mang tính xác suất, không đảm bảo giống nhau giữa hai lần chạy.
Token và context window: chi phí và giới hạn đều tính theo token, không theo số ký tự hay số request.
Context engineering: quyết định đưa thông tin nào vào prompt để model trả lời đúng.
RAG và embedding: cho model đọc dữ liệu của doanh nghiệp một cách có kiểm soát.
Eval: cách đo chất lượng khi không có đáp án đúng duy nhất cho mọi câu hỏi.
Bảo mật riêng của LLM: prompt injection, rò rỉ dữ liệu, agent có quyền thực thi hành động.
Hầu hết sáu mục này học được bằng trực giác và thực hành, không cần công thức. Bạn không phải học huấn luyện model hay xây neural network để làm việc ở mức ứng dụng. Muốn xem sáu mục này nằm ở đâu trên bức tranh chung, đọc tiếp bản đồ AI Engineer cần học gì.
Điểm khác lớn nhất: hệ thống không còn deterministic
Có một thay đổi tư duy mà dev backend nào cũng phải vượt qua. Trước đây, cùng một đầu vào cho cùng một đầu ra, và unit test chỉ cần so sánh bằng nhau. Với LLM, cùng một câu hỏi có thể cho hai câu trả lời hơi khác nhau, và "đúng" thường là một thang điểm chứ không phải đúng hoặc sai.
So sánh hai cách test cho cùng câu hỏi "Nhân viên thử việc có được nghỉ phép năm không?":
// Cách cũ: so chuỗi, sẽ đỏ ngay lần chạy thứ hai dù câu trả lời vẫn đúng
Assert.Equal("Nhân viên thử việc không được nghỉ phép năm.", answer);

// Cách mới: chấm theo tiêu chí, mỗi tiêu chí là một kiểm tra riêng
var checks = new[]
{
    answer.Contains("thử việc", StringComparison.OrdinalIgnoreCase),
    CitesSection(answer, "Điều 12"),          // có dẫn đúng điều khoản
    !MentionsNumberOfDays(answer)            // không tự bịa số ngày phép
};
Assert.True(checks.All(c => c));
Các hàm CitesSection, MentionsNumberOfDays là hàm kiểm tra bạn tự viết, minh họa ý tưởng. Với tiêu chí khó viết bằng code, người ta dùng thêm model khác để chấm, kèm những cái bẫy riêng.
Hệ quả thực tế:
Test không so sánh chuỗi bằng nhau nữa, mà chấm theo tiêu chí: có nêu đúng điều khoản không, có bịa thông tin không.
Mỗi lần đổi model hay đổi prompt đều cần chạy lại bộ test để biết chất lượng tăng hay giảm. Đổi một dòng prompt mà không chạy lại eval cũng giống sửa code rồi bỏ qua CI.
Lỗi không phải lúc nào cũng nổ exception. Model có thể trả lời rất tự tin nhưng sai, và log không báo gì.
Đây là phần cần thời gian làm quen nhất, nhưng nó vẫn là kỹ năng kỹ thuật phần mềm: đo lường, kiểm thử, theo dõi. Bạn đang mở rộng kỹ năng sẵn có sang một loại hệ thống mới, chứ không học một nghề mới hoàn toàn.
Những cái bẫy khi dev backend chuyển hướng
Chủ quan vì thấy quen. Gọi API thì dễ, nên nhiều người dừng ở demo. Phần khó (eval, bảo mật, chi phí) chỉ lộ ra khi có người dùng thật.
Bỏ sạch stack cũ để học lại bằng Python. Không cần. Ngôn ngữ chỉ là phương tiện. Python ở mức đọc hiểu giúp bạn đọc tài liệu và công cụ cộng đồng, nhưng hệ thống thật vẫn có thể viết bằng .NET hay Java.
Chỉ học qua video, không làm dự án có đo lường. Nhà tuyển dụng hỏi "hệ thống của anh đúng bao nhiêu phần trăm, tốn bao nhiêu tiền mỗi nghìn câu hỏi". Câu đó chỉ trả lời được khi bạn đã tự đo.
Ba việc nên làm trong tuần này
Tự chấm điểm bảng kỹ năng ở trên. Với mỗi dòng, ghi bạn đã làm ở mức nào: chưa, từng làm, hay làm thành thạo. Bạn sẽ biết con số 70% của riêng mình.
Chọn một mục thiếu để học trước. Nếu chưa biết bắt đầu từ đâu, hãy học token và context window trước, vì chúng ảnh hưởng đến chi phí và độ chính xác của mọi thứ phía sau.
Làm một thứ nhỏ nhưng thật. Ví dụ trợ lý hỏi đáp trên một tài liệu quy trình ở công ty, có log chi phí và một bộ vài chục câu hỏi để chấm. Một dự án nhỏ có đo lường thuyết phục hơn mười bài hướng dẫn chỉ đọc.
Một lời nhắc trung thực: tin tuyển dụng AI Engineer thường đòi nhiều hơn một dự án nhỏ, và chuyển hướng nghề vẫn cần thời gian. Nhưng điểm xuất phát của dev backend tốt hơn nhiều người nghĩ.
Tóm lại: phần lớn kỹ năng backend dùng được ngay, một nhóm cần đổi cách nghĩ (test thành eval, log thành tracing, SQL injection thành prompt injection), và phần mới thật sự là một lớp mỏng. Bài tiếp theo trong series vẽ bản đồ 7 tầng AI Engineer cần học để bạn biết học phần thiếu theo thứ tự nào.
Xem bản tóm tắt dưới một phút trên YouTube @teduco hoặc TikTok @teducolabs, và đọc thêm các bài khác trong chuyên mục AI Engineer.
Bài viết liên quan
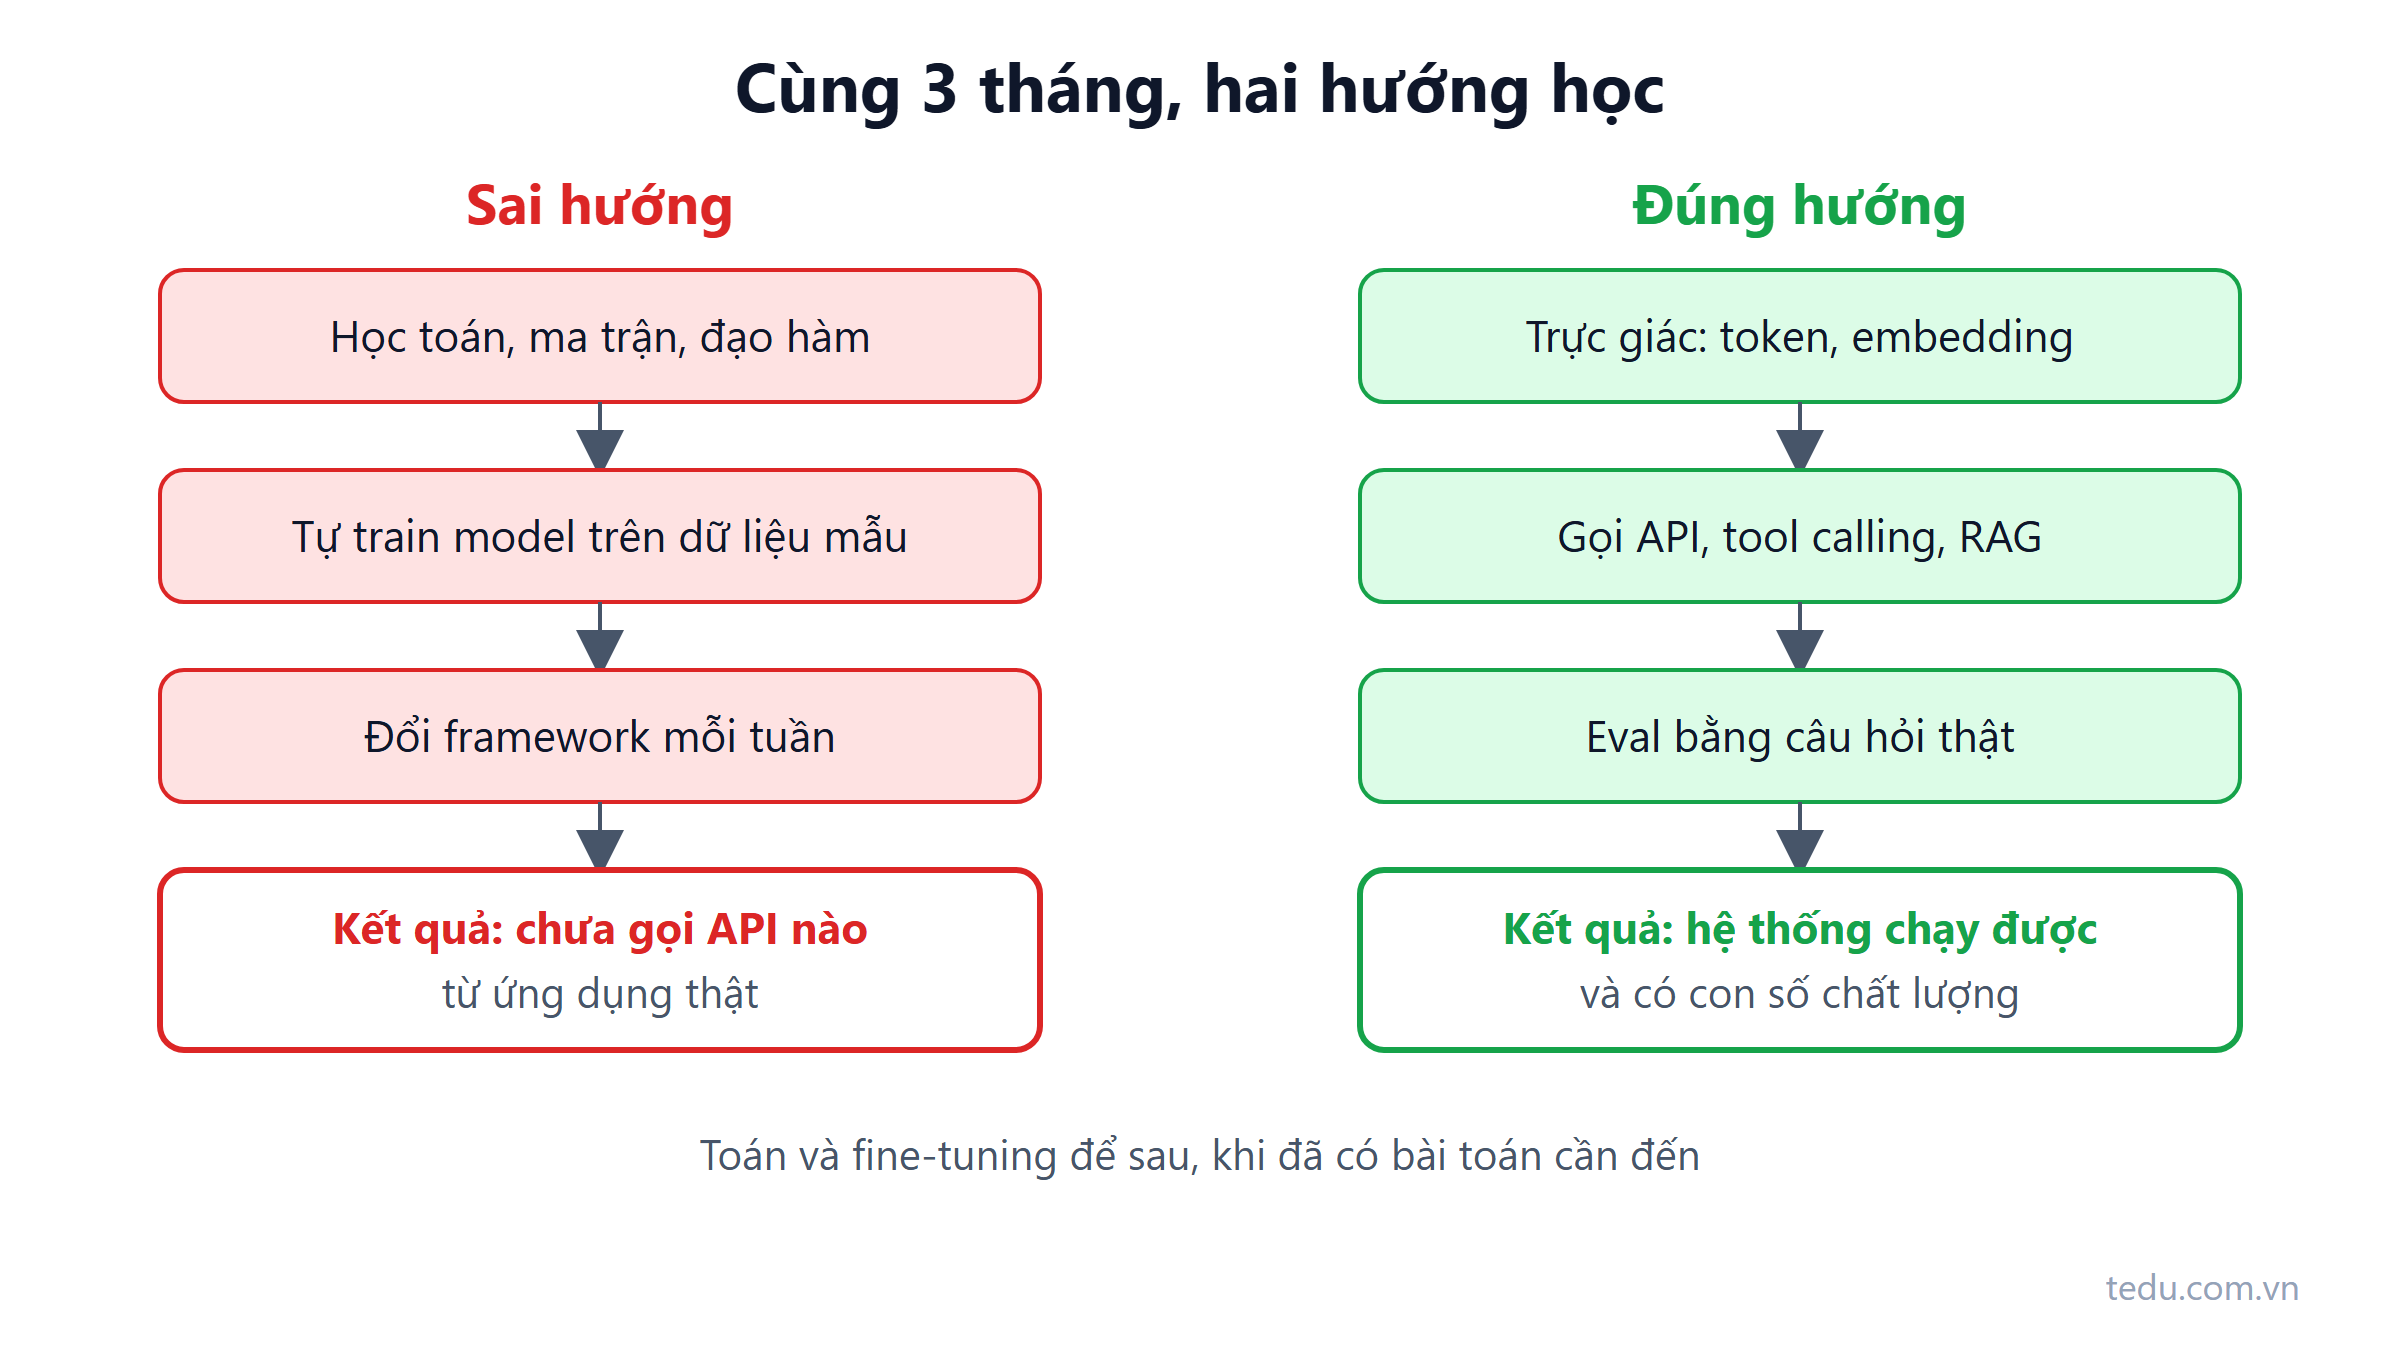
3 hiểu lầm khiến dev học AI Engineer sai hướng
Học toán trước, tự train model, chạy theo framework: ba hiểu lầm làm dev backend mất hàng tháng khi học AI Engineer, và nên học gì thay vào đó.
Đọc thêm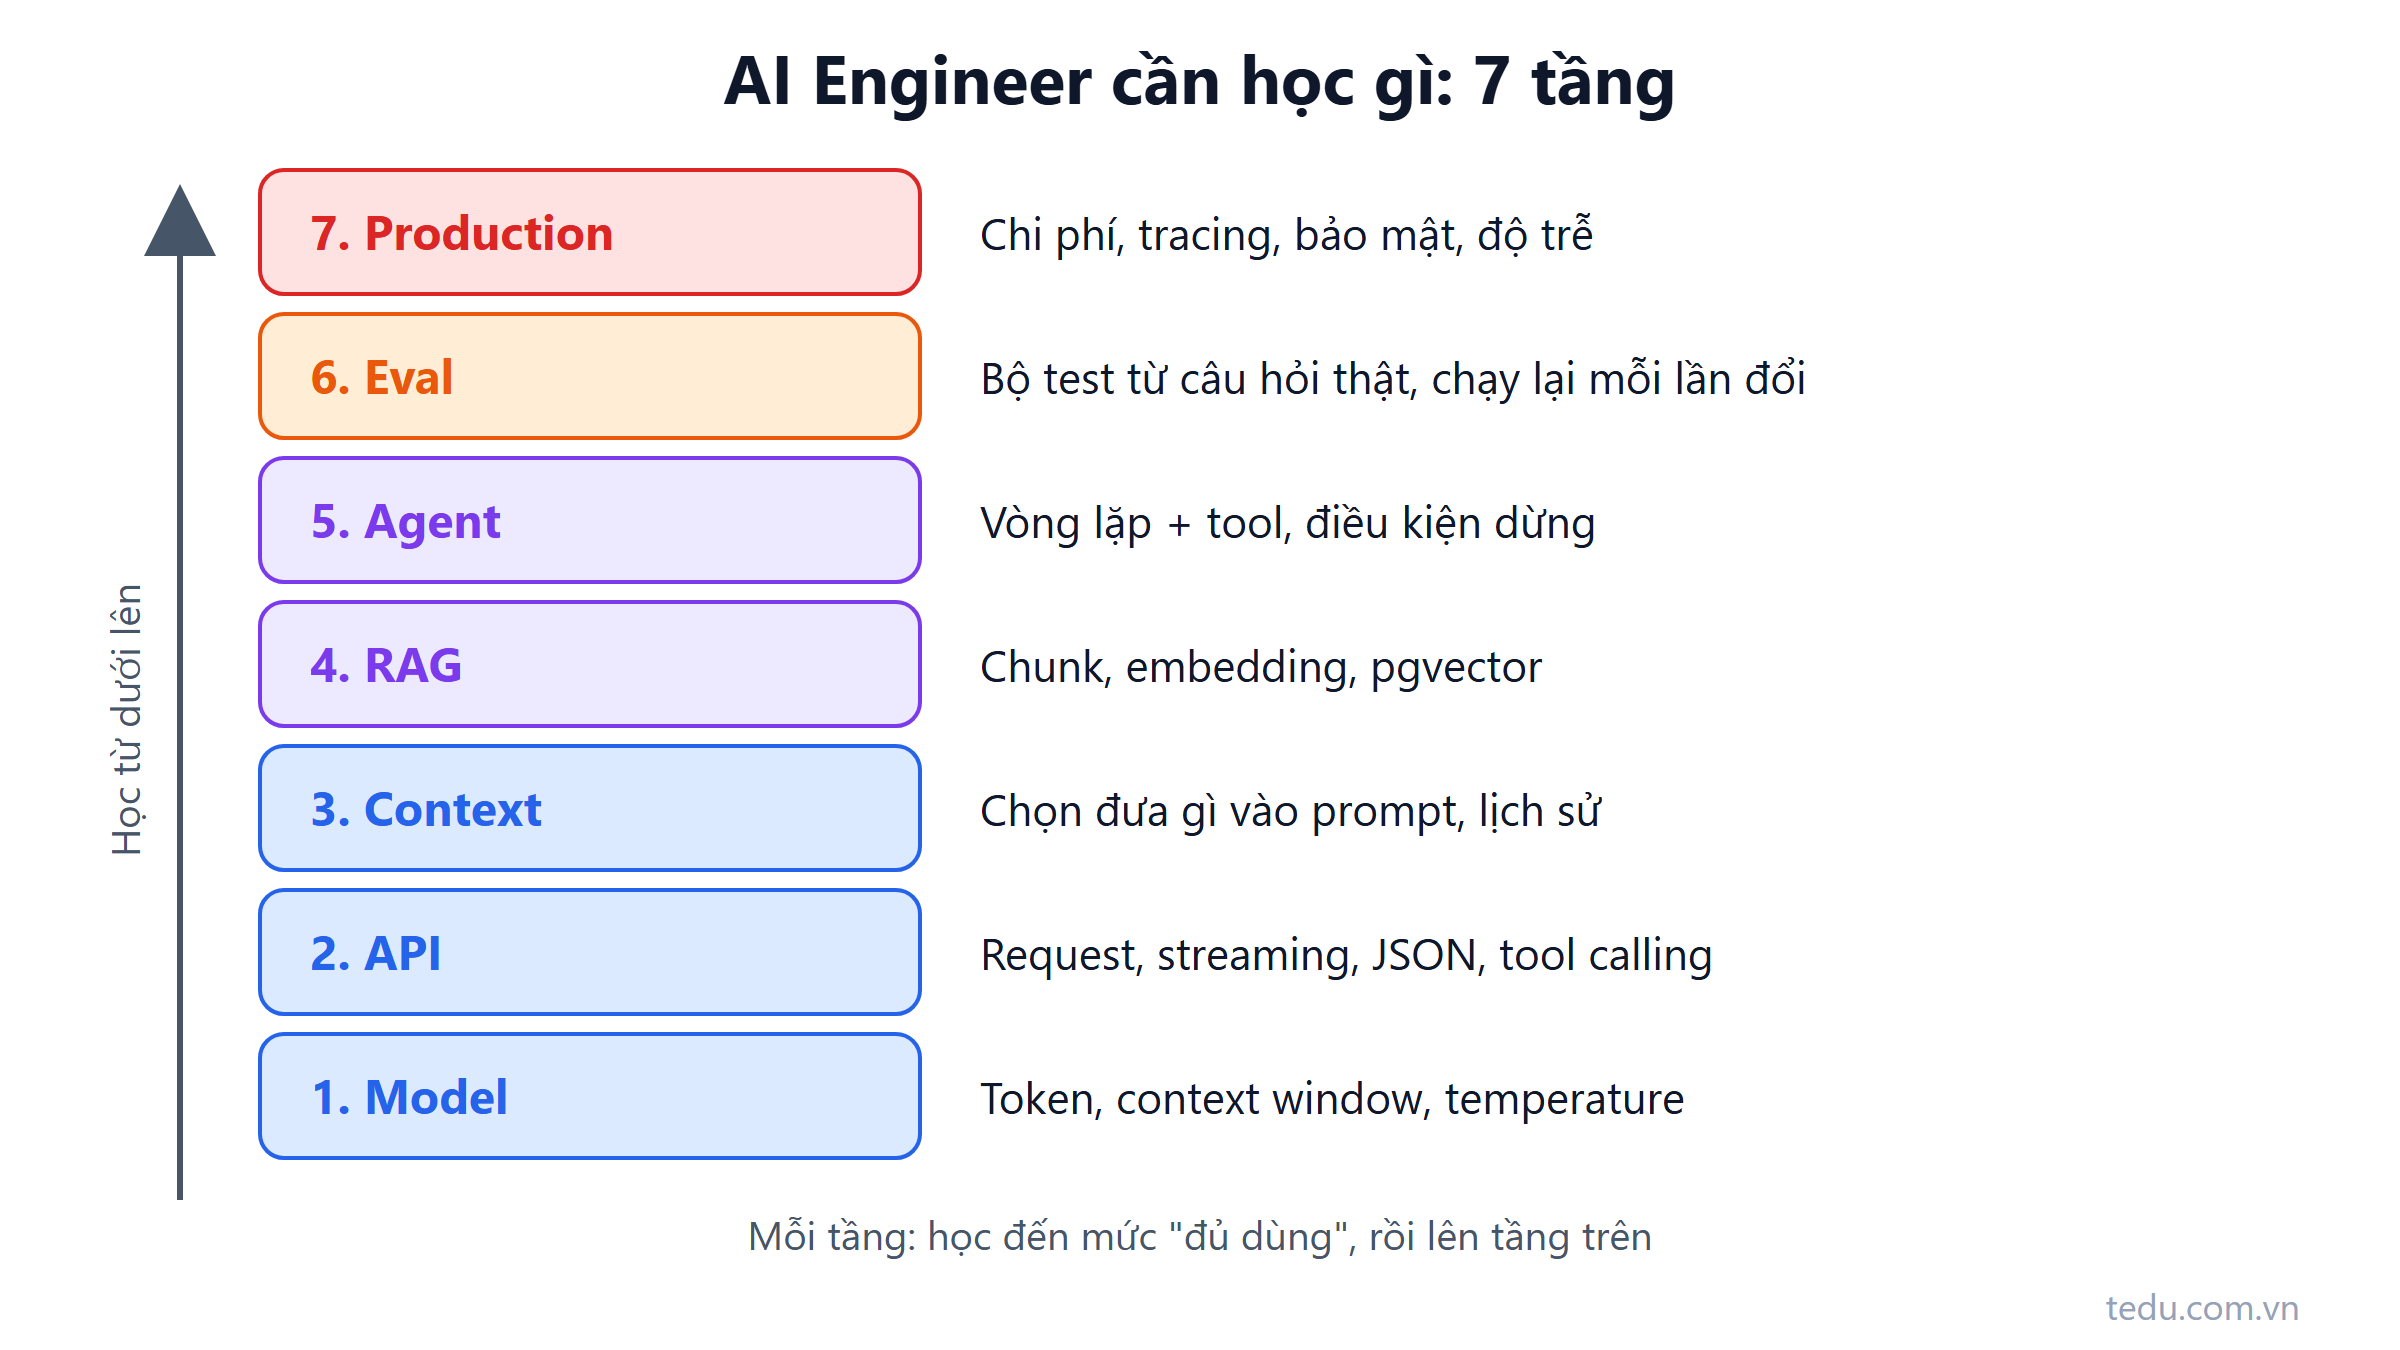
AI Engineer cần học gì? Bản đồ từ Model đến Production
Checklist kỹ năng AI Engineer theo 7 tầng từ Model đến Production, mỗi tầng có phần đủ dùng và phần chưa cần học, dành cho backend developer.
Đọc thêm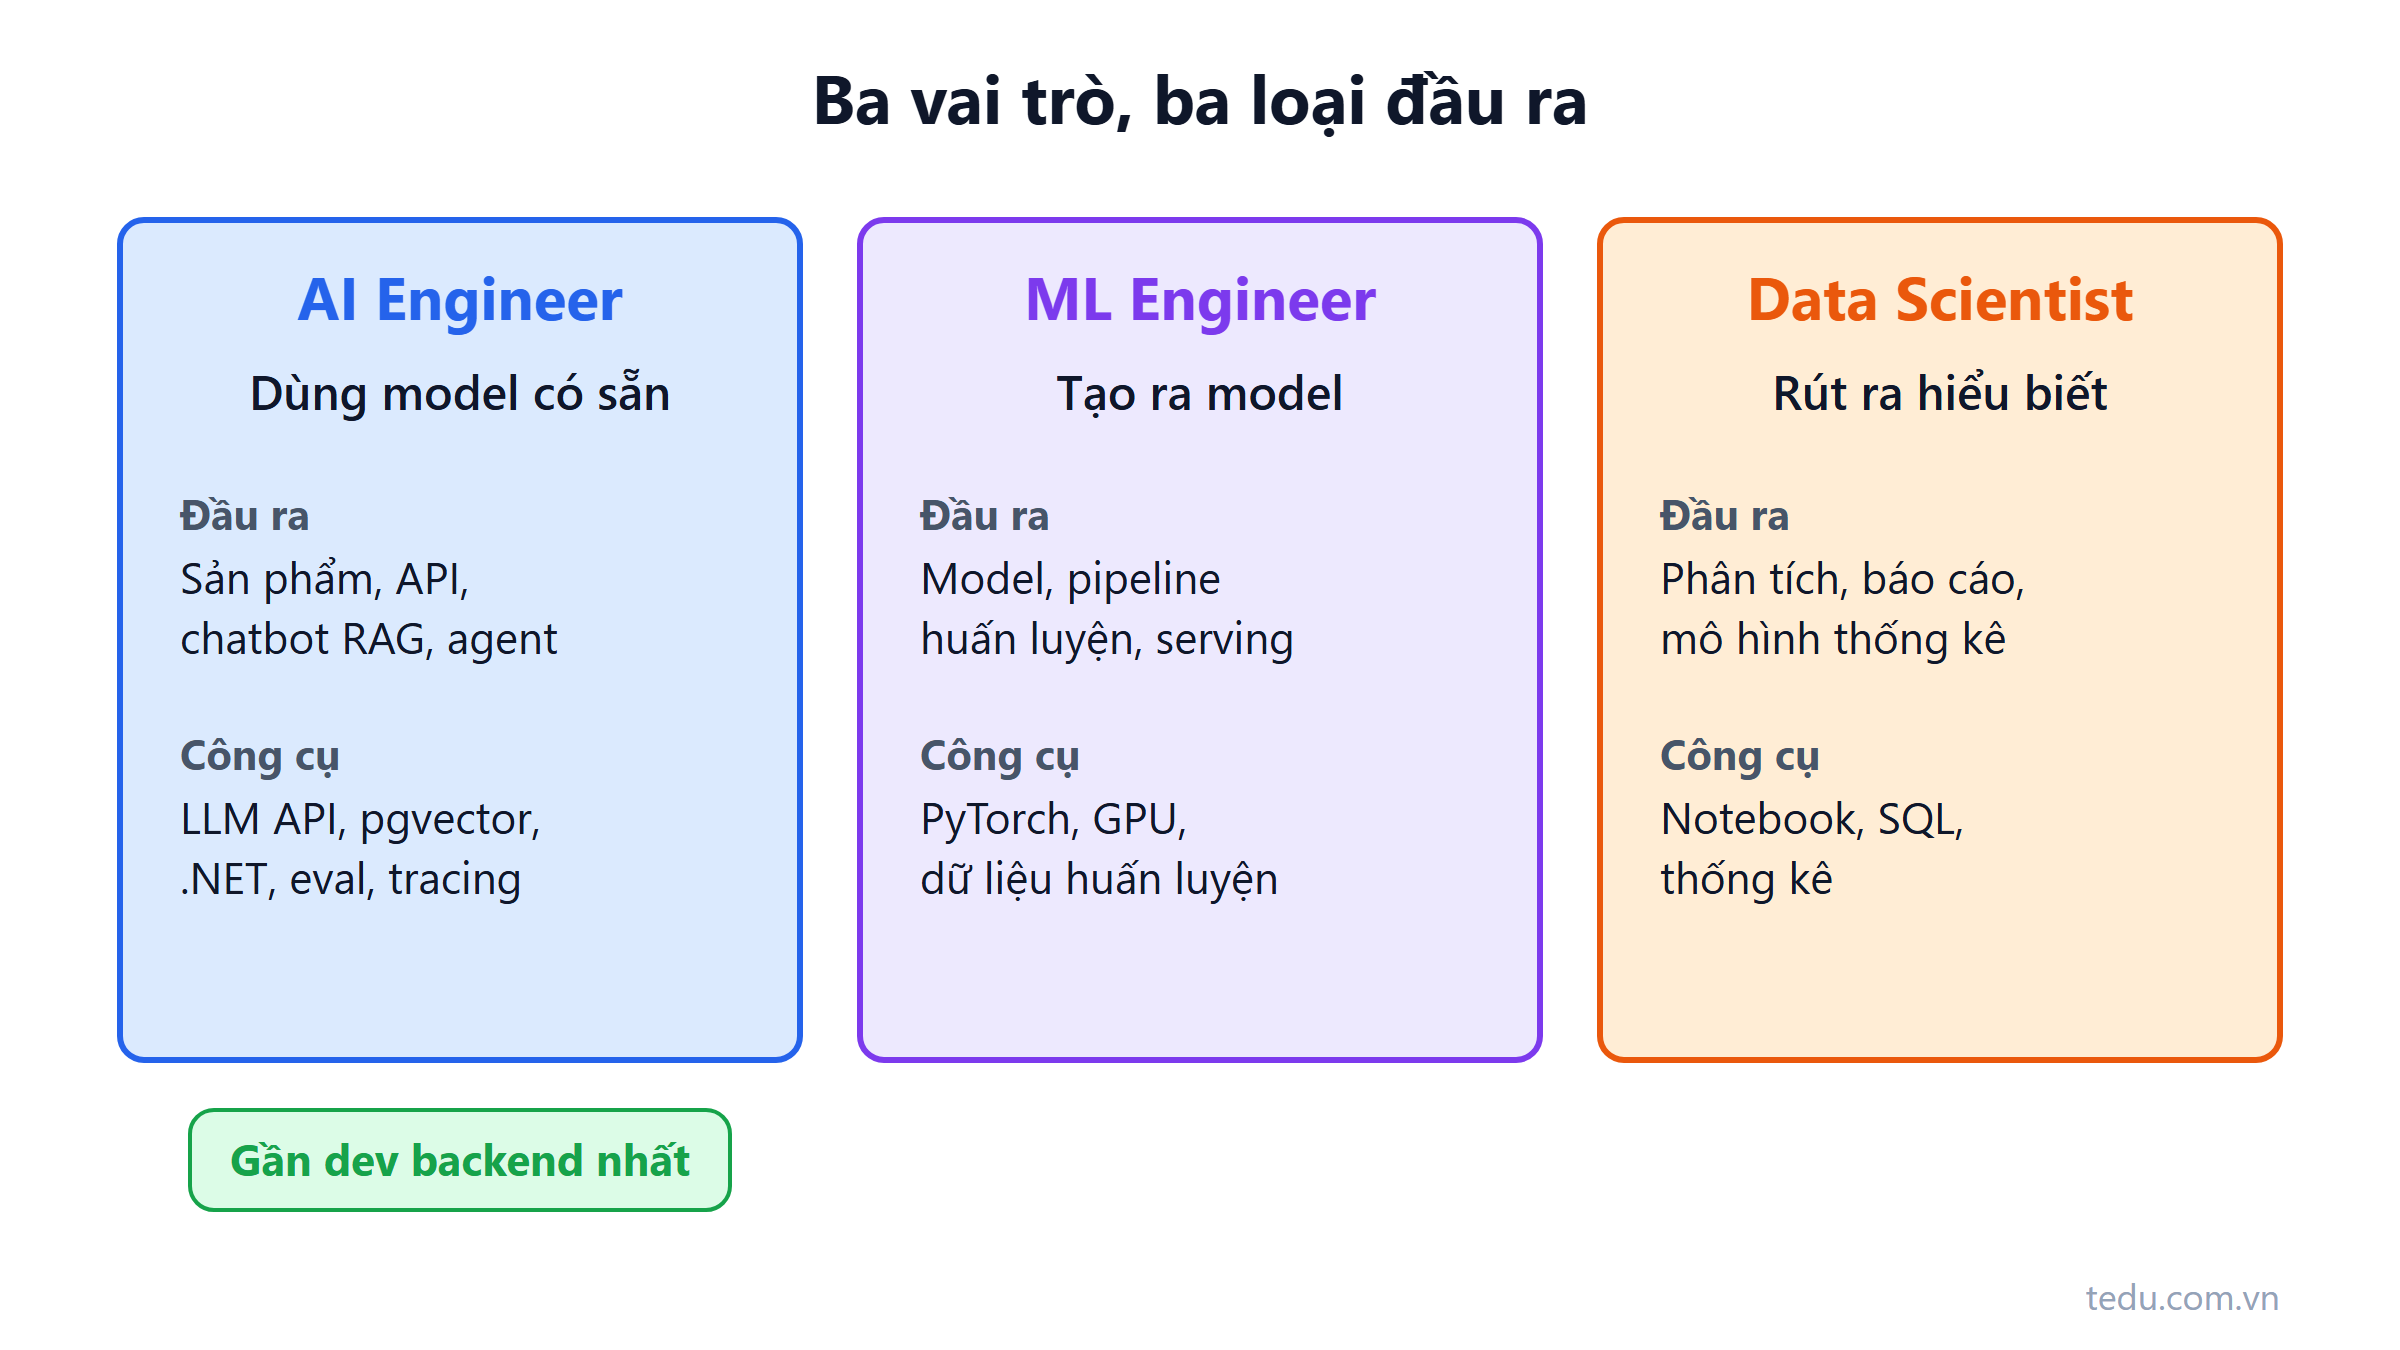
AI Engineer là gì? Khác ML Engineer ở đâu
AI Engineer là kỹ sư xây ứng dụng bằng model AI có sẵn qua API. Bài này giải thích công việc hằng ngày và điểm khác với ML Engineer, Data Scientist.
Đọc thêm