

Nâng cấp PostgreSQL tại chỗ không downtime trên cụm phân tán
Bối cảnh và lựa chọn thay thế
Bài trước của tác giả trình bày cách nâng cấp cuốn chiếu: thêm node mới chạy phiên bản mới, cho vào cụm Spock rồi loại node cũ. Cách này hiệu quả nhưng đòi hỏi thêm một server cho mỗi node cần nâng cấp. Nhiều khách hàng không có phần cứng dư, hoặc cơ sở dữ liệu quá lớn để giữ thêm bản sao đầy đủ.
Giải pháp thứ hai là nâng cấp tại chỗ từng node. Node đang nâng cấp có ngừng hoạt động, nhưng trong cụm đa master các node còn lại vẫn nhận ghi, nên ứng dụng không mất endpoint ghi. Downtime thuộc về một node, không thuộc về người dùng.
Tác giả kiểm thử đầu-cuối trên cùng lab dùng cho bài cuốn chiếu, đưa một node từ PostgreSQL 17.10 lên 18.6, gồm cả standby do Patroni quản lý.
Môi trường thử nghiệm
Cụm Spock ba node trên hai máy ảo Rocky Linux ARM64. Node được nâng cấp chạy dưới Patroni với một physical standby, giống hình thái phần lớn node production. Cơ sở dữ liệu chứa các bảng của bộ benchmark, tất cả nằm trong replication set.
Quy trình nâng cấp tại chỗ
Với từng node, làm lần lượt:
- Rút traffic khỏi node, tạm dừng Patroni, dừng standby rồi dừng node.
- Cài PostgreSQL 18, khởi tạo data directory mới và đưa cấu hình Spock vào đó.
- Chạy pg_upgrade, công cụ hard-link các file dữ liệu thay vì sao chép.
- Khởi động node trên PostgreSQL 18 và khôi phục tiến trình replication của Spock.
- Trả node về Patroni và dựng lại standby từ node đó.
Cần tối thiểu ba node để hai node còn lại phục vụ trong khi một node được nâng cấp.
Chuẩn bị trước khi bắt đầu
Kiểm tra node khi còn đang chạy, ghi lại encoding và thiết lập checksum vì cụm mới phải khớp cả hai. Đảm bảo gói Spock cho phiên bản major mới trùng phiên bản Spock mà cụm đang chạy, vì pg_upgrade chuyển dữ liệu từ binary 17 sang 18 nên hai bên cần cùng Spock. Cuối cùng, tắt DDL replication trên mọi node trong suốt quá trình triển khai.
Các bước chính và những cạm bẫy
Bước 1: rút traffic tại load balancer hoặc pooler, xác nhận mọi subscription đến và đi từ node đã bắt kịp, tạm dừng Patroni rồi dừng standby trước, node sau. Cần dừng standby ngay vì khi Postgres dừng, Patroni nhả leader lock kể cả ở chế độ maintenance; một standby cũ còn chạy chính là nguy cơ bị promote nếu ai đó resume Patroni quá sớm.
Bước 2: khởi tạo cụm PostgreSQL 18. Cạm bẫy thứ nhất là checksum: pg_upgrade của PostgreSQL 18 bật data checksum mặc định, nên nếu cụm cũ tắt checksum thì phải chỉ định rõ ràng. Cạm bẫy thứ hai là thứ tự: Spock từ chối nạp trừ khi nằm trong shared_preload_libraries, và pg_upgrade cần nạp nó trong cụm mới, do đó phải thêm cấu hình Spock vào postgresql.conf trước khi chạy pg_upgrade và khớp chính xác tham số với node cũ.
Bước 3: chạy pg_upgrade thử từ thư mục ghi được vì log ghi tại đó, rồi chạy thật. Vì node cũ dùng PostgreSQL 17, pg_upgrade mang theo logical slot; với nguồn 15 hoặc 16 thì slot không được giữ và các node khác phải resync toàn bộ.
Bước 4: khởi động node trên PostgreSQL 18. Đây là phần quan trọng nhất: Spock theo dõi vị trí áp dụng của mỗi subscription bằng replication origin, và pg_upgrade không mang chúng theo, chỉ làm vậy với subscription gốc của PostgreSQL. Thiếu origin, node nâng cấp vẫn gửi thay đổi nhưng không áp dụng gì, mà các node khác vẫn báo nó khỏe mạnh. Cách sửa là tạo lại từng origin tại vị trí provider ghi nhận lần cuối, vị trí này vẫn nằm trong slot của provider.
Bước 5: trỏ cấu hình Patroni của node sang data directory và binary mới; chỉ reload là không đủ, phải khởi động lại tiến trình Patroni. pg_upgrade tạo system identifier mới trong khi etcd vẫn giữ cái cũ, nên phải xóa bản ghi cụm khỏi etcd và để Patroni nhận lại instance đang chạy. Việc này chỉ sạch nếu cấu hình Spock nằm trong phần cấu hình Patroni, vì Patroni ghi phần đó vào etcd khi nhận node.
Bước 6: physical standby không thể theo primary qua major version nên phải dựng lại từ node đã nâng cấp. Xóa thư mục standby cũ và khởi động Patroni của nó; với data directory rỗng, Patroni tự chạy pg_basebackup từ leader mới. pg_basebackup không mang theo max_slot_wal_keep_size nên phải đặt lại trên leader để các node Spock không vượt trước standby.
Bước 7: chạy đủ ba việc hậu kiểm mà pg_upgrade in ra, gồm cập nhật extension đổi phiên bản và hai lần chạy để dựng lại thống kê. Chỉ xóa cụm cũ khi đã hài lòng, rồi chuyển sang node tiếp theo và bật lại DDL replication khi xong node cuối.
Kết luận
Nâng cấp tại chỗ cho kết quả như cách cuốn chiếu mà không cần thêm server mỗi node. Phần lớn trục trặc không hiện ra dưới dạng kiểm tra trạng thái thất bại: replication origin của Spock không sống sót qua pg_upgrade, cấu hình Spock phải có trước pg_upgrade, checksum mặc định của PostgreSQL 18, system identifier mới phá resume của Patroni, và phải dựng lại standby bằng cách xóa thư mục. Hãy kiểm tra ghi theo cả hai chiều trước khi chuyển node, vì trạng thái subscription một mình không cho biết node nâng cấp có bị "điếc" hay không.
Nguồn: Planet PostgreSQL
Trích nguồn từ: Planet PostgreSQL
Tags:
Bài viết liên quan
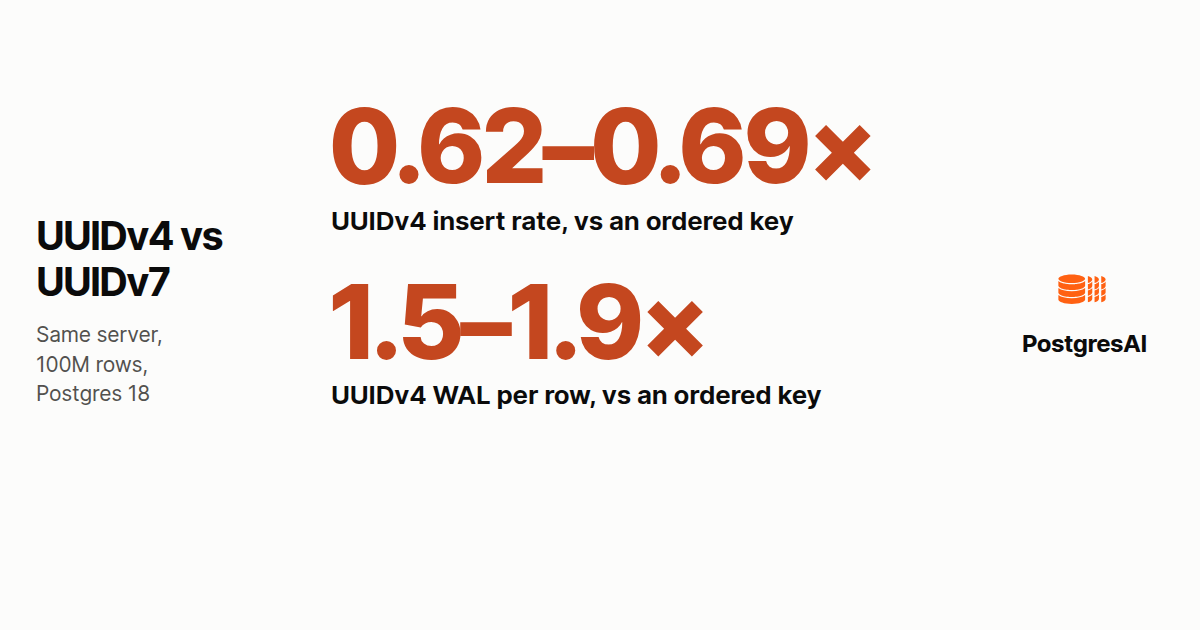
UUIDv4 và UUIDv7 trên Postgres: cái giá của khóa chính ngẫu nhiên
So sánh ba loại khóa chính trên Postgres 18 cho thấy UUIDv4 chèn chậm hơn khóa có thứ tự và ghi WAL nhiều hơn đáng kể ở mức 100 triệu dòng.
Đọc thêm
Ilya Kosmodemiansky bàn về file cấu hình postgresql.conf "mặc định"
Bài đầu tiên trong loạt bốn phần của Ilya Kosmodemiansky (Data Egret) về cách PostgreSQL đọc cấu hình và nhóm thiết lập kết nối, dựa trên bản PostgreSQL 18.
Đọc thêm
Chris van Eijk: Lỗi 'server closed the connection unexpectedly' trong PostgreSQL
Phân tích lỗi PostgreSQL đóng kết nối bất ngờ khi có sáu client, cách đọc log máy chủ theo từng nguyên nhân, nơi lưu lý do và các COMMIT bị mất.
Đọc thêm
Christophe Pettus: Hiểu đúng về row_security trong PostgreSQL
Chuyên gia tư vấn PostgreSQL Christophe Pettus giải thích rằng đặt row_security = off không tắt bảo mật cấp dòng mà sẽ gây lỗi khi có chính sách được áp dụng.
Đọc thêm
Mô hình Data Warehouse: Sơ đồ ngôi sao
Trình bày về mô hình ngôi sao (star schema) khi xây dựng một dat a warehouse phục vụ mục đích báo cáo và phân tích cho doanh nghiệp.
Đọc thêm
Sự khác nhau giữa hệ thống OLAP và OLTP?
Có 2 loại ứng dụng cơ sở dữ liệu trong việc phát triển ứng dụng mà chúng ta cần biết. Bài viết này sẽ nói cho bạn biết sự giống và khác nhau giữa 2 loại hệ thống này.
Đọc thêm