Cùng truy vấn, cùng index nhưng hiệu năng khác nhau khi chuyển PostgreSQL lên Azure
Cùng truy vấn, cùng index, hiệu năng khác nhau
Một khách hàng đang chuẩn bị chuyển PostgreSQL từ on-premises lên Azure Database for PostgreSQL. Trong quá trình kiểm thử hiệu năng, họ phát hiện một truy vấn trước đây chỉ mất vài chục mili giây nay lại cần 1-2 giây trên môi trường Azure. Chạy lại thì nhanh, nhưng khi dữ liệu bị đẩy khỏi cache, thời gian chậm lại xuất hiện.
Máy chủ dự kiến lên production tiêu thụ IOPS nhiều hơn 10-20% so với máy chủ dựng để so sánh. Một lần chạy với cache lạnh, chỉ một Index Scan đã kéo hơn 100 trang heap, trong khi máy kia chỉ kéo 60 trang. Khách hàng nghĩ đến bloat hoặc phân mảnh, thử VACUUM FULL nhưng không cải thiện.
Index có thực sự là vấn đề?
Hai giả thuyết được đặt ra: index có vấn đề (bloat, mật độ leaf, phân mảnh) hoặc storage có vấn đề. Kiểm tra bằng pg_stattuple và pg_statindex không thấy bất thường về mật độ leaf hay phân mảnh; telemetry cũng không cho thấy lỗi storage.
Cần nhớ rằng index scan dùng index để định vị các tuple khớp, rồi ghé các trang heap của bảng để lấy chúng. Index có thứ tự, còn heap thì không bắt buộc. Nếu 200 dòng kết quả nằm trên 5 trang heap thì chi phí truy cập thấp; nếu chúng rải trên 100 trang thì cùng số dòng nhưng khối lượng đọc lớn hơn nhiều. Cả hai đều hiển thị Index Scan trong execution plan, nhưng không có nghĩa là làm khối lượng công việc như nhau.
Nhóm phân tích so sánh đầu ra EXPLAIN (ANALYZE, BUFFERS), chú ý đến buffer hits và reads thay vì chỉ loại scan. Lưu ý: shared-buffer read nghĩa là trang không nằm trong shared buffers của PostgreSQL, không hẳn là đọc từ storage vật lý vì OS có thể vẫn cache.
Manh mối từ correlation
Một dấu hiệu hữu ích nằm trong pg_stats. Chỉ số correlation mô tả mức độ thứ tự logic của một cột bám theo thứ tự vật lý của bảng; gần 1 hoặc -1 là bám sát, gần 0 là ít liên quan. PostgreSQL dùng thống kê này khi ước tính chi phí index scan.
Trong trường hợp này, môi trường chậm có correlation khoảng 0,037, còn môi trường kiểm thử nhanh khoảng 0,571. Tuy nhiên correlation là thống kê lấy mẫu trên toàn cột, không cho biết chính xác một lần tra cứu cụ thể chiếm bao nhiêu trang heap.
Truy vấn đo đạc thực tế
PostgreSQL có cột hệ thống ctid xác định vị trí vật lý của tuple dưới dạng (block_number, tuple_number). Tách số block cho phép đếm số trang heap riêng biệt chứa các dòng khớp. Với bảng không phân vùng, đếm distinct block_number; với bảng phân vùng, đếm cặp (tableoid, block_number). Lưu ý ctid chỉ là công cụ chẩn đoán, không phải định danh dòng vĩnh viễn vì update và rewrite bảng có thể thay đổi nó.
Kết quả với hai giá trị tra cứu đại diện:
- Tra cứu A: 157 dòng, môi trường chậm chiếm 119 trang heap, môi trường nhanh 33 trang
- Tra cứu B: 200 dòng, môi trường chậm chiếm 101 trang heap, môi trường nhanh chỉ 5 trang
Với tra cứu B, các dòng khớp ở môi trường chậm nằm trên số trang heap gấp khoảng 20 lần. Index không hề thất bại trong việc tìm dòng; vấn đề là sau khi tìm thấy, các dòng nằm rải rác trên quá nhiều trang.
Vì sao dữ liệu bị phân tán?
Khách hàng nạp dữ liệu vào Azure song song. Cách này tăng thông lượng nạp nhưng các dòng thuộc những giá trị tra cứu khác nhau bị xen kẽ. Những dòng liên quan từng nằm cạnh nhau ở môi trường nguồn nay không còn nằm cạnh nhau trên heap đích. Nạp song song không đương nhiên gây phân tán; kết quả phụ thuộc cách chia việc và cách insert chạm heap, nhưng ở trường hợp này phương pháp nạp giải thích được khác biệt.
Tạo lại cùng index không khôi phục được tính cục bộ đó: B-tree sắp xếp các mục của chính nó, việc build hay rebuild không sắp xếp lại bảng bên dưới. Điều này cũng giải thích hành vi cache: chạy lặp lại được lợi từ các trang đã cache, che lấp chi phí của footprint lớn hơn; khi các trang bị đẩy ra, truy vấn phải lấy lại.
Sửa bố cục rồi đo lại
VACUUM FULL không giải quyết vấn đề bố cục này vì nó viết lại bảng để thu hồi không gian từ dead tuple và nén heap, nhưng không sắp xếp các dòng còn sống theo khóa tra cứu. Bước tiếp theo là tổ chức lại heap quanh khóa tra cứu. CLUSTER có thể viết lại bảng theo thứ tự index nhưng cần khóa ACCESS EXCLUSIVE nên phải lên lịch cẩn thận. Khách hàng dùng pg_repack với --order-by để tổ chức lại dữ liệu và báo hiệu năng cải thiện trên bản kiểm thử phục hồi.
Đây cũng không phải thao tác bảo trì miễn phí: cần kiểm tra hỗ trợ extension, dung lượng trống và yêu cầu khóa trước khi chọn. Sau đó chạy ANALYZE làm mới thống kê, lặp lại truy vấn đếm trang riêng biệt, so sánh execution plan và thời gian trong điều kiện cache tương đương. Lưu ý chính truy vấn chẩn đoán cũng làm nóng các trang, nên đừng coi lần chạy ngay sau đó là kiểm thử cache lạnh.
Cả clustering lẫn repack đều không duy trì thứ tự vĩnh viễn. Các ghi tiếp theo có thể bào mòn tính cục bộ, nên chiến lược nạp dữ liệu khi migration và khối lượng công việc thường xuyên đều cần được quan tâm.
Kết luận
Trước khi đổ lỗi cho độ trễ storage, hãy kiểm tra mỗi môi trường cần đọc bao nhiêu trang cho cùng một truy vấn. Với khách hàng này, correlation dẫn đến việc xem xét bố cục heap; đếm số trang heap riêng biệt cho thấy các dòng khớp phân tán đến mức nào. Bài học không phải là "đừng nạp song song" hay "Azure cần đĩa lớn hơn", mà là chuyển cùng dòng và cùng index không có nghĩa là chuyển cùng bố cục vật lý. Index scan chỉ là một nửa câu chuyện.
Nguồn: Planet PostgreSQL
Trích nguồn từ: Planet PostgreSQL
Tags:
Bài viết liên quan
json và jsonb trong PostgreSQL: đo kích thước và tốc độ thực tế
So sánh json và jsonb trên PostgreSQL 17 và 18 với sáu dạng tài liệu, cho thấy jsonb có thể nhỏ hơn 23% hoặc lớn hơn 41%, kèm tốc độ đọc và chỉ mục GIN.
Đọc thêm
PostgreSQL có thực sự đang thắng? Bằng chứng vượt xa các bảng xếp hạng
Bài viết của Dave Stokes tổng hợp khảo sát người dùng, các thương vụ mua bán công ty PostgreSQL, sản phẩm của đối thủ và lựa chọn của AI agent để lập luận PostgreSQL đang dẫn đầu mảng cơ sở dữ liệu vận hành.
Đọc thêm
PostgreSQL, NUMA và điện toán đám mây: những lưu ý khi chạy trong VM và container
Bài cuối trong loạt 4 phần về PostgreSQL và NUMA, tập trung vào thách thức khi chạy PostgreSQL trên máy ảo và container trong môi trường đám mây, kèm các khuyến nghị thực hành.
Đọc thêm
Nâng cấp PostgreSQL tại chỗ không downtime trên cụm phân tán
Ahsan Hadi hướng dẫn nâng cấp tại chỗ từng node PostgreSQL từ 17.10 lên 18.6 trên cụm Spock đa master, giữ ứng dụng luôn có endpoint ghi trong khi mỗi node tạm ngừng vài phút.
Đọc thêm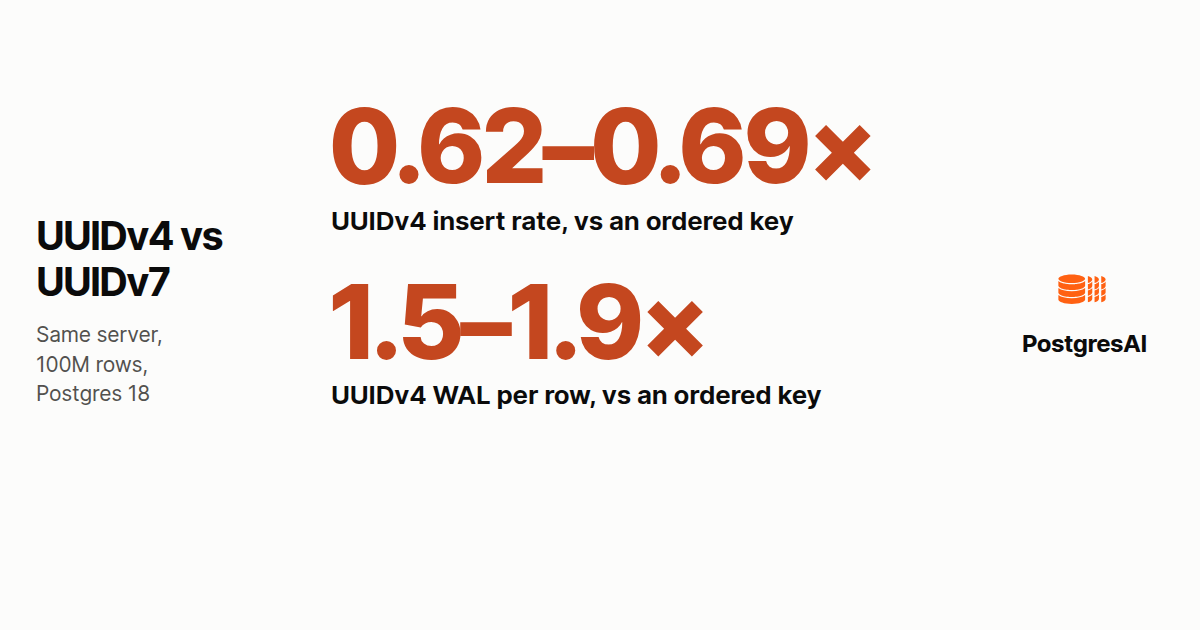
UUIDv4 và UUIDv7 trên Postgres: cái giá của khóa chính ngẫu nhiên
So sánh ba loại khóa chính trên Postgres 18 cho thấy UUIDv4 chèn chậm hơn khóa có thứ tự và ghi WAL nhiều hơn đáng kể ở mức 100 triệu dòng.
Đọc thêm
Ilya Kosmodemiansky bàn về file cấu hình postgresql.conf "mặc định"
Bài đầu tiên trong loạt bốn phần của Ilya Kosmodemiansky (Data Egret) về cách PostgreSQL đọc cấu hình và nhóm thiết lập kết nối, dựa trên bản PostgreSQL 18.
Đọc thêm
Chris van Eijk: Lỗi 'server closed the connection unexpectedly' trong PostgreSQL
Phân tích lỗi PostgreSQL đóng kết nối bất ngờ khi có sáu client, cách đọc log máy chủ theo từng nguyên nhân, nơi lưu lý do và các COMMIT bị mất.
Đọc thêm
Christophe Pettus: Hiểu đúng về row_security trong PostgreSQL
Chuyên gia tư vấn PostgreSQL Christophe Pettus giải thích rằng đặt row_security = off không tắt bảo mật cấp dòng mà sẽ gây lỗi khi có chính sách được áp dụng.
Đọc thêm
Mô hình Data Warehouse: Sơ đồ ngôi sao
Trình bày về mô hình ngôi sao (star schema) khi xây dựng một dat a warehouse phục vụ mục đích báo cáo và phân tích cho doanh nghiệp.
Đọc thêm
Sự khác nhau giữa hệ thống OLAP và OLTP?
Có 2 loại ứng dụng cơ sở dữ liệu trong việc phát triển ứng dụng mà chúng ta cần biết. Bài viết này sẽ nói cho bạn biết sự giống và khác nhau giữa 2 loại hệ thống này.
Đọc thêm