

Context engineering là gì, vì sao quan trọng hơn prompt
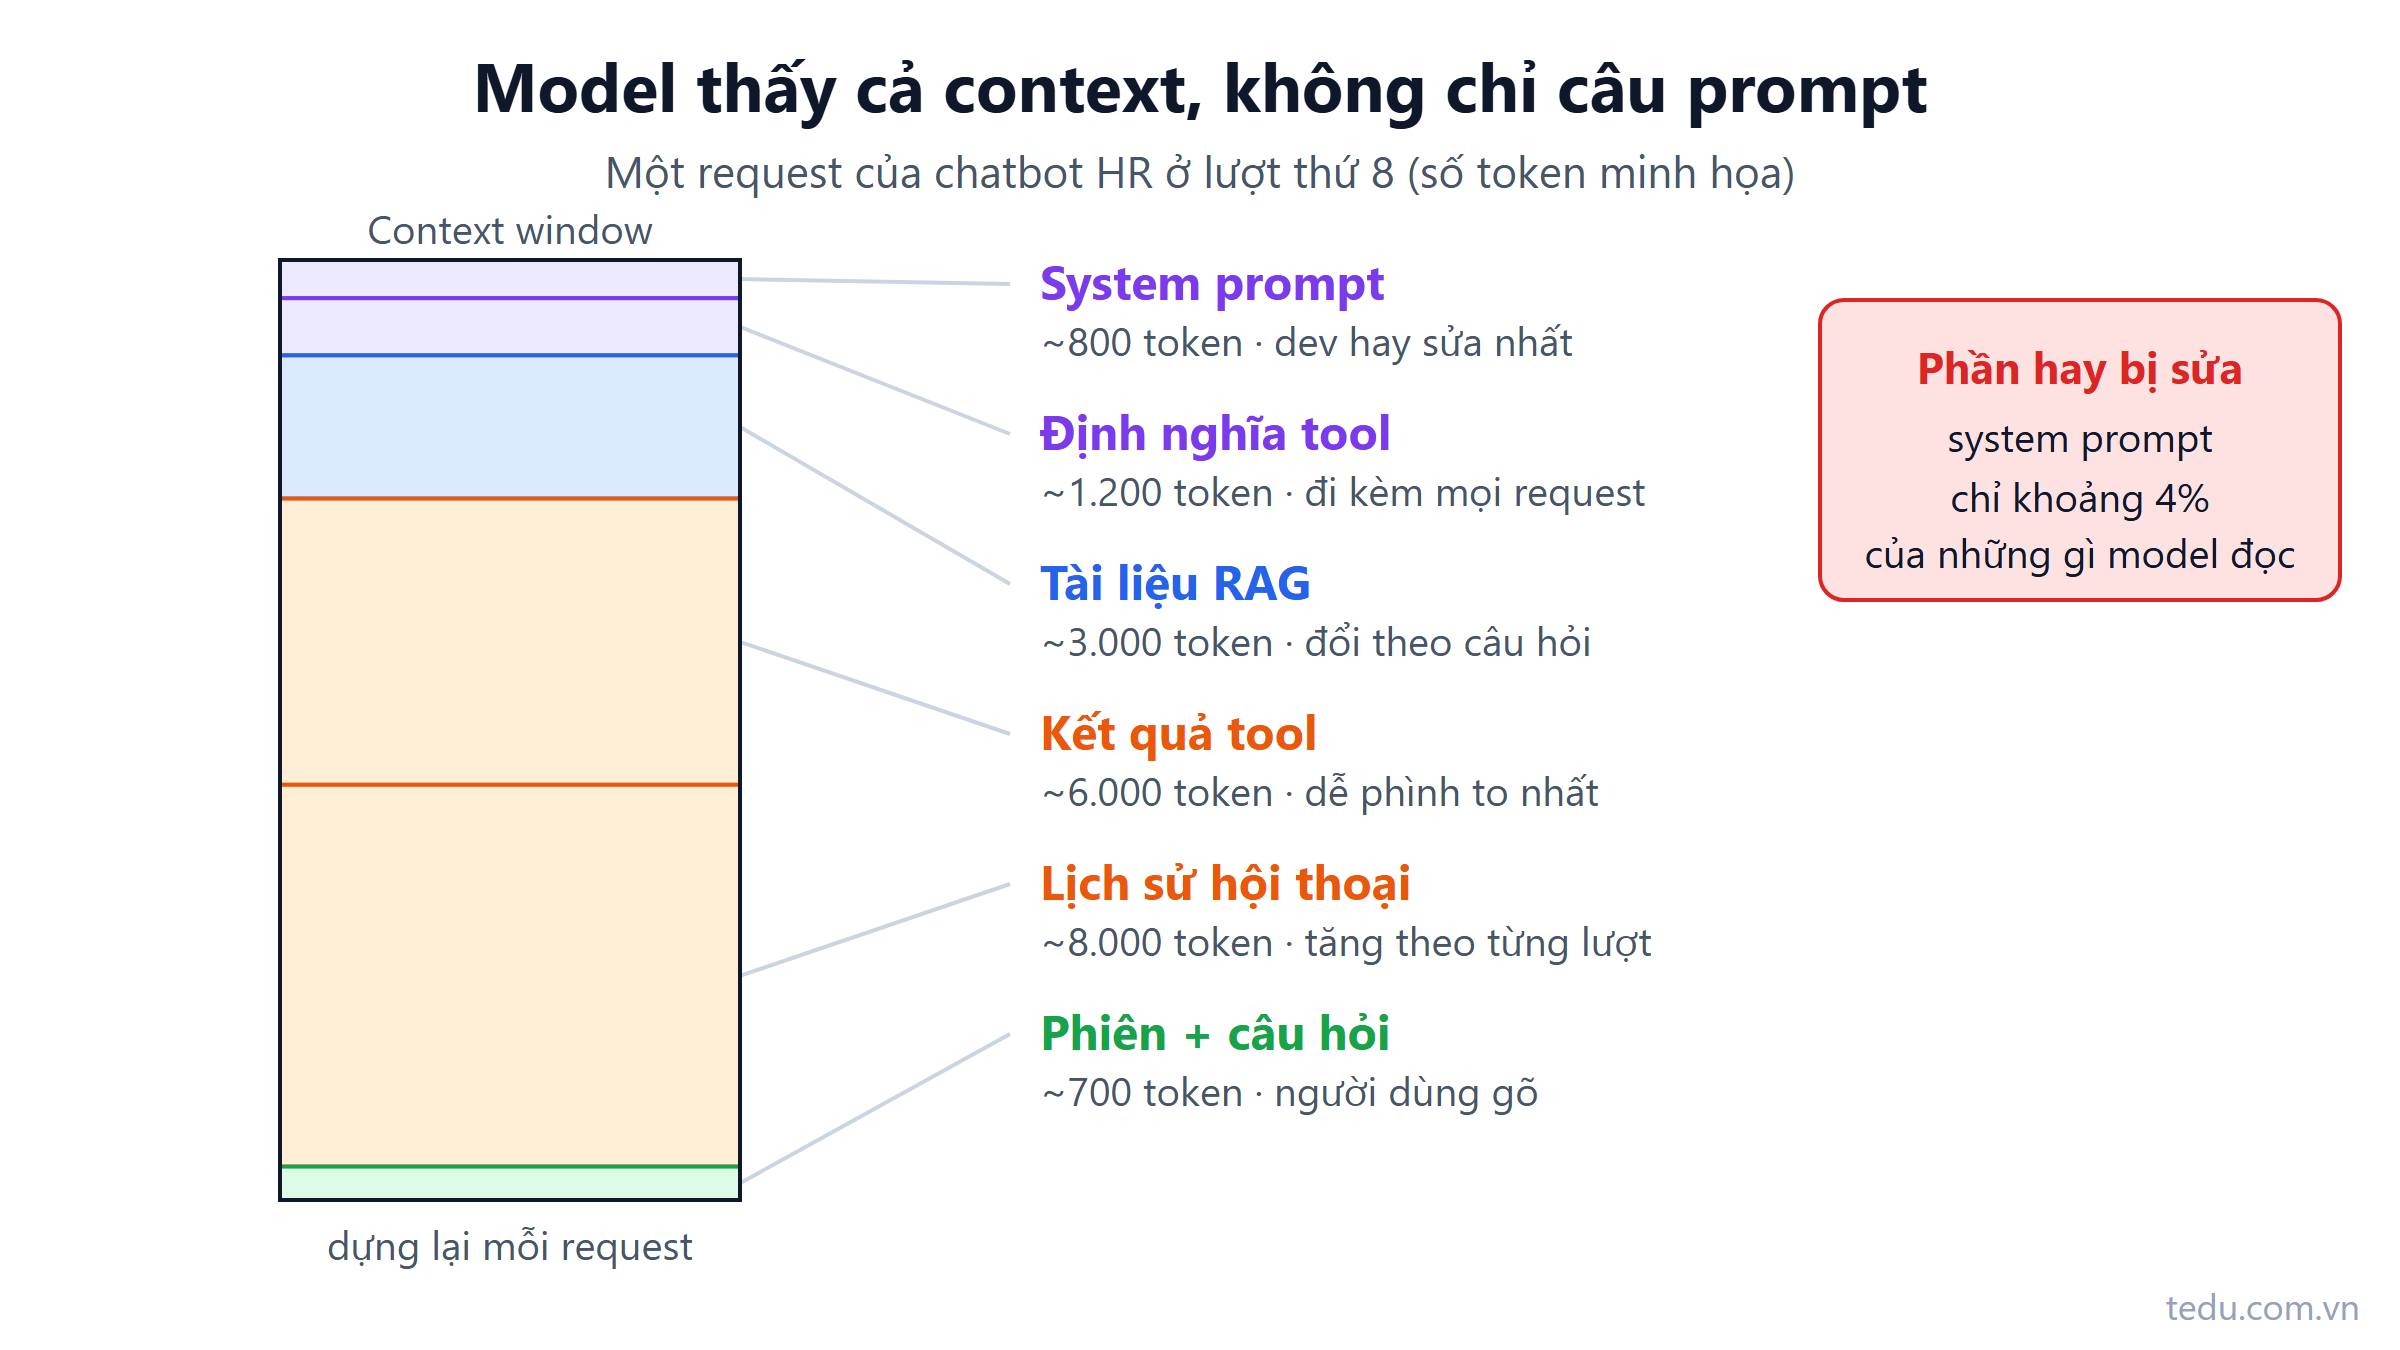
Chatbot HR của một công ty trả lời sai câu "em còn bao nhiêu ngày phép". Dev phụ trách mở system prompt ra sửa cả buổi chiều: thêm "hãy cẩn thận", thêm "TUYỆT ĐỐI chỉ dùng dữ liệu được cung cấp", viết hoa vài chữ cho chắc. Câu trả lời vẫn sai. Cuối ngày, anh in toàn bộ request gửi đi ra màn hình và đọc từ đầu đến cuối. Thủ phạm nằm ở giữa: kết quả tool tra phép năm trả về nguyên bản ghi 4.000 token, trong đó có cả số phép của năm ngoái, và model lấy nhầm con số đó.
Vấn đề không nằm ở câu prompt. Nó nằm ở những gì model nhìn thấy. Đó là lý do người làm AI Engineer giờ nói nhiều về context engineering hơn là prompt engineering. Prompt engineering chưa chết, nhưng nó chỉ là một phần nhỏ của việc chính.
Context engineering là gì
Model không đọc "câu prompt" của bạn. Model đọc toàn bộ context window: mọi token bạn gửi trong một request. Câu prompt bạn viết chỉ là một mảnh trong đó.
Một request của chatbot HR ở trên thật ra chứa:
| Thành phần | Ai tạo ra | Thay đổi khi nào |
|---|---|---|
| System prompt | Dev viết | Khi deploy phiên bản mới |
| Định nghĩa tool | Dev viết | Khi thêm hoặc sửa tool |
| Tài liệu truy xuất (RAG) | Hệ thống tìm kiếm | Mỗi câu hỏi |
| Kết quả tool | API nội bộ, DB | Mỗi lần model gọi tool |
| Lịch sử hội thoại | Người dùng và model | Mỗi lượt |
| Thông tin phiên: người dùng, phòng ban, ngày | App | Mỗi phiên hoặc mỗi request |
| Câu hỏi hiện tại | Người dùng | Mỗi lượt |
Vì LLM là stateless, mỗi request bạn phải dựng lại toàn bộ đống này từ đầu. Không có "phiên làm việc" nào phía model. Context engineering là công việc quyết định, ở mỗi request:
Cái gì được vào: tài liệu nào, tool nào, bao nhiêu lượt lịch sử.
Cái gì phải ra: kết quả tool cũ, lịch sử đã lỗi thời, tài liệu không liên quan.
Theo thứ tự nào: cái gì đứng đầu, cái gì đứng cuối, cái gì được gắn nhãn rõ ràng.
Nói theo ngôn ngữ dev backend: prompt engineering giống viết một câu SQL hay. Context engineering giống thiết kế cả tầng truy cập dữ liệu: lấy dữ liệu gì, từ đâu, lọc thế nào, ghép ra sao, trước khi câu SQL đó được chạy.
Vì sao prompt engineering không còn đủ
Thời mới có ChatGPT, phần lớn ứng dụng là một câu hỏi, một câu trả lời. Context gần như chỉ có câu prompt, nên viết prompt khéo là đủ.
Ứng dụng bây giờ khác. Một agent CSKH có thể gọi 4 tool, đọc 6 đoạn tài liệu, mang theo 15 lượt hội thoại. Câu system prompt 300 token bạn chăm chút cả tuần đang nằm cạnh 20.000 token do hệ thống tự ghép vào. Bạn sửa 300 token đó, trong khi vấn đề nằm ở 20.000 token còn lại.
| Tiêu chí | Prompt engineering | Context engineering |
|---|---|---|
| Đối tượng | Câu chữ của prompt | Toàn bộ những gì vào context window |
| Câu hỏi chính | "Viết thế nào cho model hiểu?" | "Model cần thấy gì, không nên thấy gì?" |
| Công cụ | Câu lệnh, ví dụ, định dạng | Truy xuất, lọc, tóm tắt, cắt, sắp xếp, ngân sách token |
| Bản chất | Viết | Thiết kế hệ thống |
| Khi có lỗi | Sửa câu chữ | In toàn bộ request ra đọc |
Prompt engineering vẫn cần: system prompt rõ ràng, ví dụ few-shot tốt vẫn tạo khác biệt. Nhưng nó là một thành phần trong context engineering, không phải toàn bộ.
Bốn việc chính của context engineering
Chọn: chỉ đưa vào thứ cần cho câu hỏi này
Truy xuất tài liệu theo câu hỏi thay vì dán cả bộ quy chế (đó là RAG).
Chỉ khai báo các tool liên quan đến tính năng đang dùng. Chatbot HR không cần tool tra đơn hàng.
Lấy thông tin người dùng cần thiết (phòng ban, cấp bậc), không đưa cả hồ sơ nhân sự.
Cắt và nén: giữ context gọn
Kết quả tool chỉ trả trường cần thiết. Tool tra phép năm trả
{ "year": 2026, "remainingDays": 7 }, không trả nguyên bản ghi 40 cột kèm lịch sử 5 năm.Lịch sử dài thì giữ vài lượt gần nhất nguyên văn, phần cũ hơn thì tóm tắt.
Kết quả tool cũ đã dùng xong có thể thay bằng một dòng ghi chú ngắn.
Sắp xếp: thứ tự ảnh hưởng đến kết quả
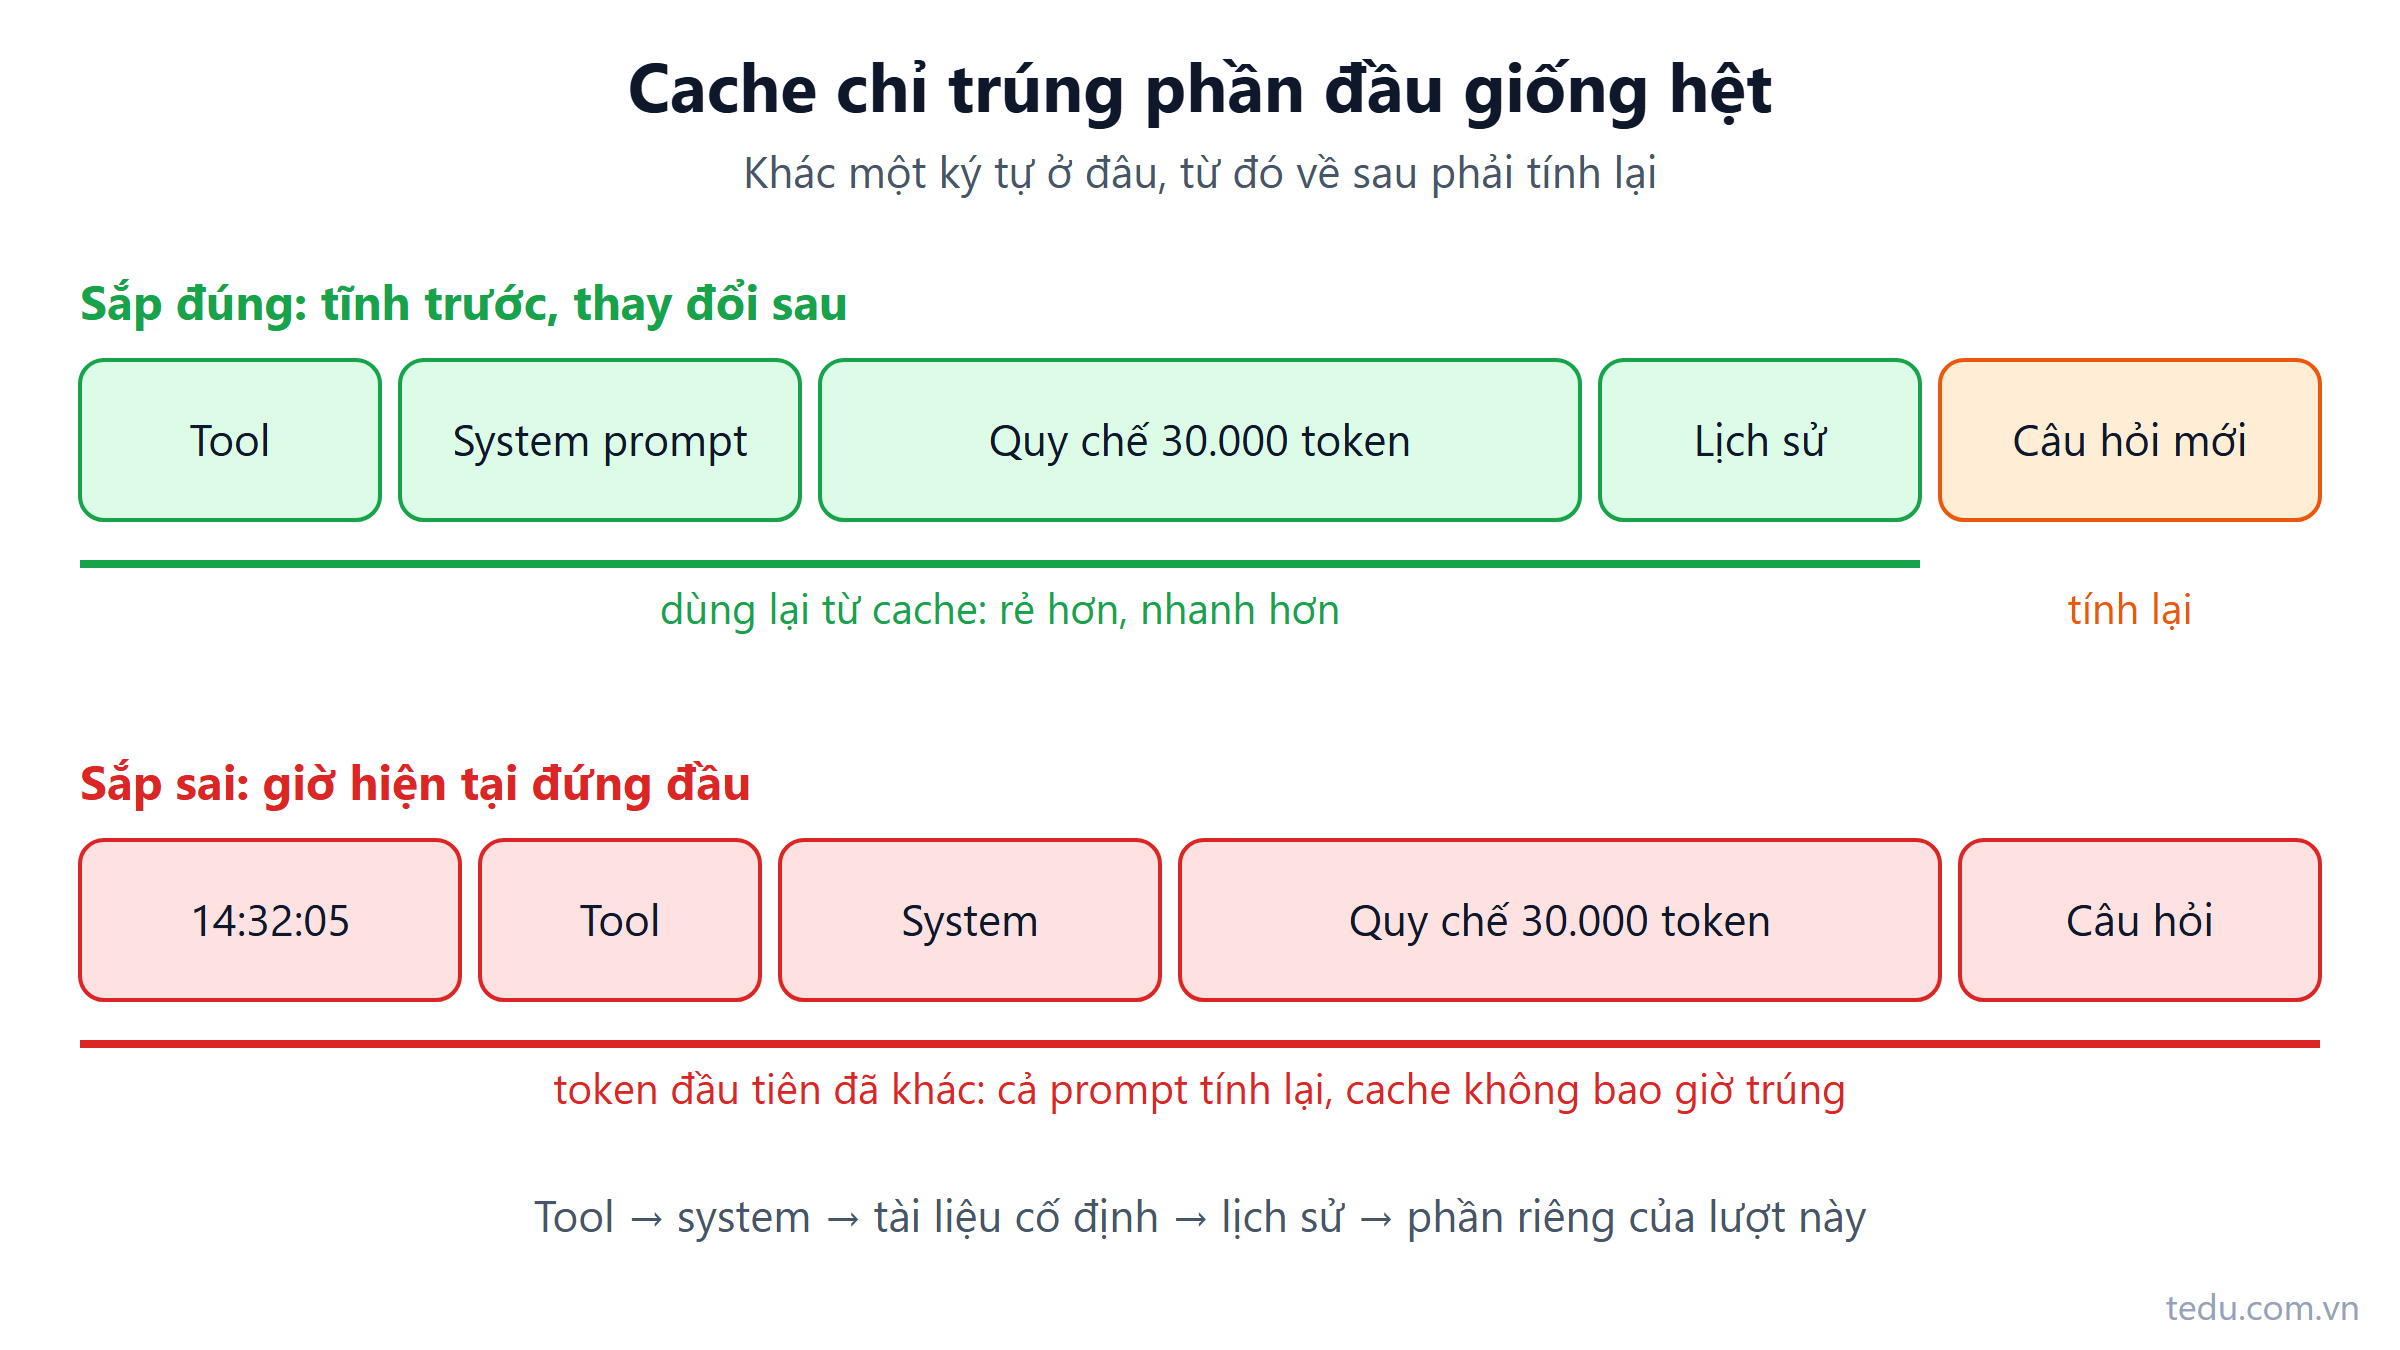
Phần tĩnh đứng trước để hưởng prompt caching.
Thông tin quan trọng không nên bị chôn ở giữa một khối dài. Hiện tượng "lost in the middle" cho thấy model thường dùng thông tin ở đầu và cuối context tốt hơn ở giữa.
Câu hỏi hiện tại và chỉ dẫn quan trọng nhất nên ở gần cuối.
Gắn nhãn: cho model biết mỗi khối là gì
Đừng ghép tài liệu và kết quả tool thành một khối chữ liền. Gắn nhãn nguồn, ngày hiệu lực, loại dữ liệu:
<quy_che nguon="Quy chế nghỉ phép" hieu_luc="2026-01-01">
Nhân viên có từ đủ 12 tháng làm việc được nghỉ 12 ngày phép năm...
</quy_che>

<du_lieu_nhan_vien nguon="HRM" cap_nhat="2026-11-20">
Phép năm 2026 còn lại: 7 ngày
</du_lieu_nhan_vien>
Thẻ dạng XML như trên là một quy ước phổ biến, không phải cú pháp bắt buộc; markdown heading hay JSON cũng được, miễn là nhất quán. Nhãn hieu_luc và cap_nhat giúp model chọn đúng khi hai nguồn mâu thuẫn.
Dựng context bằng code, có ngân sách token
Với dev .NET, context engineering nên là một thành phần có tên, có test, thay vì chuỗi ghép rải rác trong controller. Dưới đây là khung minh họa (Message, ITokenCounter và các kiểu khác là do bạn tự định nghĩa quanh SDK đang dùng):
public sealed class HrContextBuilder(
    IPolicyRetriever retriever, ITokenCounter tokens, IHistoryStore history)
{
    private const int Budget = 12_000;   // ngân sách input, tự đặt theo model và chi phí

    public async Task<List<Message>> BuildAsync(UserSession s, string question, CancellationToken ct)
    {
        var messages = new List<Message> { Message.System(SystemPrompts.HrAssistant) };

        // 1. Chọn: chỉ các đoạn quy chế liên quan, tối đa 4
        var chunks = await retriever.SearchAsync(question, top: 4, ct);
        var docs = string.Join("\n", chunks.Select(c =>
            $"<quy_che nguon=\"{c.Source}\" hieu_luc=\"{c.EffectiveDate:yyyy-MM-dd}\">\n{c.Text}\n</quy_che>"));

        // 2. Nén: lịch sử gần nhất nguyên văn, phần cũ đã được tóm tắt sẵn
        var turns = await history.GetAsync(s.ConversationId, ct);
        var summary = turns.Summary;
        var recent = turns.Recent.TakeLast(6).ToList();

        // 3. Cắt theo ngân sách: bỏ bớt lượt cũ nếu vượt
        while (recent.Count > 0 && tokens.Count(SystemPrompts.HrAssistant, docs, summary, recent, question) > Budget)
            recent.RemoveAt(0);

        // 4. Sắp xếp: tĩnh trước, phần riêng của lượt này ở cuối
        if (summary is not null) messages.Add(Message.System($"Tóm tắt hội thoại trước: {summary}"));
        messages.AddRange(recent);
        messages.Add(Message.User($"{docs}\n\nNgười hỏi: {s.EmployeeCode}, ngày {DateTime.Today:yyyy-MM-dd}\n\nCâu hỏi: {question}"));

        return messages;
    }
}
Lợi ích của việc gom vào một lớp: bạn viết được unit test kiểu "lịch sử 50 lượt thì context không vượt 12.000 token", "kết quả tool không bao giờ quá 500 token", và log được đúng context đã gửi cho từng request.
Khi agent trả lời sai: đừng sửa prompt trước
Đây là thói quen quan trọng nhất của bài. Lần tới chatbot hoặc agent trả lời sai, in toàn bộ messages gửi đi rồi đọc, trước khi chạm vào system prompt. Đọc như model đọc: từ token đầu tiên đến token cuối cùng.
Những thủ phạm hay gặp nhất:
| Triệu chứng | Thủ phạm thường gặp | Cách sửa |
|---|---|---|
| Trả lời bằng số liệu cũ | Lịch sử chứa câu trả lời cũ, hoặc tool trả cả dữ liệu năm trước | Lọc dữ liệu theo thời điểm, gắn nhãn ngày, bỏ lượt lỗi thời |
| Bỏ qua chỉ dẫn trong system prompt | Một kết quả tool dài mấy nghìn token đè lên, chỉ dẫn bị lu mờ | Rút gọn kết quả tool, nhắc chỉ dẫn quan trọng ở gần cuối |
| Trả lời mâu thuẫn với lượt trước | Lịch sử có hai thông tin trái ngược, ví dụ quy chế cũ và mới | Gắn ngày hiệu lực, loại bỏ bản đã hết hiệu lực khi truy xuất |
| Gọi sai tool | Quá nhiều tool có mô tả gần giống nhau | Bớt tool, viết lại mô tả, chỉ khai báo tool của tính năng hiện tại |
| Trả lời đúng ở lượt đầu, sai dần khi chat dài | Context phình to, thông tin quan trọng trôi vào giữa | Tóm tắt lịch sử, đặt ngân sách token |
| Trả lời câu chung chung thay vì dữ liệu công ty | RAG trả về đoạn không liên quan | Sửa bước truy xuất, không sửa prompt |
Để làm được việc này, bạn cần log được toàn bộ context của từng request ở môi trường dev và staging (chú ý dữ liệu cá nhân khi bật ở production). Không có log này, bạn đang debug một hàm mà không xem được tham số đầu vào.
Ví dụ ở đầu bài được sửa không phải bằng chữ viết hoa nào, mà bằng một dòng Select trong tool tra phép năm để chỉ trả số phép của năm hiện tại. Sửa xong, system prompt còn ngắn đi vì bỏ được mấy câu "TUYỆT ĐỐI".
Checklist context engineering
Liệt kê mọi thành phần vào context của tính năng: system, tool, tài liệu, kết quả tool, lịch sử, thông tin phiên, câu hỏi.
Với mỗi thành phần, trả lời: model có thực sự cần nó cho câu hỏi này không?
Kết quả tool chỉ trả trường cần thiết, có giới hạn độ dài.
Lịch sử có chiến lược: giữ bao nhiêu lượt, khi nào tóm tắt.
Đặt ngân sách token cho cả context và cho từng thành phần.
Gắn nhãn nguồn và ngày cho tài liệu, dữ liệu.
Sắp xếp: tĩnh trước, thay đổi sau, chỉ dẫn quan trọng gần cuối.
Gom việc dựng context vào một lớp riêng, có unit test.
Log toàn bộ context gửi đi; khi sai thì đọc log trước khi sửa prompt.
Kết luận
Prompt là một dòng. Context mới là cả hệ thống. Câu prompt bạn viết chỉ là một phần nhỏ trong những gì model nhìn thấy; phần còn lại do code của bạn ghép vào ở mỗi request, và phần lớn lỗi nằm ở đó. Context engineering là kỹ năng chọn, cắt, sắp xếp và gắn nhãn những thứ ấy, và với dev backend, nó gần với thiết kế tầng dữ liệu hơn là viết văn.
Bước tiếp theo: bật log toàn bộ messages cho tính năng LLM bạn đang làm, chọn một câu trả lời sai gần đây và đọc lại context của nó. Nếu context đang quá dài, bài vì sao nhồi context làm model kém đi sẽ giải thích chuyện gì xảy ra. Bài kế tiếp trong series: few-shot prompting, cho ví dụ thay vì giải thích.
Xem bản tóm tắt dưới một phút trên YouTube @teduco hoặc TikTok @teducolabs, và đọc thêm các bài khác trong chuyên mục AI cho Backend Developer.
Bài viết liên quan
Prompt caching là gì? Cắt chi phí và độ trễ cho LLM
Prompt caching cho phép nhà cung cấp LLM dùng lại phần đầu prompt đã xử lý, giảm chi phí và độ trễ. Bài giải thích cơ chế prefix và cách sắp prompt.
Đọc thêm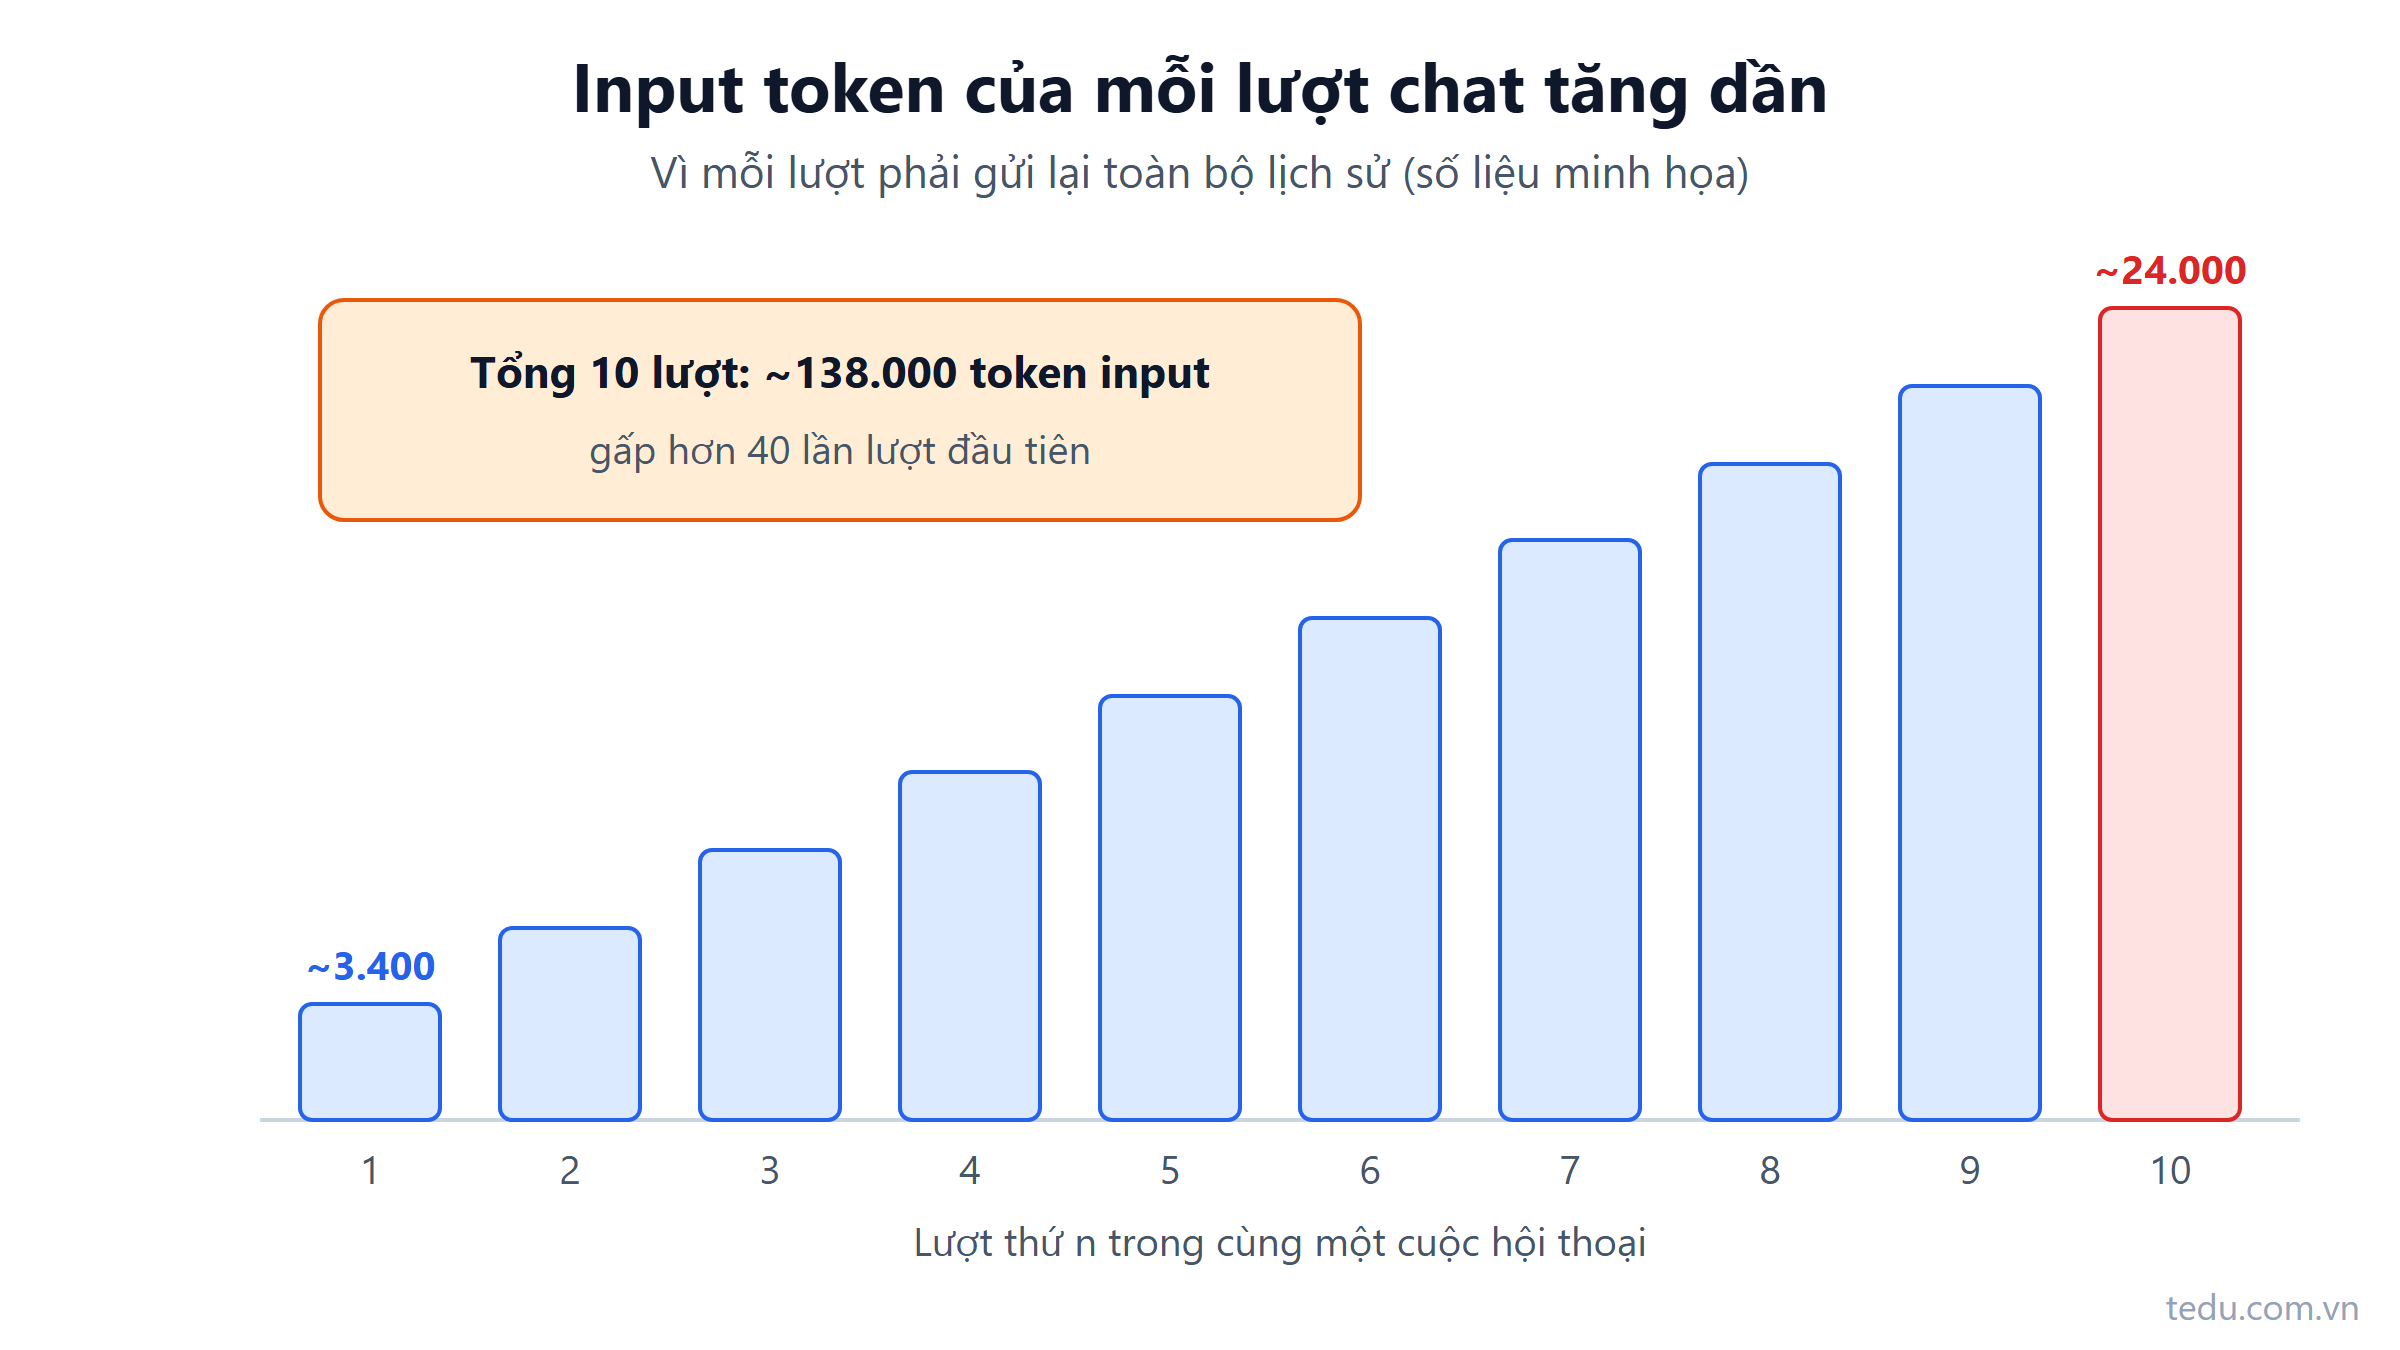
Chi phí LLM theo token: vì sao input và output giá khác nhau
Chi phí LLM tính theo token, input và output giá khác nhau. Bài hướng dẫn tự tính chi phí một chatbot, chỉ ra các khoản ẩn và cách cắt giảm.
Đọc thêm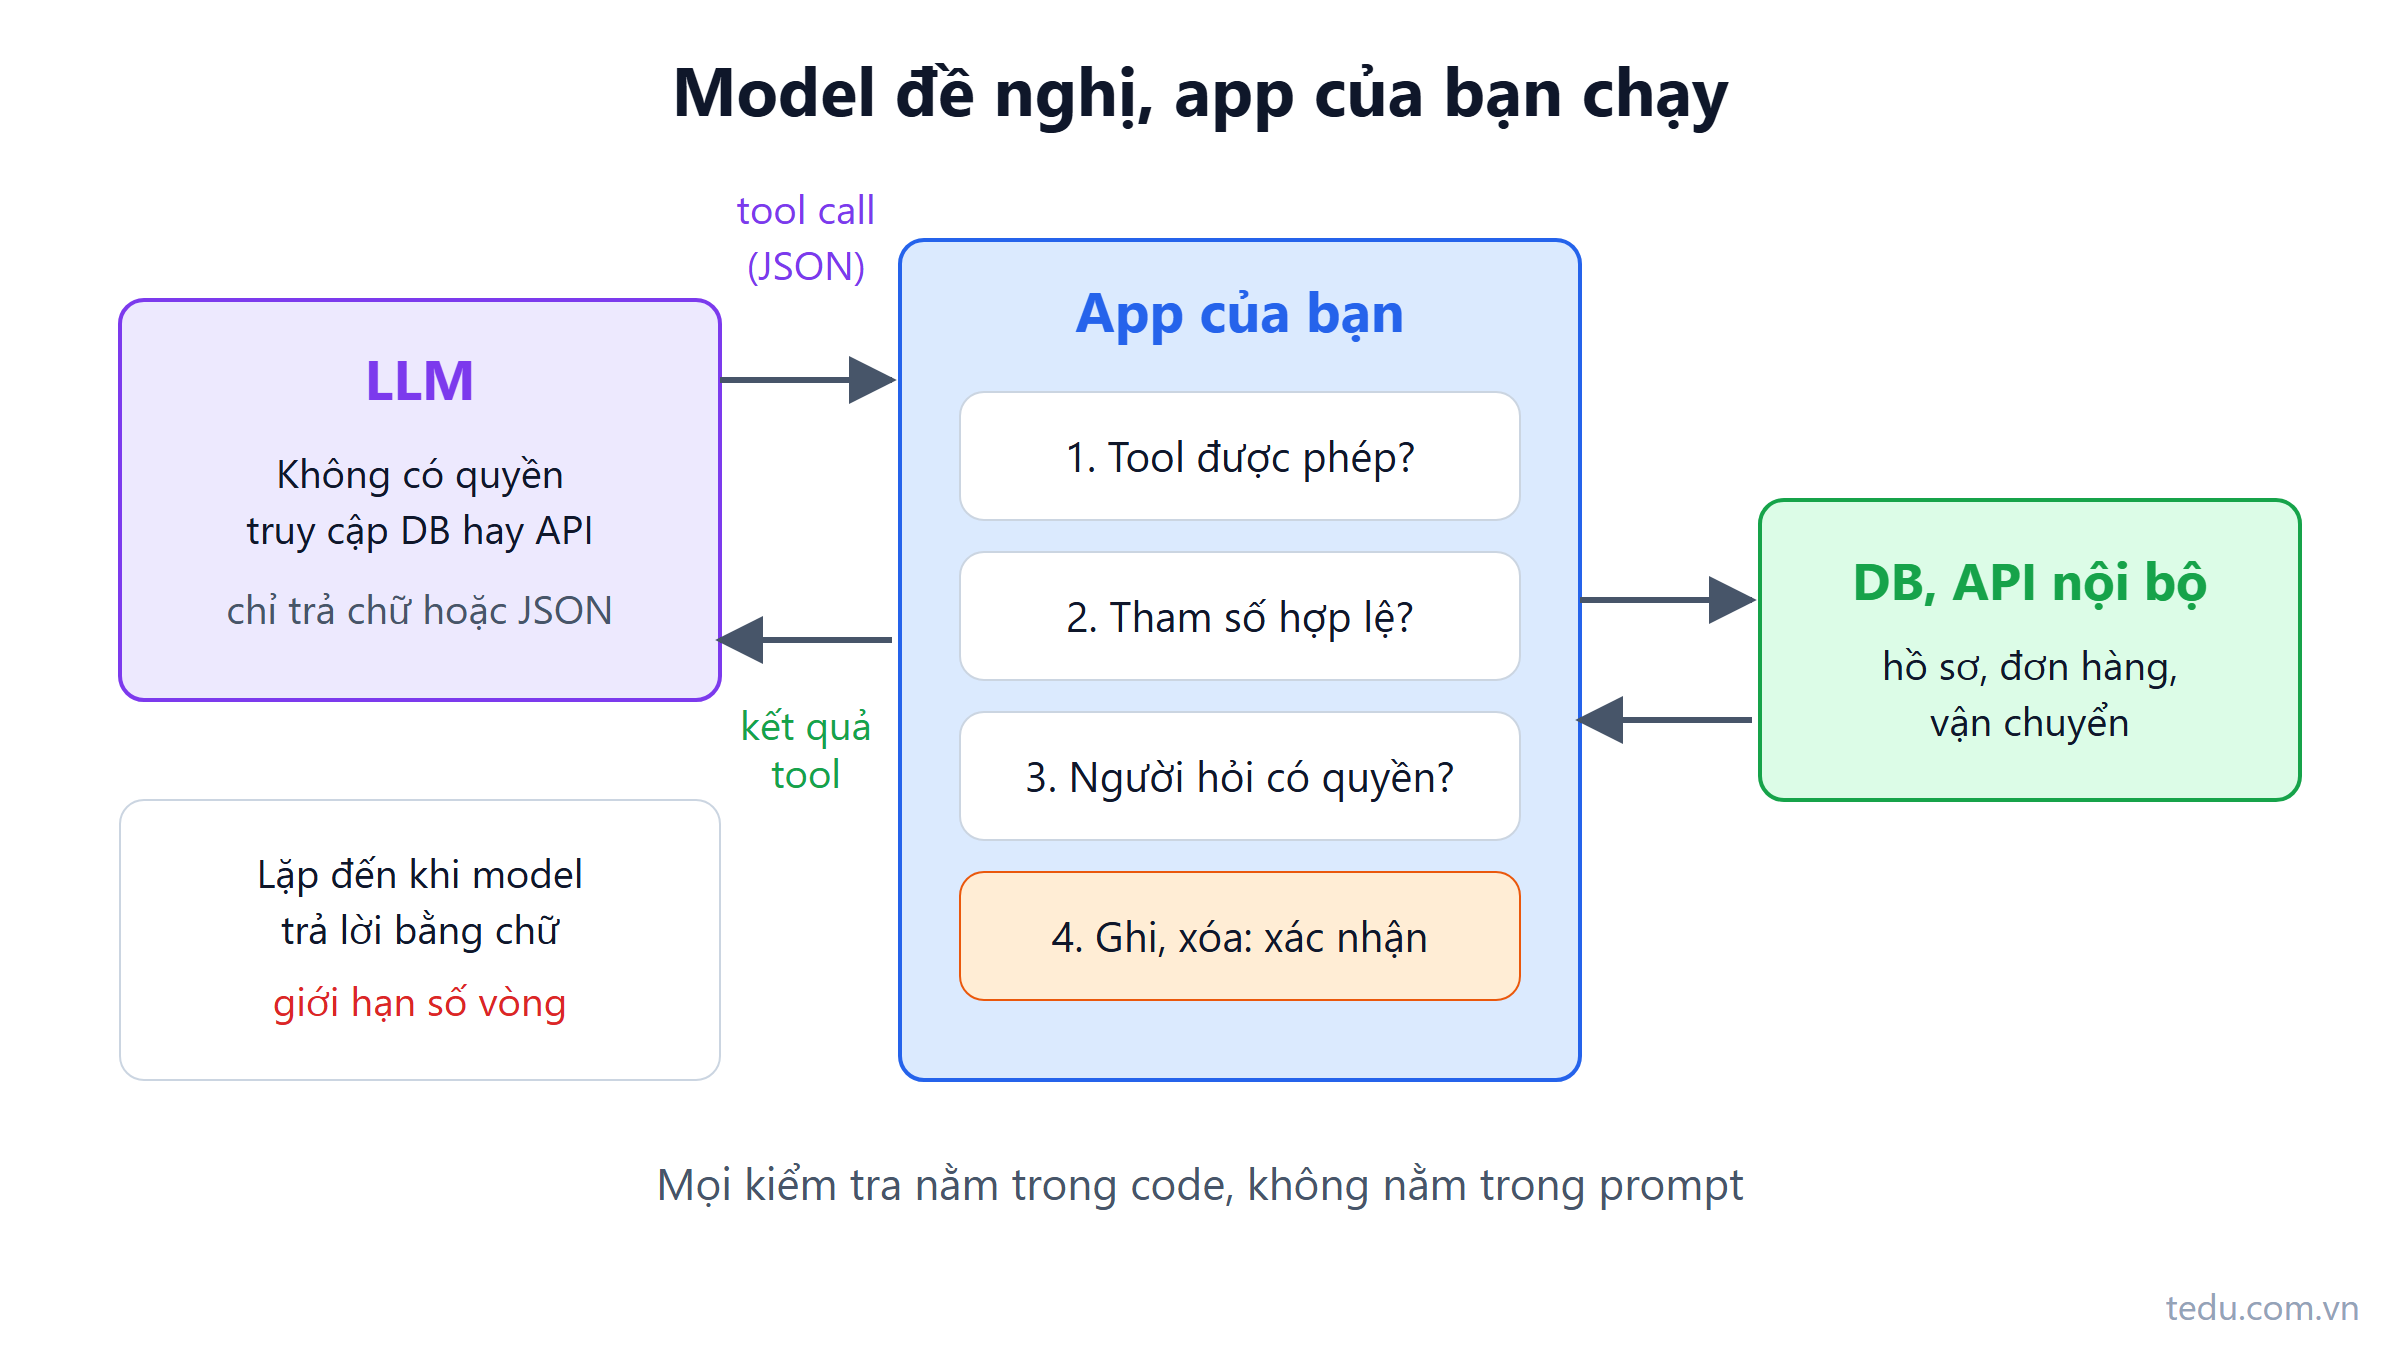
Function calling: model không tự chạy code
Function calling (tool calling) là model đề nghị gọi hàm bằng JSON, còn app của bạn validate, phân quyền và chạy. Ví dụ C# tra cứu hồ sơ, đơn hàng.
Đọc thêm
Streaming LLM: vì sao chữ hiện ra từng chút một
Streaming LLM gửi từng token về ngay khi model sinh ra, nên người dùng thấy chữ sau 1 giây thay vì chờ 10 giây. Cơ chế SSE và code C# đầy đủ.
Đọc thêm
Structured output: bắt LLM trả JSON đúng schema
Structured output giúp LLM trả JSON đúng schema để code đọc được ngay. Bài so sánh 3 cách, kèm ví dụ C# bóc tách đơn hàng từ tin nhắn khách.
Đọc thêm
LLM là stateless: "memory" của chatbot thật ra là gửi lại lịch sử
LLM không nhớ gì giữa các request. Chatbot "nhớ" được là vì app gửi lại lịch sử hội thoại. Bài giải thích cơ chế, chi phí token và cách lưu hội thoại đúng trong backend.
Đọc thêm
Cấu trúc request gọi LLM API: system, user, assistant gồm những gì
Một request gọi LLM API gồm model, tham số, danh sách message theo vai trò system, user, assistant và có thể có tools. Bài mổ xẻ từng phần kèm code C# gọi HTTP thô.
Đọc thêm
Pre-training, fine-tuning, RLHF: LLM được "dạy" thế nào
LLM đi qua ba giai đoạn huấn luyện: pre-training, fine-tuning theo chỉ dẫn và RLHF. Hiểu từng bước để biết khi nào cần fine-tune, khi nào chỉ cần RAG hoặc prompt.
Đọc thêm
Hallucination là gì? Vì sao model "bịa" và cách hạn chế
Hallucination là khi LLM trả lời trôi chảy nhưng sai sự thật. Bài giải thích vì sao về bản chất model luôn có thể bịa, các dạng hay gặp và cách chặn bằng thiết kế hệ thống.
Đọc thêm
Temperature và top-p là gì? Chỉnh độ sáng tạo của LLM đúng cách
Temperature và top-p quyết định model chọn token tiếp theo an toàn hay phiêu lưu. Bài giải thích cơ chế bằng số cụ thể, code C# mô phỏng và cách chọn theo từng tác vụ.
Đọc thêm