

LLM là stateless: "memory" của chatbot thật ra là gửi lại lịch sử
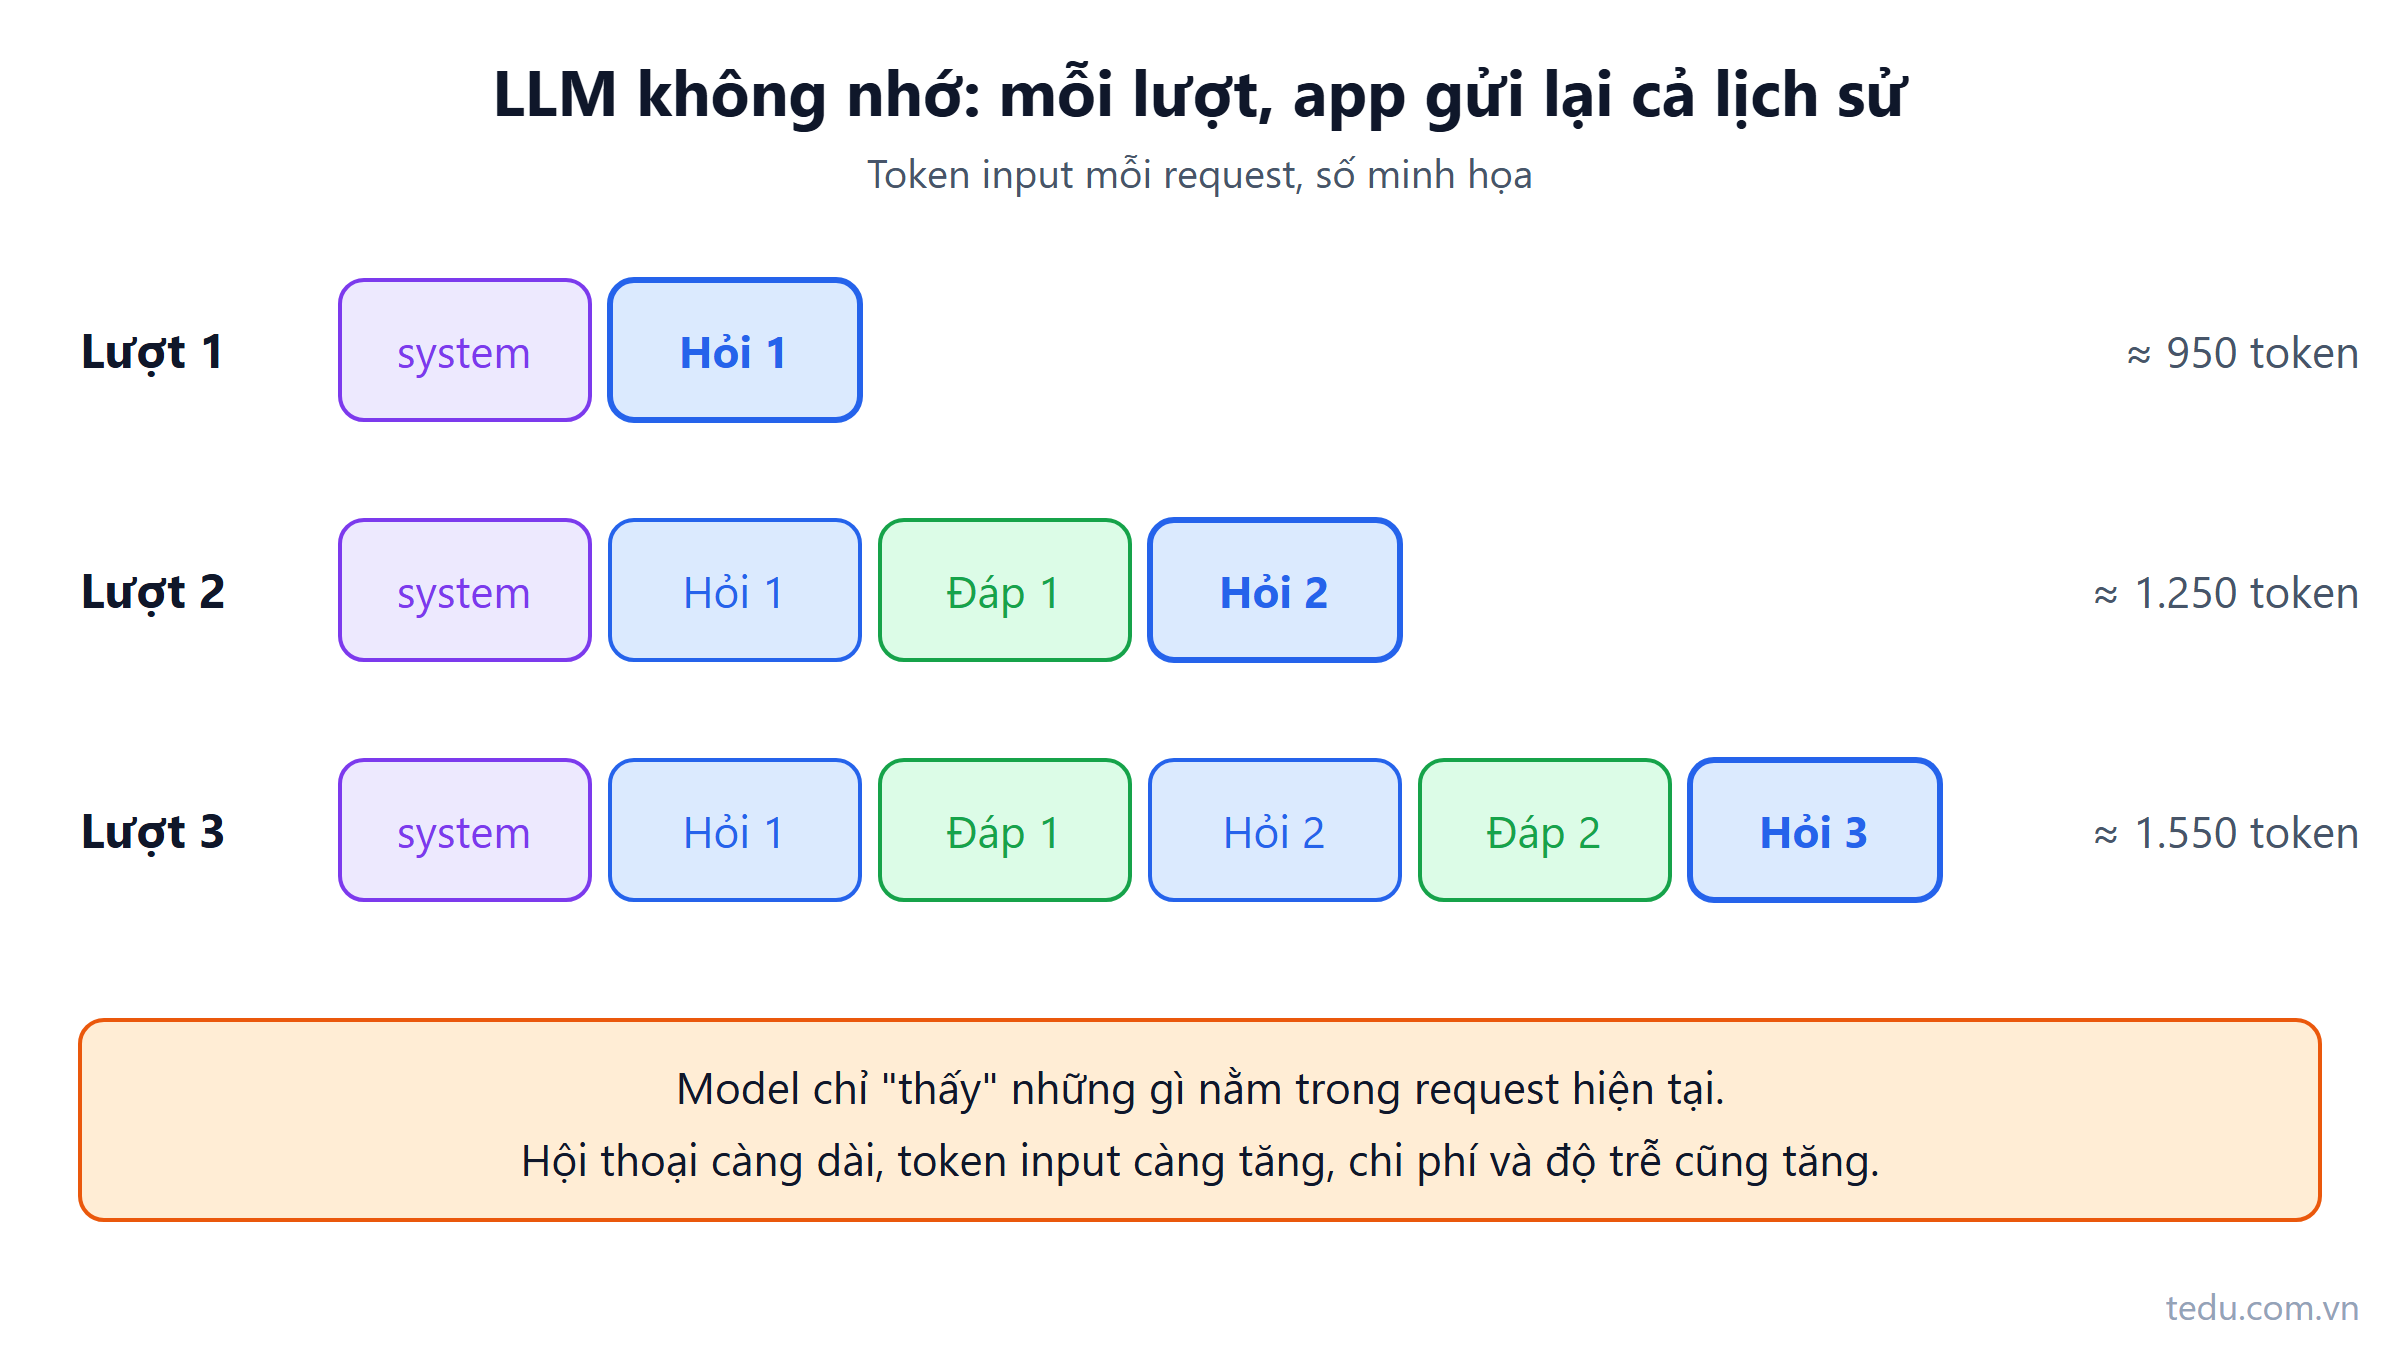
Bạn viết thử chatbot đầu tiên. Request thứ nhất gửi: "Mình tên Minh, làm kế toán ở chi nhánh Đà Nẵng." Model trả lời rất lịch sự: "Chào anh Minh, rất vui được hỗ trợ anh." Request thứ hai gửi: "Mình làm ở chi nhánh nào nhỉ?". Model đáp: "Xin lỗi, tôi không có thông tin về chi nhánh nơi bạn làm việc."
Vài giây trước nó vừa chào anh Minh, giờ đã quên sạch. Code không lỗi, API không lỗi. Đơn giản là LLM là stateless: model không nhớ gì giữa các request. Thứ mà ứng dụng chat gọi là "memory" thật ra là app gửi lại lịch sử hội thoại ở mỗi lượt. Bài này giải thích cơ chế đó, cái giá của nó tính bằng token, và cách một dev backend nên thiết kế phần lưu hội thoại cho chatbot chạy production.
LLM là stateless, giống hệt HTTP
Dev web đã quen với khái niệm này từ HTTP: mỗi request độc lập, server không tự biết request này đến từ cùng người với request trước. Muốn "nhớ" người dùng, ta dùng cookie, session, token, và lưu trạng thái ở Redis hoặc database.
LLM cũng vậy, thậm chí triệt để hơn:
Trọng số của model không thay đổi khi bạn chat. Không có gì được "ghi" vào model sau mỗi câu trả lời.
Mỗi request được xử lý như một bài toán mới hoàn toàn: đọc toàn bộ input, sinh output, rồi quên.
Thứ duy nhất model "biết" về cuộc trò chuyện là những gì nằm trong context của request hiện tại (xem bài context window).
| Ứng dụng web | Chatbot dùng LLM | |
|---|---|---|
| Giao thức | Stateless | Stateless |
| Ai giữ trạng thái | Server lưu session, DB | App của bạn lưu lịch sử hội thoại |
| Gửi kèm mỗi request | Cookie hoặc token định danh | Toàn bộ phần hội thoại cần nhớ |
| Chi phí khi trạng thái lớn | Gần như không đổi theo request | Tăng theo độ dài lịch sử, vì tính tiền theo token |
Dòng cuối là điểm khác biệt lớn. Với web, session to cỡ nào thì client vẫn chỉ gửi một cookie nhỏ. Với LLM, "session" phải được gửi nguyên văn vào model ở mọi lượt.
"Memory" thật ra là gửi lại lịch sử
Để chatbot trả lời đúng câu "Mình làm ở chi nhánh nào nhỉ?", request thứ hai phải chứa cả lượt đầu:
{
  "messages": [
    { "role": "system", "content": "Bạn là trợ lý nội bộ phòng kế toán..." },
    { "role": "user", "content": "Mình tên Minh, làm kế toán ở chi nhánh Đà Nẵng." },
    { "role": "assistant", "content": "Chào anh Minh, rất vui được hỗ trợ anh." },
    { "role": "user", "content": "Mình làm ở chi nhánh nào nhỉ?" }
  ]
}
Model đọc lại toàn bộ, thấy "chi nhánh Đà Nẵng" ở message thứ hai, và trả lời đúng. Nó không nhớ, nó đọc lại. Giống một nhân viên trực tổng đài mỗi lần nghe máy đều được đưa cho bản ghi đầy đủ cuộc gọi trước đó, đọc lướt trong một giây rồi trả lời như thể đã nhớ từ đầu.
Như bài cấu trúc request LLM API đã nói, các message assistant trong request là do app của bạn gửi lại. Nếu bạn sửa nội dung một câu trả lời cũ trước khi gửi lại, model sẽ tin đó là điều nó đã nói. Đây vừa là công cụ (dùng để làm mẫu, sửa lỗi), vừa là rủi ro (lưu sai lịch sử thì model "nhớ sai").
Cái giá của trí nhớ: token tăng theo từng lượt
Vì mỗi lượt gửi lại toàn bộ lịch sử, số token input tăng dần theo độ dài cuộc trò chuyện. Giả sử system prompt khoảng 800 token, mỗi câu hỏi khoảng 150 token, mỗi lượt hỏi và đáp làm lịch sử dài thêm khoảng 300 token (số minh họa, hãy đo trên dữ liệu thật của bạn):
| Lượt thứ | Token input của request đó |
|---|---|
| 1 | khoảng 950 |
| 5 | khoảng 2.150 |
| 10 | khoảng 3.650 |
| 20 | khoảng 6.650 |
Cộng dồn cả 20 lượt, cuộc trò chuyện tiêu khoảng 76.000 token input. Nếu mỗi lượt chỉ gửi system prompt và câu hỏi mới (không nhớ gì), con số chỉ khoảng 19.000. Trí nhớ làm chi phí input tăng khoảng 4 lần, và tỷ lệ này còn tăng nữa khi cuộc trò chuyện dài hơn, vì tổng token tăng theo bình phương số lượt.
Không chỉ tiền: input dài hơn thì thời gian chờ chữ đầu tiên cũng dài hơn. Kỹ thuật prompt caching giúp giảm cả hai khi phần đầu request (system prompt, lịch sử cũ) lặp lại giữa các lượt, nhưng nó không thay được việc thiết kế lịch sử gọn gàng.
Thiết kế lưu hội thoại trong backend
Vì app giữ trạng thái, phần này hoàn toàn là việc của dev backend. Một thiết kế tối thiểu trên PostgreSQL:
CREATE TABLE conversations (
    id          uuid PRIMARY KEY,
    user_id     bigint NOT NULL,
    summary     text,
    created_at  timestamptz NOT NULL DEFAULT now()
);

CREATE TABLE conversation_messages (
    id               bigserial PRIMARY KEY,
    conversation_id  uuid NOT NULL REFERENCES conversations(id),
    role             text NOT NULL,
    content          text NOT NULL,
    input_tokens     int,
    output_tokens    int,
    created_at       timestamptz NOT NULL DEFAULT now()
);

CREATE INDEX ix_conversation_messages_conv ON conversation_messages (conversation_id, id);
Cột summary dùng cho kỹ thuật tóm tắt ở phần sau. Cột token giúp bạn biết cuộc trò chuyện nào đang tốn tiền.
Phía service, mỗi lượt chat làm bốn việc: kiểm tra quyền, nạp lịch sử, gọi model, lưu cả câu hỏi lẫn câu trả lời. IConversationStore và ILlmClient là interface bạn tự định nghĩa (lớp bọc quanh repository và SDK của nhà cung cấp):
public sealed record ChatMessage(string Role, string Content);

public sealed class ChatService(IConversationStore store, ILlmClient llm)
{
    private const int MaxHistoryMessages = 20;
    private const string SystemPrompt = "Bạn là trợ lý nội bộ phòng kế toán...";

    public async Task<string> SendAsync(
        Guid conversationId, long userId, string userInput, CancellationToken ct)
    {
        var conversation = await store.GetAsync(conversationId, ct)
            ?? throw new KeyNotFoundException("Không tìm thấy hội thoại");

        // Hội thoại là dữ liệu của người dùng: kiểm tra quyền như mọi tài nguyên khác
        if (conversation.UserId != userId)
            throw new UnauthorizedAccessException();

        var system = string.IsNullOrEmpty(conversation.Summary)
            ? SystemPrompt
            : $"{SystemPrompt}\n\nTóm tắt phần trước của cuộc trò chuyện:\n{conversation.Summary}";

        // Lấy N message gần nhất, sắp theo thứ tự thời gian
        var history = await store.GetRecentMessagesAsync(conversationId, MaxHistoryMessages, ct);

        List<ChatMessage> messages = [new("system", system), .. history, new("user", userInput)];

        var reply = await llm.CompleteAsync(messages, ct);

        await store.AppendAsync(conversationId,
            [new("user", userInput), new("assistant", reply.Text)], ct);

        return reply.Text;
    }
}
Vài điểm thiết kế đáng chú ý:
Lưu ở database, không lưu trong bộ nhớ process. Một
static Dictionarychứa lịch sử chạy ổn trên máy dev, nhưng mất sạch khi restart và sai hoàn toàn khi có hai instance sau load balancer.Kiểm tra chủ sở hữu hội thoại. Nếu API nhận
conversationIdtừ client mà không kiểm tra, ai đoán được id là đọc được lịch sử chat của người khác, kèm mọi thông tin họ đã kể cho chatbot.Lưu đúng những gì đã gửi. Câu trả lời lưu vào DB phải là câu model đã trả về, không phải bản đã cắt gọt cho UI. Nếu có lượt gọi tool, lưu cả yêu cầu gọi tool và kết quả tool theo cặp.
Ghi nhận token. Lưu usage của mỗi lượt để biết hội thoại nào phình to bất thường.
Giữ trí nhớ mà không phình chi phí
Không cuộc trò chuyện nào nên gửi lại toàn bộ lịch sử mãi mãi. Các chiến lược thường dùng:
| Chiến lược | Cách làm | Ví dụ phù hợp |
|---|---|---|
| Cửa sổ trượt | Chỉ gửi N message gần nhất | CSKH hỏi đáp nhanh về đơn hàng |
| Tóm tắt dần | Khi vượt ngưỡng, gom phần cũ thành đoạn tóm tắt lưu ở summary | Trợ lý kế toán hướng dẫn quyết toán nhiều bước |
| Trích thông tin cố định | Lưu "chi nhánh Đà Nẵng, phòng kế toán" vào hồ sơ người dùng, nạp lại mỗi phiên | Thông tin cần nhớ qua nhiều cuộc trò chuyện |
| Tìm lại hội thoại cũ | Đánh index hội thoại cũ, chỉ lấy đoạn liên quan khi cần | "Tháng trước mình hỏi về hóa đơn gì ấy nhỉ?" |
Với kỹ thuật tóm tắt, prompt tóm tắt nên yêu cầu giữ lại các dữ kiện cụ thể, không chỉ ý chung:
Tóm tắt đoạn hội thoại dưới đây trong tối đa 150 từ.
Giữ nguyên các dữ kiện cụ thể: tên, mã chứng từ, số tiền, ngày tháng,
các quyết định người dùng đã chốt và các câu hỏi còn chưa được trả lời.
Không thêm thông tin không có trong hội thoại.
Một bản tóm tắt viết kiểu "người dùng hỏi về hóa đơn" là vô dụng. Bản tốt phải là "anh Minh, chi nhánh Đà Nẵng, hỏi cách xử lý hóa đơn HĐ-0815 lập sai ngày, đã chốt hướng lập hóa đơn điều chỉnh, còn chờ hỏi về thời hạn kê khai".
Hai chiến lược cuối là nền móng của memory dài hạn cho agent, sẽ được nói kỹ ở bài memory của AI agent.
Còn tính năng lưu hội thoại phía nhà cung cấp?
Một số nhà cung cấp có API tự lưu hội thoại phía server: bạn chỉ gửi câu mới kèm id của lượt trước. Tiện, nhưng hiểu đúng bản chất: bên dưới, model vẫn phải đọc lại phần lịch sử đó, và phần token này thường vẫn được tính vào input (có thể được giảm giá nhờ caching, tùy chính sách từng nơi). Ngoài ra dữ liệu hội thoại nằm ở hệ thống của bên thứ ba, bạn khó tự cắt gọt, tóm tắt hay kiểm tra. Kiểm tra docs và chính sách lưu trữ dữ liệu trước khi dùng.
Tính năng "ghi nhớ" trong các ứng dụng chat phổ biến cũng theo nguyên lý tương tự: ứng dụng lưu lại ghi chú về người dùng rồi đưa vào context ở các cuộc trò chuyện sau. Không có phép màu nào bên trong model.
Lỗi hay gặp và checklist
Những lỗi thường gặp:
Lưu lịch sử trong bộ nhớ process, mất khi deploy lại hoặc khi scale nhiều instance.
Không kiểm tra người gọi có phải chủ hội thoại.
Gửi toàn bộ lịch sử không giới hạn, chi phí và độ trễ tăng dần theo ngày.
Cắt lịch sử làm tách rời yêu cầu gọi tool và kết quả tool, khiến API báo lỗi.
Tóm tắt quá chung chung, làm mất dữ kiện quan trọng.
Lưu vĩnh viễn hội thoại chứa dữ liệu cá nhân mà không có chính sách xóa.
Checklist áp dụng:
Bảng
conversationsvàconversation_messagestrong DB, cóuser_idvà kiểm tra quyền.Giới hạn số message gửi lại; có chiến lược tóm tắt khi vượt ngưỡng.
Thông tin cần nhớ lâu dài được tách thành hồ sơ có cấu trúc.
Log token input theo lượt để phát hiện hội thoại phình to.
Có chính sách lưu trữ và xóa hội thoại, che dữ liệu nhạy cảm trước khi lưu nếu cần.
Tóm lại
LLM là stateless: model không nhớ gì giữa các request, trọng số không đổi khi bạn chat. "Memory" của chatbot là app lưu lịch sử và gửi lại ở mỗi lượt, giống session của ứng dụng web nhưng đắt hơn vì phải trả tiền cho từng token gửi lại. Việc của dev backend là lưu hội thoại đúng chỗ, kiểm tra quyền, và giữ lịch sử gọn bằng cửa sổ trượt, tóm tắt hoặc trích thông tin cố định.
Bài tiếp theo trong series: Structured output: bắt model trả JSON đúng schema, kỹ thuật bạn sẽ dùng ngay khi muốn lưu bản tóm tắt hay hồ sơ người dùng dưới dạng có cấu trúc.
Xem bản tóm tắt dưới một phút trên YouTube @teduco hoặc TikTok @teducolabs, và đọc thêm các bài khác trong chuyên mục AI cho Backend Developer.
Bài viết liên quan
Context engineering là gì, vì sao quan trọng hơn prompt
Context engineering là quyết định cái gì vào context window, cái gì phải ra, theo thứ tự nào. Câu prompt chỉ là một phần nhỏ của những gì model thấy.
Đọc thêm
Prompt caching là gì? Cắt chi phí và độ trễ cho LLM
Prompt caching cho phép nhà cung cấp LLM dùng lại phần đầu prompt đã xử lý, giảm chi phí và độ trễ. Bài giải thích cơ chế prefix và cách sắp prompt.
Đọc thêm
Chi phí LLM theo token: vì sao input và output giá khác nhau
Chi phí LLM tính theo token, input và output giá khác nhau. Bài hướng dẫn tự tính chi phí một chatbot, chỉ ra các khoản ẩn và cách cắt giảm.
Đọc thêm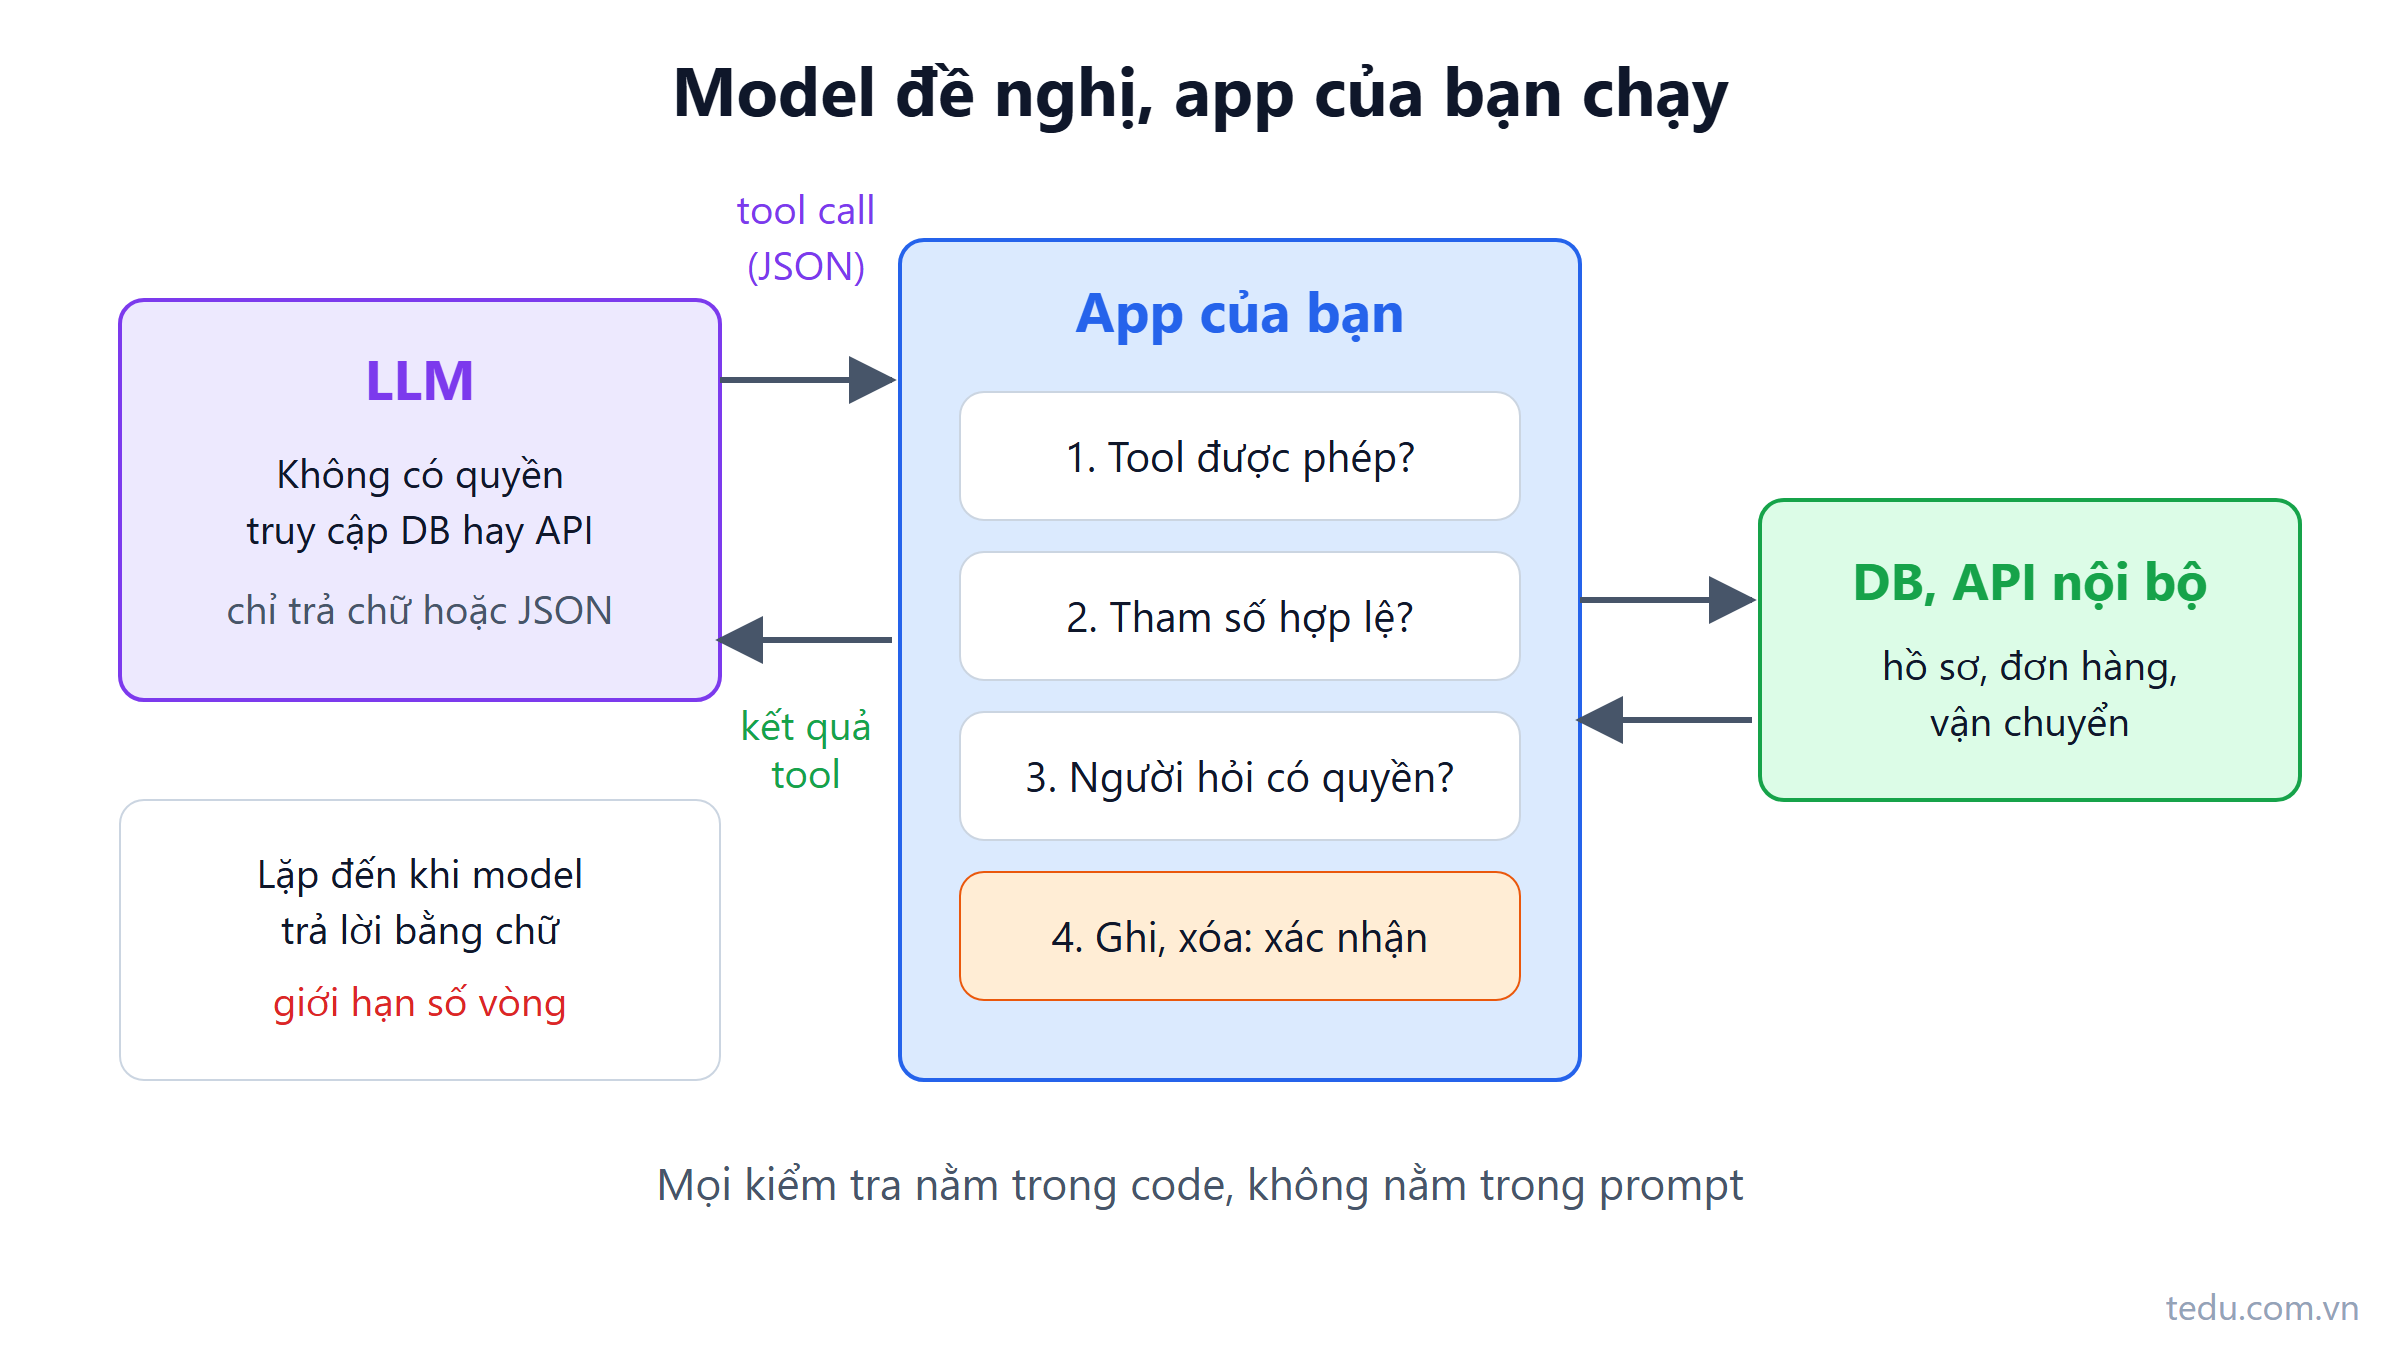
Function calling: model không tự chạy code
Function calling (tool calling) là model đề nghị gọi hàm bằng JSON, còn app của bạn validate, phân quyền và chạy. Ví dụ C# tra cứu hồ sơ, đơn hàng.
Đọc thêm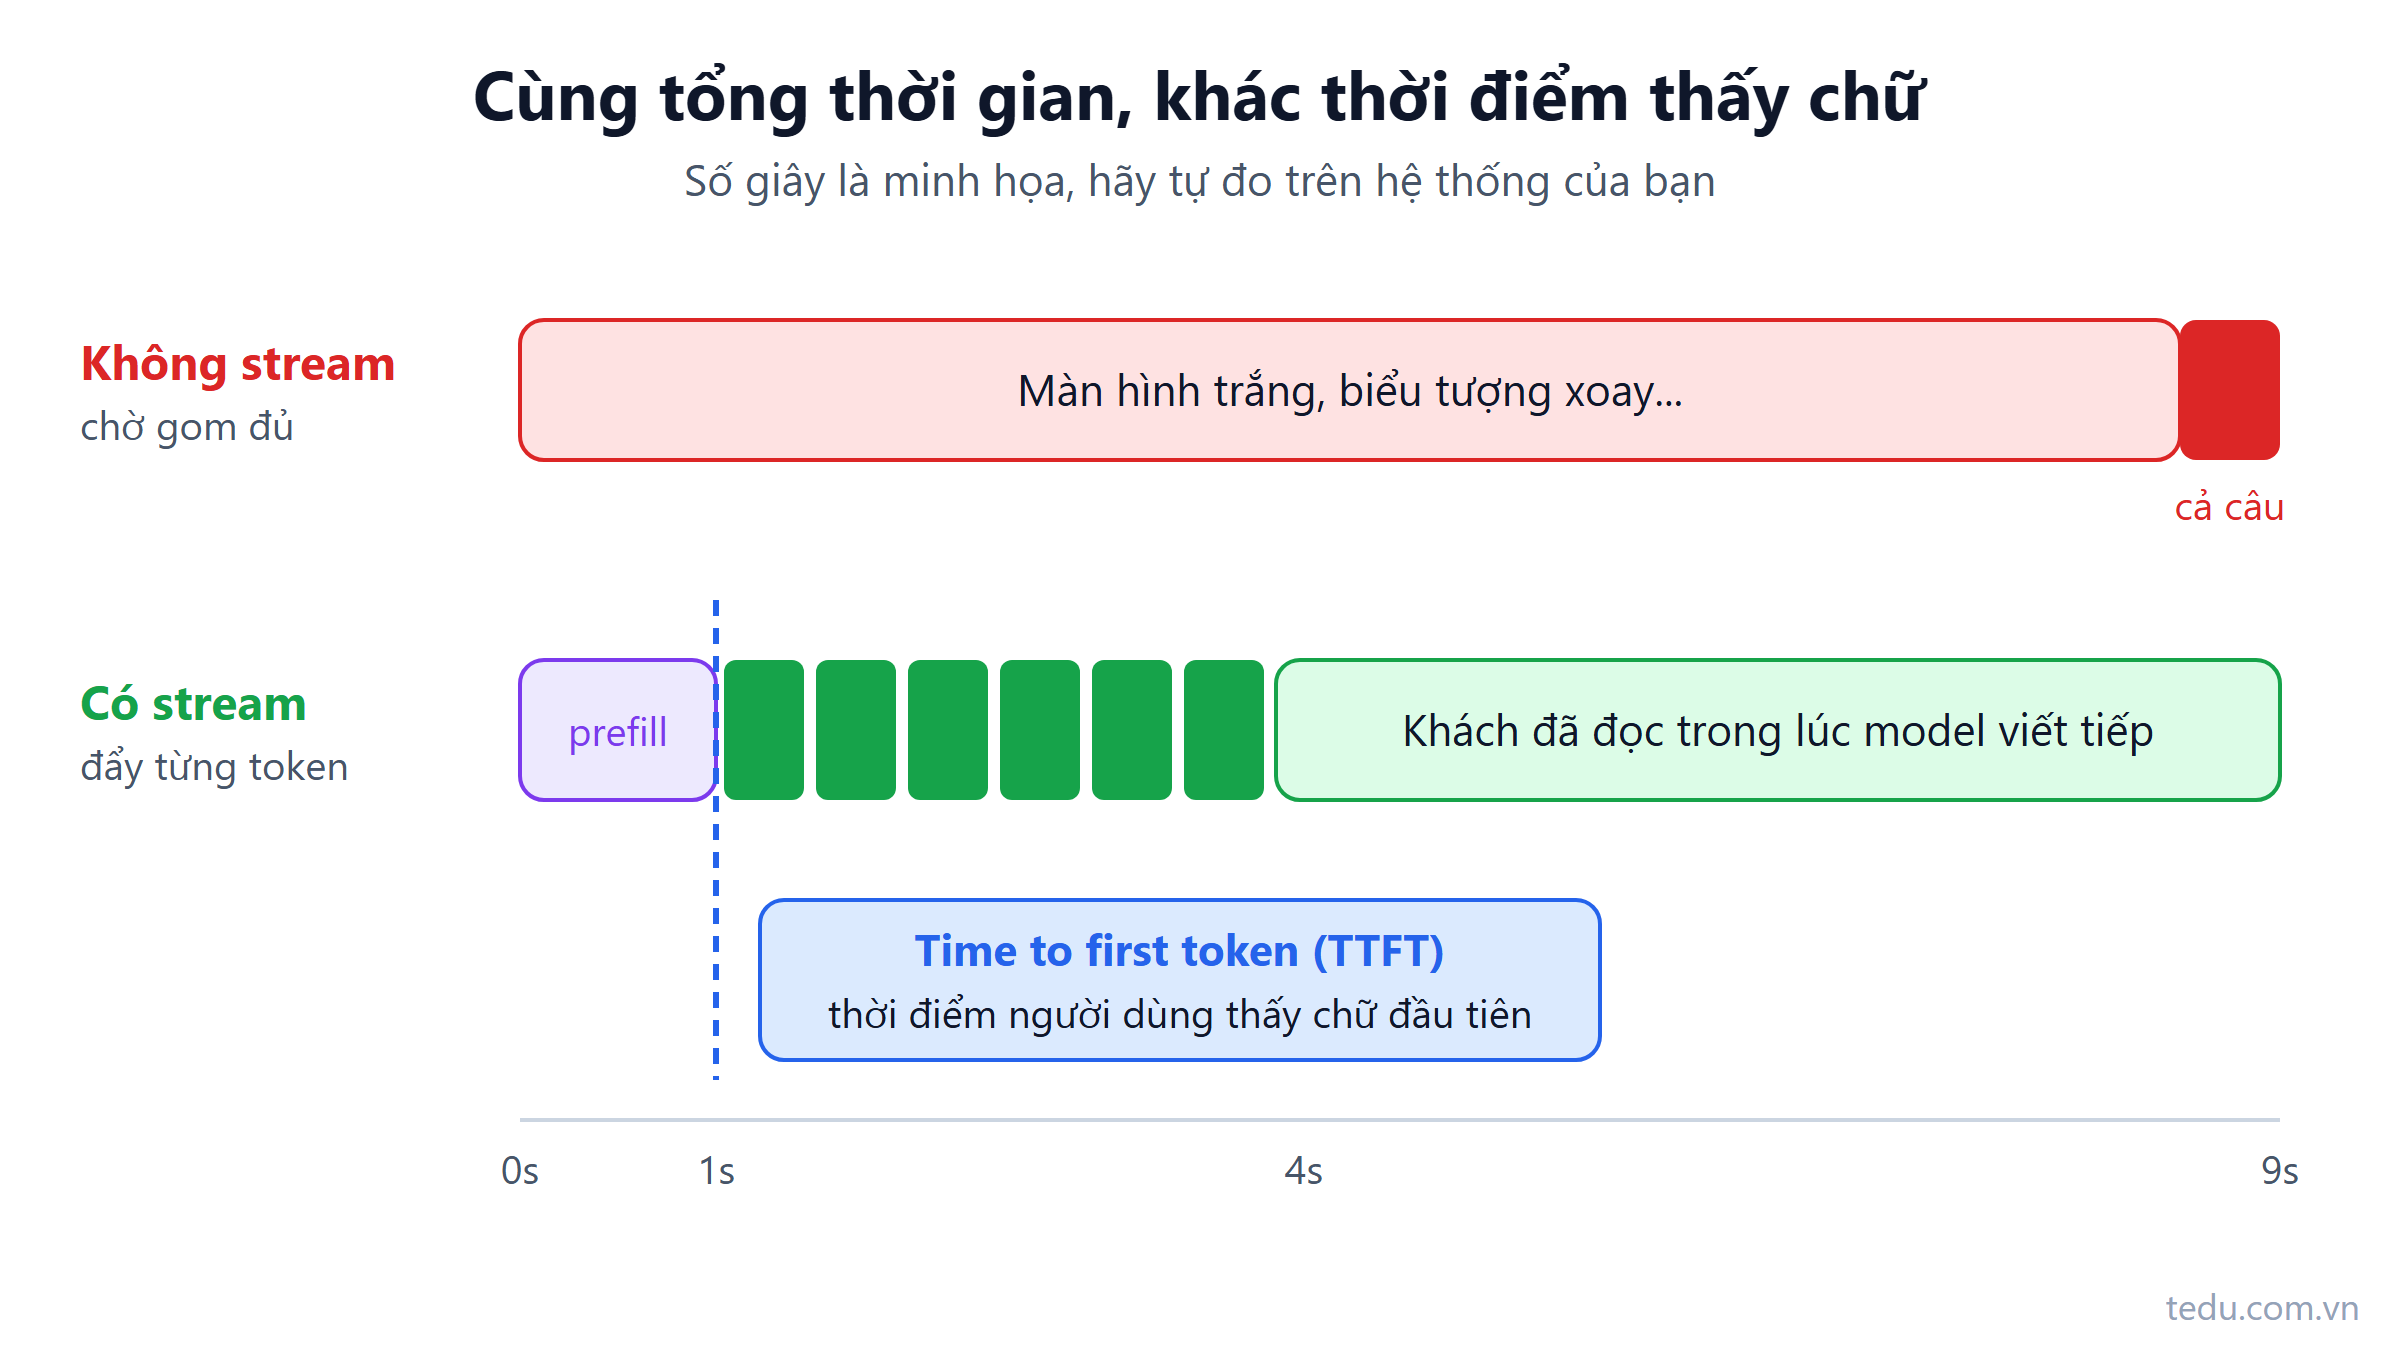
Streaming LLM: vì sao chữ hiện ra từng chút một
Streaming LLM gửi từng token về ngay khi model sinh ra, nên người dùng thấy chữ sau 1 giây thay vì chờ 10 giây. Cơ chế SSE và code C# đầy đủ.
Đọc thêm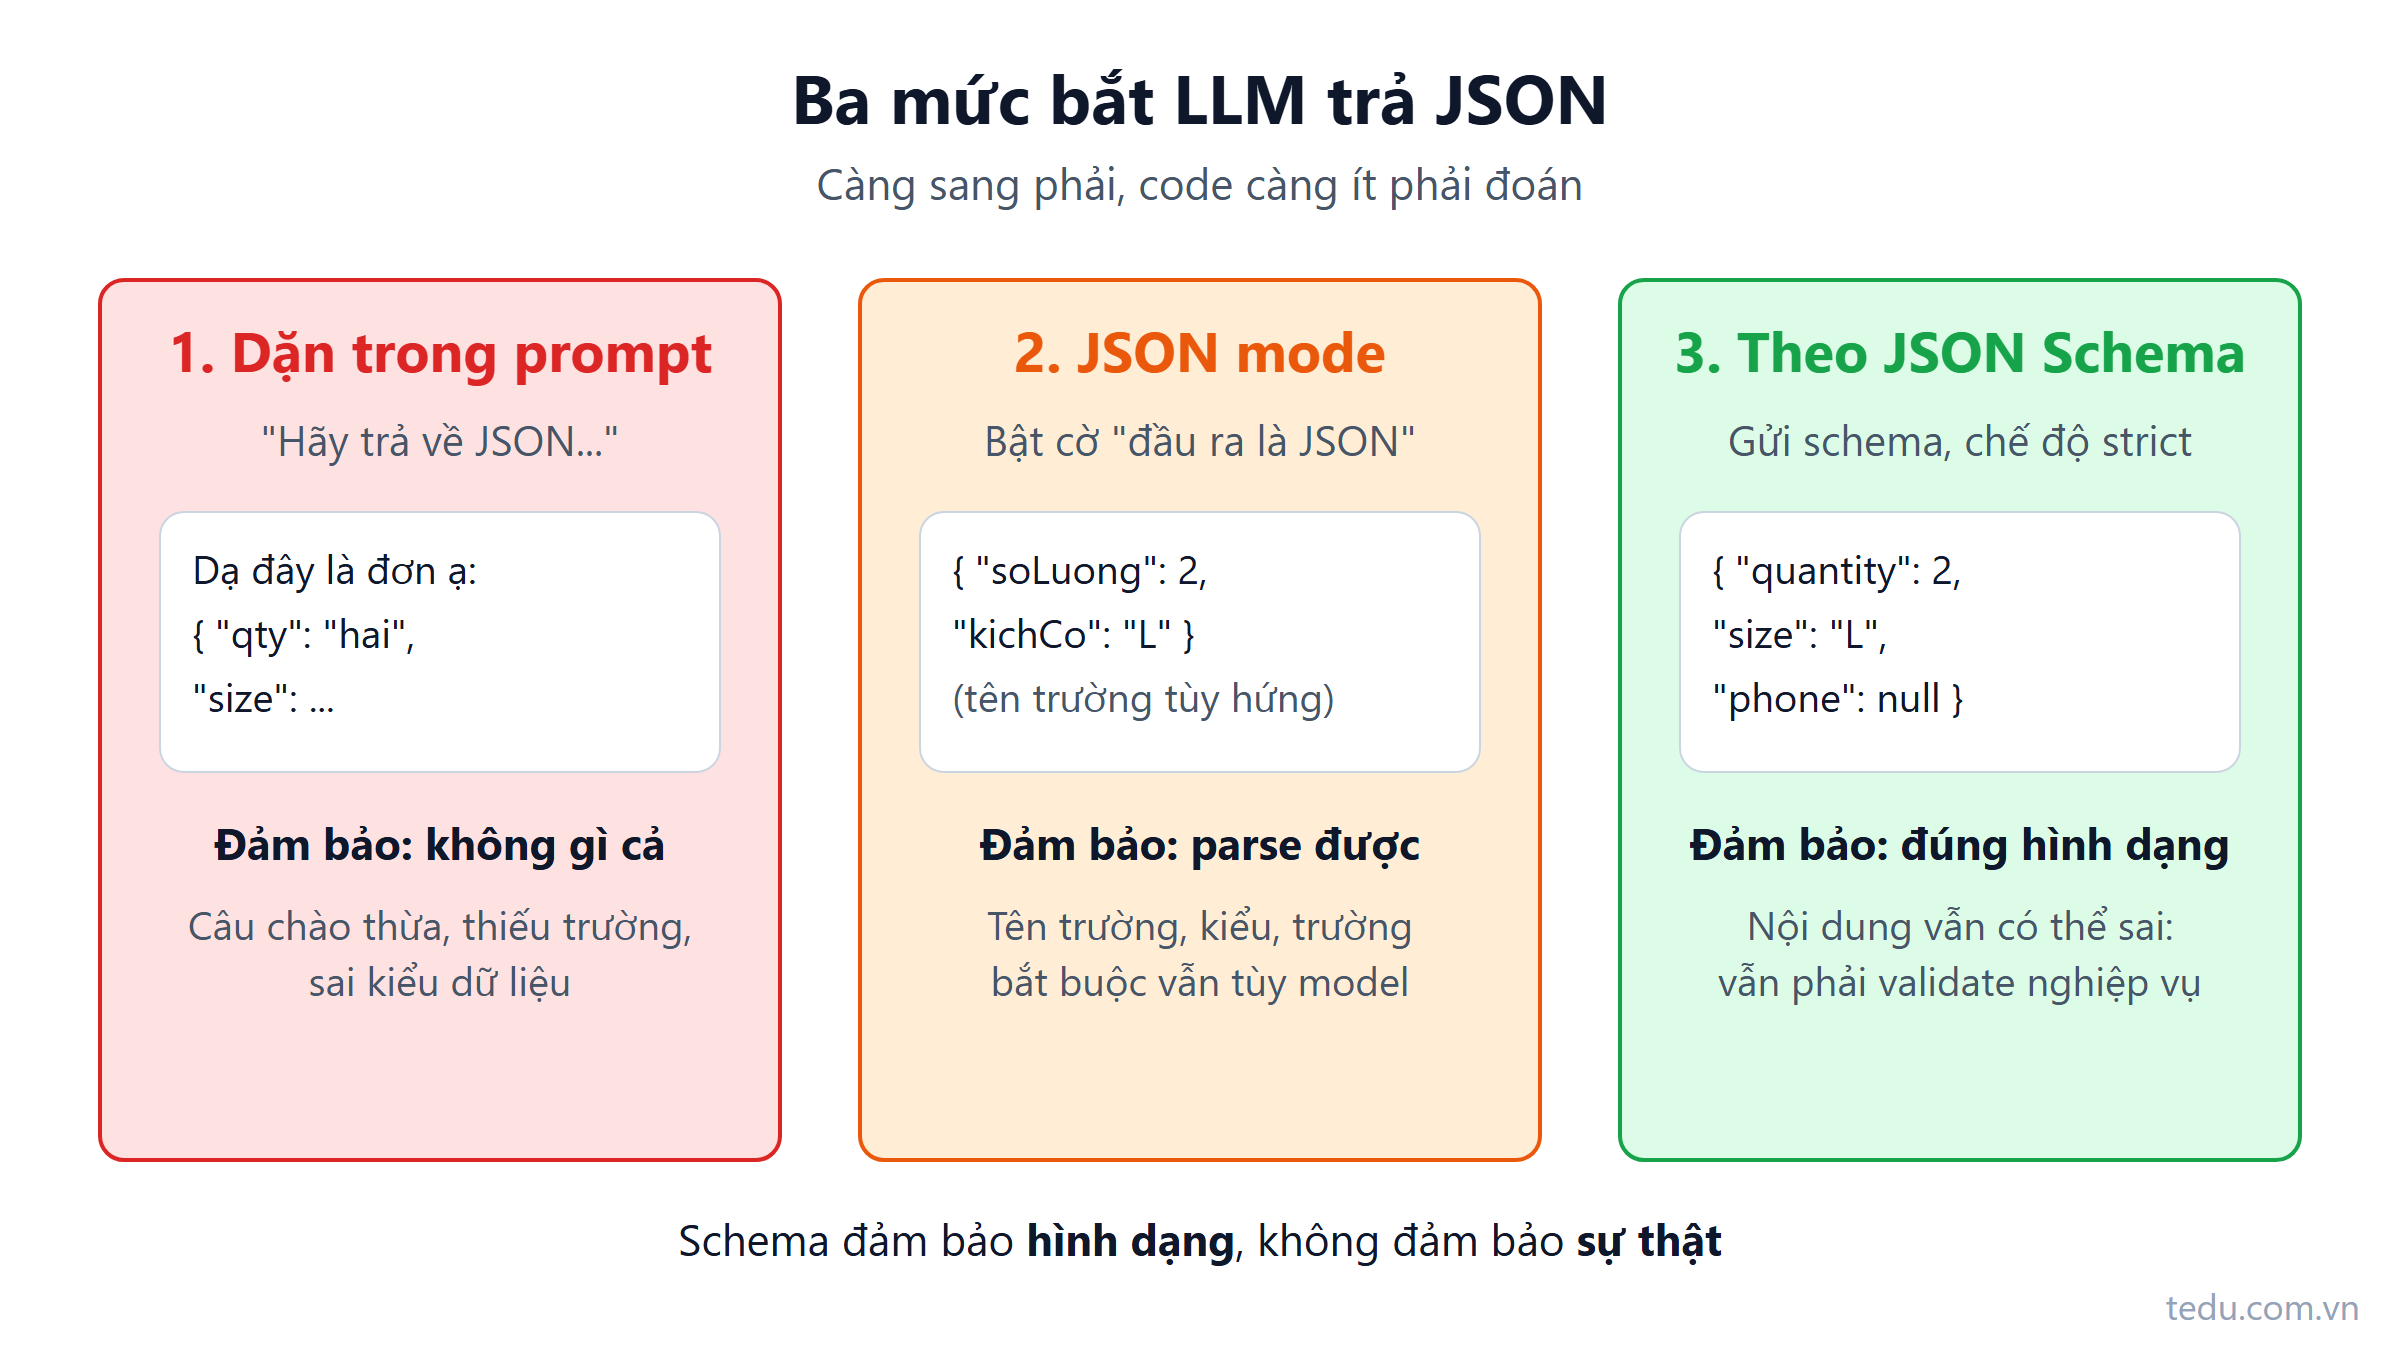
Structured output: bắt LLM trả JSON đúng schema
Structured output giúp LLM trả JSON đúng schema để code đọc được ngay. Bài so sánh 3 cách, kèm ví dụ C# bóc tách đơn hàng từ tin nhắn khách.
Đọc thêm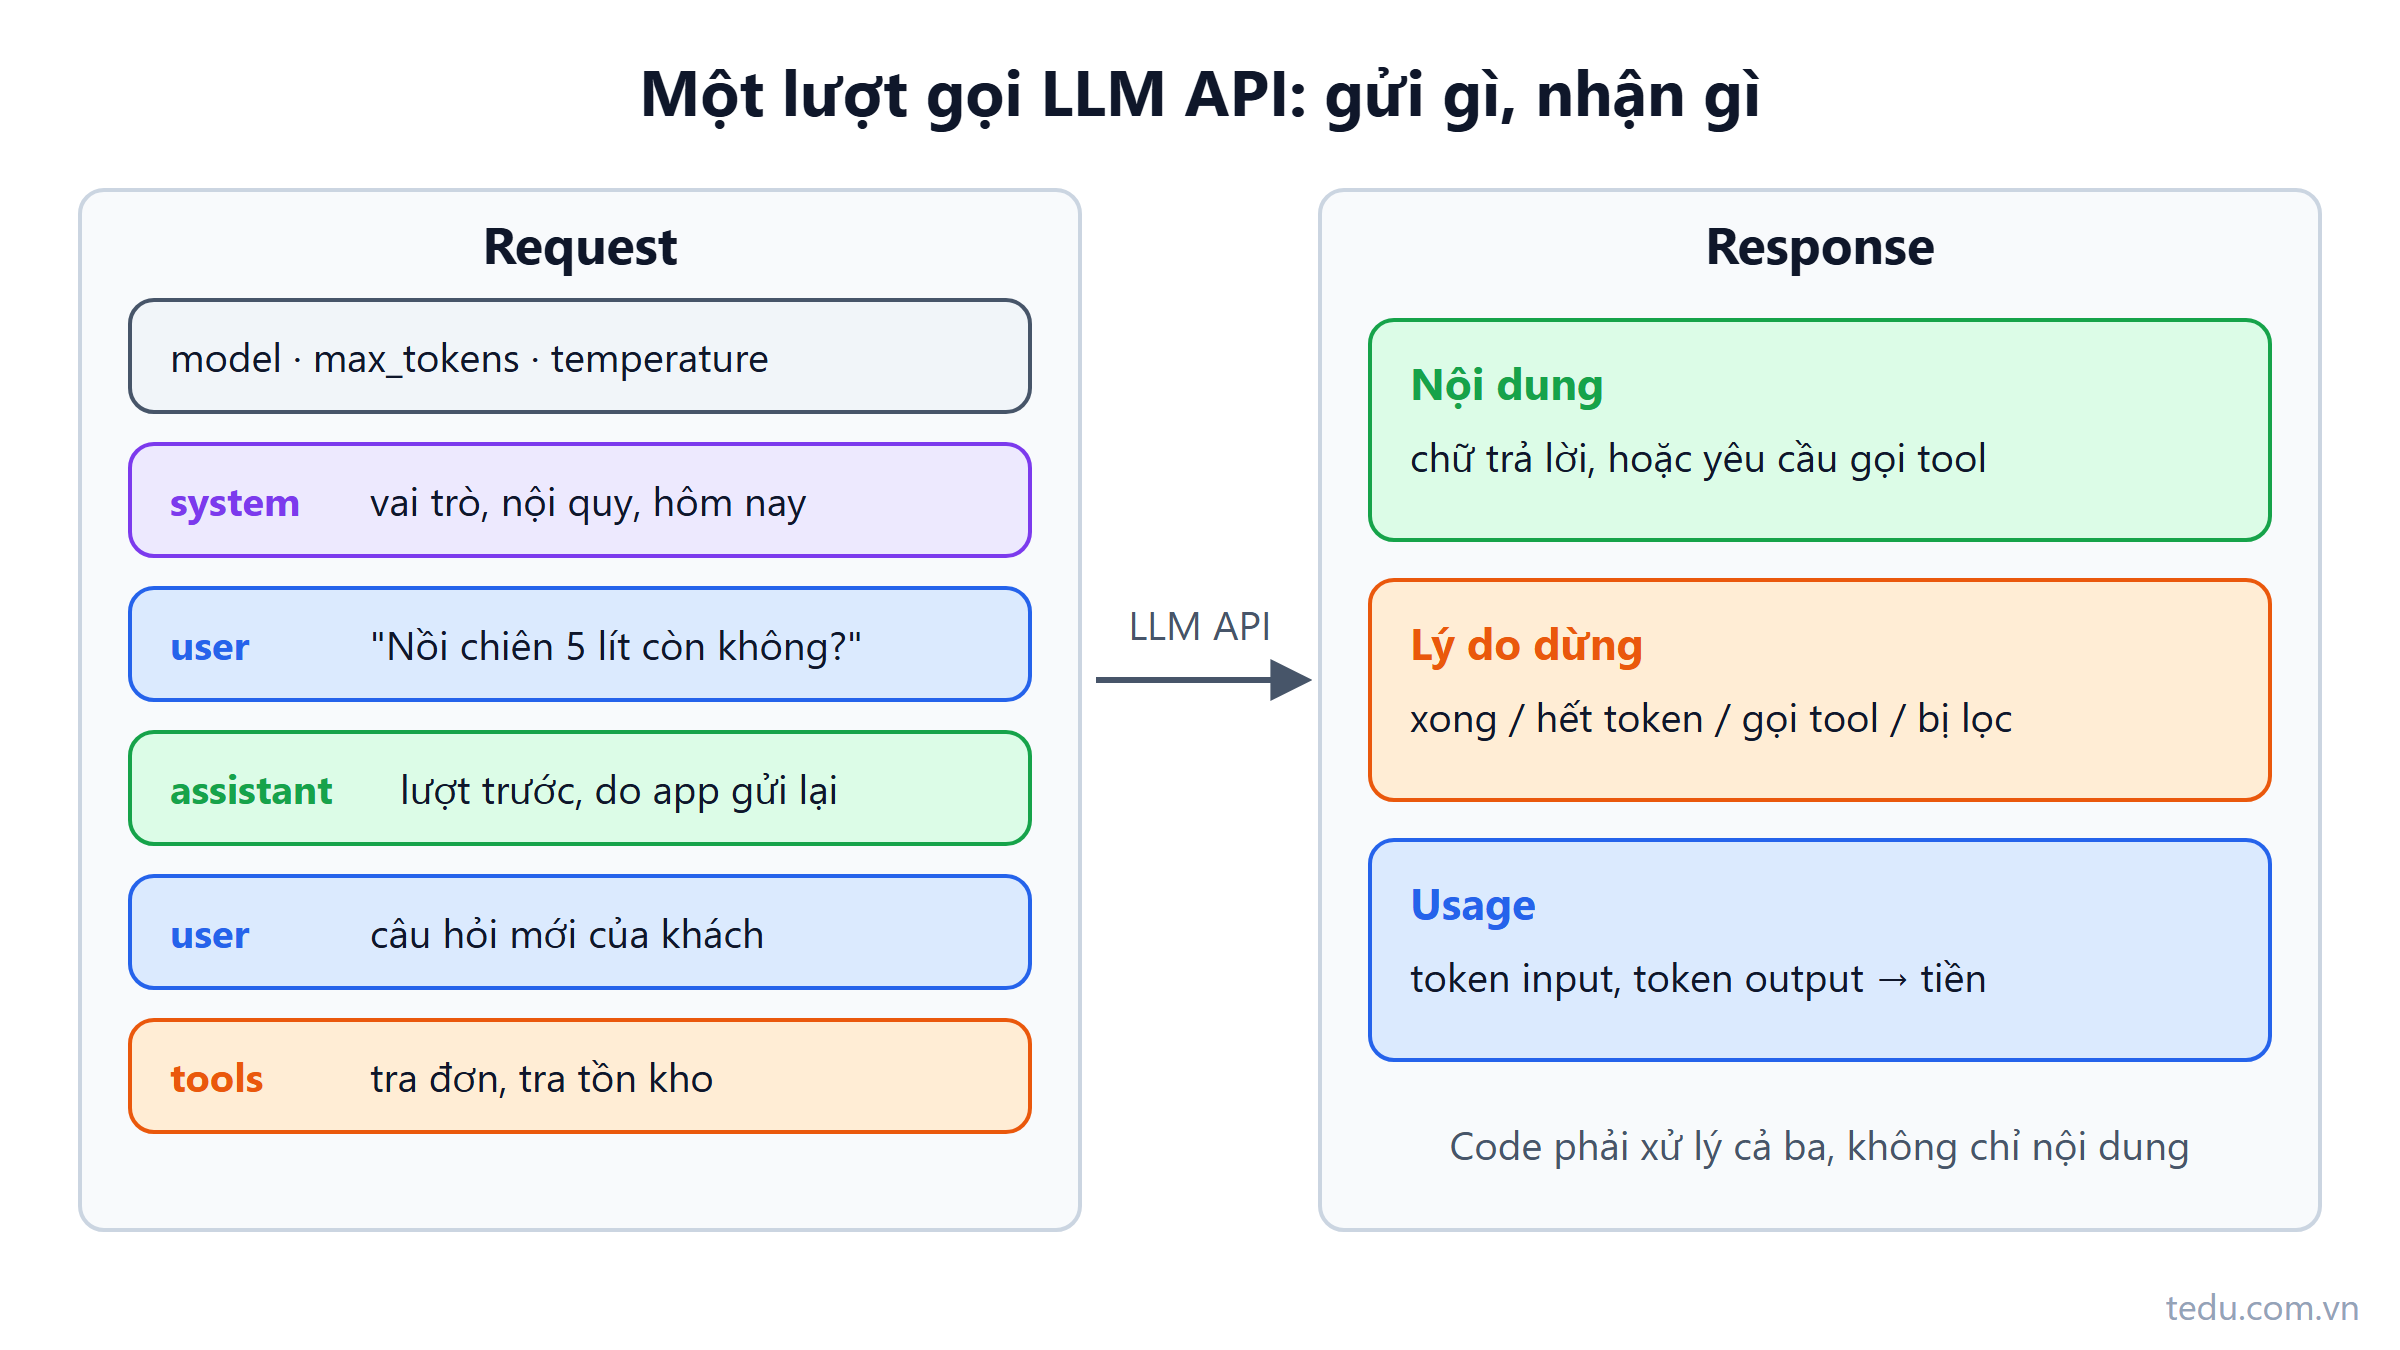
Cấu trúc request gọi LLM API: system, user, assistant gồm những gì
Một request gọi LLM API gồm model, tham số, danh sách message theo vai trò system, user, assistant và có thể có tools. Bài mổ xẻ từng phần kèm code C# gọi HTTP thô.
Đọc thêm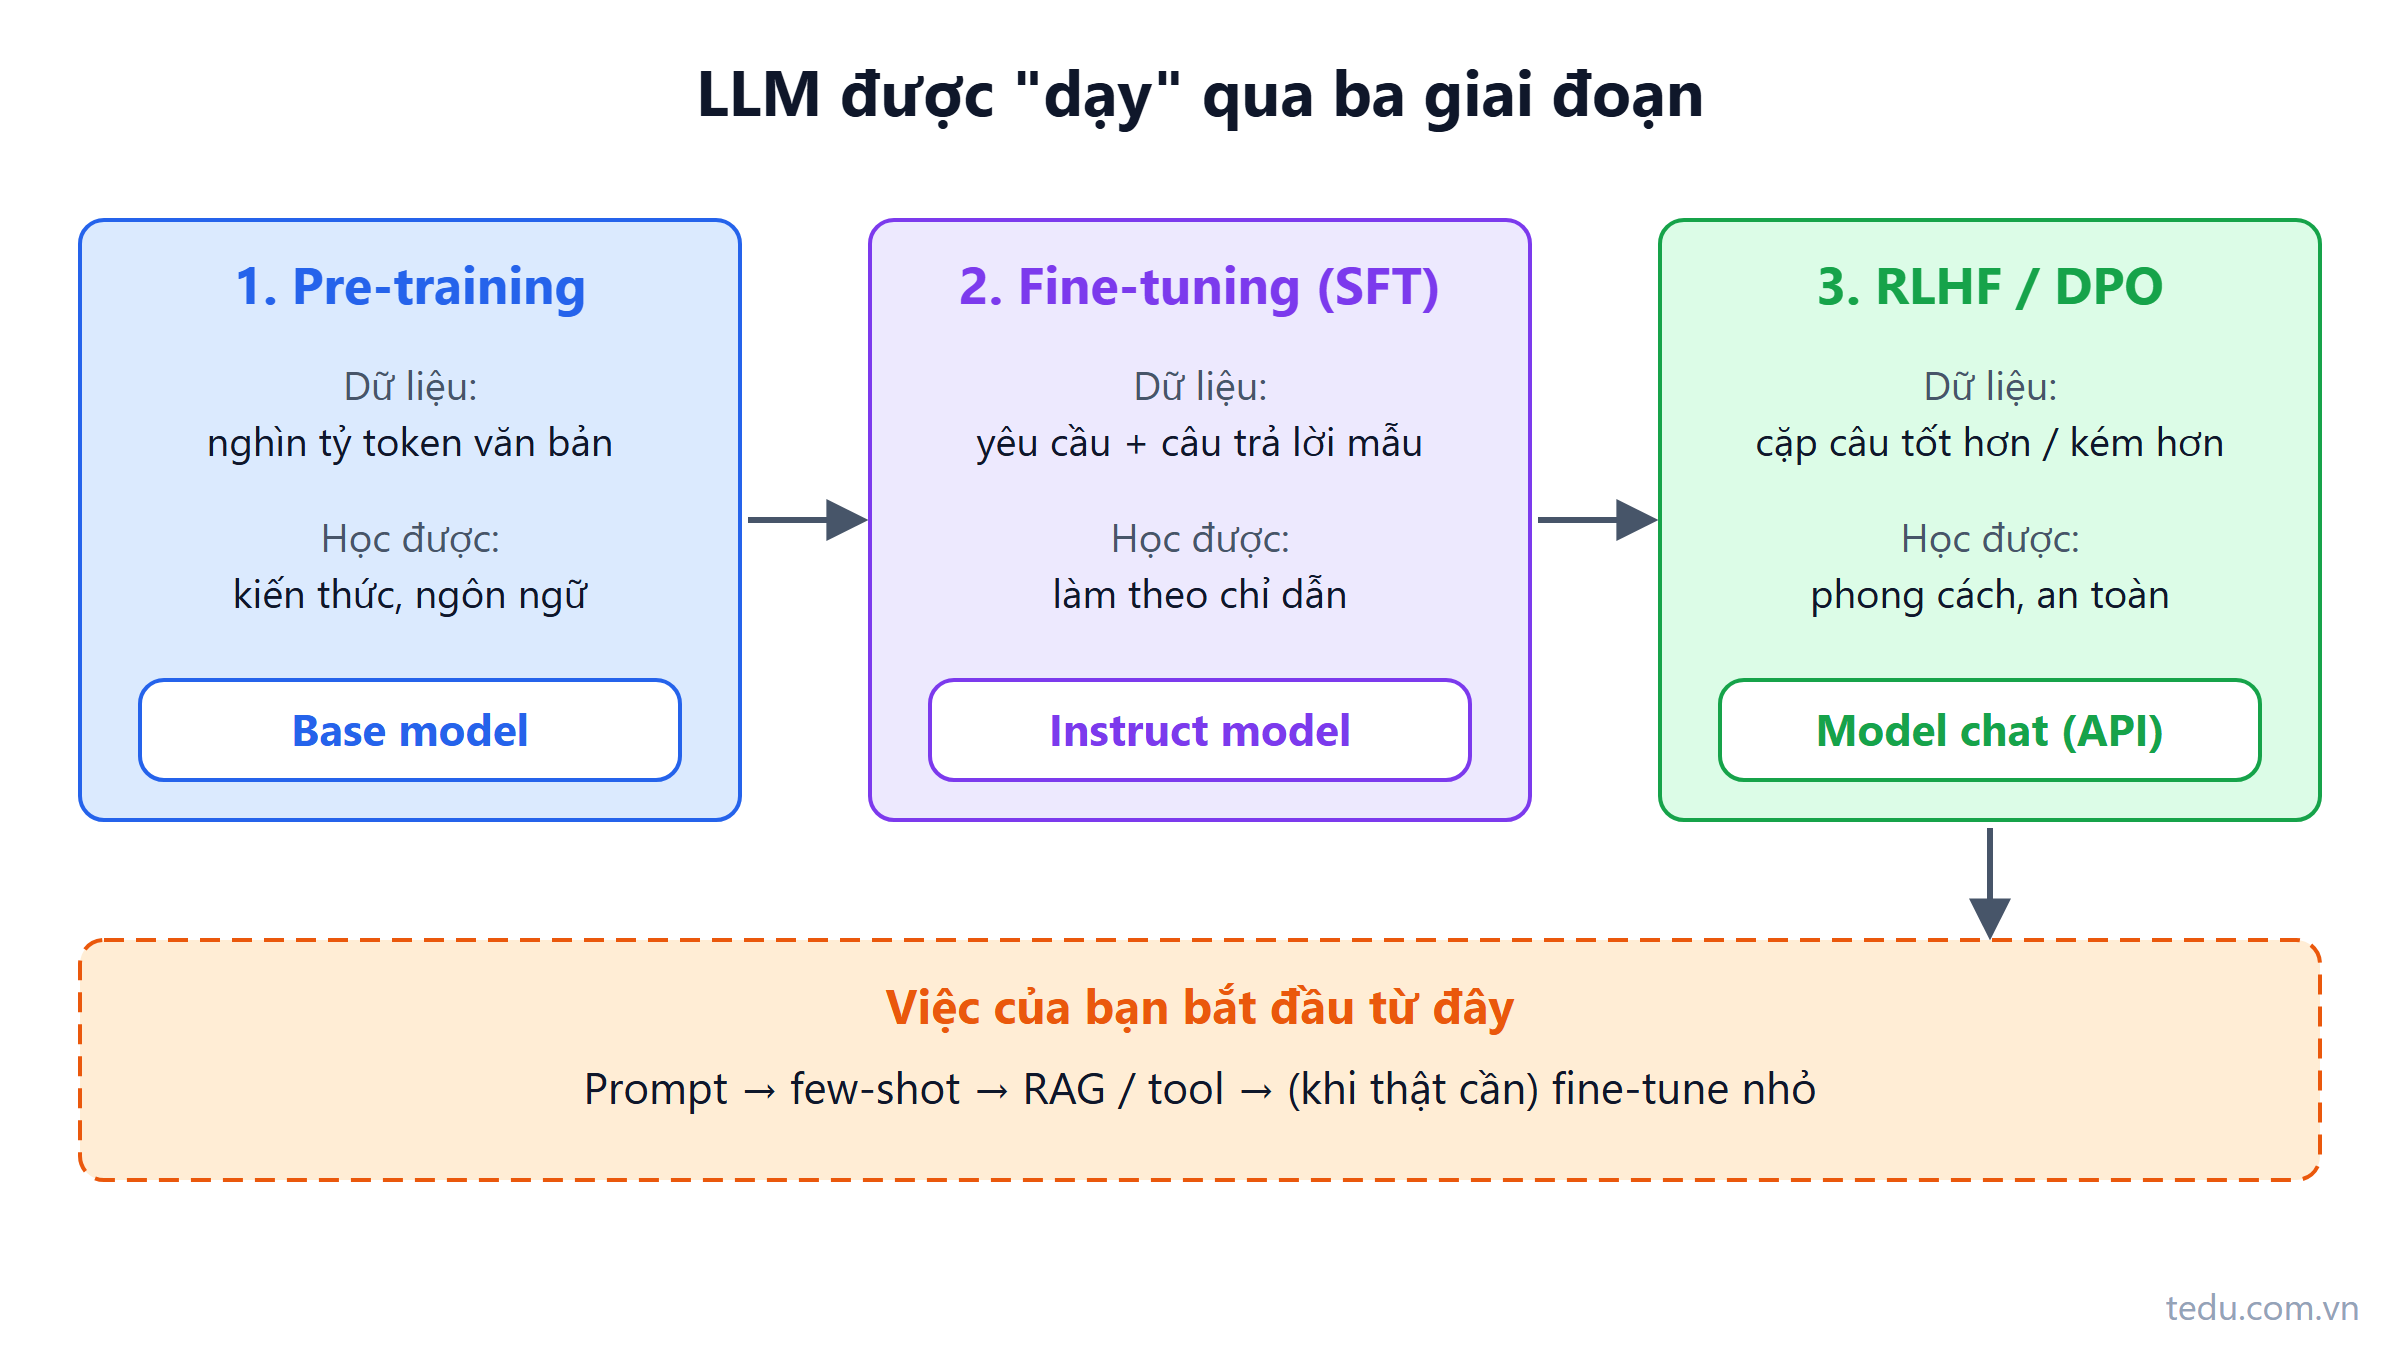
Pre-training, fine-tuning, RLHF: LLM được "dạy" thế nào
LLM đi qua ba giai đoạn huấn luyện: pre-training, fine-tuning theo chỉ dẫn và RLHF. Hiểu từng bước để biết khi nào cần fine-tune, khi nào chỉ cần RAG hoặc prompt.
Đọc thêm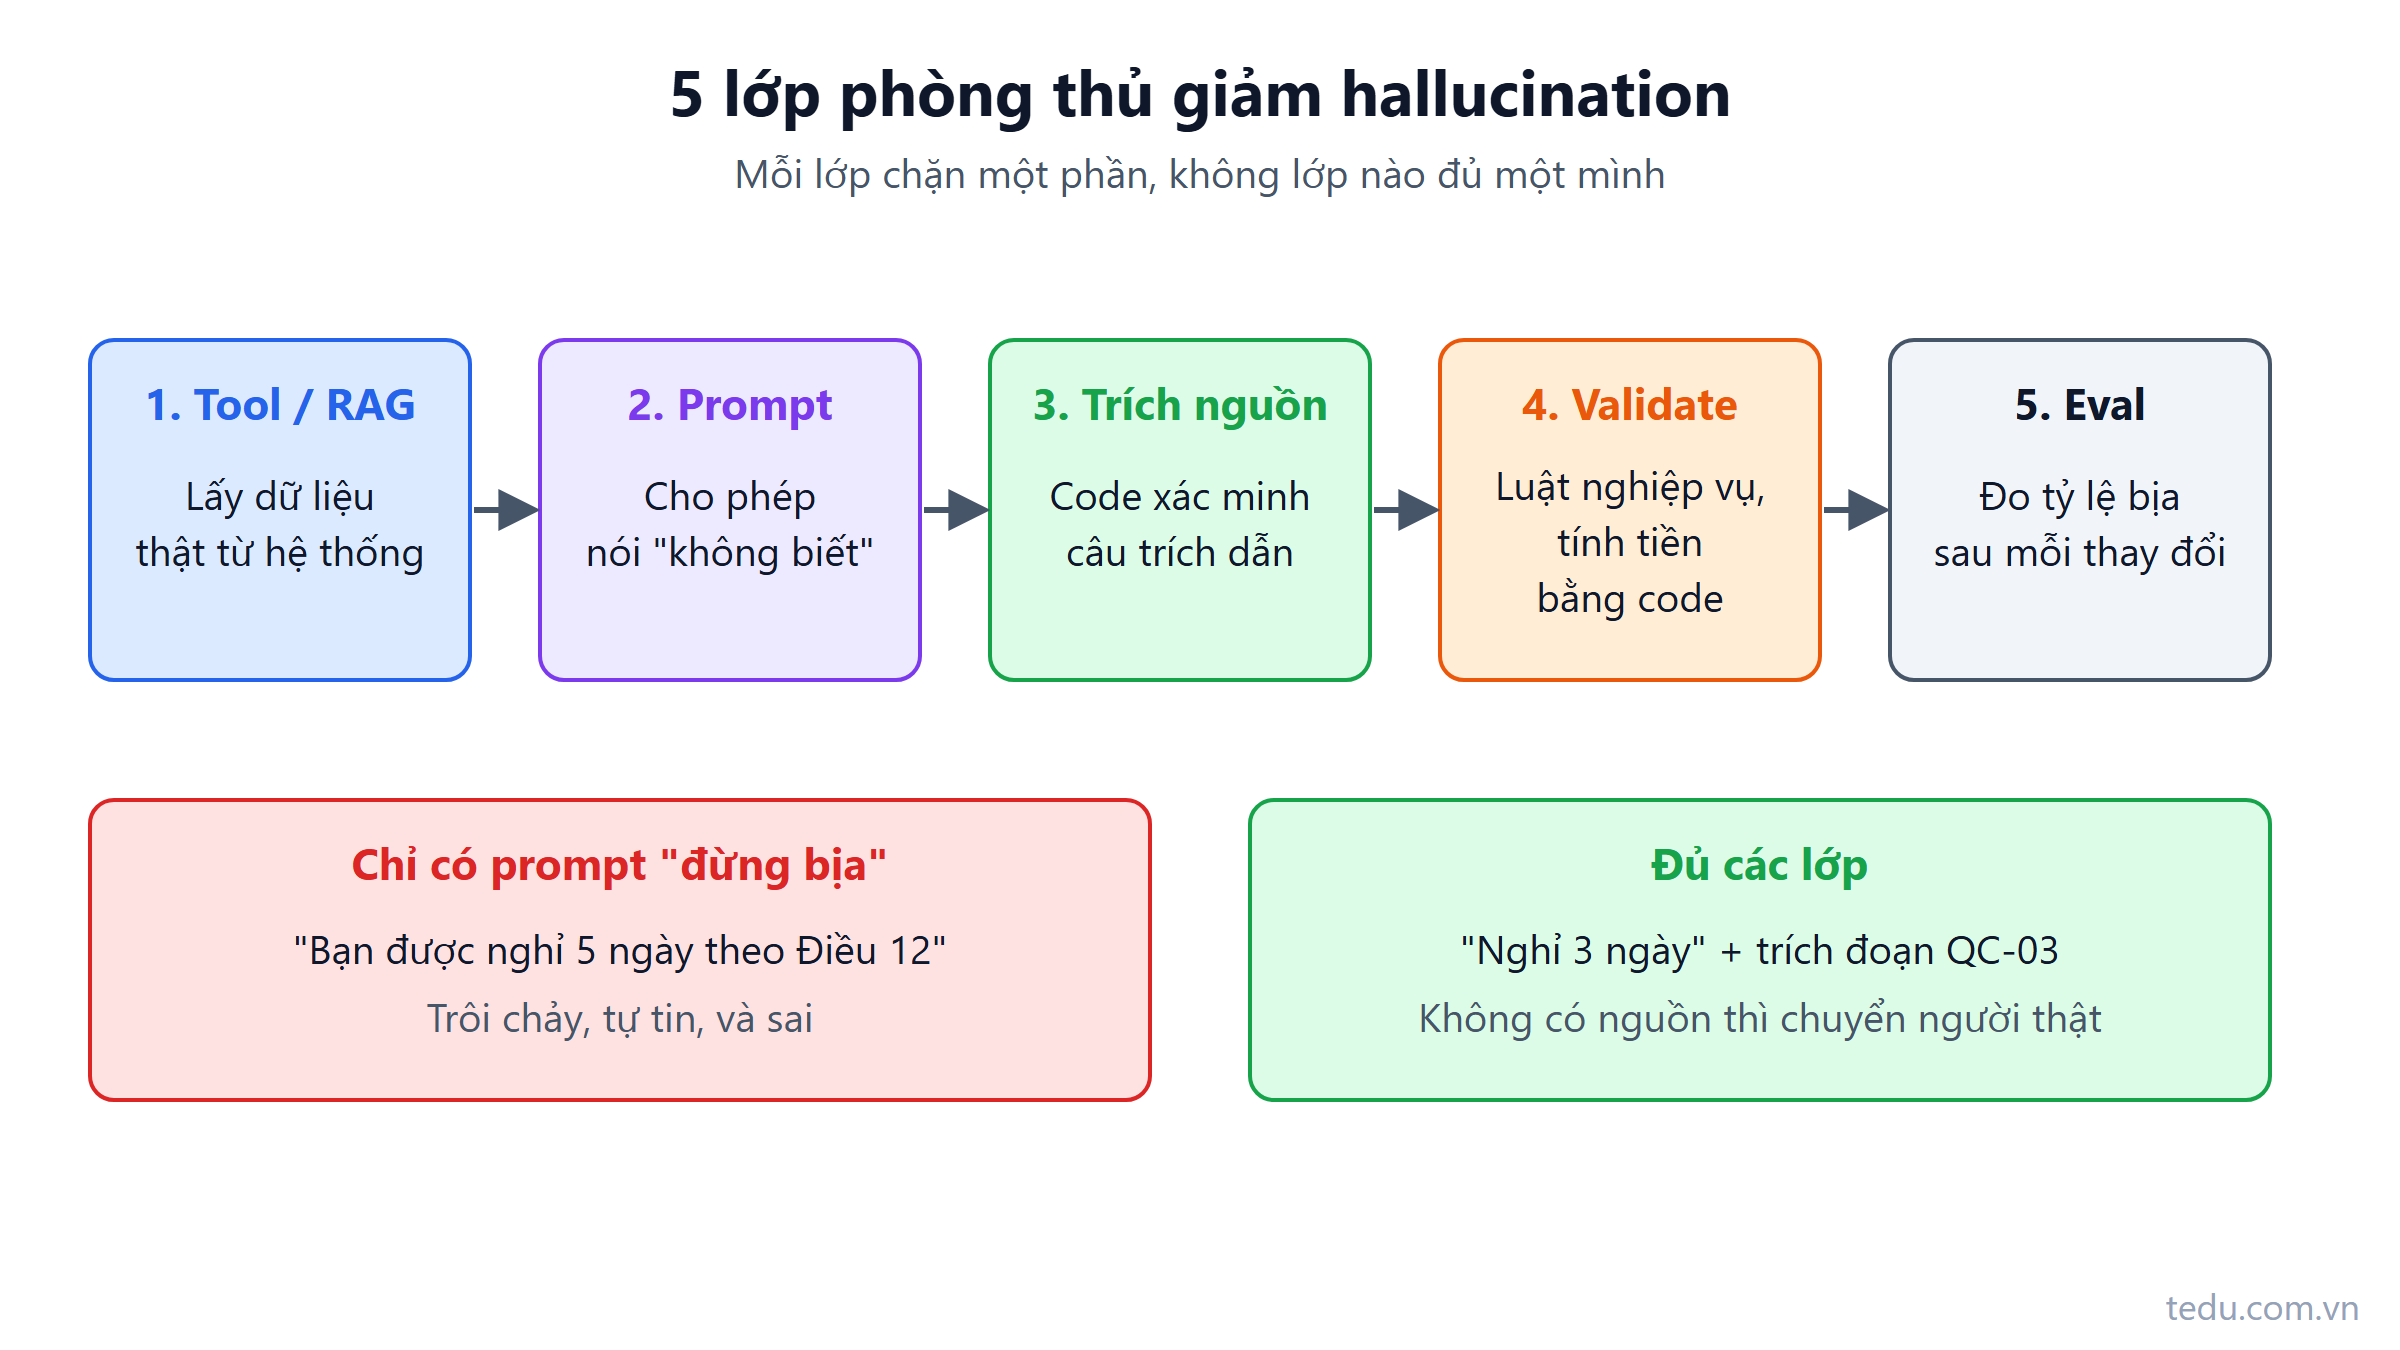
Hallucination là gì? Vì sao model "bịa" và cách hạn chế
Hallucination là khi LLM trả lời trôi chảy nhưng sai sự thật. Bài giải thích vì sao về bản chất model luôn có thể bịa, các dạng hay gặp và cách chặn bằng thiết kế hệ thống.
Đọc thêm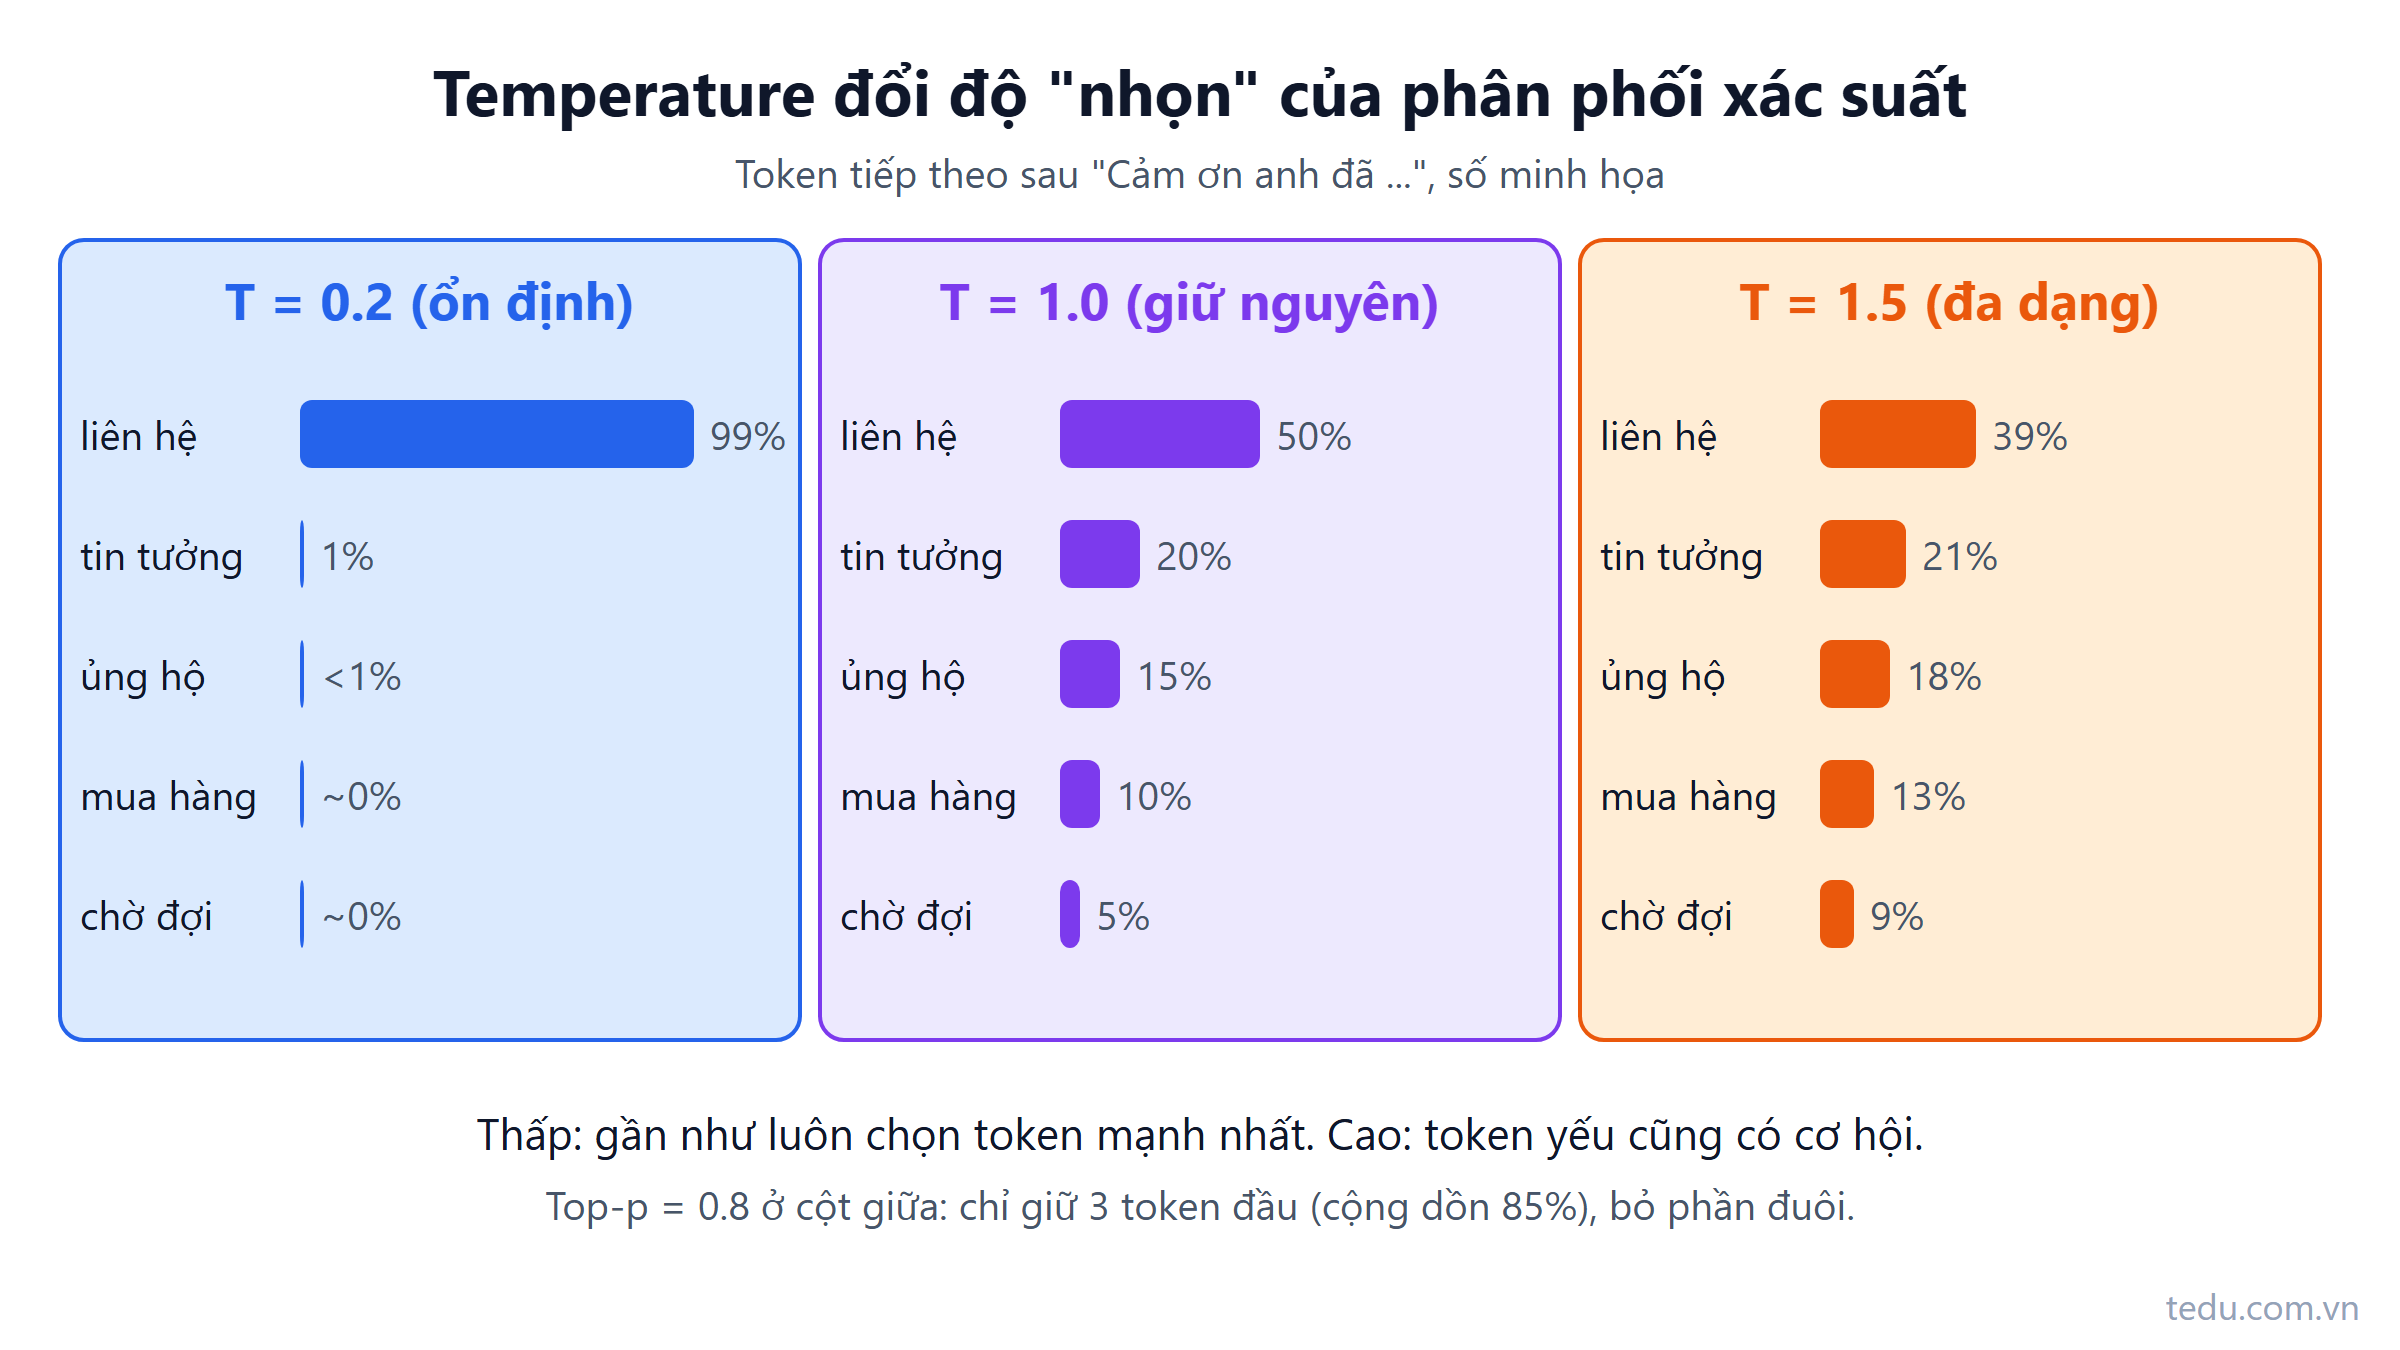
Temperature và top-p là gì? Chỉnh độ sáng tạo của LLM đúng cách
Temperature và top-p quyết định model chọn token tiếp theo an toàn hay phiêu lưu. Bài giải thích cơ chế bằng số cụ thể, code C# mô phỏng và cách chọn theo từng tác vụ.
Đọc thêm