

Chi phí LLM theo token: vì sao input và output giá khác nhau
Tháng đầu chạy thử, chatbot hỏi đáp quy chế nội bộ của một công ty khoảng 300 nhân viên tốn chưa tới một bữa trưa. Tháng thứ hai mở cho toàn công ty, hóa đơn tăng gấp mấy chục lần, trong khi số câu hỏi chỉ tăng vài lần. Sếp hỏi "sao đắt thế", và cả team ngồi nhìn nhau, vì không ai biết tiền đã đi vào đâu.
Câu trả lời gần như lúc nào cũng nằm ở cùng một chỗ: chi phí LLM tính theo token, và token không chỉ là câu hỏi người dùng gõ. Bài này giúp bạn tự tính chi phí một request, hiểu vì sao input và output có giá khác nhau, tìm ra các khoản "ẩn" làm hóa đơn phình to, và biết cắt ở đâu trước.
Chi phí LLM tính thế nào
Hầu hết nhà cung cấp LLM tính tiền theo số token, với hai mức giá riêng:
chi phí 1 request = input_tokens × giá_input + output_tokens × giá_outputGiá thường niêm yết theo một triệu token (1M tokens). Nếu chưa rõ token là gì và vì sao một câu tiếng Việt lại tốn nhiều token hơn câu tiếng Anh cùng nghĩa, đọc bài token là gì trước.
Trong bài này mình dùng giá minh họa: input 1 USD/1M token, output 4 USD/1M token, tỷ giá làm tròn 25.000 đồng/USD. Giá thật thay đổi liên tục và chênh nhau rất xa giữa model nhỏ và model lớn, hãy kiểm tra bảng giá hiện tại của nhà cung cấp bạn dùng rồi thay vào công thức.
Vì sao output đắt hơn input
Gần như mọi bảng giá đều để token đầu ra đắt hơn token đầu vào, thường gấp vài lần. Lý do nằm ở cách model chạy:
| Phần | Model làm gì | Vì sao giá như vậy |
|---|---|---|
| Input | Đọc toàn bộ prompt một lượt (prefill) | Xử lý song song nhiều token cùng lúc trên GPU, tận dụng phần cứng tốt |
| Output | Sinh từng token một (decode) | Mỗi token là một lượt tính riêng, tuần tự, GPU phải giữ trạng thái suốt quá trình |
Bài streaming LLM đã nói về hai giai đoạn này dưới góc độ thời gian. Ở góc độ tiền thì kết luận tương tự: một token output tốn tài nguyên hơn một token input, nên nó đắt hơn.
Hệ quả thực tế: một câu trả lời dài dòng tốn tiền gấp nhiều lần một câu trả lời gọn. Yêu cầu model "trả lời ngắn gọn, tối đa 5 câu" không chỉ giúp người đọc mà còn giúp ngân sách.
Một lưu ý với các model có chế độ suy luận (reasoning): phần "suy nghĩ" của model trước khi trả lời thường được tính như token output, kể cả khi bạn không nhìn thấy nó. Một câu trả lời hiển thị 100 token có thể đã tiêu vài nghìn token suy luận. Kiểm tra trường usage trong response để biết con số thật.
Ví dụ: tự tính chi phí chatbot quy chế nội bộ
Lấy chatbot hỏi đáp quy chế ở đầu bài. Một lượt hỏi đầu tiên gồm:
| Thành phần | Token (ước lượng) | Loại |
|---|---|---|
| System prompt (vai trò, quy tắc trả lời, định dạng) | 800 | Input |
| Định nghĩa 3 tool (tra phép năm, tra quy chế, tạo đơn nghỉ) | 600 | Input |
| 4 đoạn quy chế lấy từ RAG | 2.000 | Input |
| Câu hỏi của nhân viên | 40 | Input |
| Câu trả lời | 250 | Output |
Tính với giá minh họa:
input  = 3.440 token × 1 USD / 1.000.000 = 0,00344 USD
output =   250 token × 4 USD / 1.000.000 = 0,00100 USD
tổng   ≈ 0,0044 USD ≈ 110 đồng một lượt hỏi
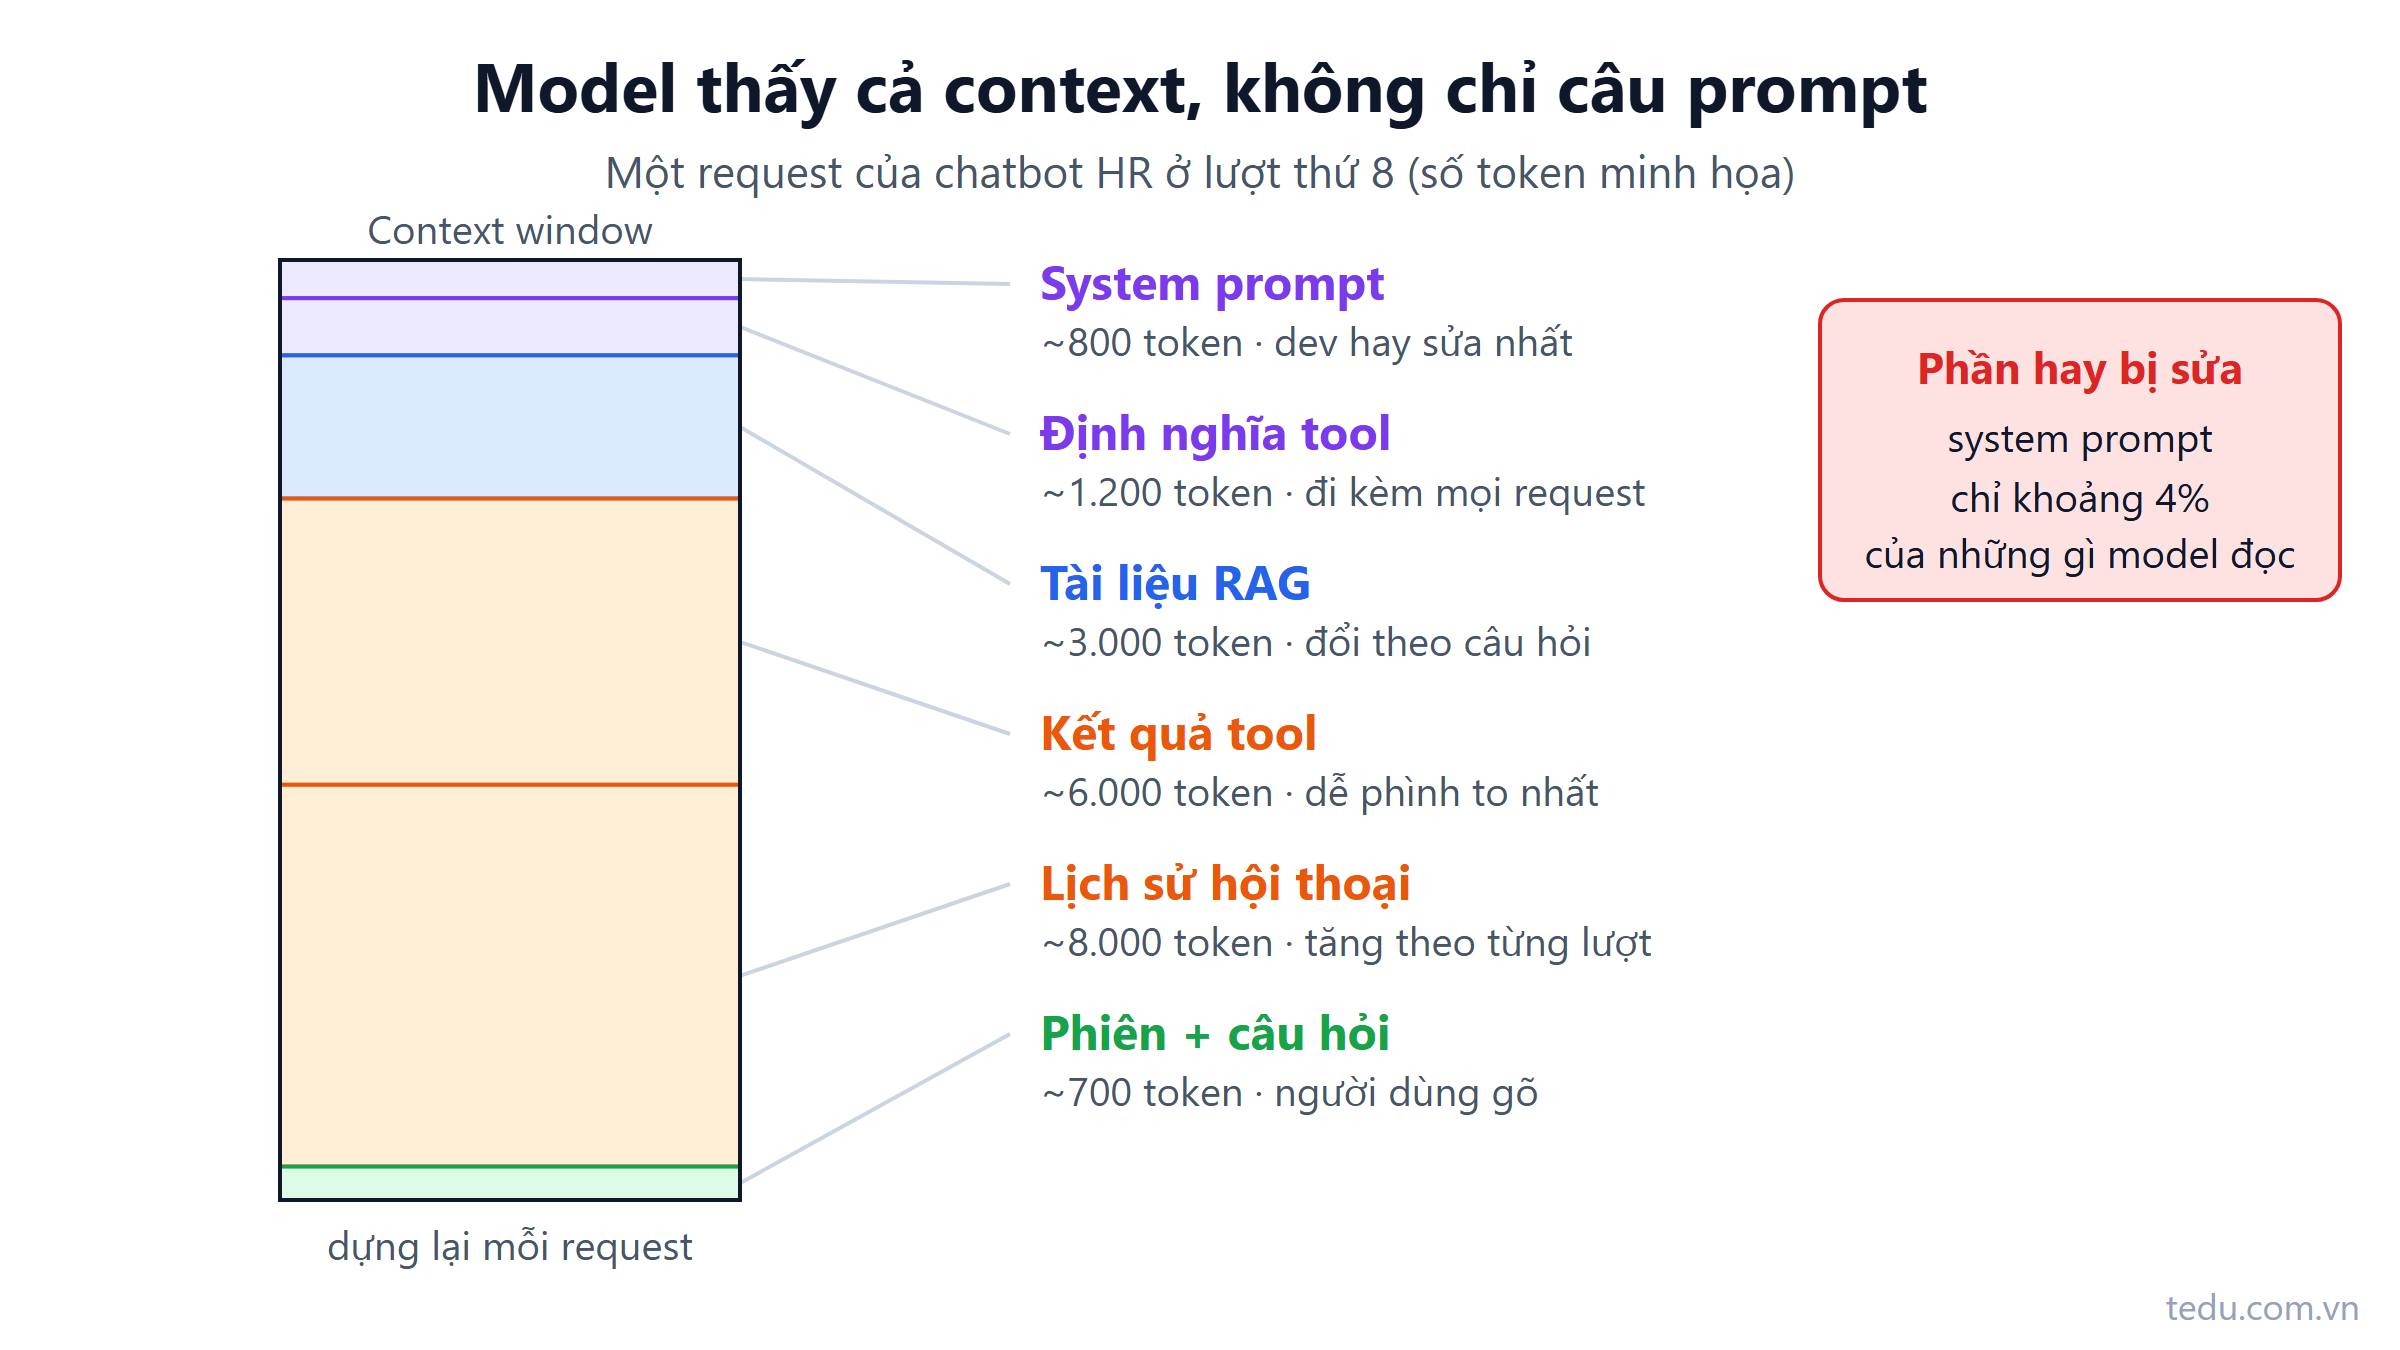
110 đồng nghe rất rẻ. Câu hỏi đầu tiên của nhân viên gõ 40 token, nhưng bạn trả tiền cho gần 3.700 token. Phần lớn chi phí nằm ở thứ người dùng không nhìn thấy.
Các khoản ẩn làm hóa đơn phình to
Lịch sử hội thoại gửi lại mỗi lượt
LLM là stateless: mỗi lượt hỏi tiếp theo phải gửi lại toàn bộ lịch sử (xem bài LLM là stateless). Lượt thứ 10 của một cuộc chat mang theo 9 câu hỏi, 9 câu trả lời, và có thể cả 9 lần kết quả RAG nếu bạn lưu chúng vào lịch sử.
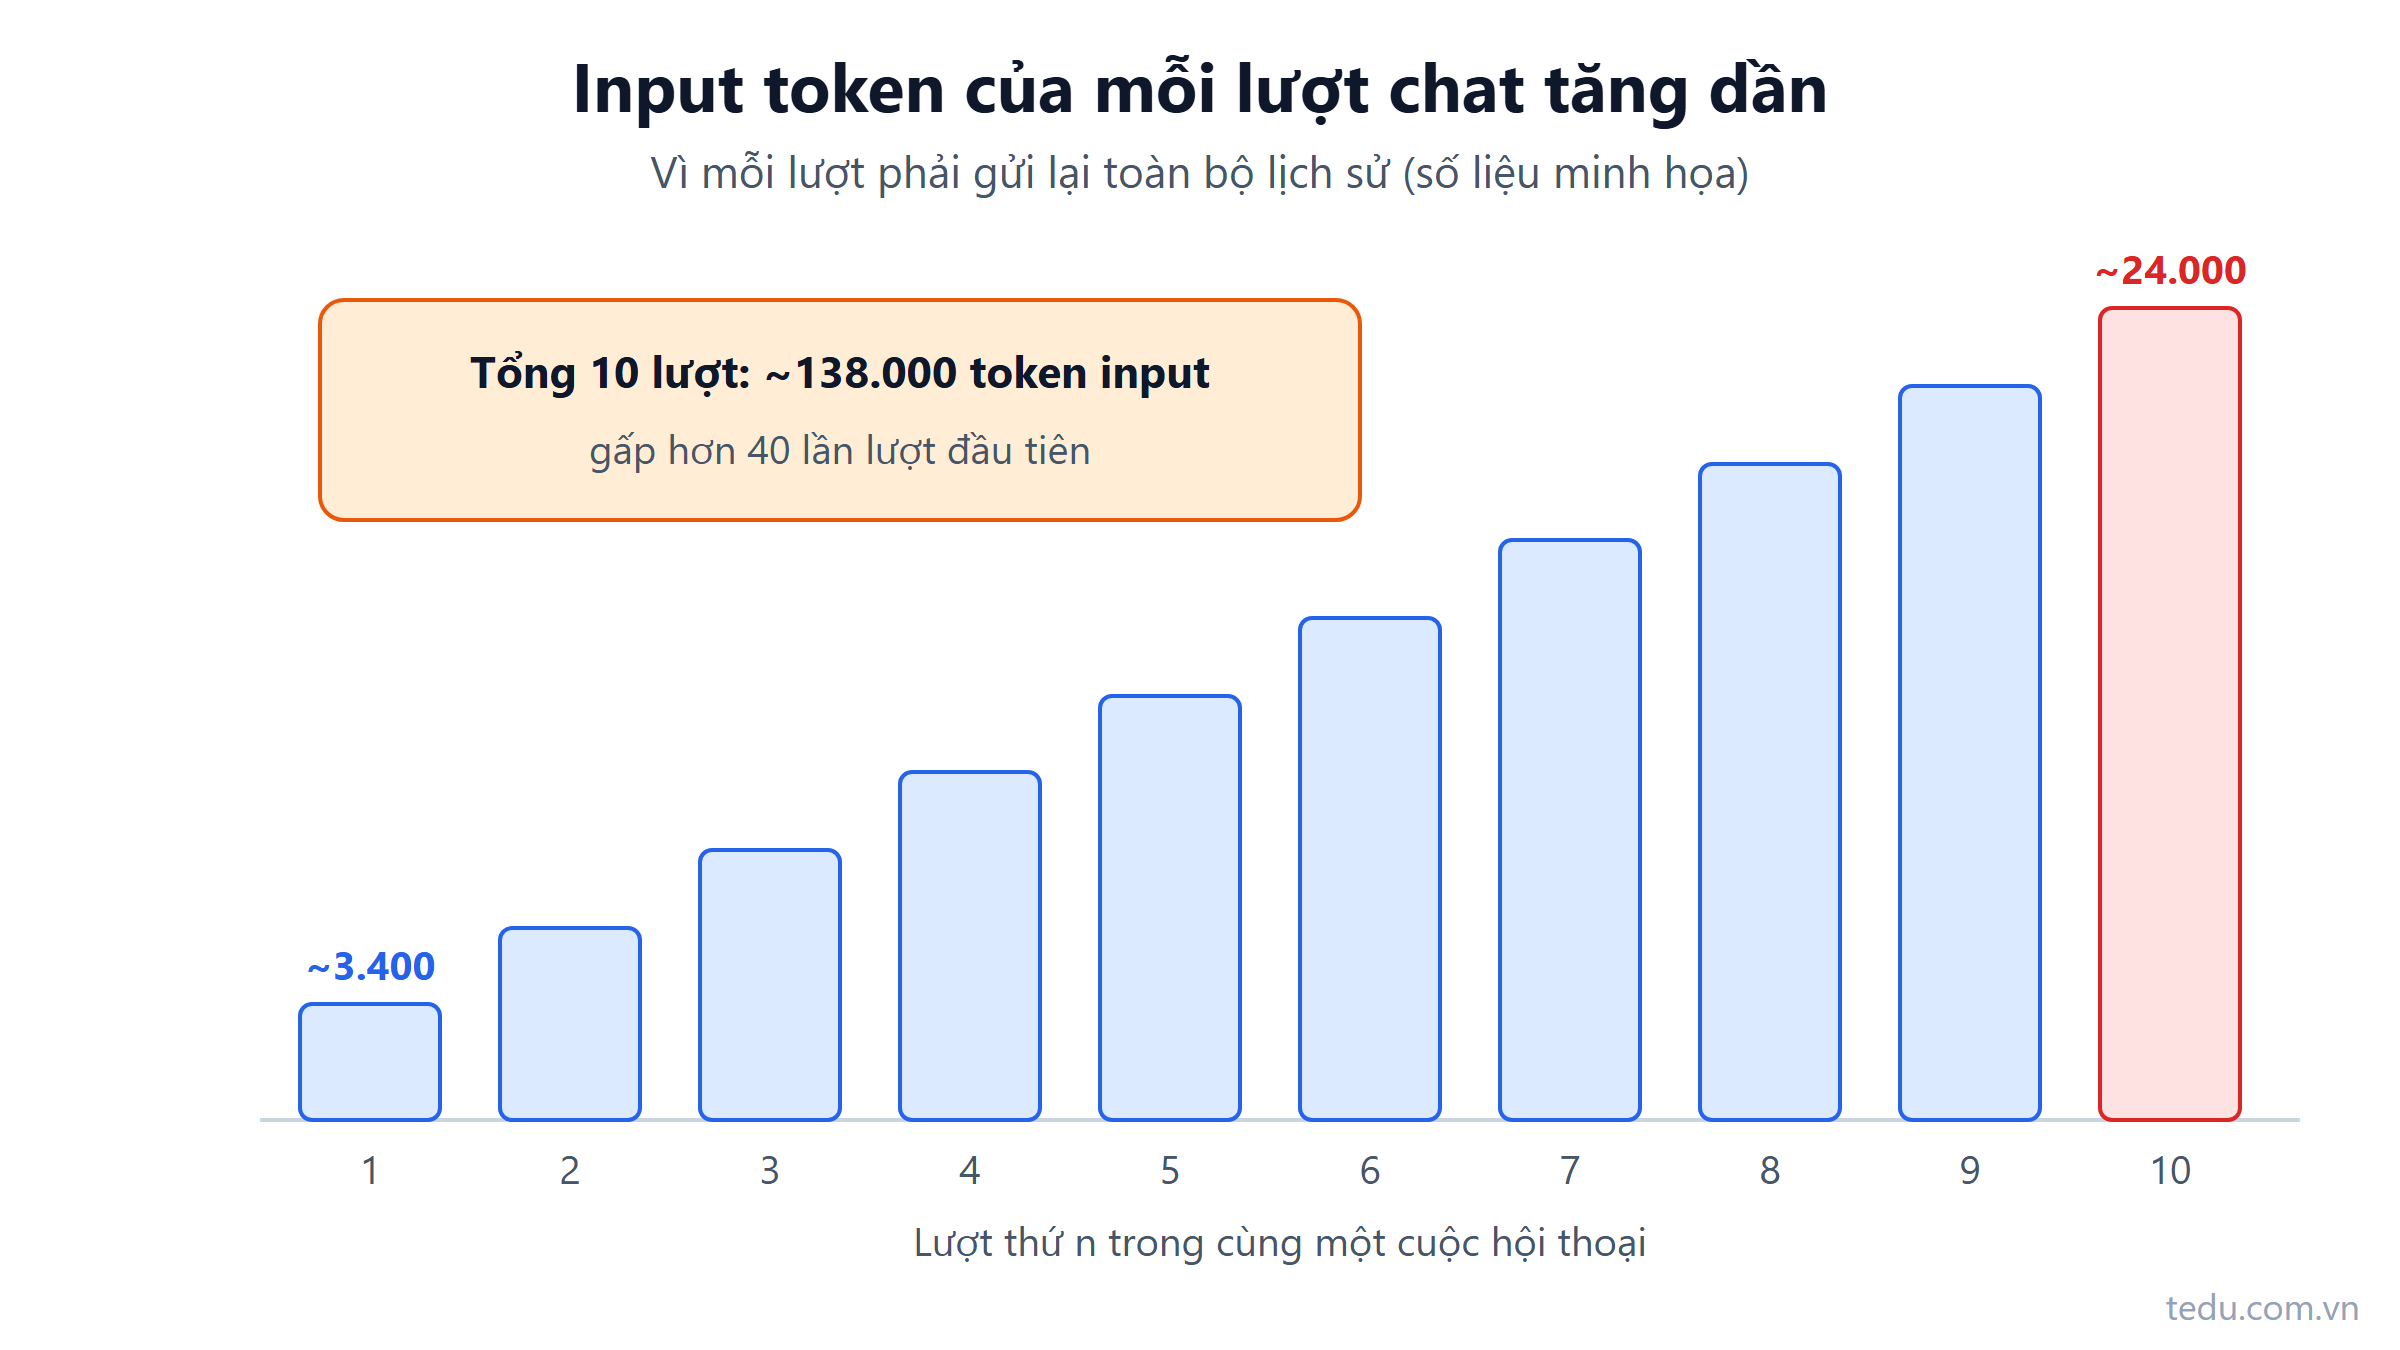
Giả sử mỗi lượt thêm khoảng 2.300 token vào lịch sử (câu hỏi, đoạn quy chế, câu trả lời). Input của lượt thứ n xấp xỉ 3.440 + 2.300 × (n − 1). Lượt 1 khoảng 3.400 token, lượt 10 khoảng 24.000 token. Tổng input của cả cuộc 10 lượt khoảng 138.000 token, gấp hơn 40 lần lượt đầu tiên. Chi phí của cuộc chat tăng gần như theo bình phương số lượt, không phải tuyến tính.
Đây chính là lý do ở đầu bài: khi mở cho toàn công ty, người dùng chat dài hơn, và mỗi lượt sau đắt hơn lượt trước.
Định nghĩa tool và vòng lặp tool
Mỗi tool bạn khai báo đi kèm mọi request, dù model có gọi hay không. Thêm 20 tool "cho đủ bộ" có thể thêm vài nghìn token input cho mỗi lượt.
Với function calling, một câu hỏi có thể thành 3 lần gọi model: lần 1 model đề nghị gọi tool, lần 2 đọc kết quả rồi gọi tool khác, lần 3 trả lời. Mỗi lần đều gửi lại toàn bộ messages. Kết quả tool là một bản ghi JSON 3.000 token thì bạn trả tiền cho nó ở lần 2, lần 3, và mọi lượt sau trong lịch sử.
Retry, eval, và các request bạn quên đếm
Retry khi parse JSON lỗi hoặc timeout: mỗi lần retry là một request đầy đủ.
Bước phụ: viết lại câu hỏi trước khi tìm kiếm, phân loại ý định, tóm tắt lịch sử. Mỗi bước là một request.
Chạy bộ eval mỗi lần đổi prompt: vài trăm câu hỏi nhân với số lần chạy.
Môi trường dev và staging dùng chung API key với production.
Ghi log chi phí từng request bằng C#
Bạn không cắt được thứ bạn không đo. Hầu hết API trả về số token đã dùng trong response (trường thường tên là usage, tên field con khác nhau giữa các nhà cung cấp). Ghi nó lại cho từng request, kèm tính năng và người dùng:
public sealed record ModelPrice(decimal InputPerMillion, decimal OutputPerMillion);

public sealed class LlmCostTracker(ILogger<LlmCostTracker> logger)
{
    // Giá minh họa, đọc từ cấu hình thật trong dự án
    private readonly Dictionary<string, ModelPrice> prices = new()
    {
        ["model-small"] = new(0.2m, 0.8m),
        ["model-large"] = new(1.0m, 4.0m)
    };

    public decimal Record(string model, string feature, string userId,
                          int inputTokens, int outputTokens)
    {
        var p = prices[model];
        var cost = inputTokens  * p.InputPerMillion  / 1_000_000m
                 + outputTokens * p.OutputPerMillion / 1_000_000m;

        logger.LogInformation(
            "LLM {Model} {Feature} user={UserId} in={In} out={Out} cost={Cost:F6} USD",
            model, feature, userId, inputTokens, outputTokens, cost);

        return cost;
    }
}
Dùng structured logging như trên, bạn có thể dựng dashboard trả lời được những câu sếp sẽ hỏi: tính năng nào tốn nhất, người dùng nào chat nhiều bất thường, chi phí trung bình một cuộc hội thoại là bao nhiêu. Đừng tự đếm token bằng cách chia độ dài chuỗi cho một hằng số; con số do nhà cung cấp trả về mới là con số họ dùng để tính tiền.
Cắt chi phí ở đâu trước
Thứ tự ưu tiên dưới đây đi từ ít công nhất, hiệu quả nhất:
| Cách | Cắt vào đâu | Đánh đổi |
|---|---|---|
| Giới hạn độ dài trả lời (dặn trong prompt và đặt số token output tối đa) | Output | Câu trả lời có thể bị cụt nếu đặt quá thấp |
| Cắt lịch sử: giữ vài lượt gần nhất, tóm tắt phần cũ | Input tăng dần theo lượt | Model có thể quên chi tiết đầu cuộc |
| Không lưu kết quả RAG và kết quả tool vào lịch sử, chỉ lưu câu hỏi và câu trả lời | Input | Lượt sau muốn dùng lại phải tìm lại |
| Rút gọn kết quả tool, chỉ trả trường cần thiết | Input ở mọi vòng sau | Phải viết thêm mapping |
| Giảm số đoạn RAG (top 4 thay vì top 10) | Input | Có thể bỏ sót thông tin, cần đo bằng eval |
| Prompt caching cho phần tĩnh: system prompt, tool, tài liệu cố định | Input lặp lại | Phải sắp xếp prompt cho phần tĩnh đứng trước |
| Dùng model nhỏ cho bước dễ (phân loại, viết lại câu hỏi) | Cả hai | Cần eval để chắc model nhỏ đủ tốt |
Hai dòng đầu thường cắt được phần lớn chi phí thừa mà gần như không ảnh hưởng chất lượng. Đổi sang model rẻ hơn hay bị chọn đầu tiên, nhưng nên để sau cùng, vì nó là cách duy nhất trong bảng có thể làm chất lượng giảm rõ rệt.
Checklist ước tính chi phí trước khi lên production
Liệt kê mọi thành phần input của một request: system prompt, tool, tài liệu, lịch sử, câu hỏi.
Ước tính số lượt trung bình mỗi cuộc chat và số cuộc chat mỗi ngày.
Tính chi phí theo công thức, dùng giá hiện tại của nhà cung cấp, có tính lịch sử tăng dần.
Cộng thêm các request phụ: retry, phân loại, viết lại câu hỏi, eval.
Ghi log usage cho từng request, gắn theo tính năng và người dùng.
Đặt giới hạn: số token output tối đa, số lượt tối đa mỗi cuộc chat, hạn mức mỗi người dùng mỗi ngày.
Đặt cảnh báo ngân sách ở tài khoản nhà cung cấp, tách API key cho dev và production.
Kết luận
Chi phí LLM không khó tính, chỉ khó thấy. Công thức chỉ có hai số hạng, nhưng input bao gồm mọi thứ bạn gửi đi: system prompt, tool, tài liệu, lịch sử, kết quả tool. Output ít token hơn nhưng đắt hơn từng token. Hóa đơn bất ngờ thường đến từ lịch sử chat dài và vòng lặp tool, không phải từ câu hỏi của người dùng.
Bước tiếp theo: thêm log usage vào tính năng LLM bạn đang làm và xem một tuần dữ liệu thật trước khi tối ưu bất cứ thứ gì. Bài kế tiếp trong series: prompt caching, cách cắt cả chi phí lẫn độ trễ cho phần prompt lặp lại.
Xem bản tóm tắt dưới một phút trên YouTube @teduco hoặc TikTok @teducolabs, và đọc thêm các bài khác trong chuyên mục AI cho Backend Developer.
Bài viết liên quan
Context engineering là gì, vì sao quan trọng hơn prompt
Context engineering là quyết định cái gì vào context window, cái gì phải ra, theo thứ tự nào. Câu prompt chỉ là một phần nhỏ của những gì model thấy.
Đọc thêm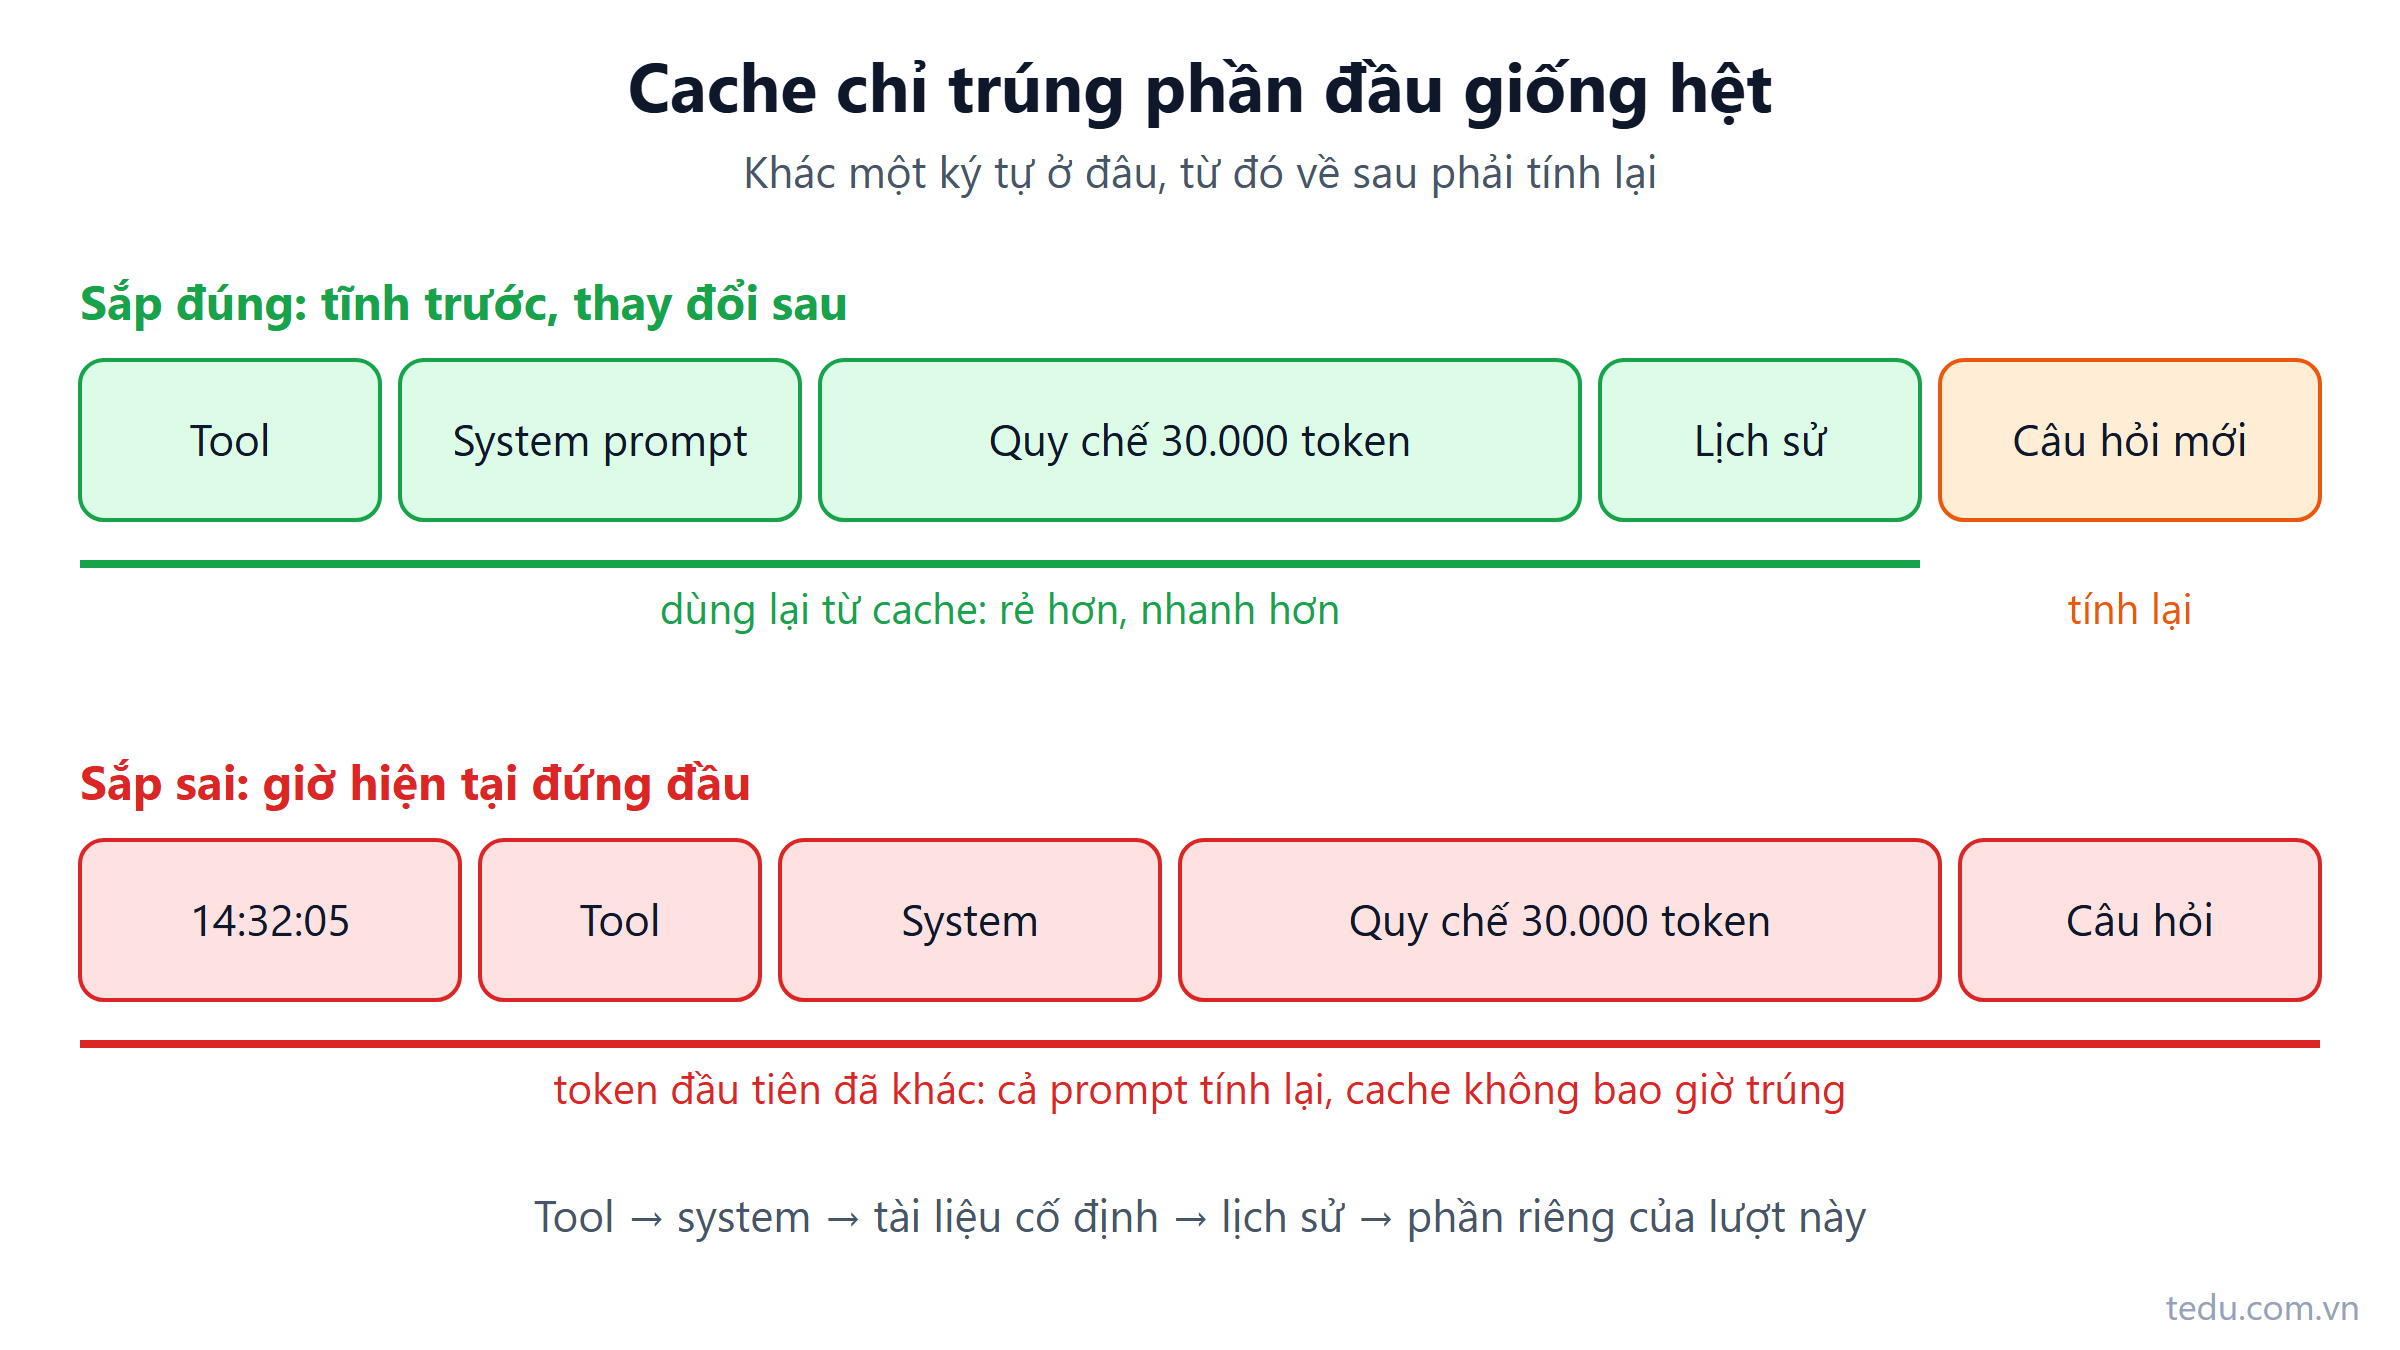
Prompt caching là gì? Cắt chi phí và độ trễ cho LLM
Prompt caching cho phép nhà cung cấp LLM dùng lại phần đầu prompt đã xử lý, giảm chi phí và độ trễ. Bài giải thích cơ chế prefix và cách sắp prompt.
Đọc thêm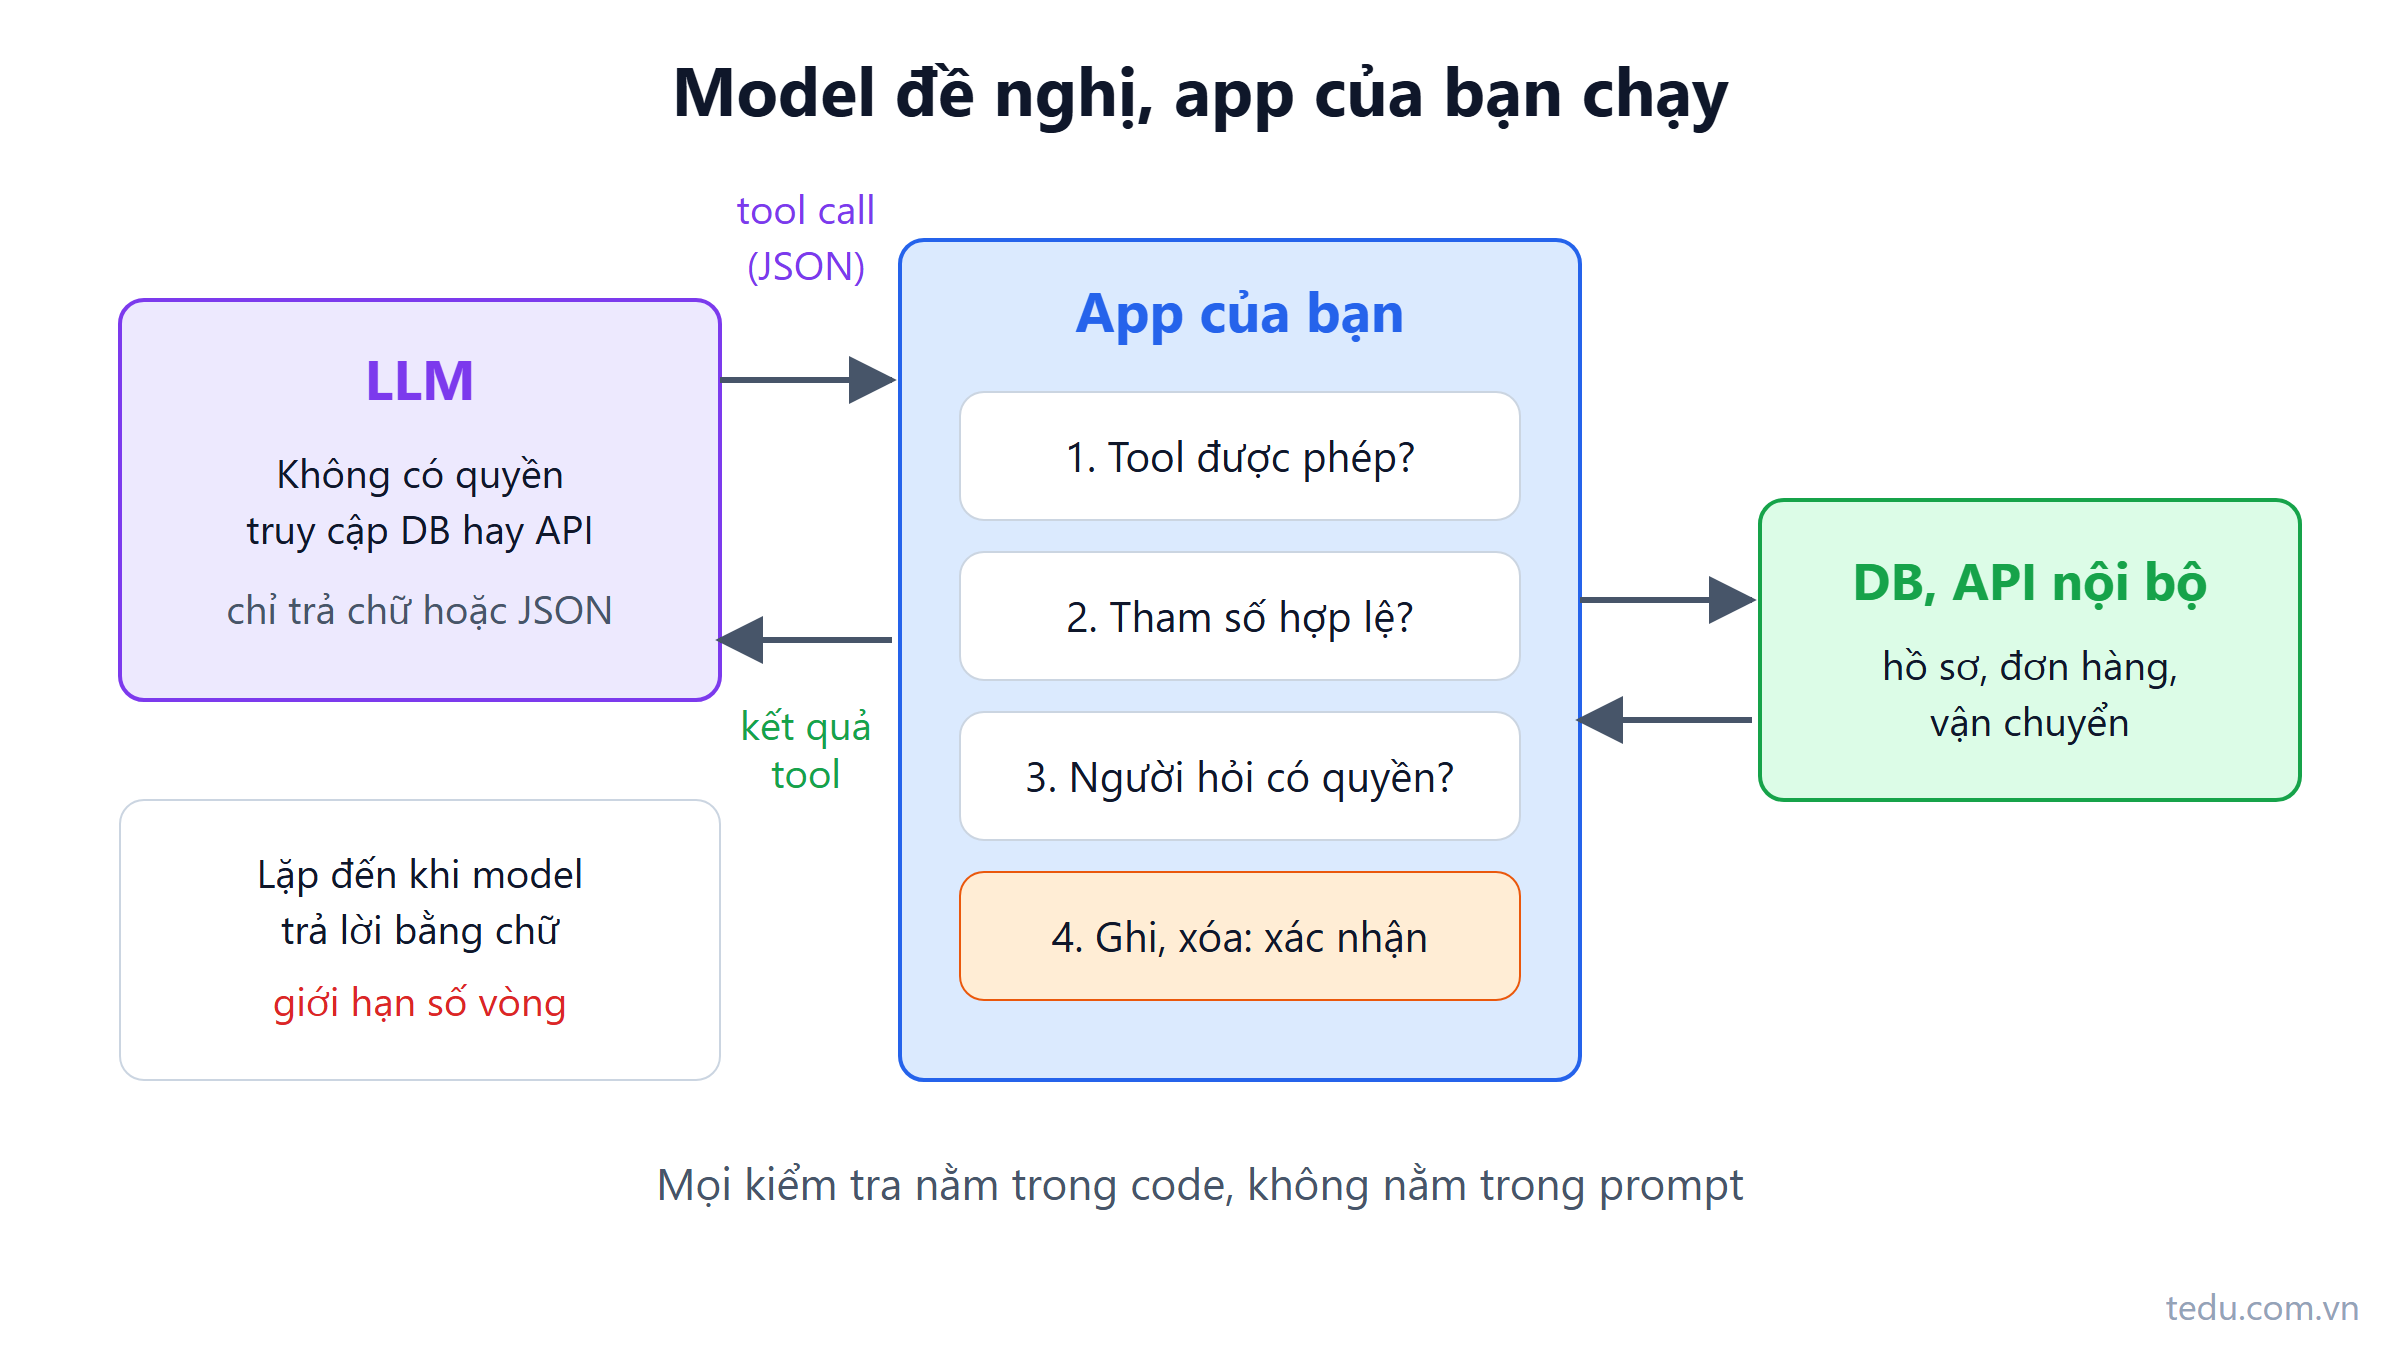
Function calling: model không tự chạy code
Function calling (tool calling) là model đề nghị gọi hàm bằng JSON, còn app của bạn validate, phân quyền và chạy. Ví dụ C# tra cứu hồ sơ, đơn hàng.
Đọc thêm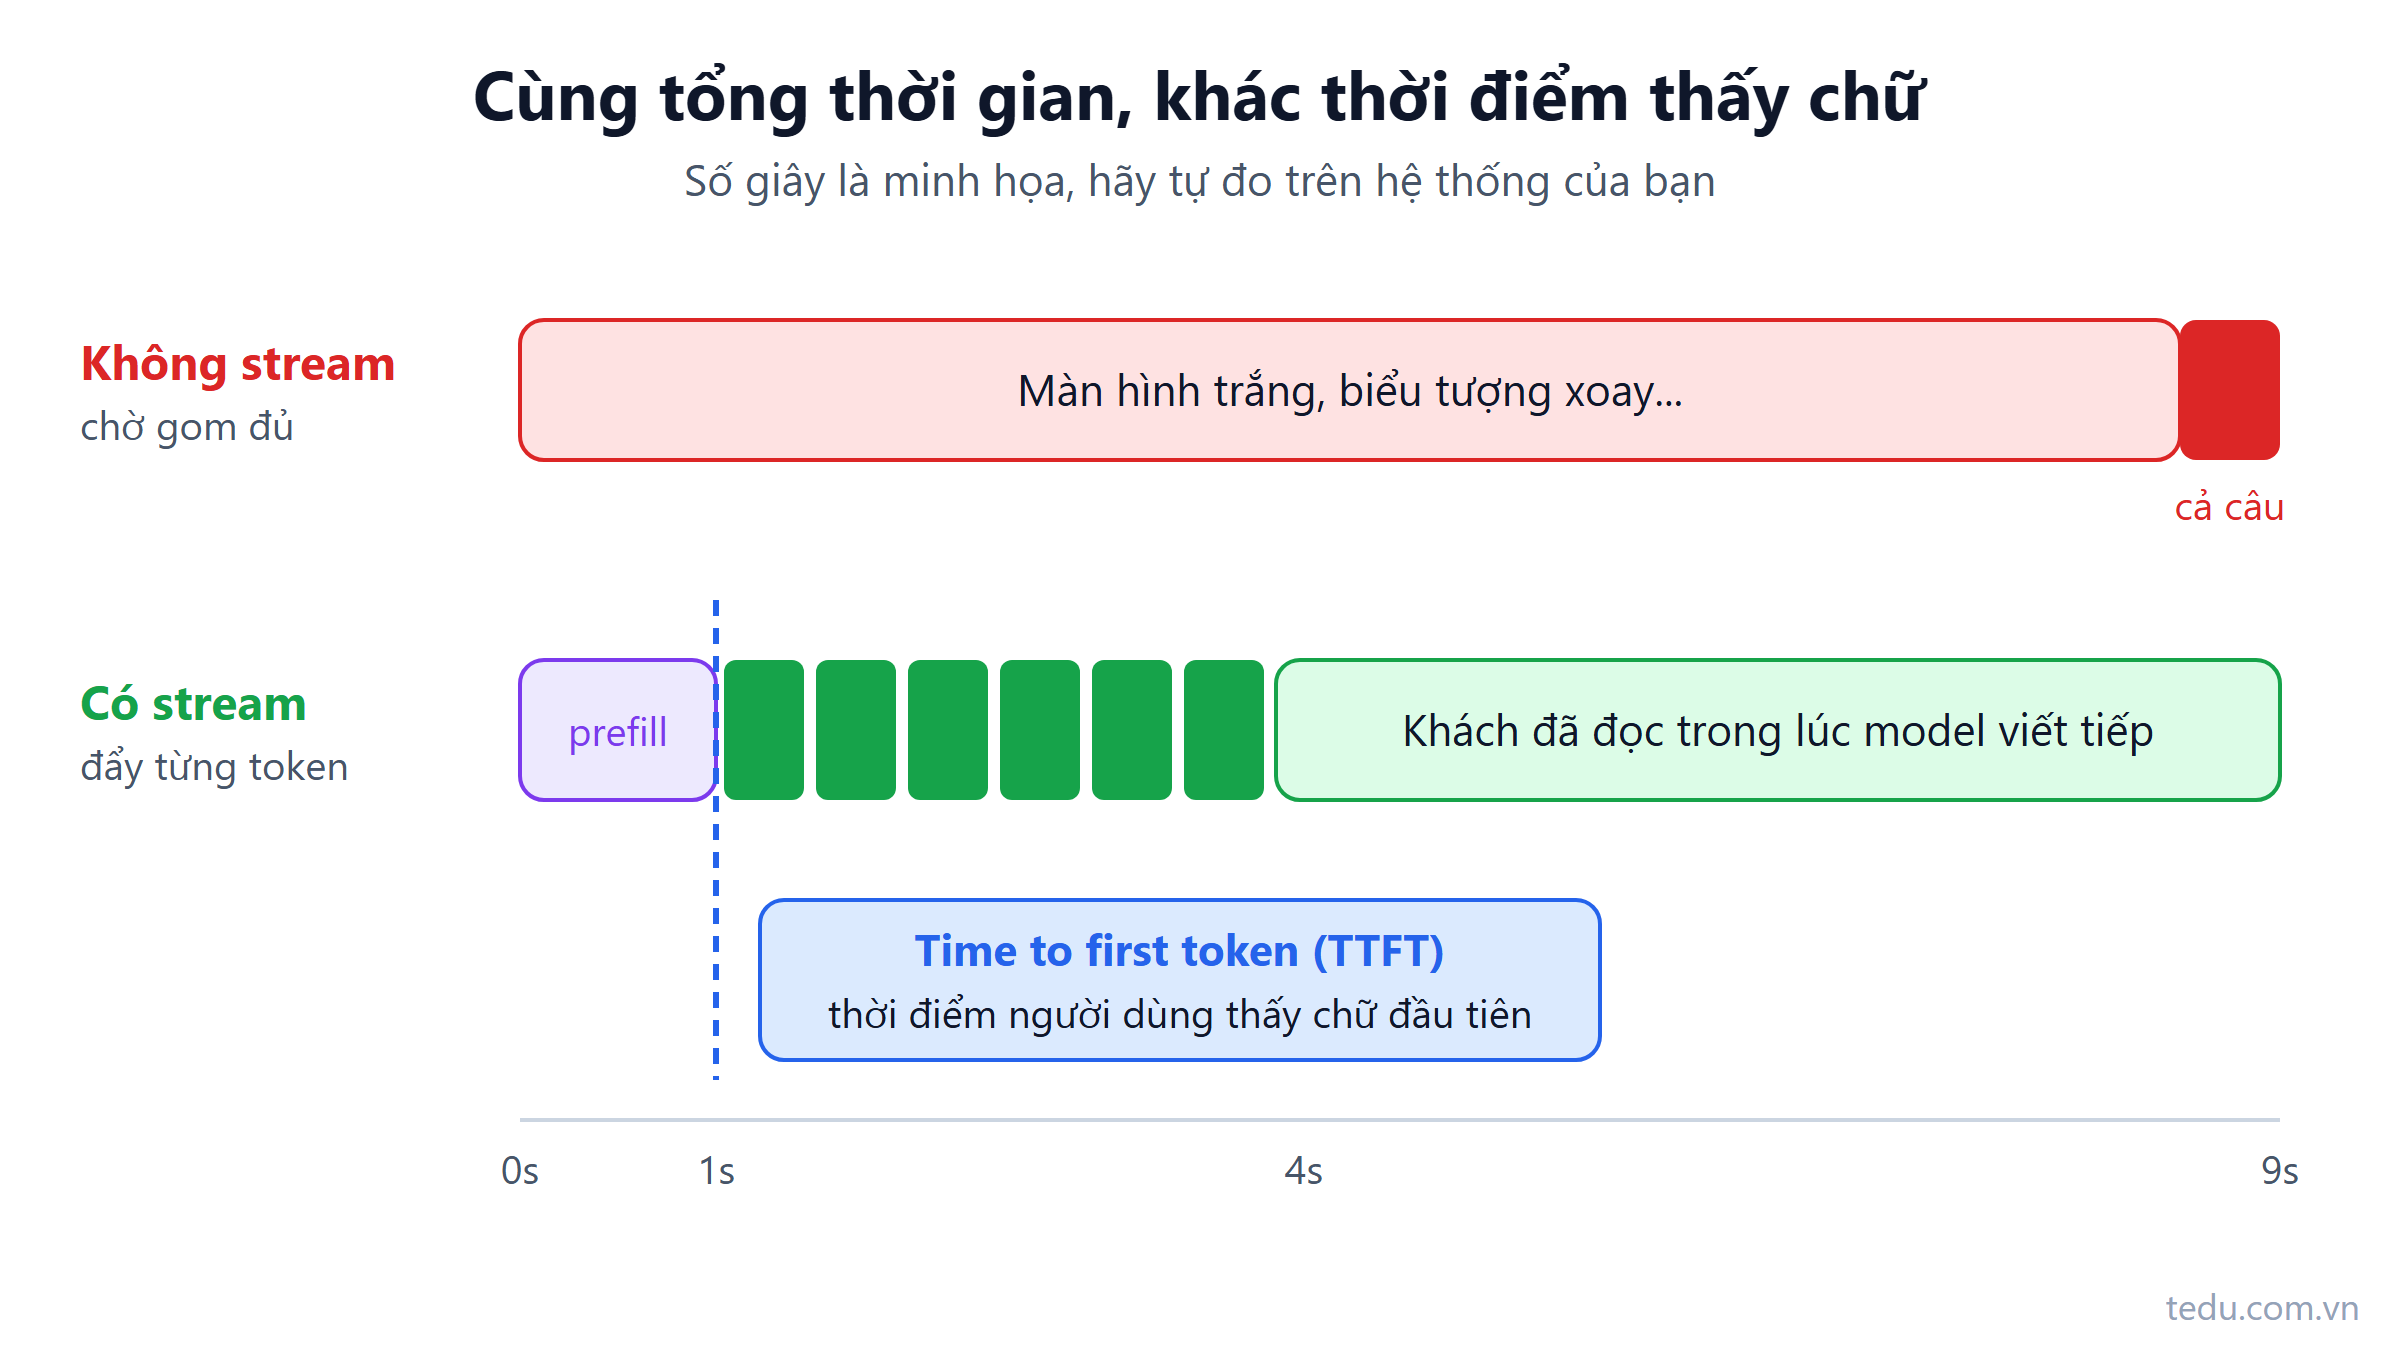
Streaming LLM: vì sao chữ hiện ra từng chút một
Streaming LLM gửi từng token về ngay khi model sinh ra, nên người dùng thấy chữ sau 1 giây thay vì chờ 10 giây. Cơ chế SSE và code C# đầy đủ.
Đọc thêm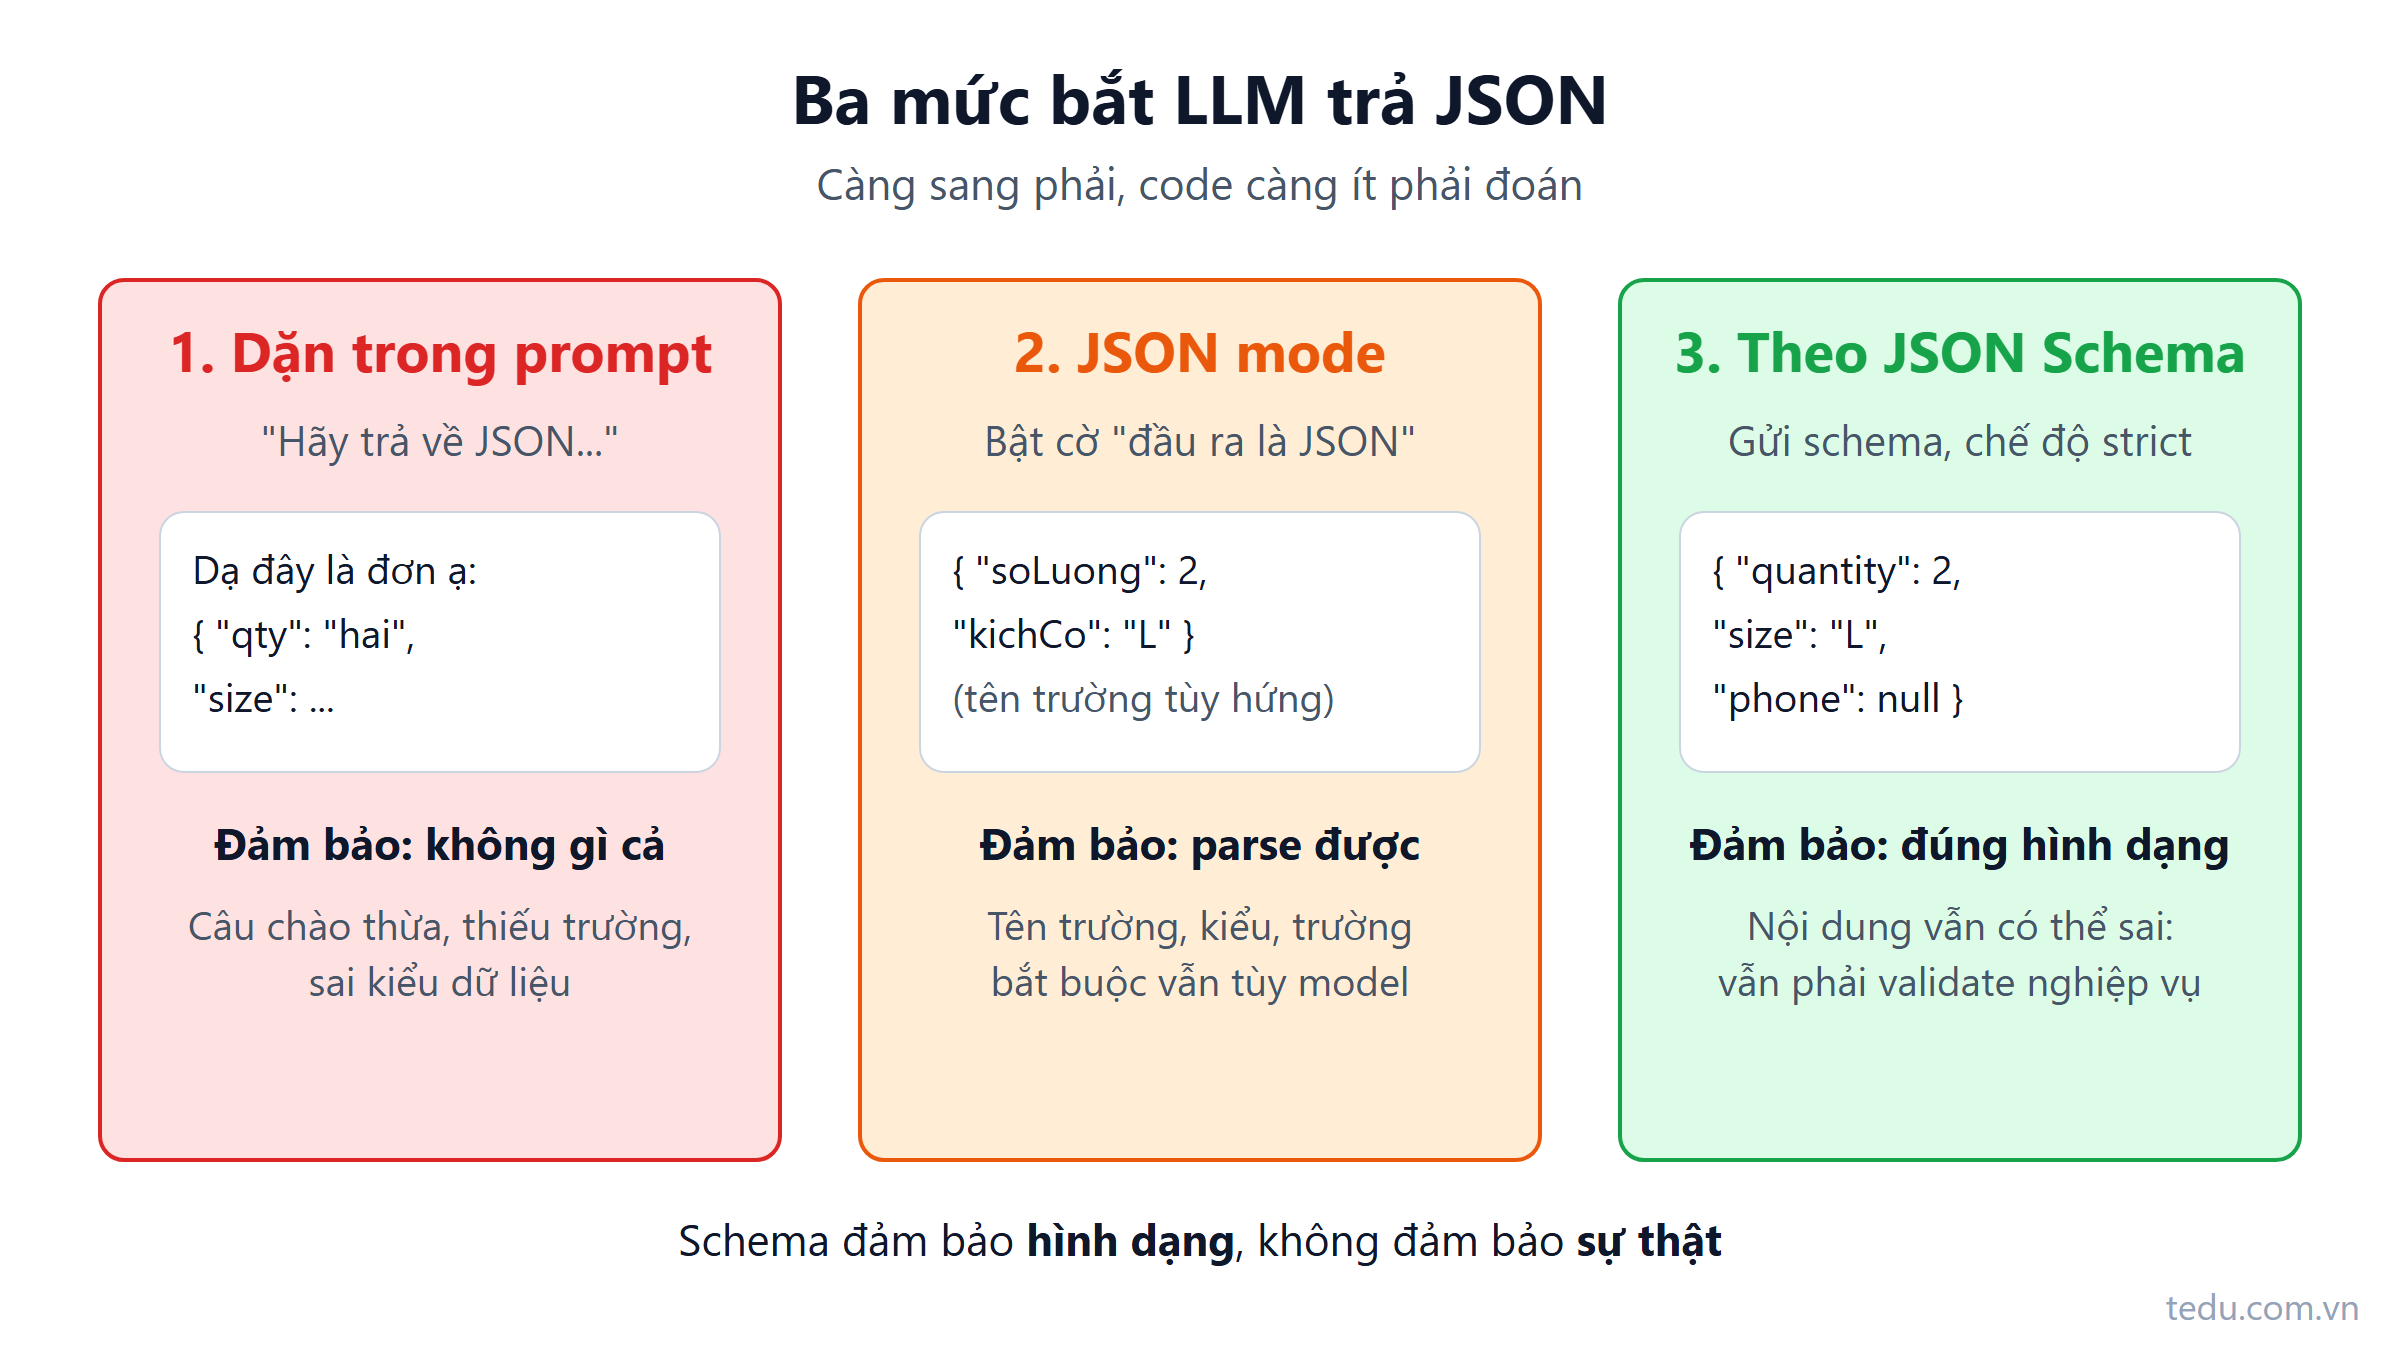
Structured output: bắt LLM trả JSON đúng schema
Structured output giúp LLM trả JSON đúng schema để code đọc được ngay. Bài so sánh 3 cách, kèm ví dụ C# bóc tách đơn hàng từ tin nhắn khách.
Đọc thêm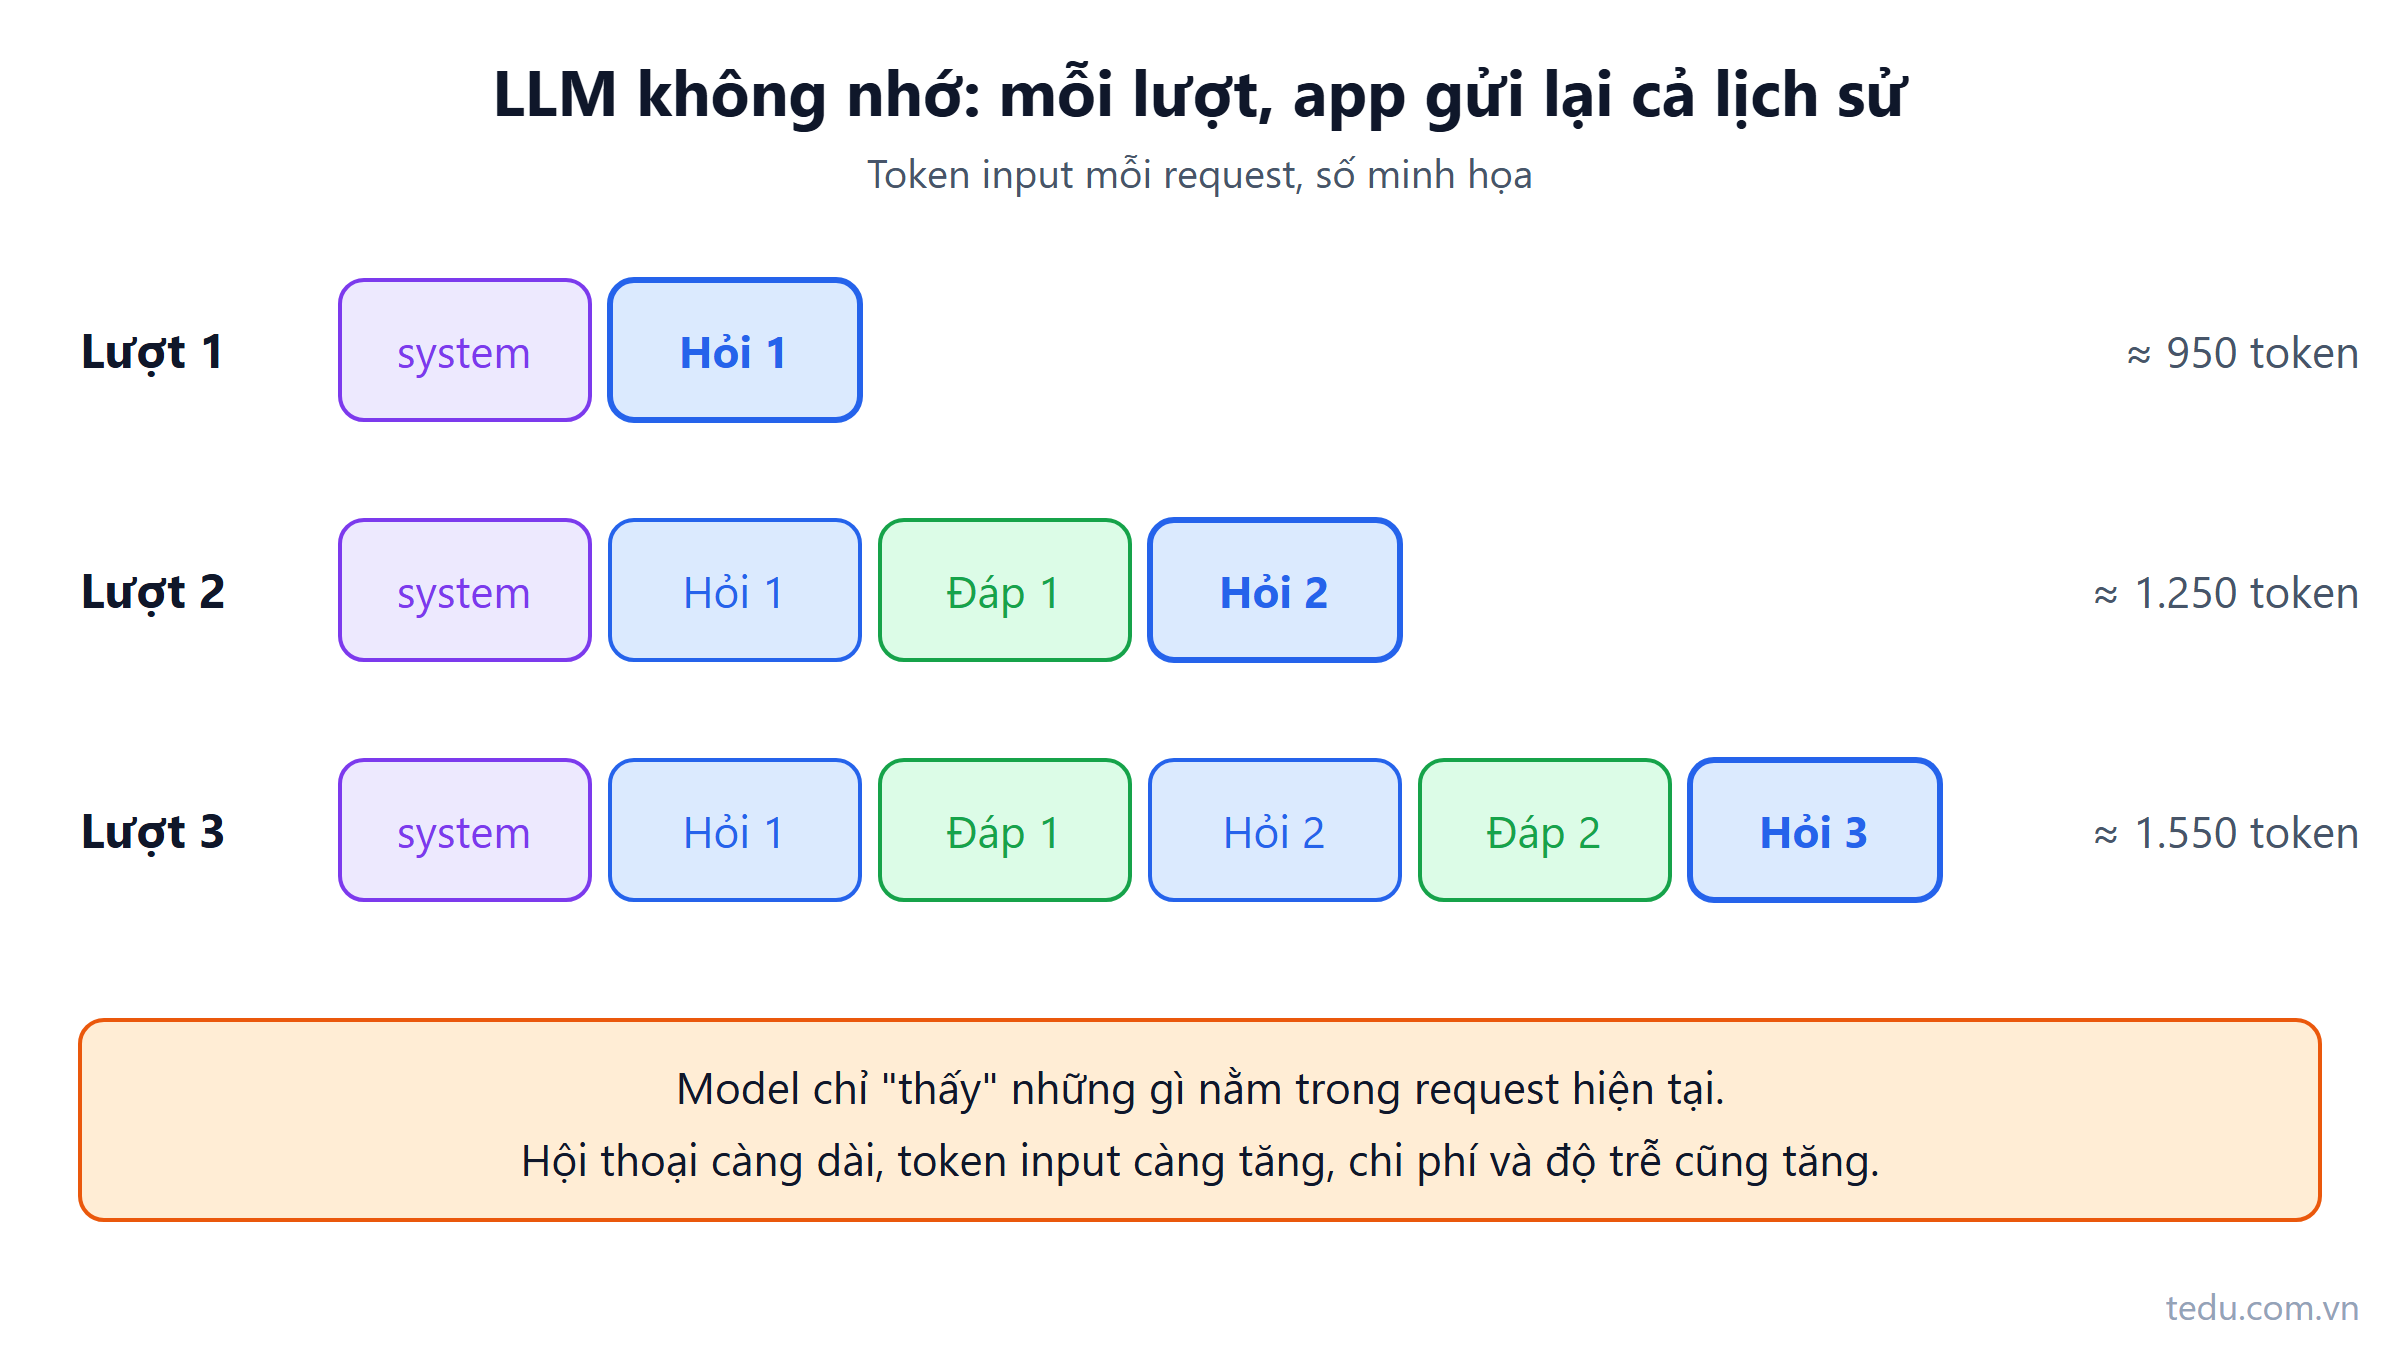
LLM là stateless: "memory" của chatbot thật ra là gửi lại lịch sử
LLM không nhớ gì giữa các request. Chatbot "nhớ" được là vì app gửi lại lịch sử hội thoại. Bài giải thích cơ chế, chi phí token và cách lưu hội thoại đúng trong backend.
Đọc thêm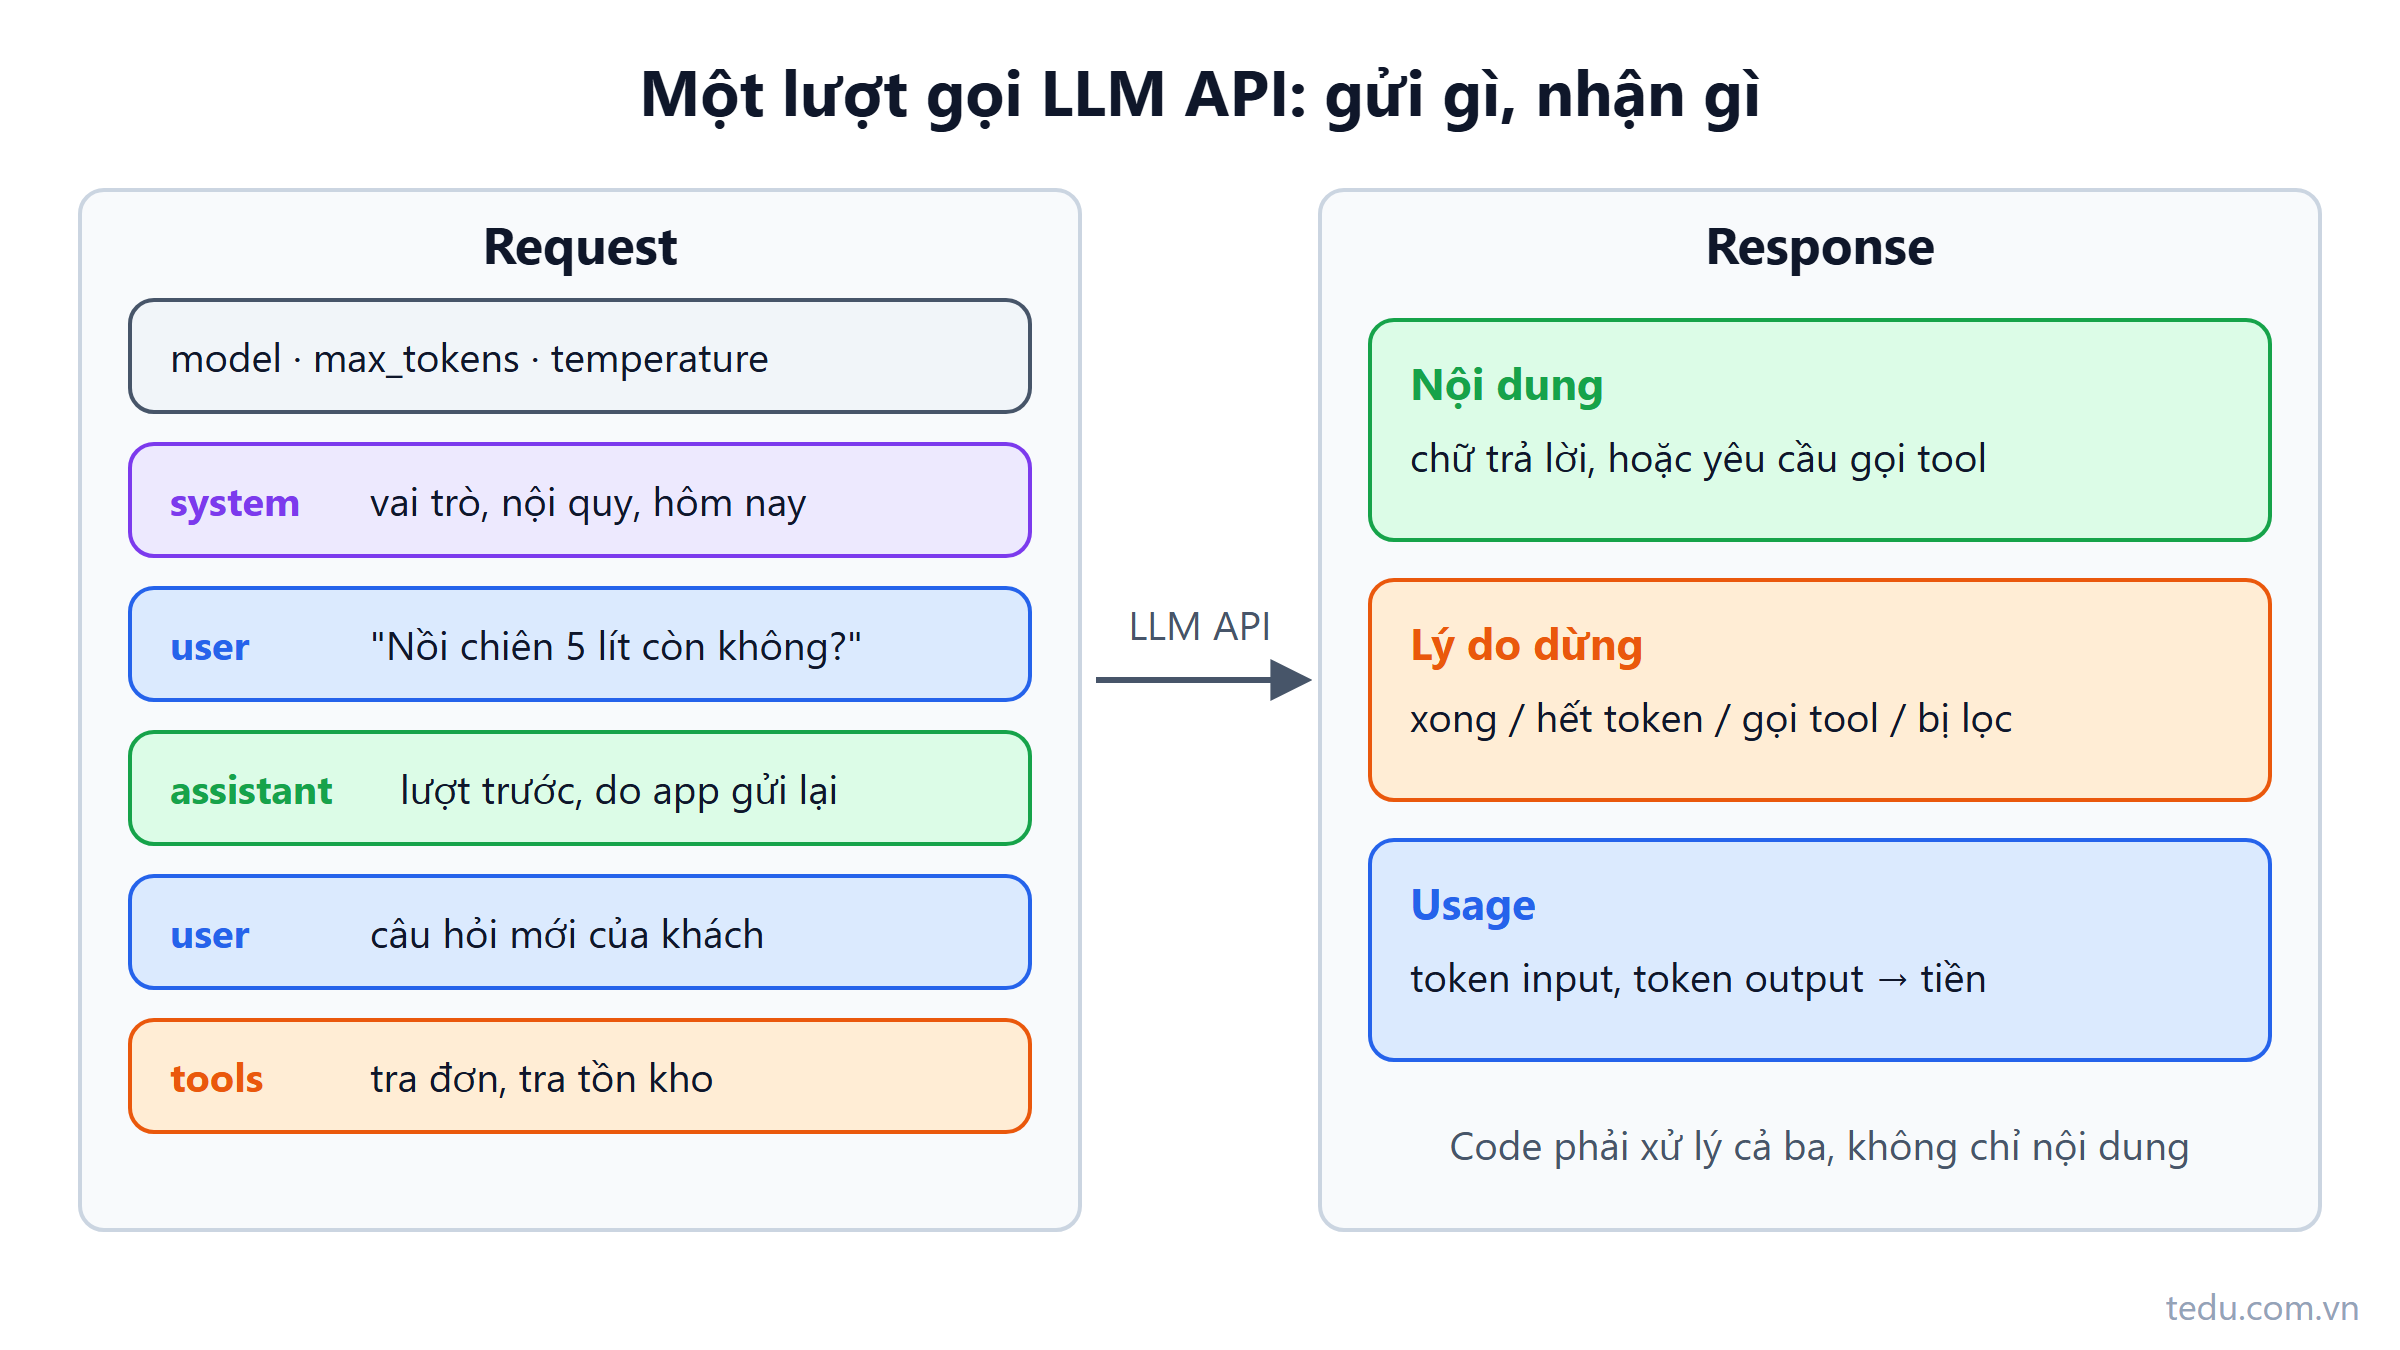
Cấu trúc request gọi LLM API: system, user, assistant gồm những gì
Một request gọi LLM API gồm model, tham số, danh sách message theo vai trò system, user, assistant và có thể có tools. Bài mổ xẻ từng phần kèm code C# gọi HTTP thô.
Đọc thêm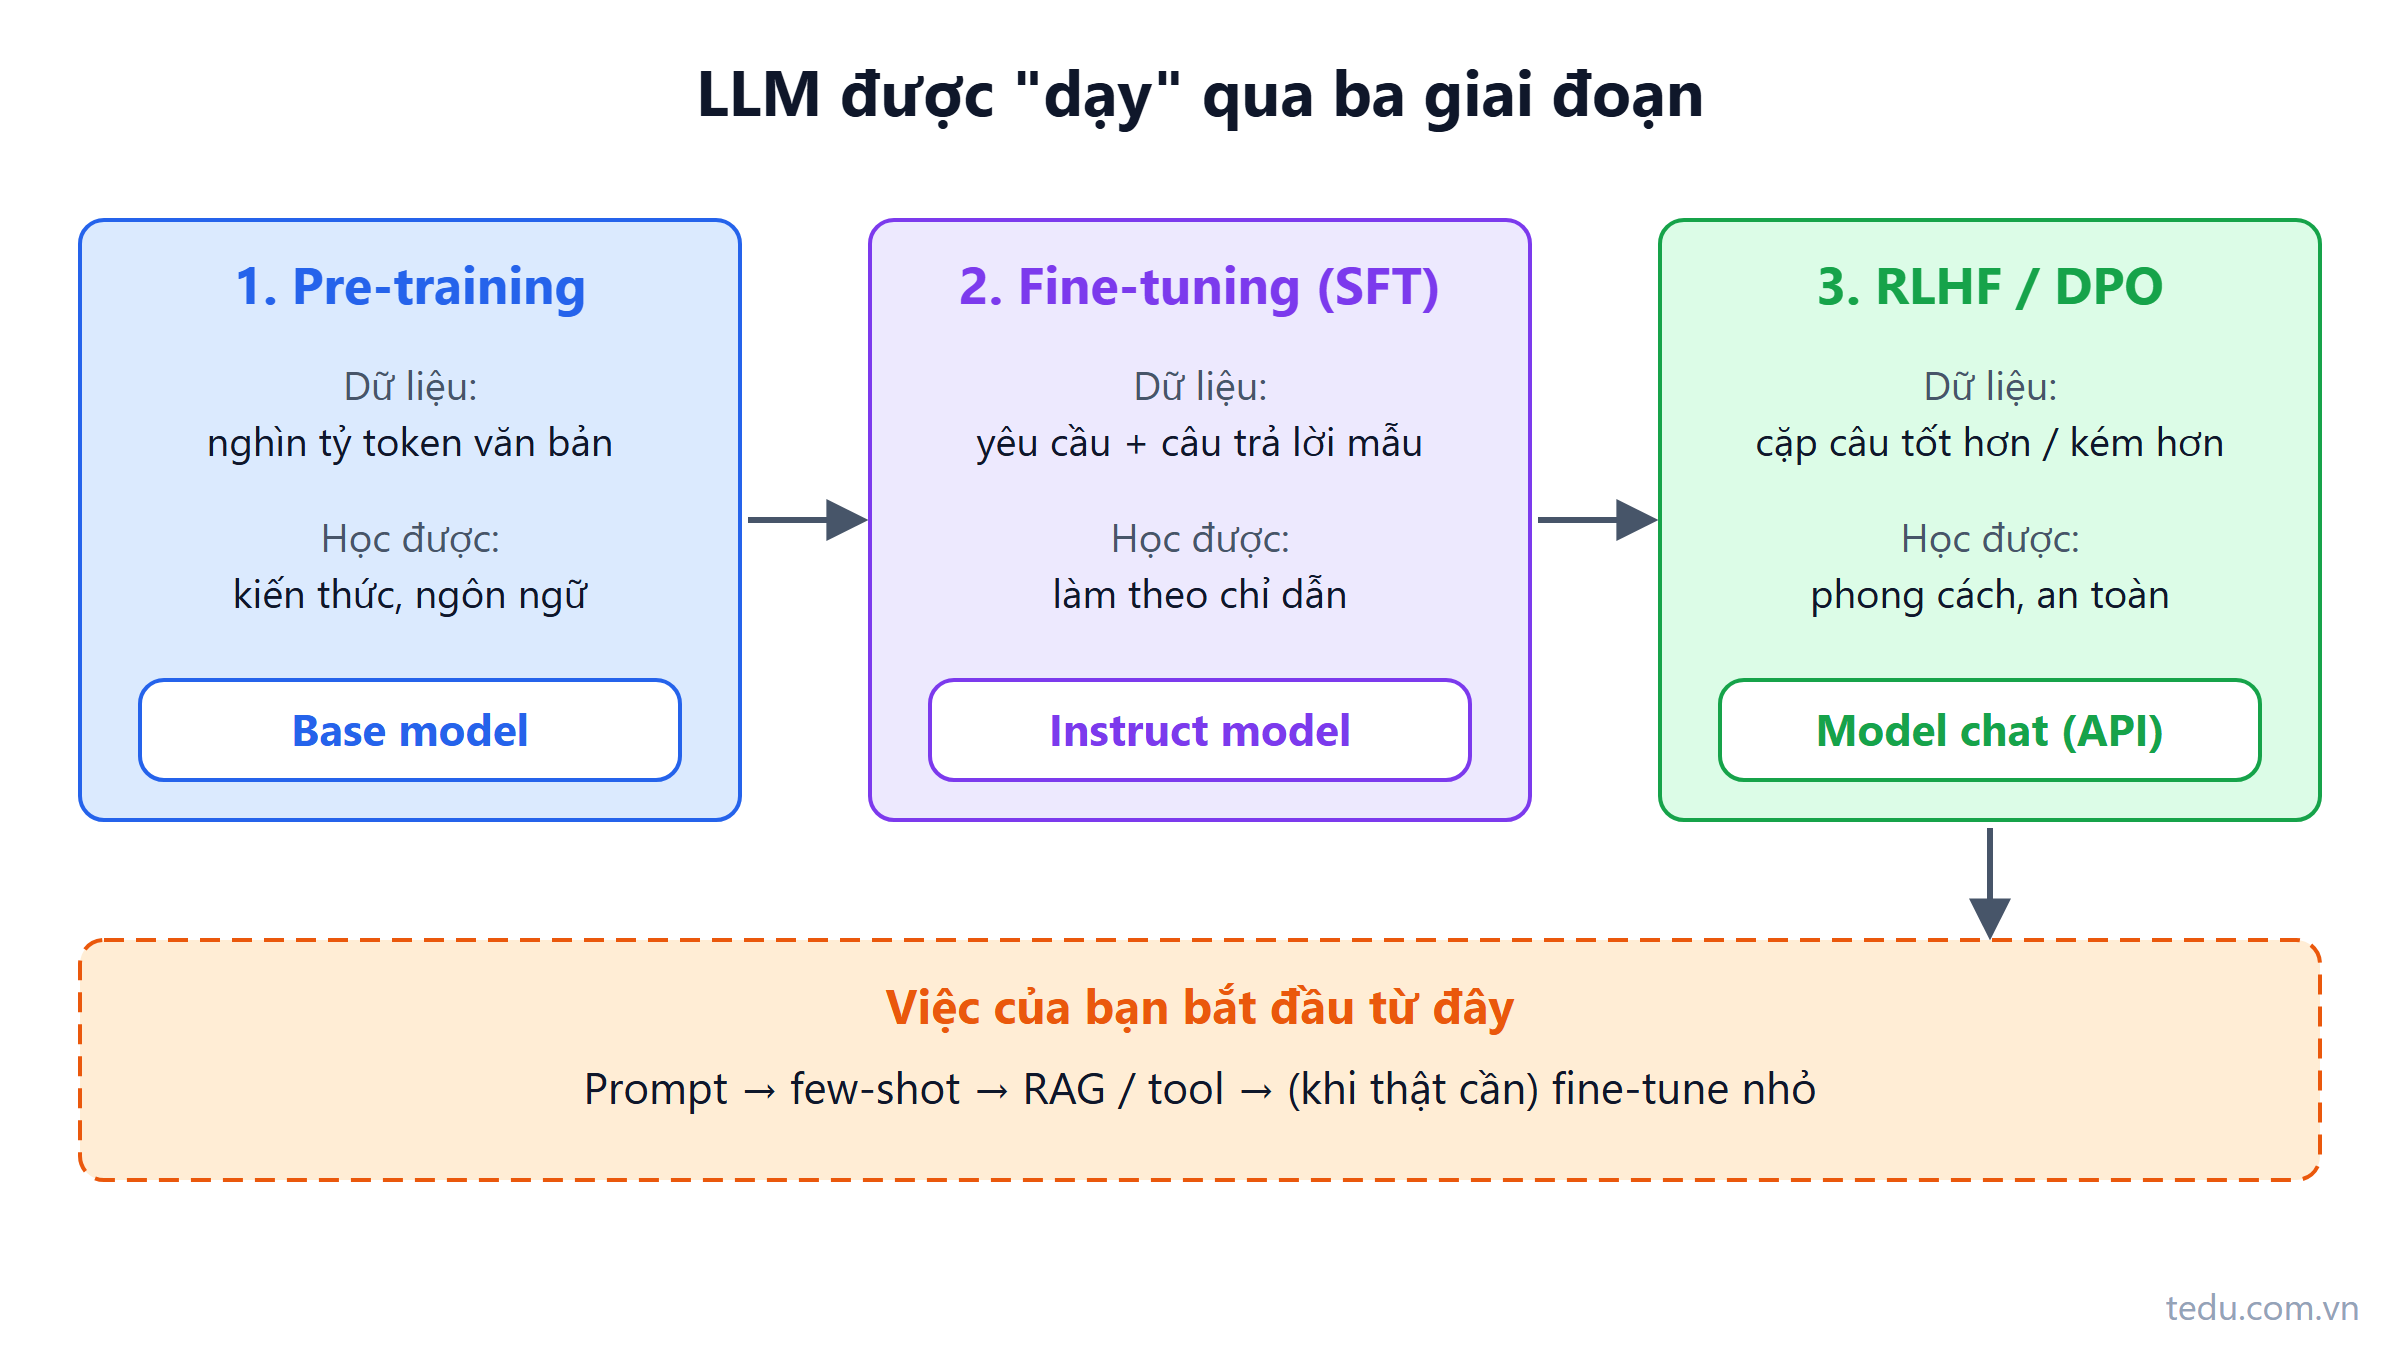
Pre-training, fine-tuning, RLHF: LLM được "dạy" thế nào
LLM đi qua ba giai đoạn huấn luyện: pre-training, fine-tuning theo chỉ dẫn và RLHF. Hiểu từng bước để biết khi nào cần fine-tune, khi nào chỉ cần RAG hoặc prompt.
Đọc thêm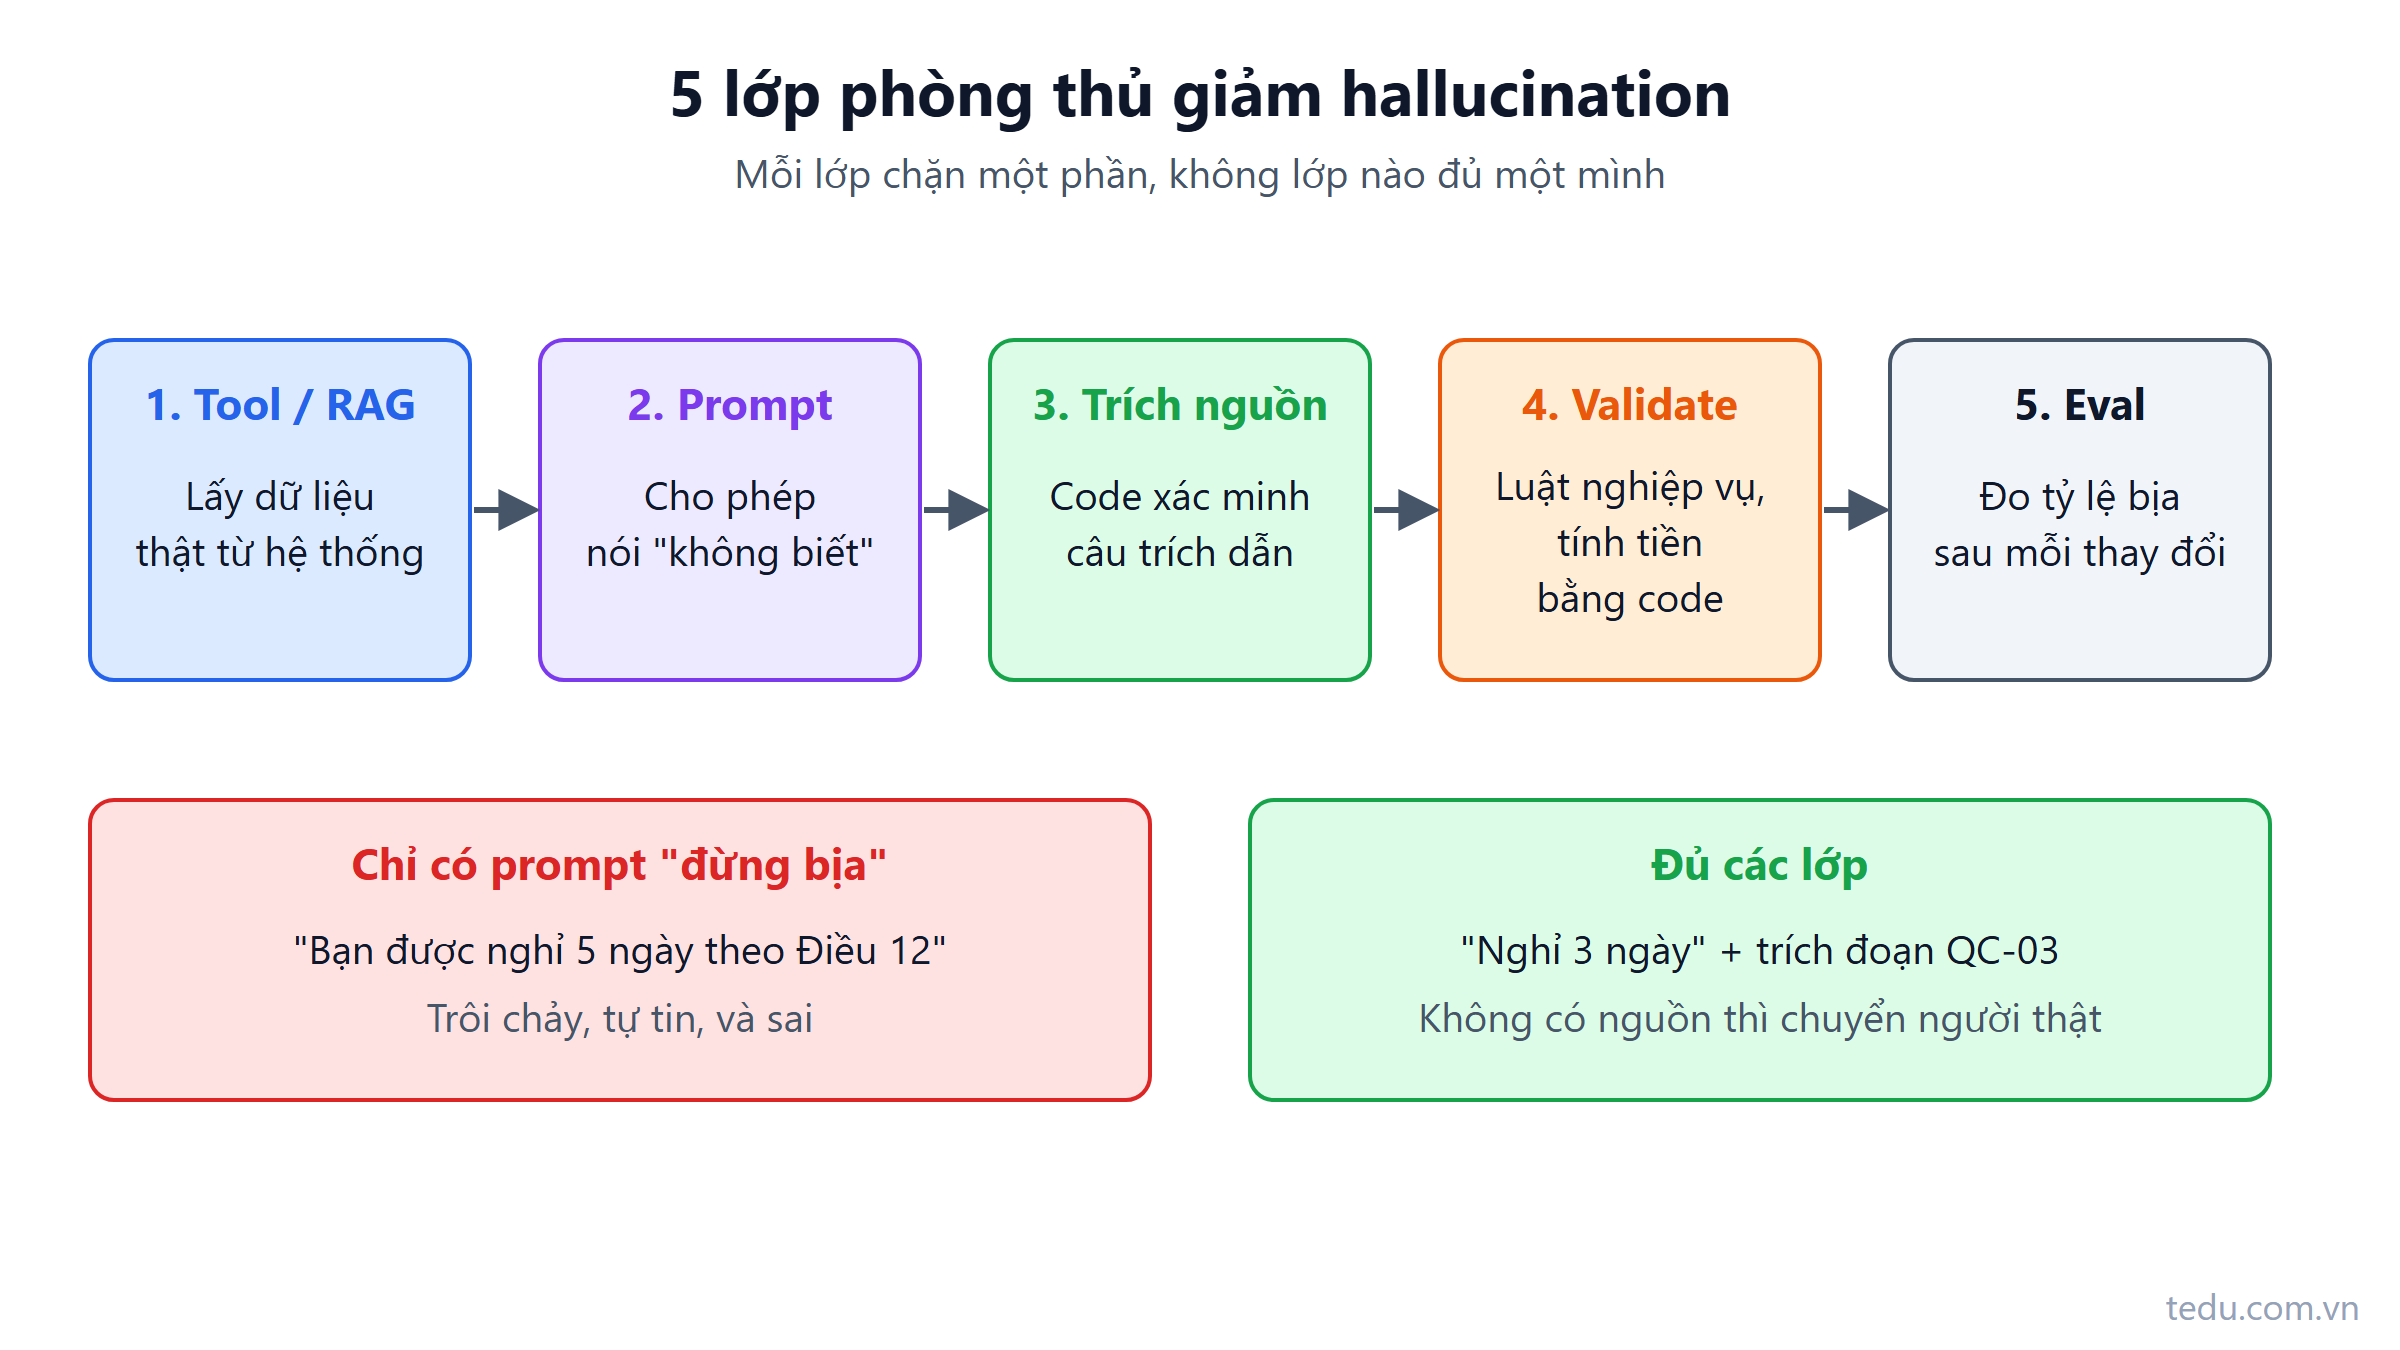
Hallucination là gì? Vì sao model "bịa" và cách hạn chế
Hallucination là khi LLM trả lời trôi chảy nhưng sai sự thật. Bài giải thích vì sao về bản chất model luôn có thể bịa, các dạng hay gặp và cách chặn bằng thiết kế hệ thống.
Đọc thêm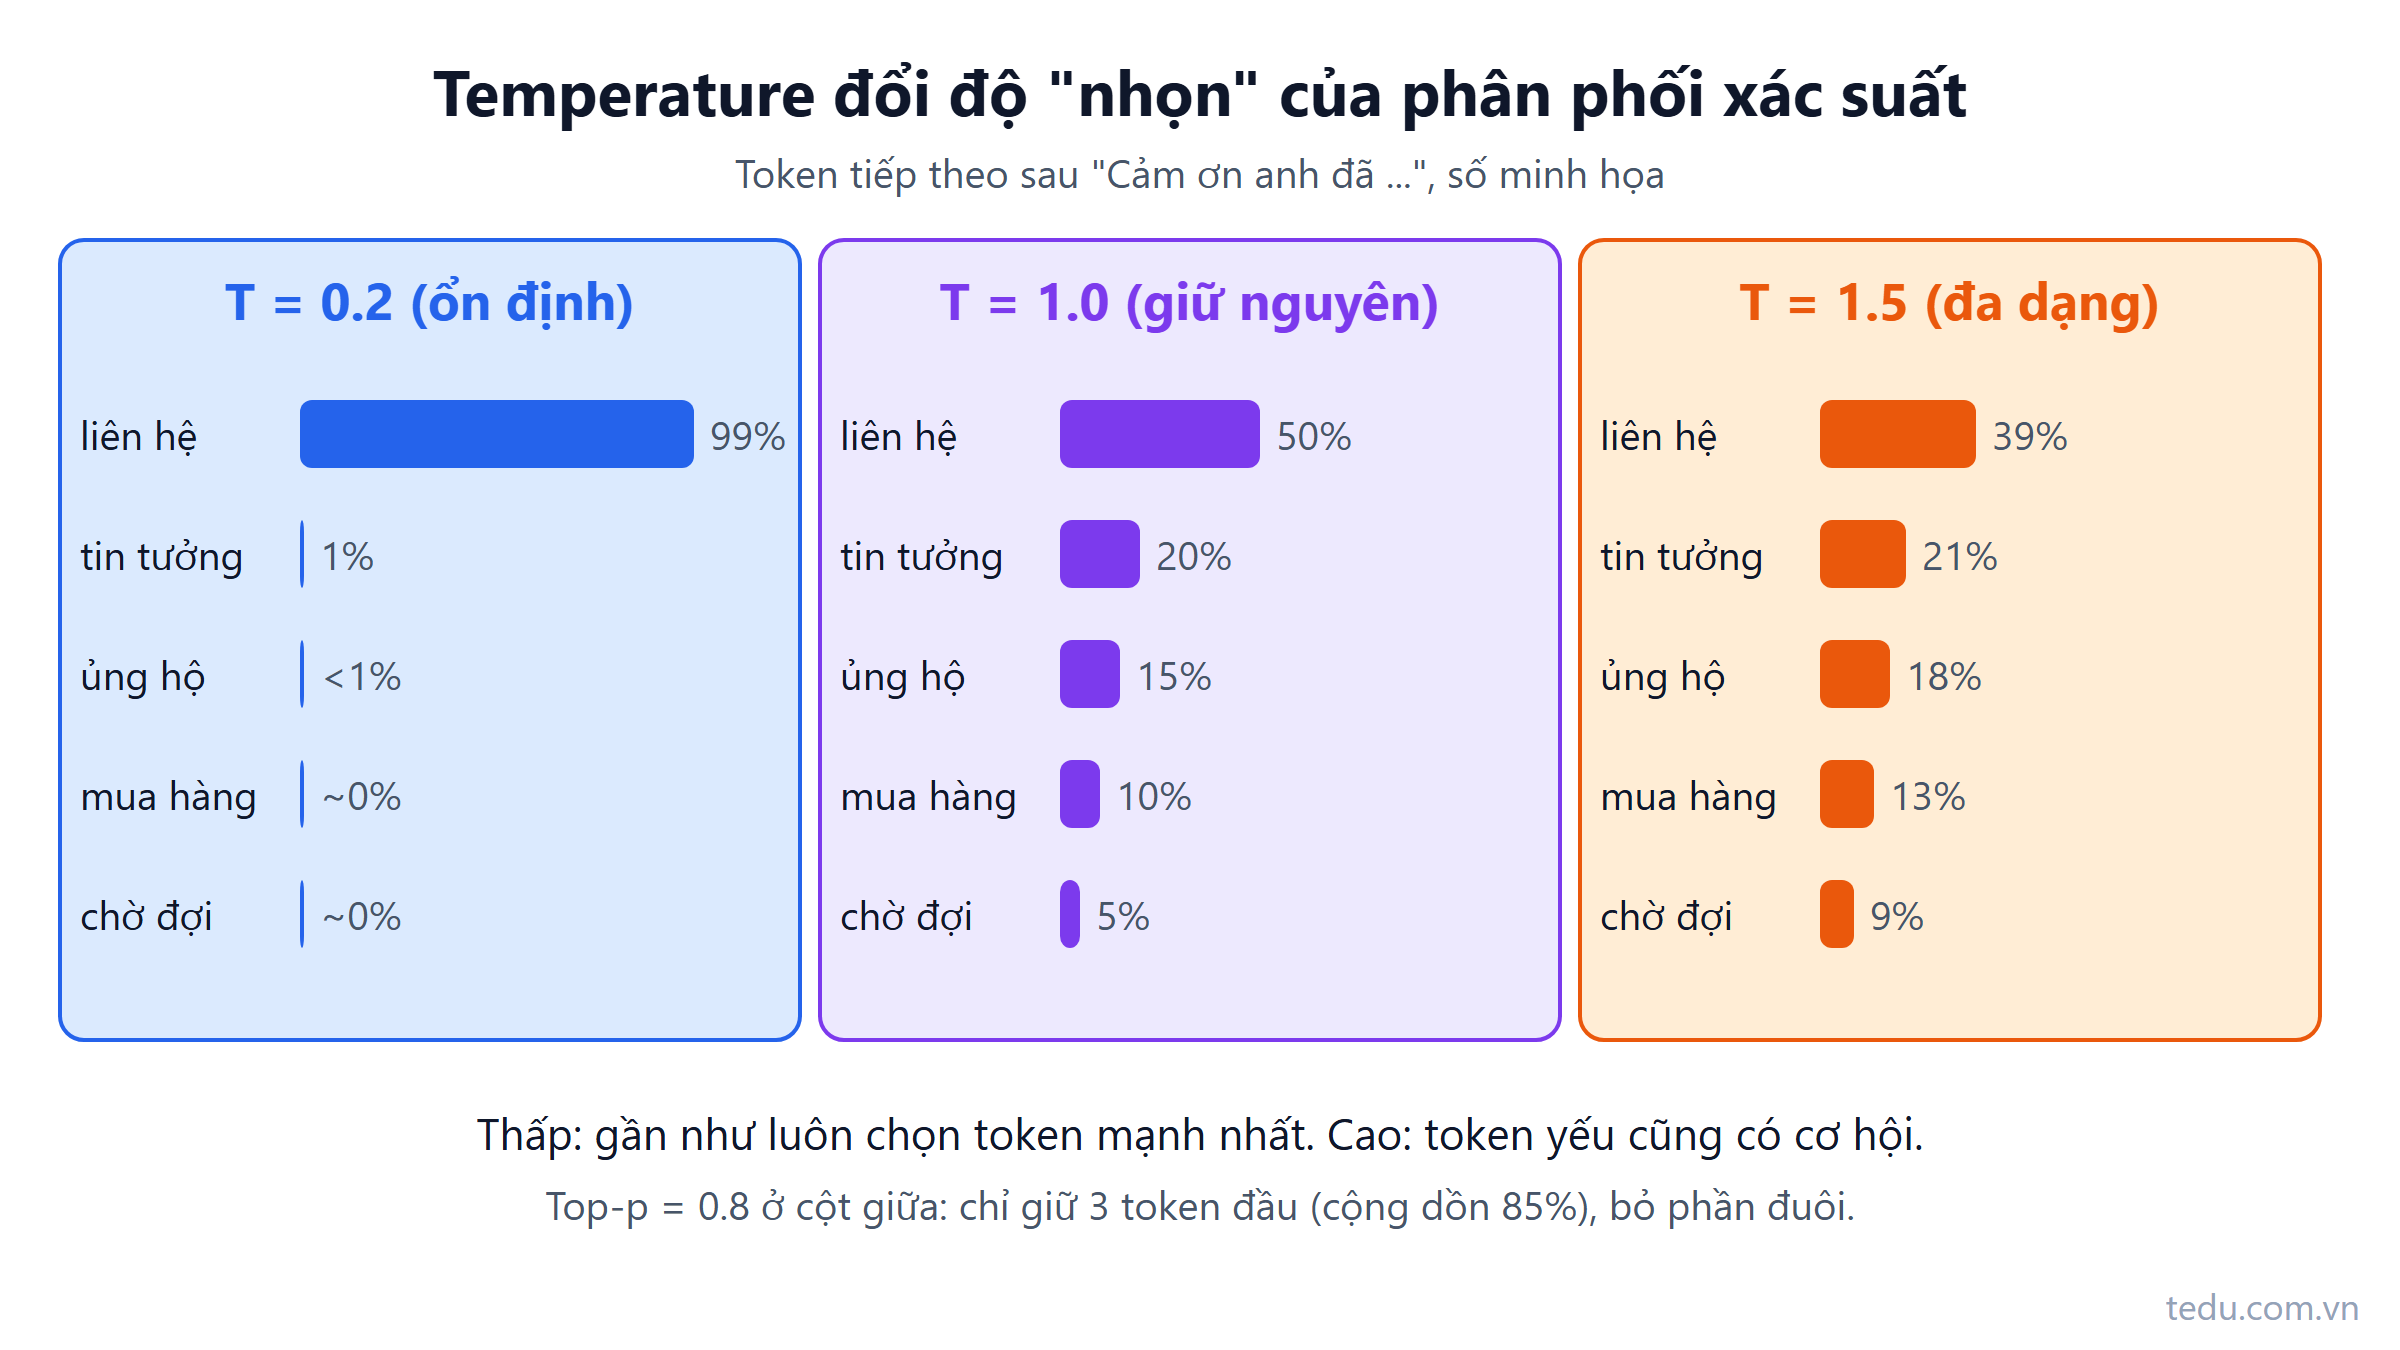
Temperature và top-p là gì? Chỉnh độ sáng tạo của LLM đúng cách
Temperature và top-p quyết định model chọn token tiếp theo an toàn hay phiêu lưu. Bài giải thích cơ chế bằng số cụ thể, code C# mô phỏng và cách chọn theo từng tác vụ.
Đọc thêm