

Streaming LLM: vì sao chữ hiện ra từng chút một
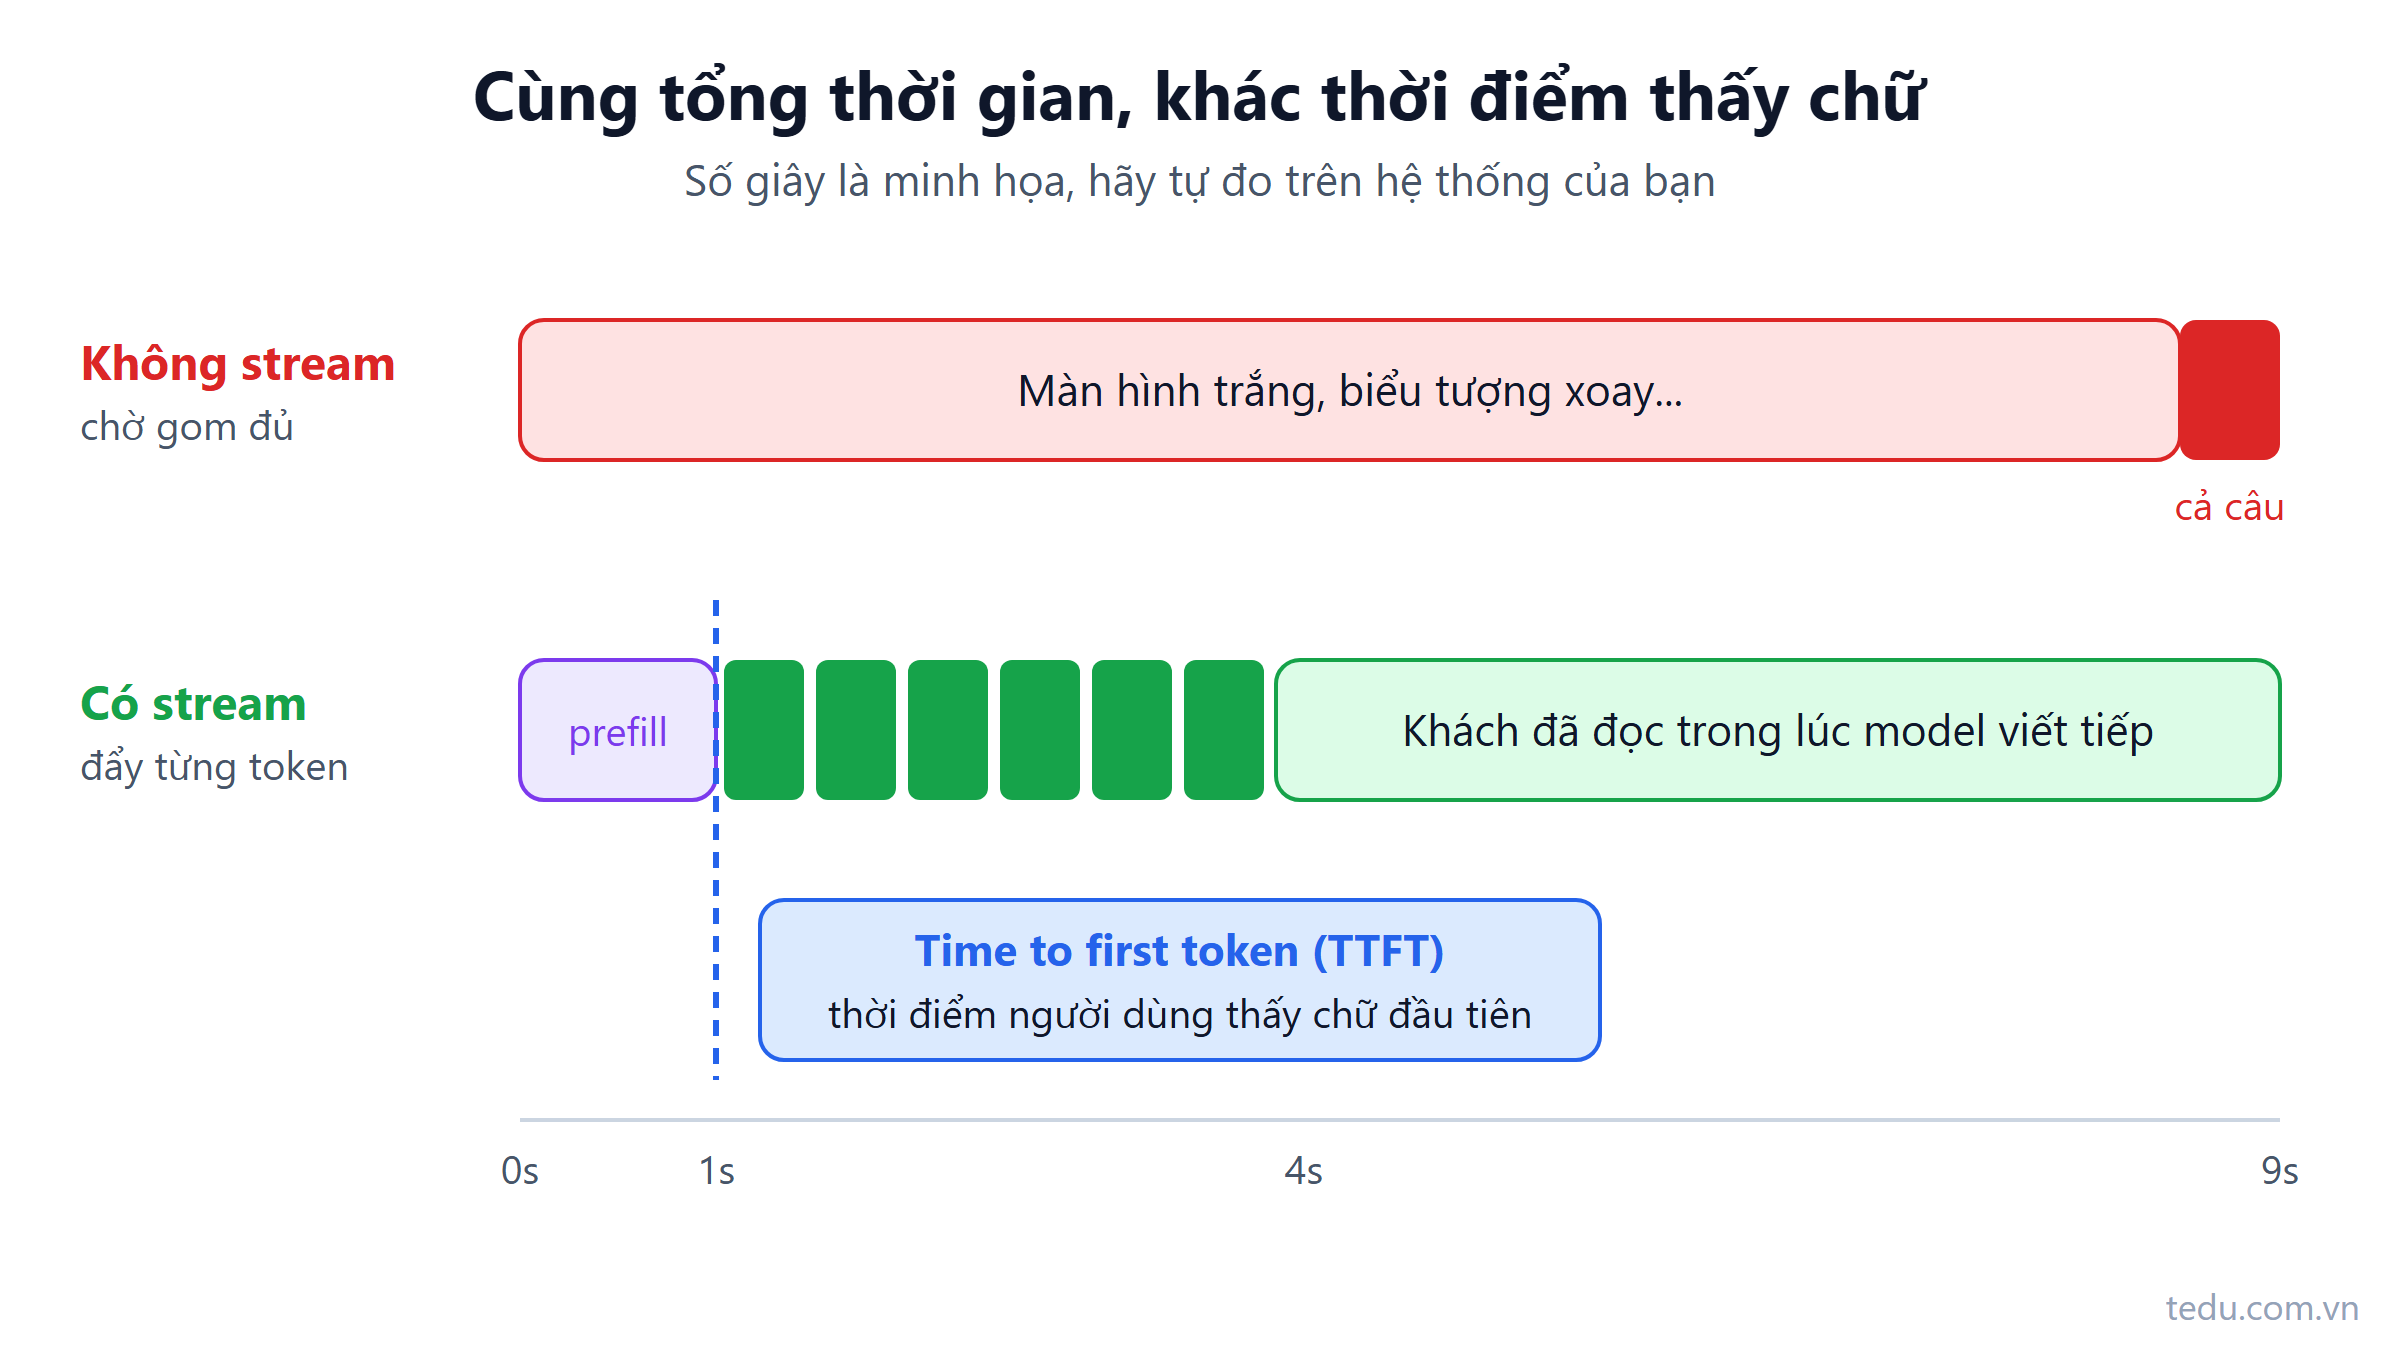
Chatbot CSKH của một shop online chạy ổn trên máy dev. Lên production, khách hỏi "đơn của em bao giờ giao", rồi nhìn biểu tượng xoay xoay suốt 9 giây. Nửa số khách tắt tab trước khi câu trả lời xuất hiện. Ai đó trong team đề xuất "đổi model nhanh hơn". Thực ra tổng thời gian không đổi nhiều. Thứ cần đổi là thời điểm chữ đầu tiên hiện ra.
Đó là việc của streaming LLM: gửi từng mẩu chữ về trình duyệt ngay khi model vừa sinh ra, thay vì chờ sinh xong cả câu trả lời. Bài này giải thích vì sao LLM có thể stream được, dữ liệu stream trông thế nào trên dây, cách làm bằng C# trong ASP.NET Core, và những chỗ streaming làm khó những phần khác của hệ thống.
Vì sao chữ hiện ra từng chút một
Chữ hiện từng chút không phải hiệu ứng gõ phím cho đẹp. Nó phản ánh đúng cách LLM làm việc: model sinh từng token một, token sau dựa trên tất cả token trước. Muốn có token thứ 300, model phải sinh xong 299 token trước đó.
Một request LLM có hai giai đoạn:
| Giai đoạn | Việc model làm | Đặc điểm thời gian |
|---|---|---|
| Đọc đầu vào (prefill) | Xử lý toàn bộ prompt: system prompt, lịch sử, tài liệu, câu hỏi | Chạy song song được, tương đối nhanh, tăng theo độ dài đầu vào |
| Sinh đầu ra (decode) | Sinh từng token, mỗi token là một lượt tính | Tuần tự, tăng gần như tuyến tính theo số token đầu ra |
Không có streaming, server của nhà cung cấp gom đủ toàn bộ đầu ra rồi mới trả một response duy nhất. Có streaming, mỗi token (hoặc vài token gộp lại) được đẩy về ngay. Tổng thời gian gần như như nhau, nhưng trải nghiệm khác hẳn.
Hai con số cần đo: TTFT và tổng thời gian
Khi làm việc với streaming, bạn sẽ gặp hai chỉ số:
Time to first token (TTFT): từ lúc gửi request đến lúc nhận được token đầu tiên. Đây là con số quyết định người dùng có cảm thấy "app đang trả lời" hay không.
Tổng thời gian: đến lúc nhận token cuối. Phụ thuộc chủ yếu vào số token đầu ra và tốc độ sinh của model.
Con số cụ thể thay đổi theo model, nhà cung cấp, giờ cao điểm, độ dài prompt. Đừng tin con số trên blog nào (kể cả bài này), hãy tự đo. Một ví dụ minh họa cho chatbot CSKH ở trên: TTFT khoảng 1 giây, câu trả lời 250 token sinh trong khoảng 8 giây. Không stream: khách nhìn màn hình trắng 9 giây. Có stream: sau 1 giây khách đã đọc được "Dạ, đơn hàng của anh...", và tốc độ chữ hiện ra nhanh hơn tốc độ khách đọc.
Hệ quả thiết kế: muốn giảm TTFT, hãy cắt đầu vào (prompt gọn, ít tài liệu thừa, prompt caching). Muốn giảm tổng thời gian, hãy cắt đầu ra (yêu cầu trả lời ngắn, giới hạn số token đầu ra).
Streaming trên dây: Server-Sent Events
Đa số nhà cung cấp LLM stream qua Server-Sent Events (SSE): một HTTP response với Content-Type: text/event-stream, giữ kết nối mở, mỗi sự kiện là một vài dòng văn bản kết thúc bằng một dòng trống. Dạng chung trông như sau (tên field và kiểu sự kiện khác nhau giữa các nhà cung cấp):
data: {"type":"delta","text":"Dạ, đơn"}

data: {"type":"delta","text":" hàng của anh"}

data: {"type":"delta","text":" đang được giao"}

data: {"type":"done","finish_reason":"stop","usage":{"input_tokens":812,"output_tokens":246}}
Ba điều đáng để ý:
Mỗi sự kiện chỉ chứa phần chữ mới (delta), app phải tự ghép lại.
Một mẩu delta không nhất thiết là một từ trọn vẹn. Nó có thể cắt giữa từ, thậm chí giữa một ký tự tiếng Việt có dấu nếu bạn tự xử lý ở mức byte.
Thông tin số token đã dùng (
usage) thường chỉ có ở sự kiện cuối. Nếu bạn ngắt stream giữa chừng hoặc không đọc sự kiện cuối, log chi phí của bạn sẽ thiếu.
Code C#: đọc stream từ nhà cung cấp và chuyển tiếp cho trình duyệt
Dưới đây là khung đọc SSE bằng HttpClient thuần, để thấy rõ cơ chế. Trong dự án thật, SDK của nhà cung cấp thường đã bọc phần này thành IAsyncEnumerable; tên kiểu và đường dẫn API ở đây mang tính minh họa:
public async IAsyncEnumerable<string> StreamAsync(
    object requestBody,
    [EnumeratorCancellation] CancellationToken ct)
{
    using var req = new HttpRequestMessage(HttpMethod.Post, "v1/chat")
    {
        Content = JsonContent.Create(requestBody)   // body có "stream": true
    };

    // Quan trọng: không chờ đọc hết body
    using var res = await http.SendAsync(req, HttpCompletionOption.ResponseHeadersRead, ct);
    res.EnsureSuccessStatusCode();

    using var reader = new StreamReader(await res.Content.ReadAsStreamAsync(ct));

    while (await reader.ReadLineAsync(ct) is { } line)
    {
        if (!line.StartsWith("data: ")) continue;

        var evt = JsonSerializer.Deserialize<StreamEvent>(line["data: ".Length..])!;
        if (evt.Type == "delta") yield return evt.Text!;
        if (evt.Type == "done") { usageLogger.Record(evt.Usage); yield break; }
    }
}
Chi tiết dễ bỏ sót là HttpCompletionOption.ResponseHeadersRead. Mặc định HttpClient đọc hết body vào bộ nhớ rồi mới trả về, tức là bạn bật streaming phía nhà cung cấp nhưng lại tự tắt nó ở phía mình.
Phía ASP.NET Core, chuyển tiếp xuống trình duyệt cũng bằng SSE:
app.MapPost("/chat", async (ChatRequest body, HttpContext ctx, LlmClient llm) =>
{
    ctx.Response.ContentType = "text/event-stream";
    ctx.Response.Headers.CacheControl = "no-cache";
    ctx.Response.Headers["X-Accel-Buffering"] = "no";   // báo nginx đừng gom

    var ct = ctx.RequestAborted;   // khách đóng tab thì dừng luôn
    await foreach (var chunk in llm.StreamAsync(BuildRequest(body), ct))
    {
        var payload = JsonSerializer.Serialize(new { text = chunk });
        await ctx.Response.WriteAsync($"data: {payload}\n\n", ct);
        await ctx.Response.Body.FlushAsync(ct);
    }
});
.NET 10 có thêm kiểu kết quả dựng sẵn cho Server-Sent Events trong Minimal API; hãy kiểm tra tài liệu ASP.NET Core bản bạn dùng nếu muốn gọn hơn cách ghi tay ở trên. Ghi tay vẫn đáng biết, vì khi có lỗi bạn hiểu chuyện gì đang xảy ra trên dây.
ctx.RequestAborted cũng đáng một dòng giải thích: khi khách đóng tab, token hủy được kích hoạt, vòng lặp dừng, kết nối tới nhà cung cấp được đóng. Việc nhà cung cấp có tính tiền phần token đã sinh sau thời điểm đó hay không tùy từng nơi, nhưng ít nhất bạn không giữ tài nguyên server cho một người đã bỏ đi.
Những chỗ streaming làm khó bạn
Streaming đẹp cho người dùng nhưng làm phức tạp nhiều thứ phía sau. Đây là những chỗ hay vấp:
| Vấn đề | Vì sao | Cách xử lý |
|---|---|---|
| Chạy local thì stream, lên server thì chữ hiện một cục | Reverse proxy (nginx), CDN hoặc middleware nén gom response lại | Tắt buffering cho route stream (proxy_buffering off hoặc header X-Accel-Buffering: no), tắt nén cho text/event-stream |
| Tool call bị chia nhỏ | Khi stream, tham số JSON của tool call cũng đến từng mẩu | Gom đủ mẩu đến khi tool call kết thúc rồi mới parse; không parse từng mẩu |
| Structured output khó dùng | JSON dở dang không parse được | Với đầu ra cho code đọc, thường không cần stream; nếu cần hiển thị dần, dùng parser chịu được JSON chưa đóng |
| Không chặn được nội dung xấu kịp thời | Chữ đã đến tay người dùng trước khi bạn kiểm tra cả câu | Kiểm tra theo từng đoạn câu, hoặc giữ lại một chút trước khi đẩy; nội dung rủi ro cao thì đừng stream |
| Thiếu log chi phí | Số token chỉ có ở sự kiện cuối | Luôn xử lý sự kiện kết thúc, ghi log cả khi stream bị ngắt |
| Lỗi giữa chừng | Header 200 đã gửi đi, không đổi status code được nữa | Gửi một sự kiện lỗi riêng để frontend hiển thị "thử lại" |
| Lưu lịch sử chat | Câu trả lời chỉ có đầy đủ khi stream xong | Ghép chuỗi trong lúc stream, lưu DB khi kết thúc (kể cả khi bị ngắt) |
Mục cuối liên quan trực tiếp đến bài LLM là stateless: lượt hỏi tiếp theo phải gửi lại câu trả lời này trong lịch sử. Nếu bạn quên lưu bản đã ghép, lượt sau model sẽ "quên" mình vừa nói gì.
Khi nào nên stream, khi nào không
Không phải request LLM nào cũng cần stream. Quy tắc đơn giản: có người đang nhìn màn hình chờ thì stream; code chờ thì không.
| Tình huống | Stream? | Lý do |
|---|---|---|
| Chatbot CSKH, trợ lý hỏi đáp quy chế nội bộ | Có | Người dùng đang chờ, TTFT quyết định trải nghiệm |
| Viết nháp email, tóm tắt tài liệu dài hiển thị cho người đọc | Có | Đọc được phần đầu trong khi phần sau đang sinh |
| Bóc tách đơn hàng thành JSON để tạo đơn | Không | Code cần JSON hoàn chỉnh, xem bài structured output |
| Phân loại ticket chạy nền, batch hàng nghìn bản ghi | Không | Không ai nhìn, stream chỉ thêm phức tạp |
| Agent gọi nhiều tool trước khi trả lời | Tùy | Stream câu trả lời cuối; các bước trung gian có thể hiển thị trạng thái "đang tra đơn hàng..." |
Dòng cuối là mẹo trải nghiệm hay bị bỏ qua. Khi agent mất 5 giây để gọi tool tra đơn, gửi một sự kiện trạng thái ngắn ("Đang kiểm tra đơn hàng...") cho người dùng biết hệ thống không treo. Cảm giác chờ giảm đi rõ rệt, dù thời gian thật không đổi giây nào. Tâm lý học xếp hàng áp dụng cho cả chatbot.
Checklist triển khai streaming
Bật
streamtrong request tới nhà cung cấp và đọc bằngResponseHeadersRead(hoặc API stream của SDK).Trả
text/event-stream,Cache-Control: no-cache, flush sau mỗi sự kiện.Tắt buffering ở nginx, CDN và nén response cho route stream; test trên môi trường giống production.
Truyền
RequestAbortedxuyên suốt để dừng khi người dùng bỏ đi.Ghép toàn bộ câu trả lời để lưu lịch sử và log, kể cả khi stream bị ngắt.
Đọc sự kiện cuối để ghi số token, phục vụ theo dõi chi phí.
Có sự kiện lỗi riêng; frontend hiển thị được trạng thái lỗi giữa chừng.
Đo TTFT và tổng thời gian ở p50 và p95, không chỉ đo trung bình.
Kết luận
Streaming không làm model nhanh hơn. Nó chỉ cho người dùng thấy kết quả ngay khi có, vì LLM vốn sinh từng token một. Với dev backend, phần khó không nằm ở việc bật cờ stream, mà ở mọi thứ xung quanh: proxy gom response, tool call bị chia mẩu, log chi phí, lưu lịch sử, và kiểm duyệt nội dung khi chữ đã ra khỏi server.
Bước tiếp theo: đo TTFT của chatbot bạn đang làm, rồi thử bật streaming sau nginx thật để xem chữ có hiện từng chút không. Bài kế tiếp trong series nói về tool calling: model không tự chạy code, app của bạn chạy.
Xem bản tóm tắt dưới một phút trên YouTube @teduco hoặc TikTok @teducolabs, và đọc thêm các bài khác trong chuyên mục AI cho Backend Developer.
Bài viết liên quan
Context engineering là gì, vì sao quan trọng hơn prompt
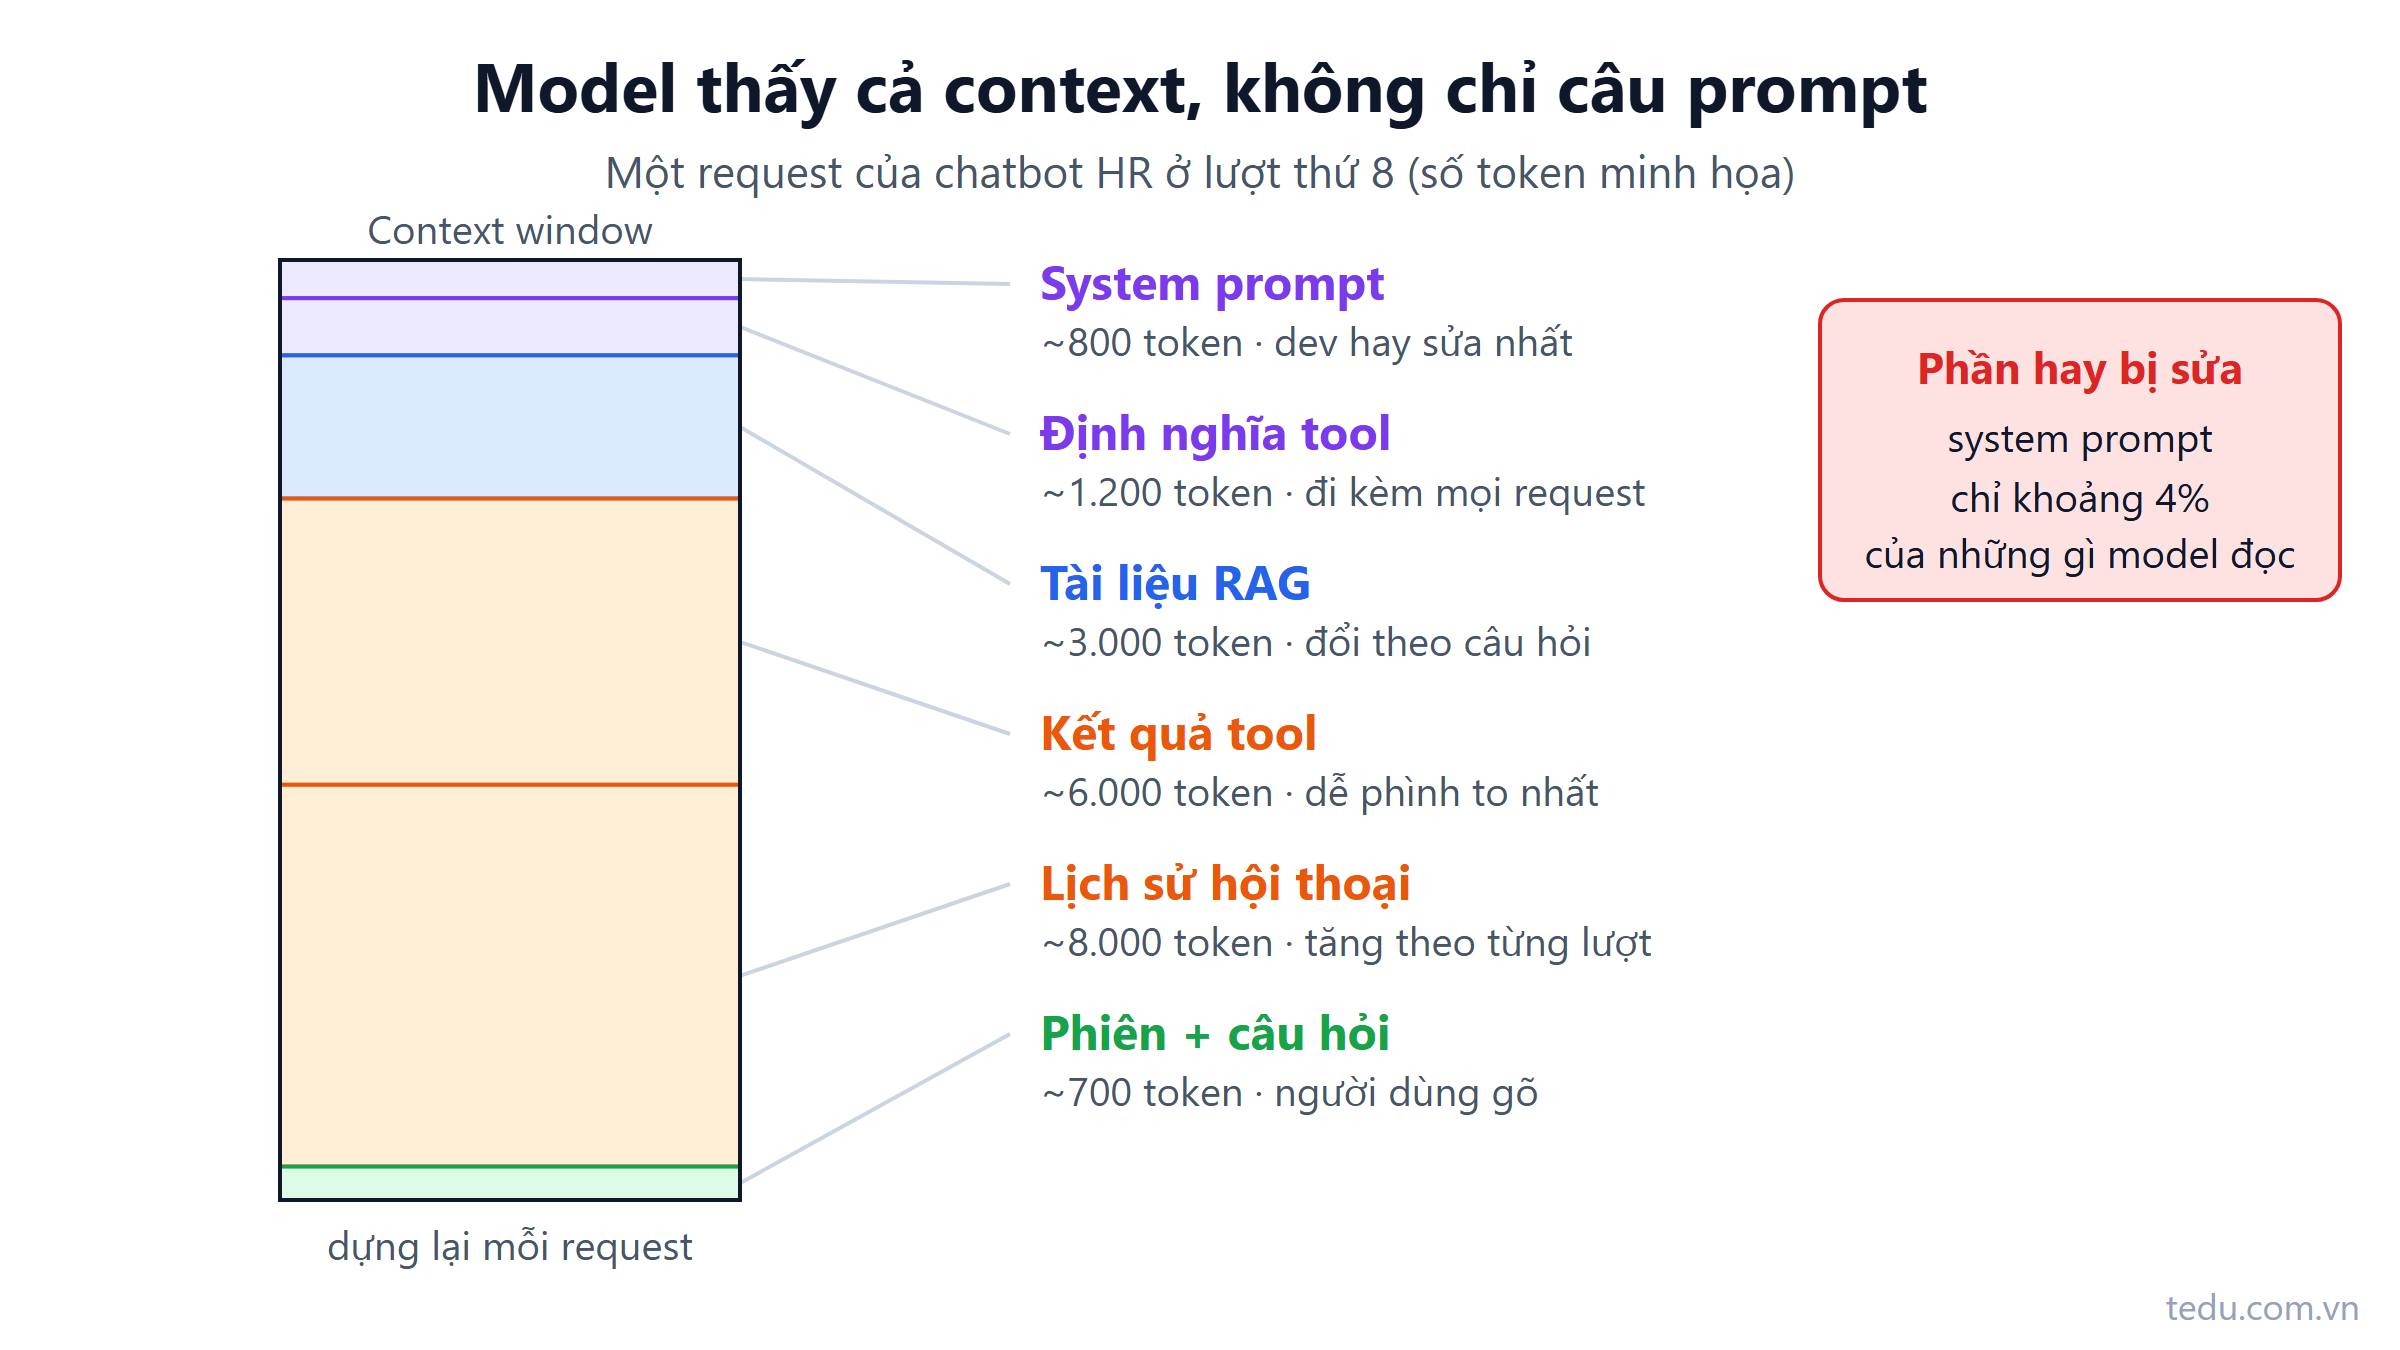
Context engineering là quyết định cái gì vào context window, cái gì phải ra, theo thứ tự nào. Câu prompt chỉ là một phần nhỏ của những gì model thấy.
Đọc thêm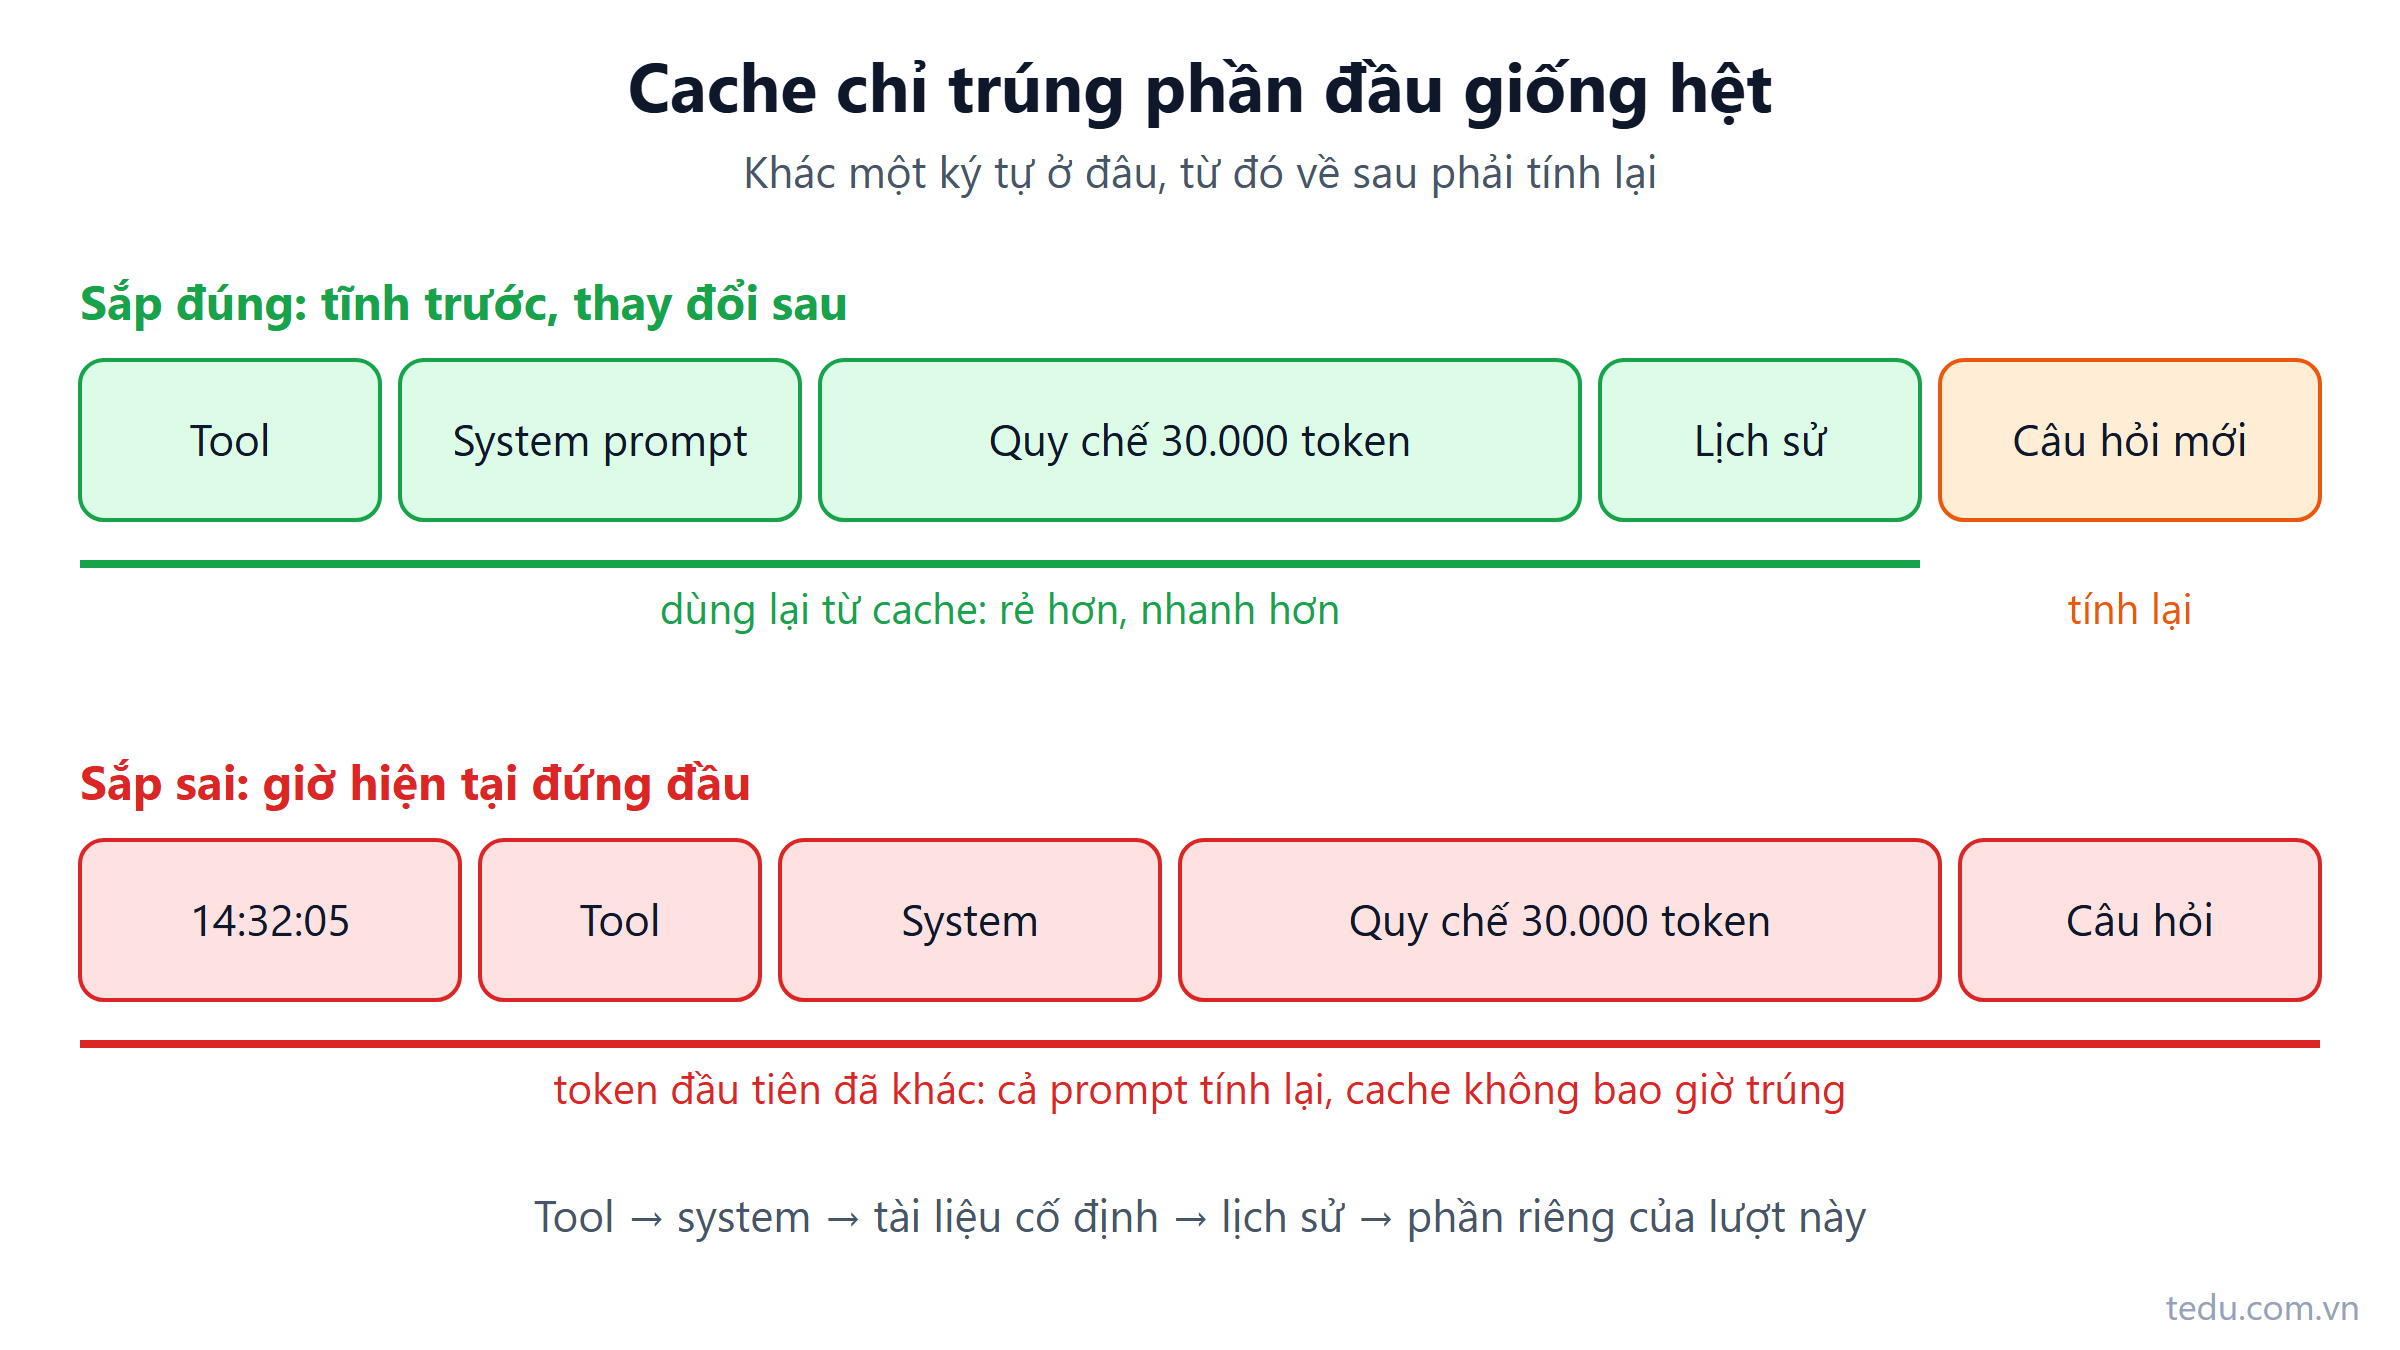
Prompt caching là gì? Cắt chi phí và độ trễ cho LLM
Prompt caching cho phép nhà cung cấp LLM dùng lại phần đầu prompt đã xử lý, giảm chi phí và độ trễ. Bài giải thích cơ chế prefix và cách sắp prompt.
Đọc thêm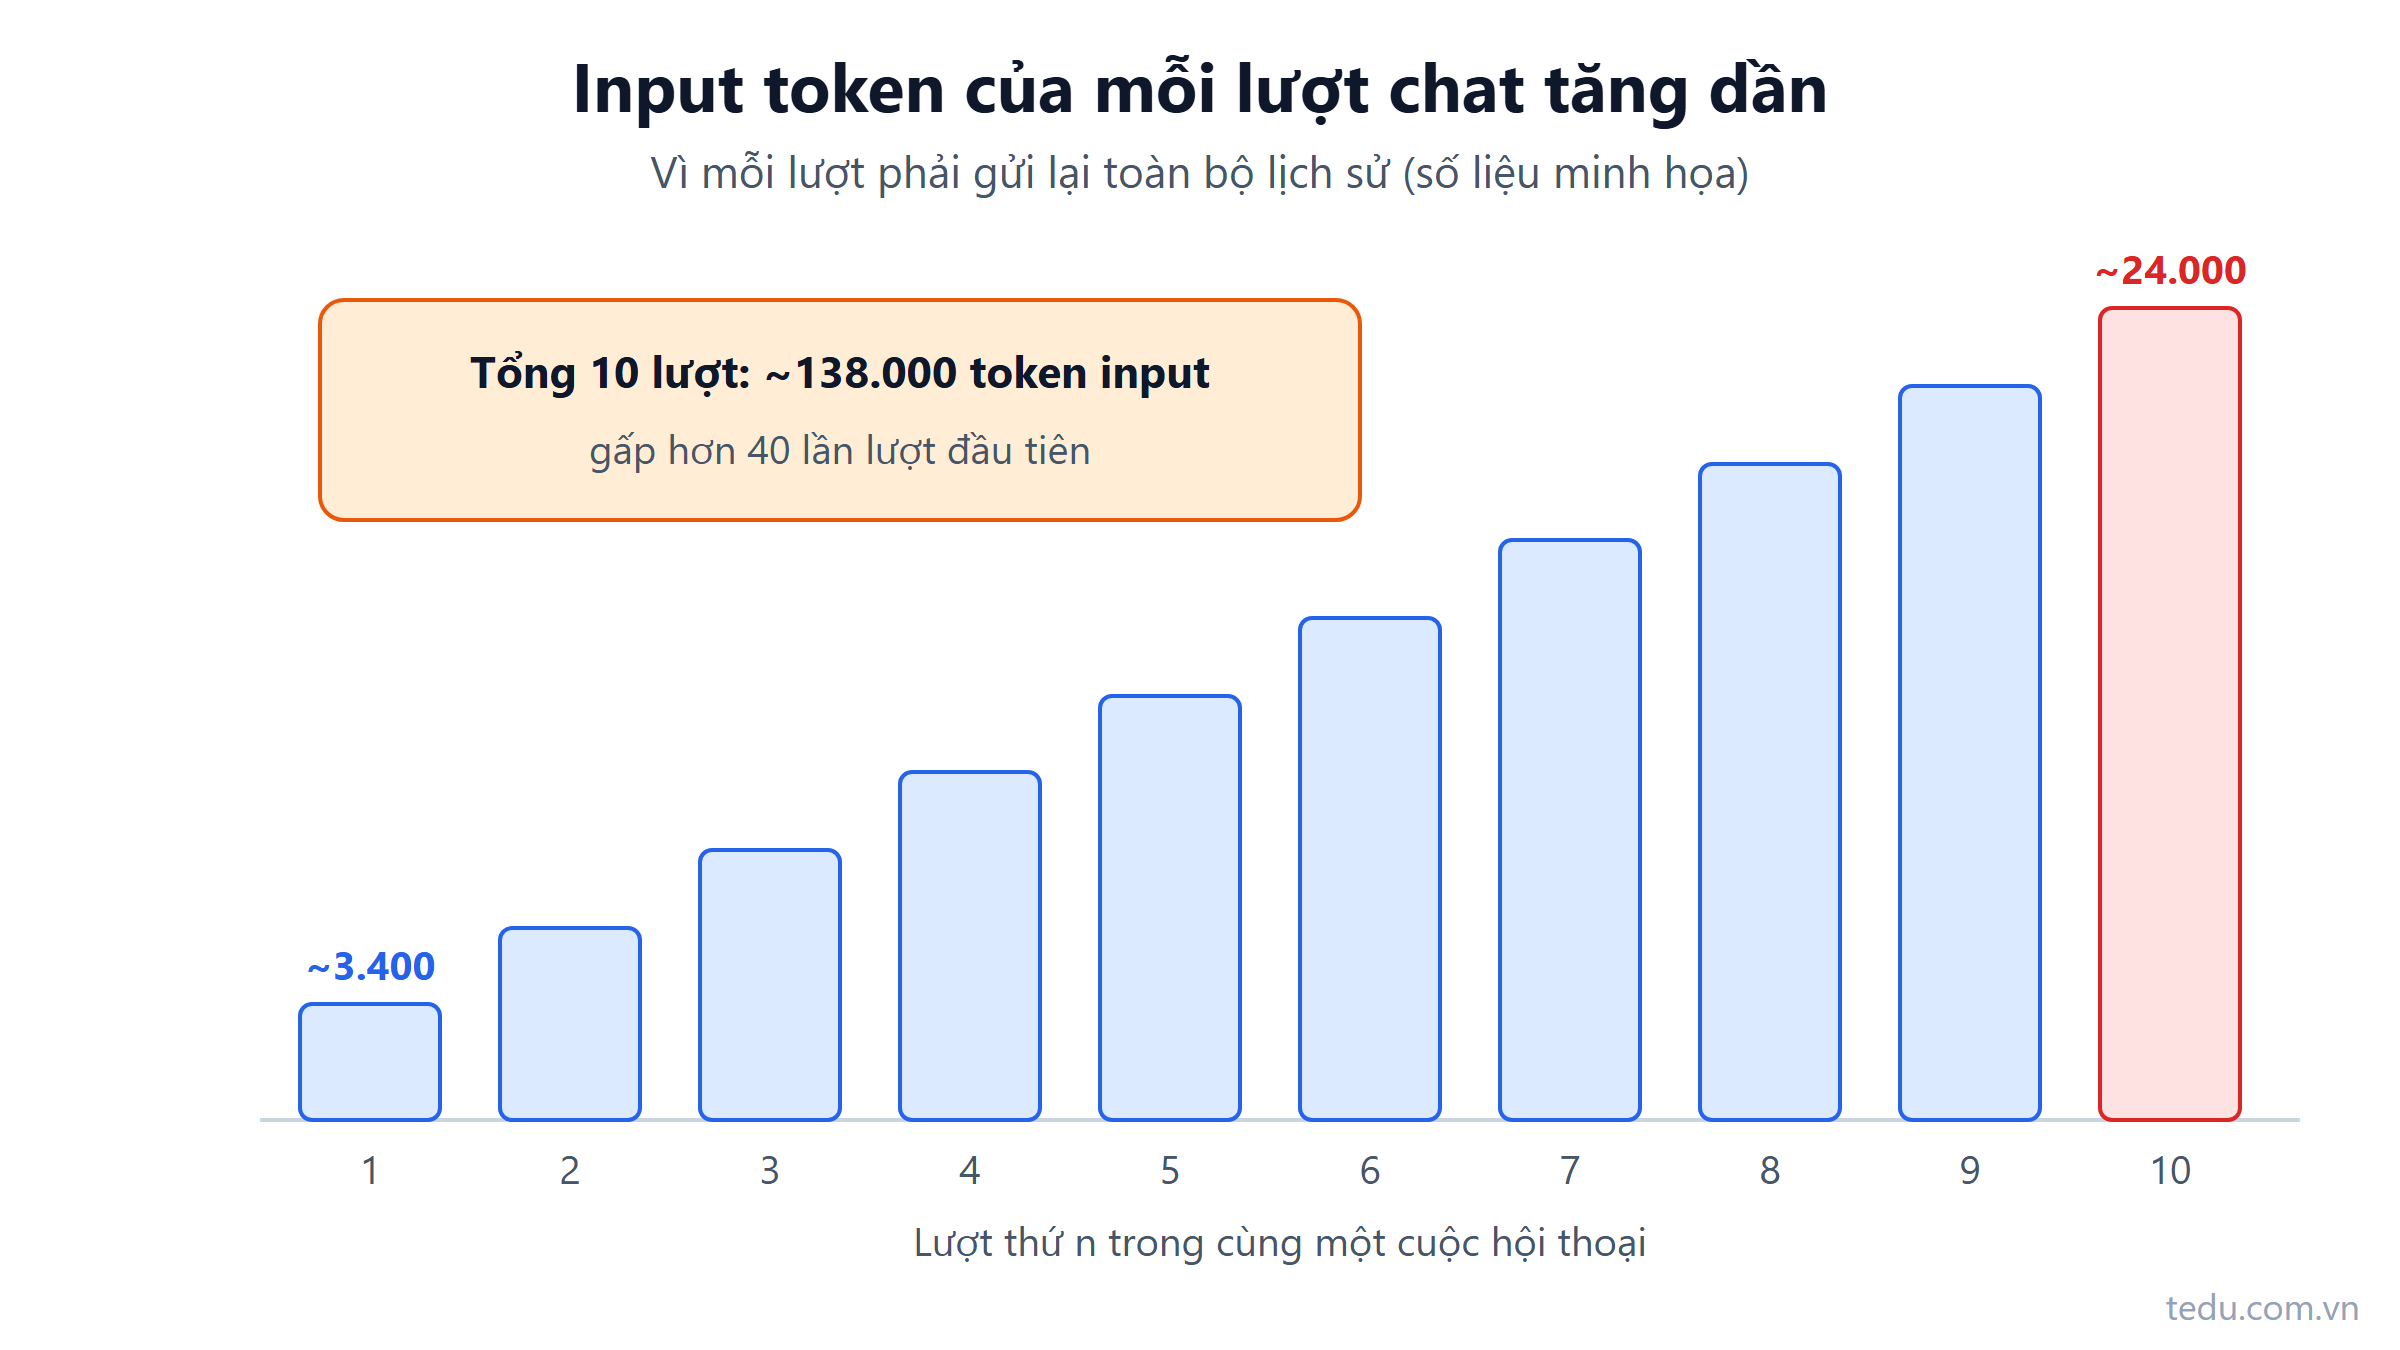
Chi phí LLM theo token: vì sao input và output giá khác nhau
Chi phí LLM tính theo token, input và output giá khác nhau. Bài hướng dẫn tự tính chi phí một chatbot, chỉ ra các khoản ẩn và cách cắt giảm.
Đọc thêm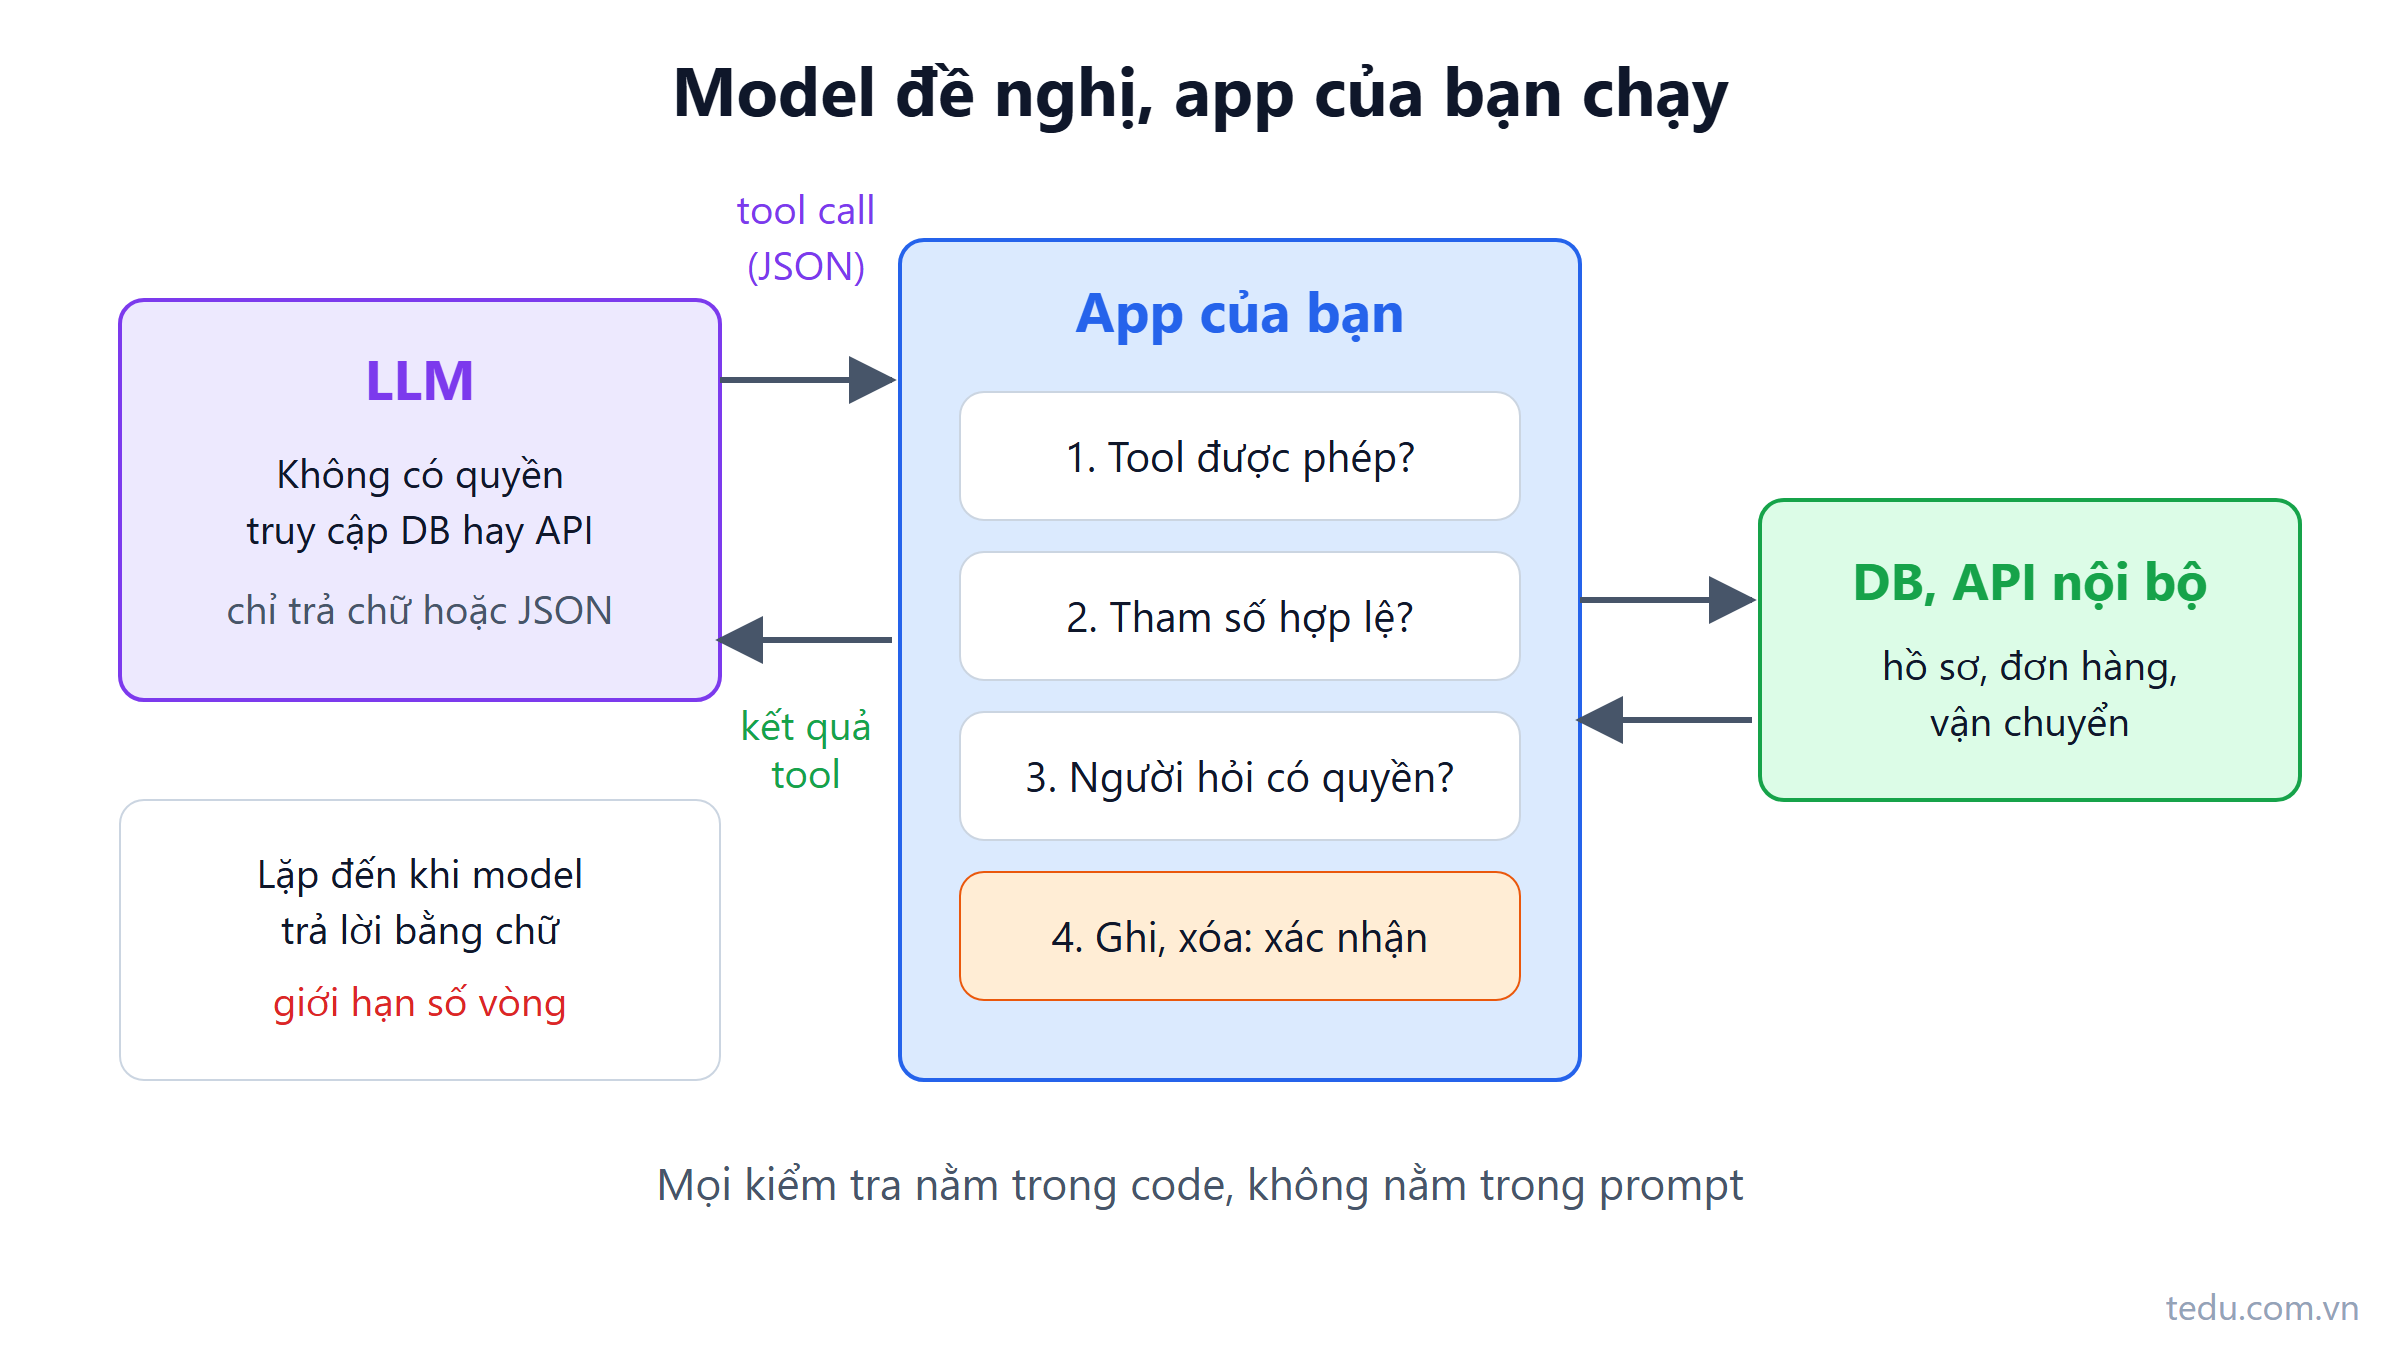
Function calling: model không tự chạy code
Function calling (tool calling) là model đề nghị gọi hàm bằng JSON, còn app của bạn validate, phân quyền và chạy. Ví dụ C# tra cứu hồ sơ, đơn hàng.
Đọc thêm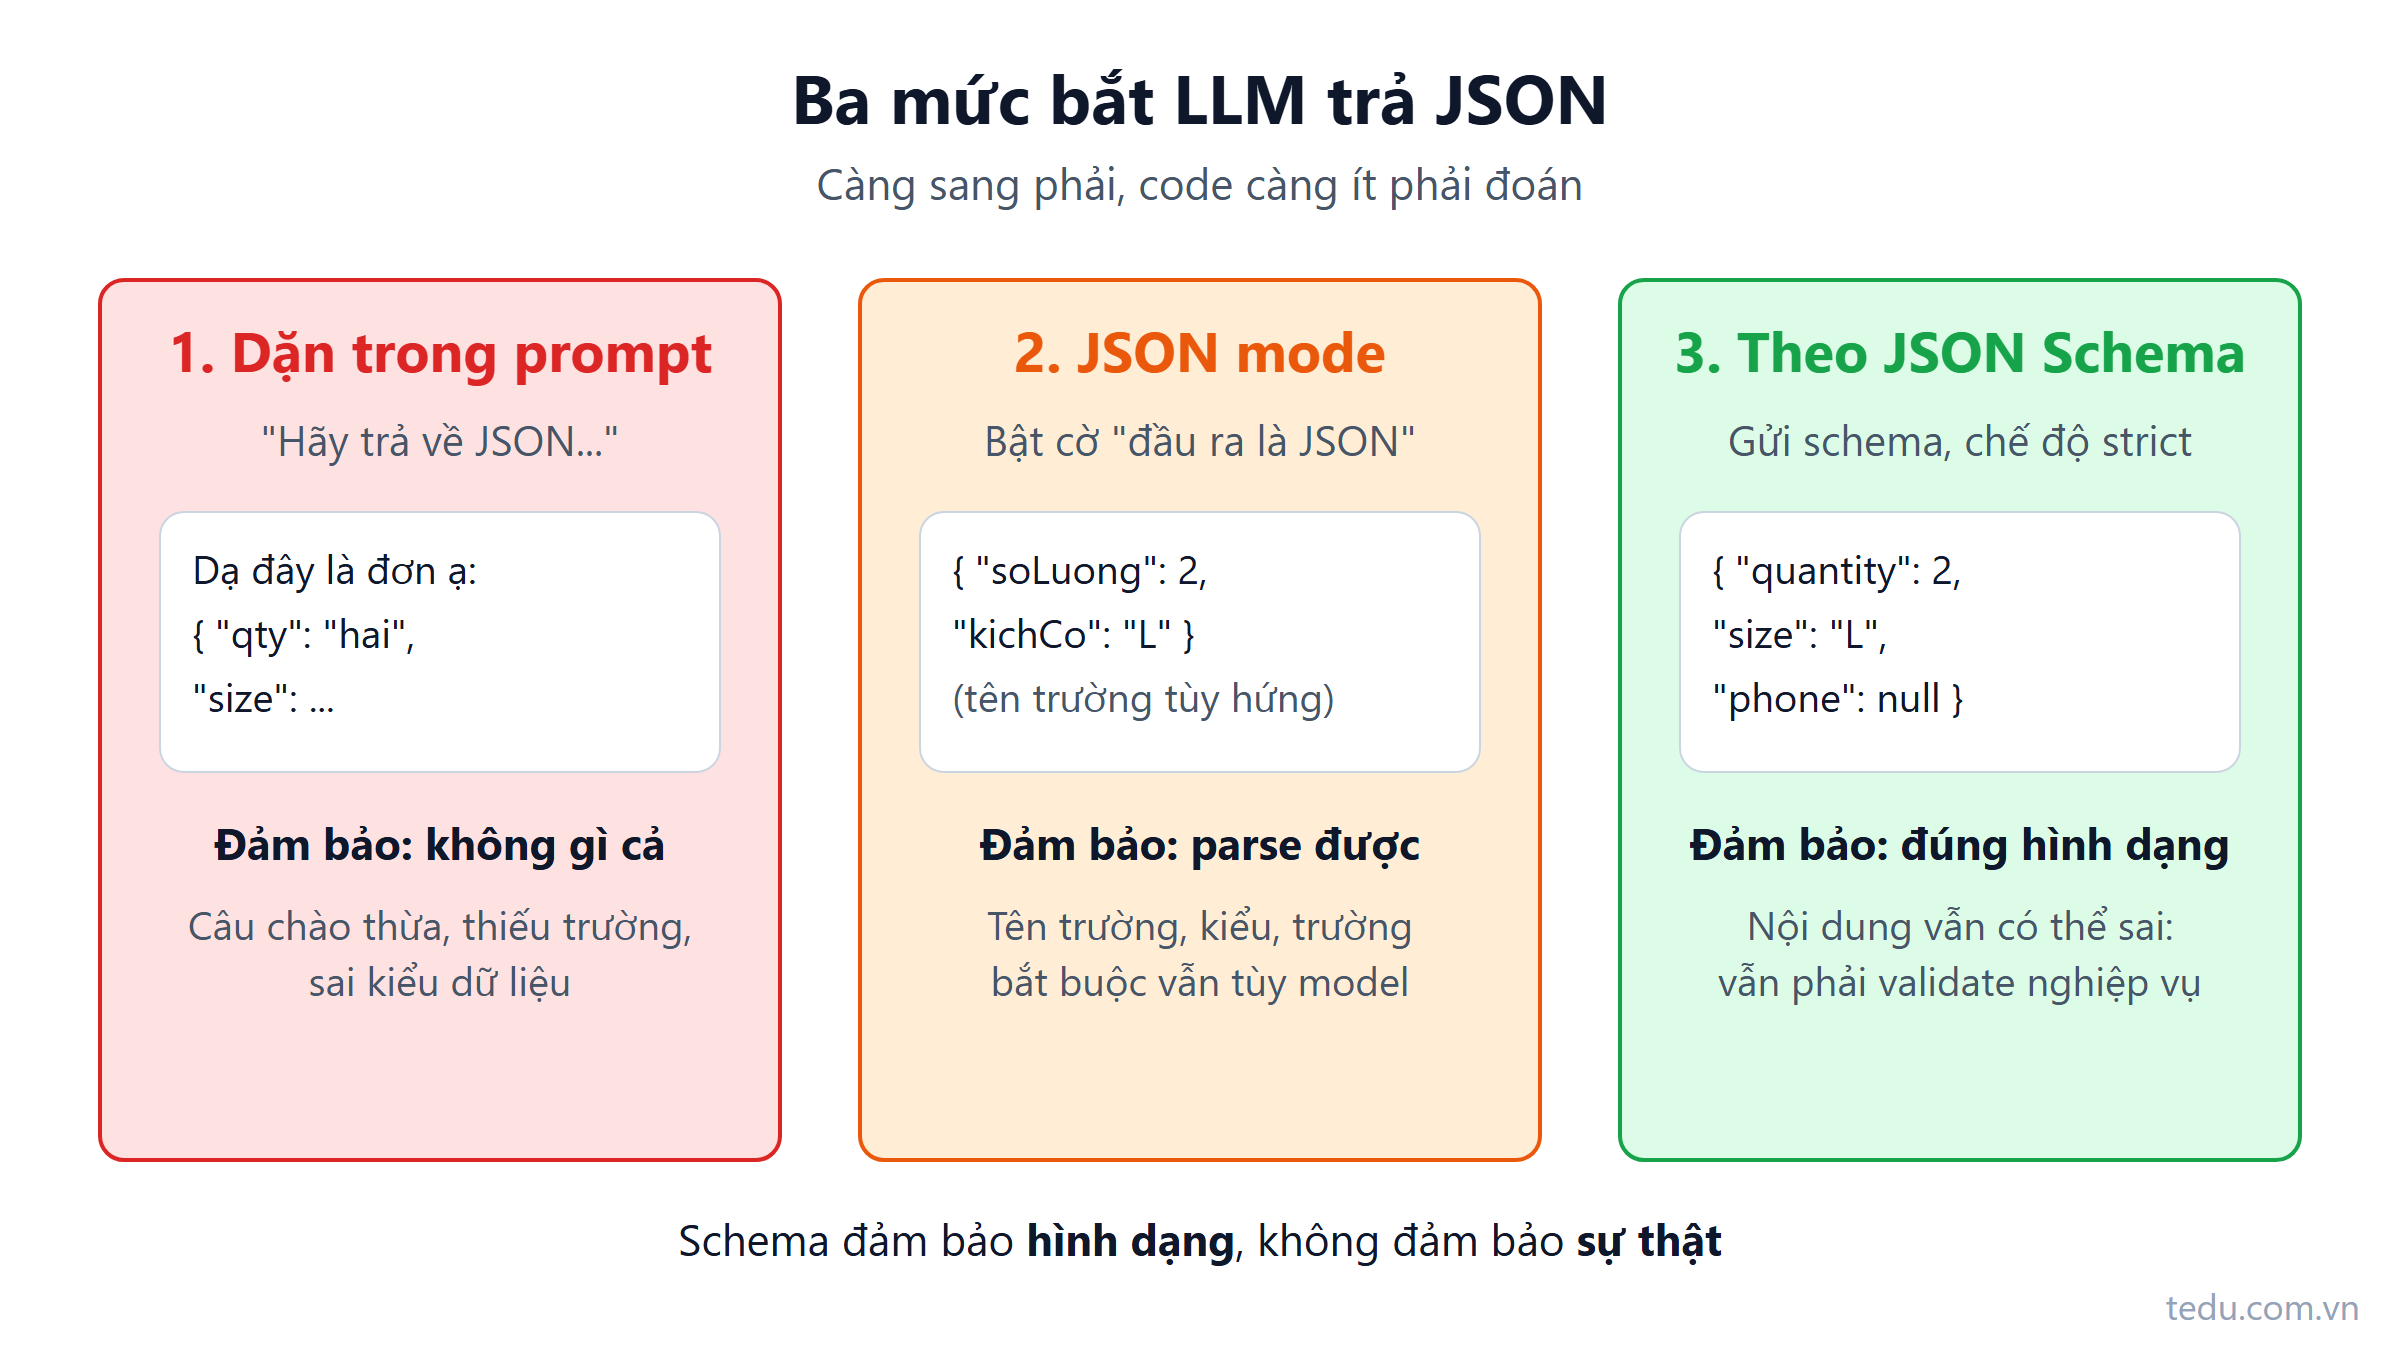
Structured output: bắt LLM trả JSON đúng schema
Structured output giúp LLM trả JSON đúng schema để code đọc được ngay. Bài so sánh 3 cách, kèm ví dụ C# bóc tách đơn hàng từ tin nhắn khách.
Đọc thêm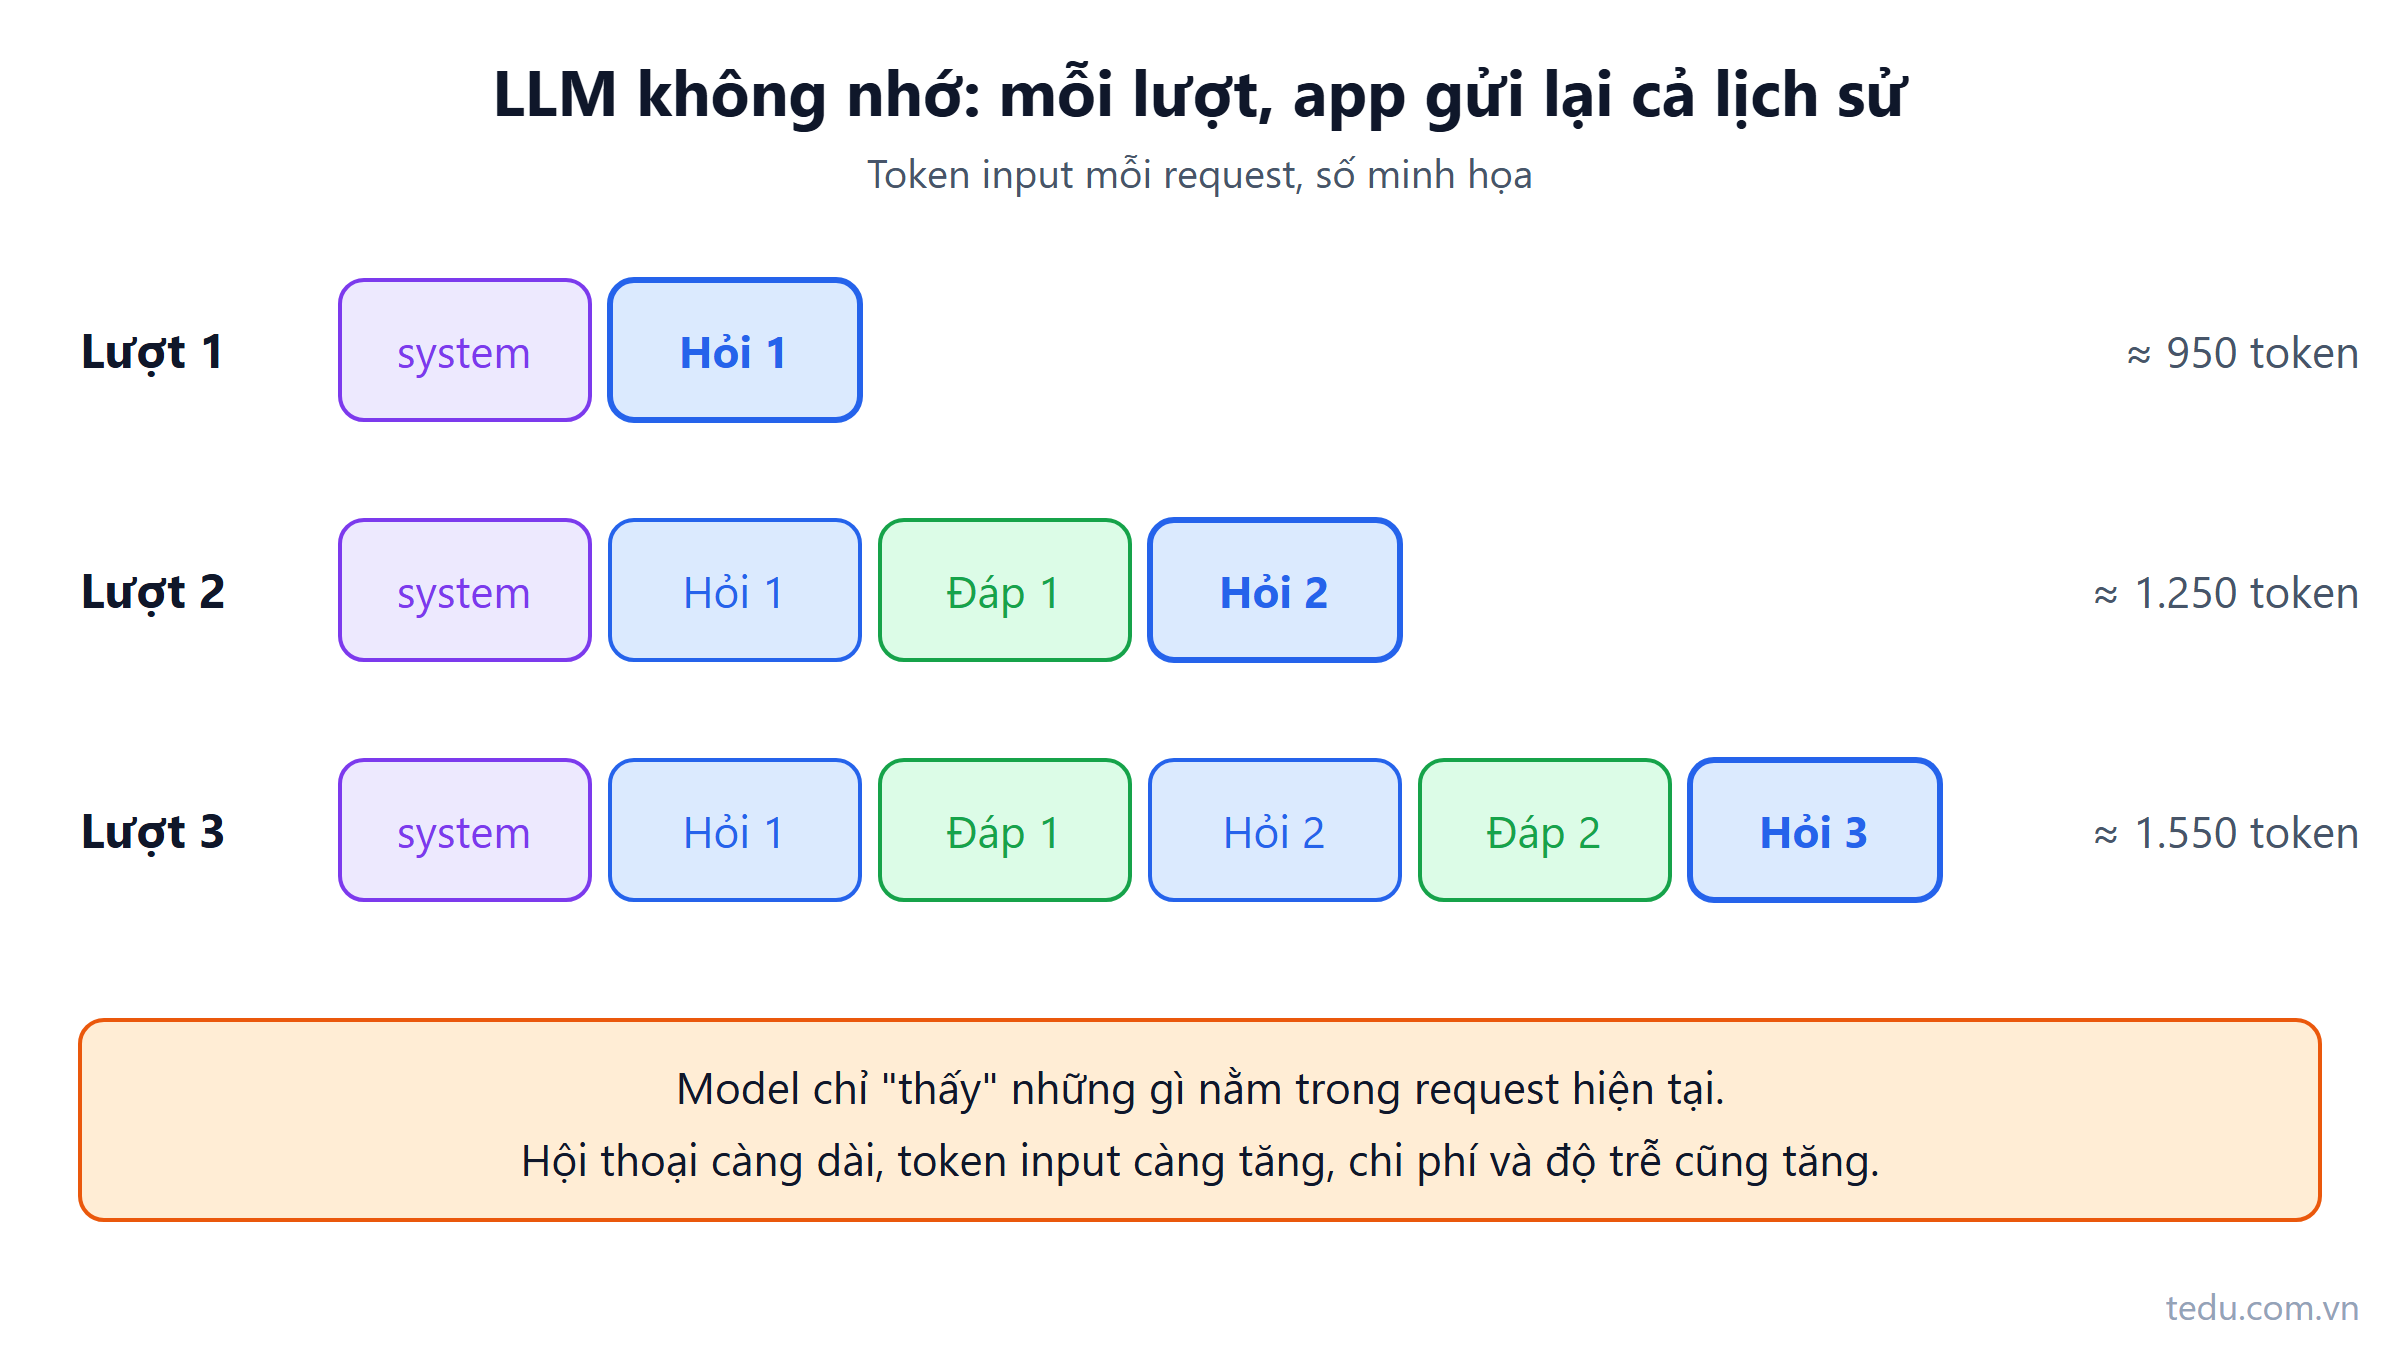
LLM là stateless: "memory" của chatbot thật ra là gửi lại lịch sử
LLM không nhớ gì giữa các request. Chatbot "nhớ" được là vì app gửi lại lịch sử hội thoại. Bài giải thích cơ chế, chi phí token và cách lưu hội thoại đúng trong backend.
Đọc thêm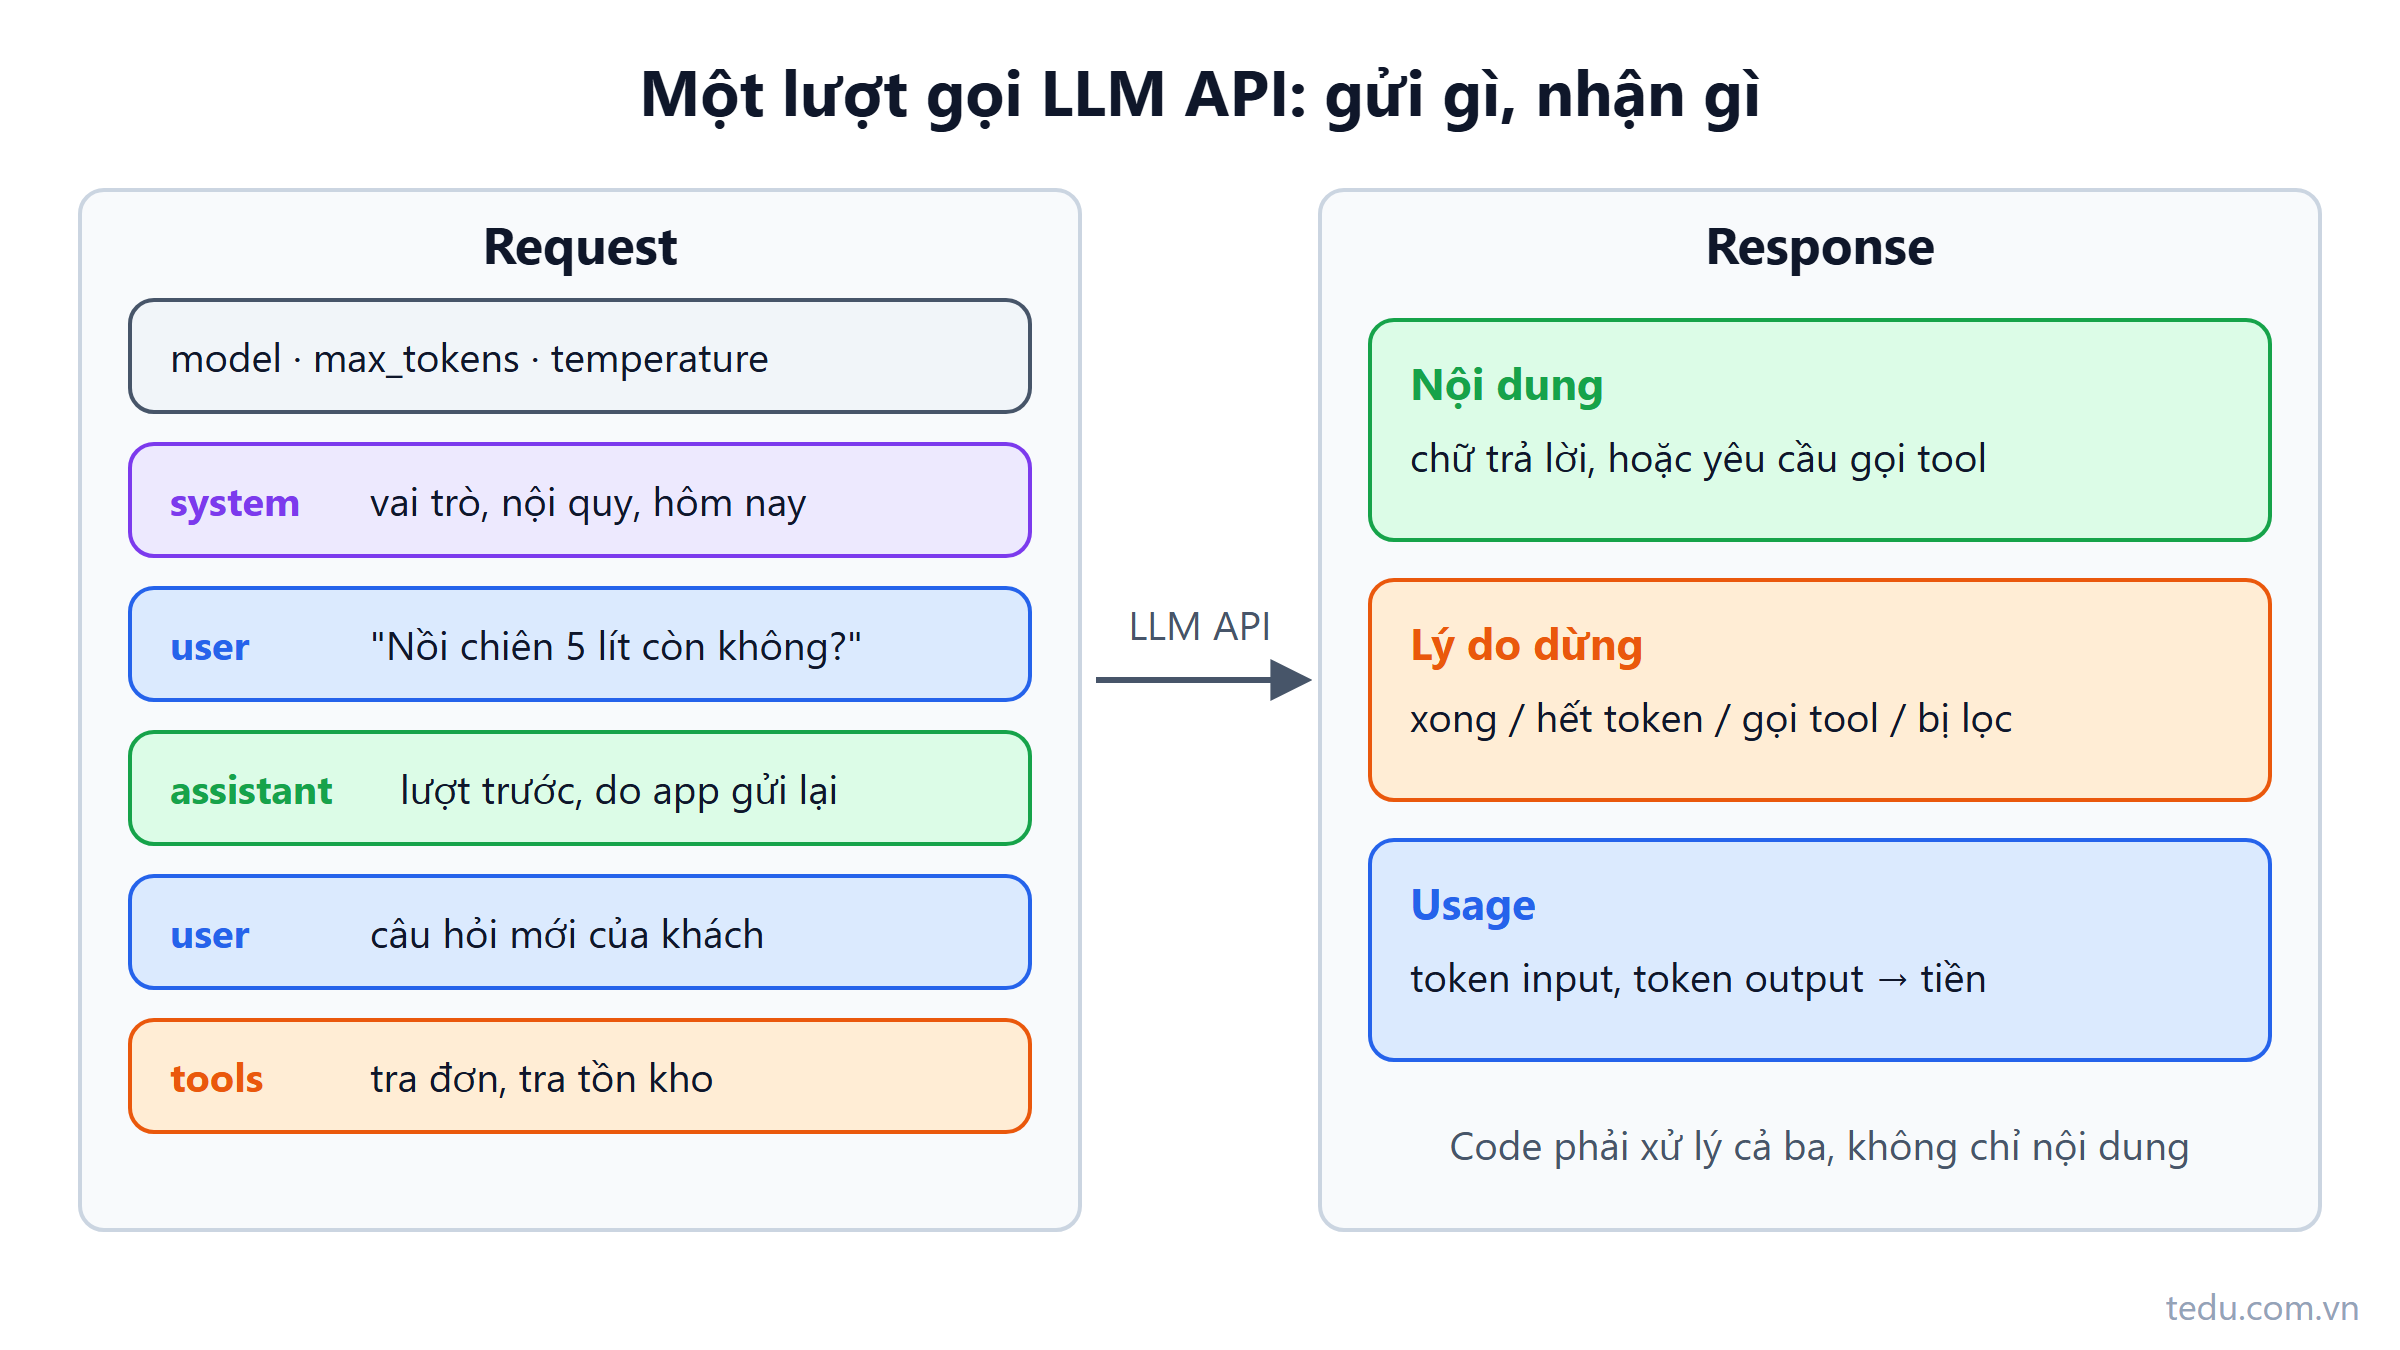
Cấu trúc request gọi LLM API: system, user, assistant gồm những gì
Một request gọi LLM API gồm model, tham số, danh sách message theo vai trò system, user, assistant và có thể có tools. Bài mổ xẻ từng phần kèm code C# gọi HTTP thô.
Đọc thêm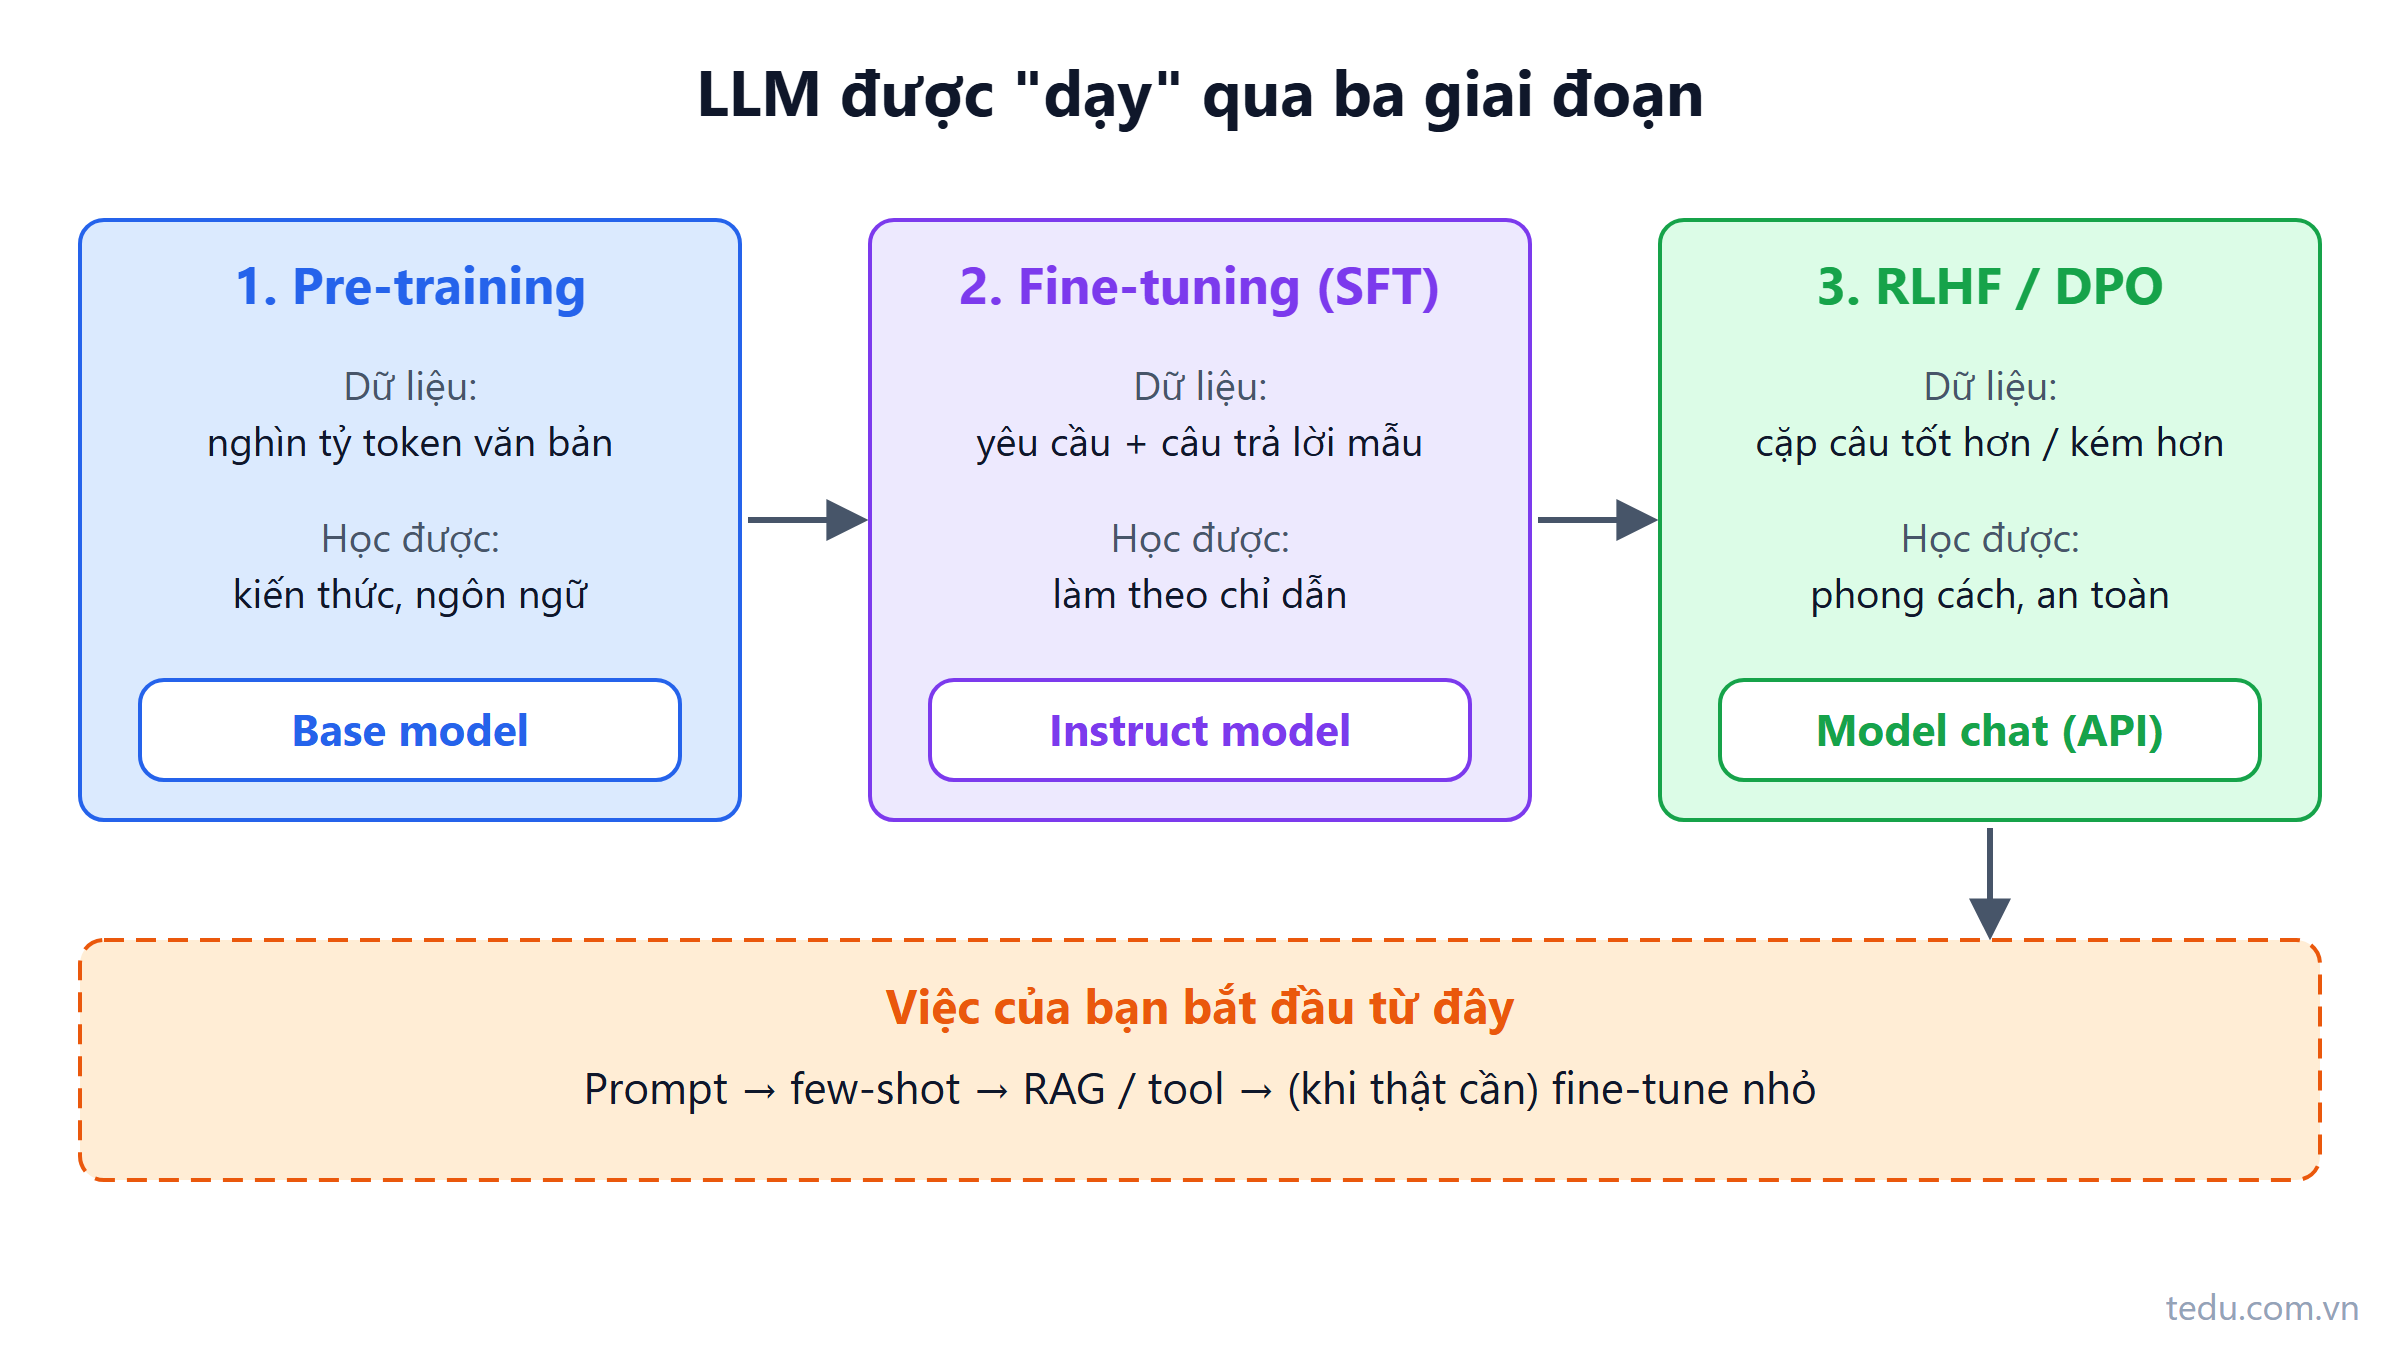
Pre-training, fine-tuning, RLHF: LLM được "dạy" thế nào
LLM đi qua ba giai đoạn huấn luyện: pre-training, fine-tuning theo chỉ dẫn và RLHF. Hiểu từng bước để biết khi nào cần fine-tune, khi nào chỉ cần RAG hoặc prompt.
Đọc thêm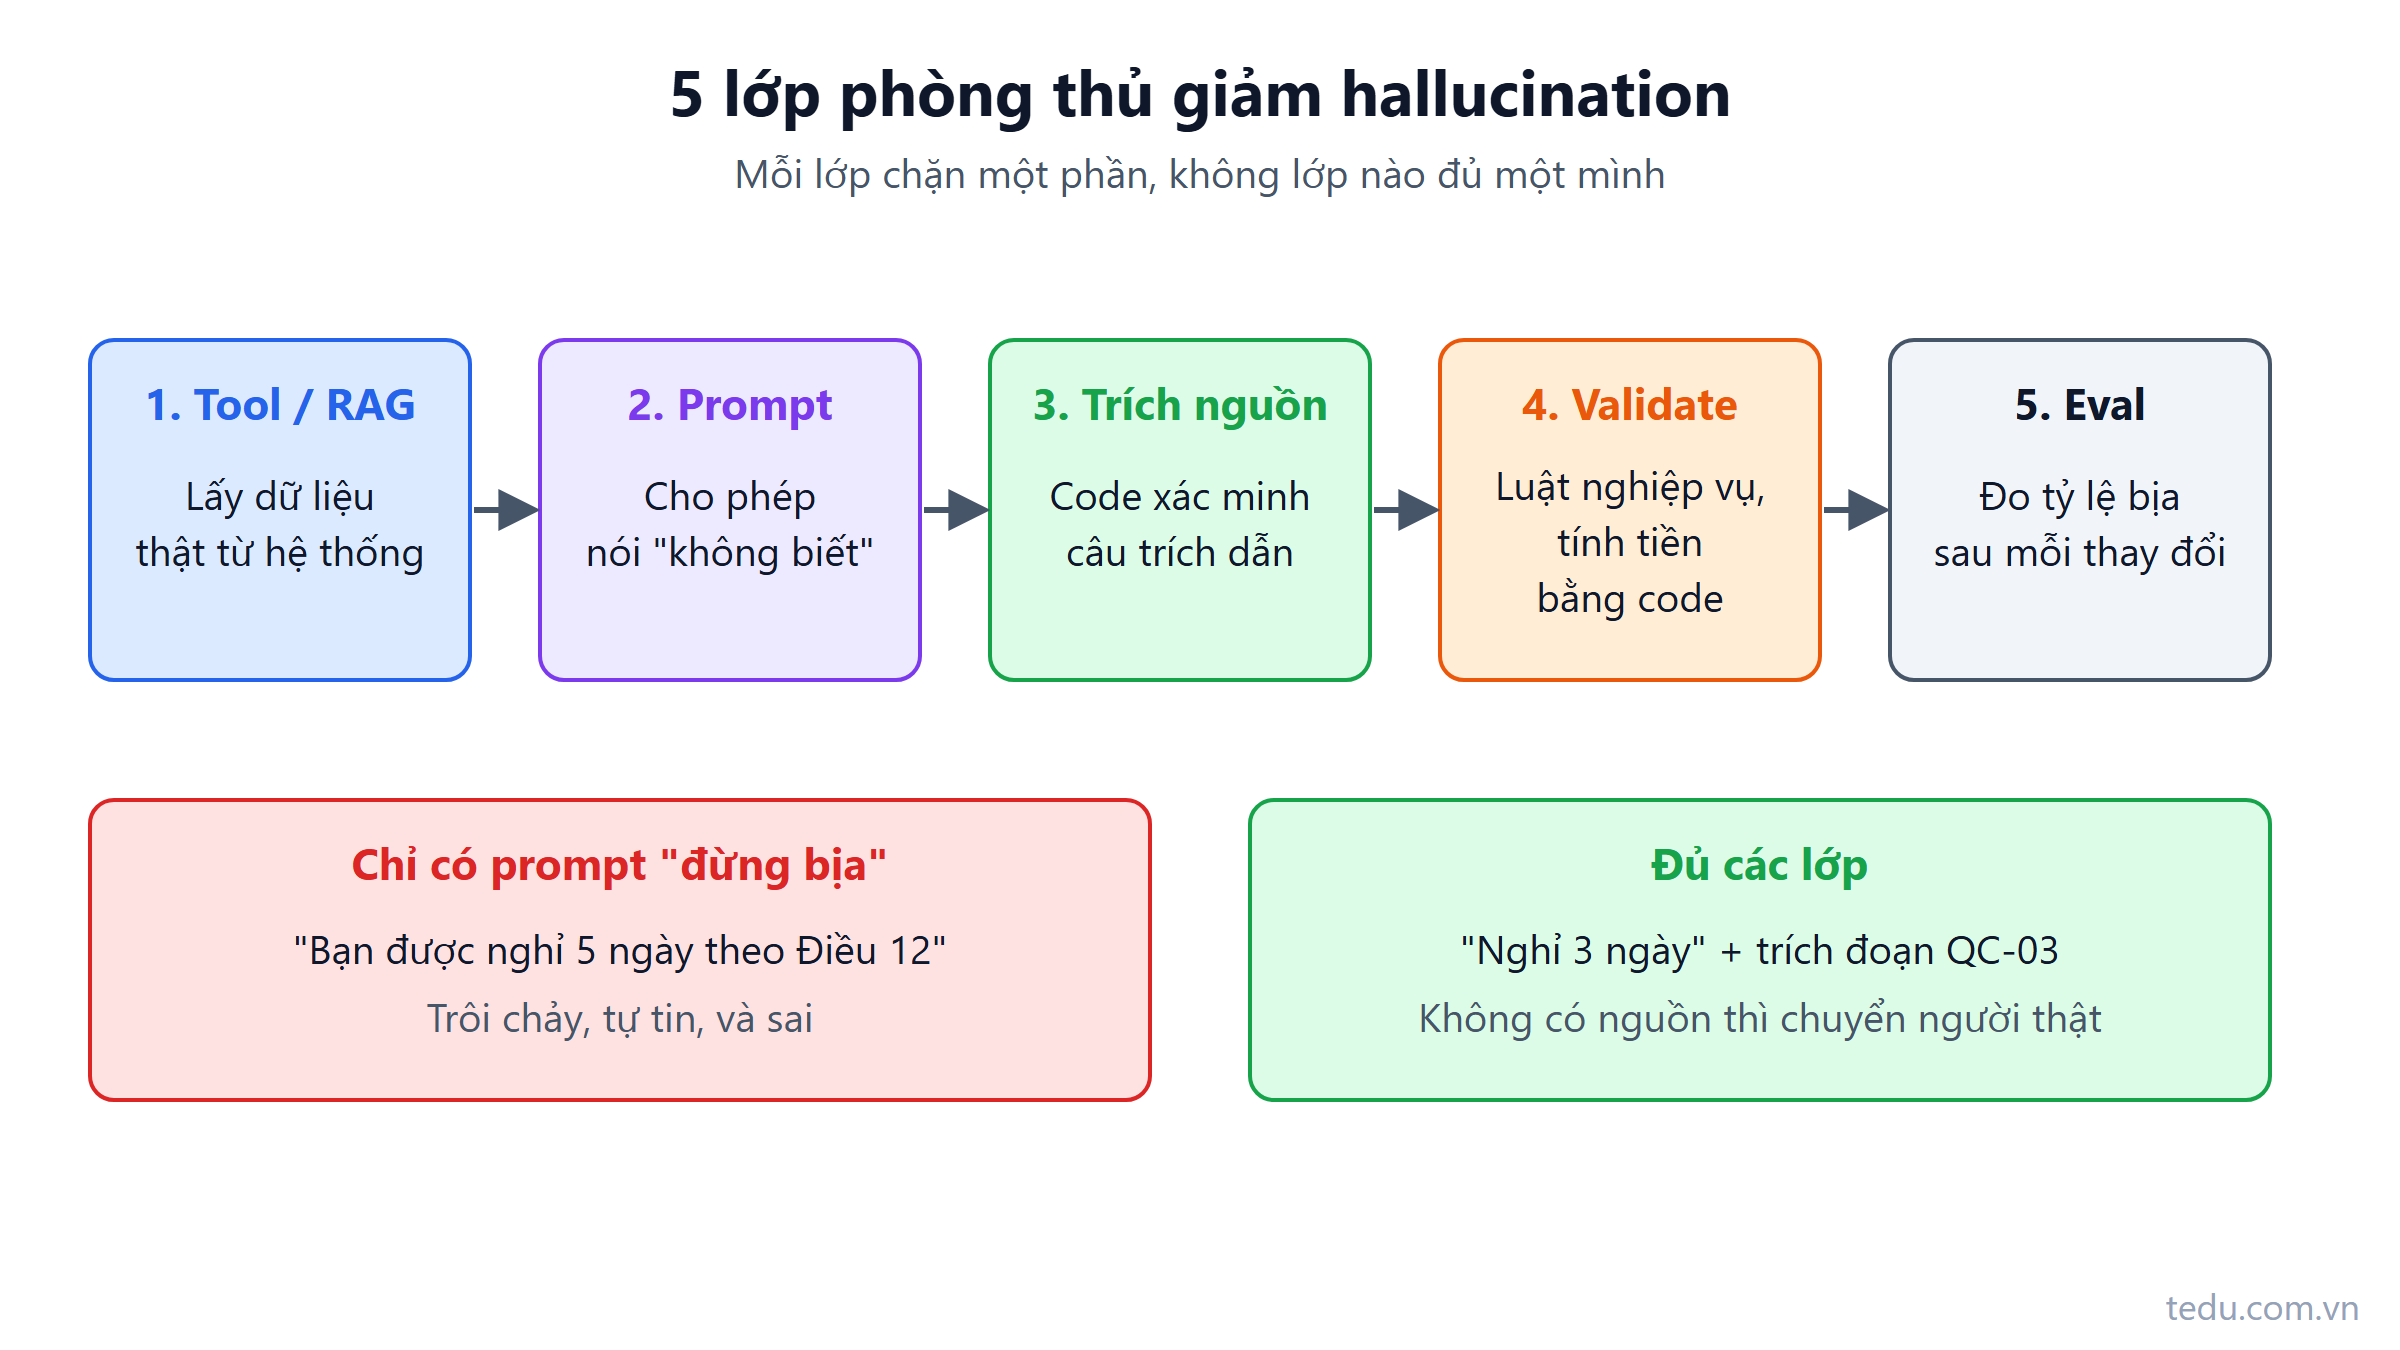
Hallucination là gì? Vì sao model "bịa" và cách hạn chế
Hallucination là khi LLM trả lời trôi chảy nhưng sai sự thật. Bài giải thích vì sao về bản chất model luôn có thể bịa, các dạng hay gặp và cách chặn bằng thiết kế hệ thống.
Đọc thêm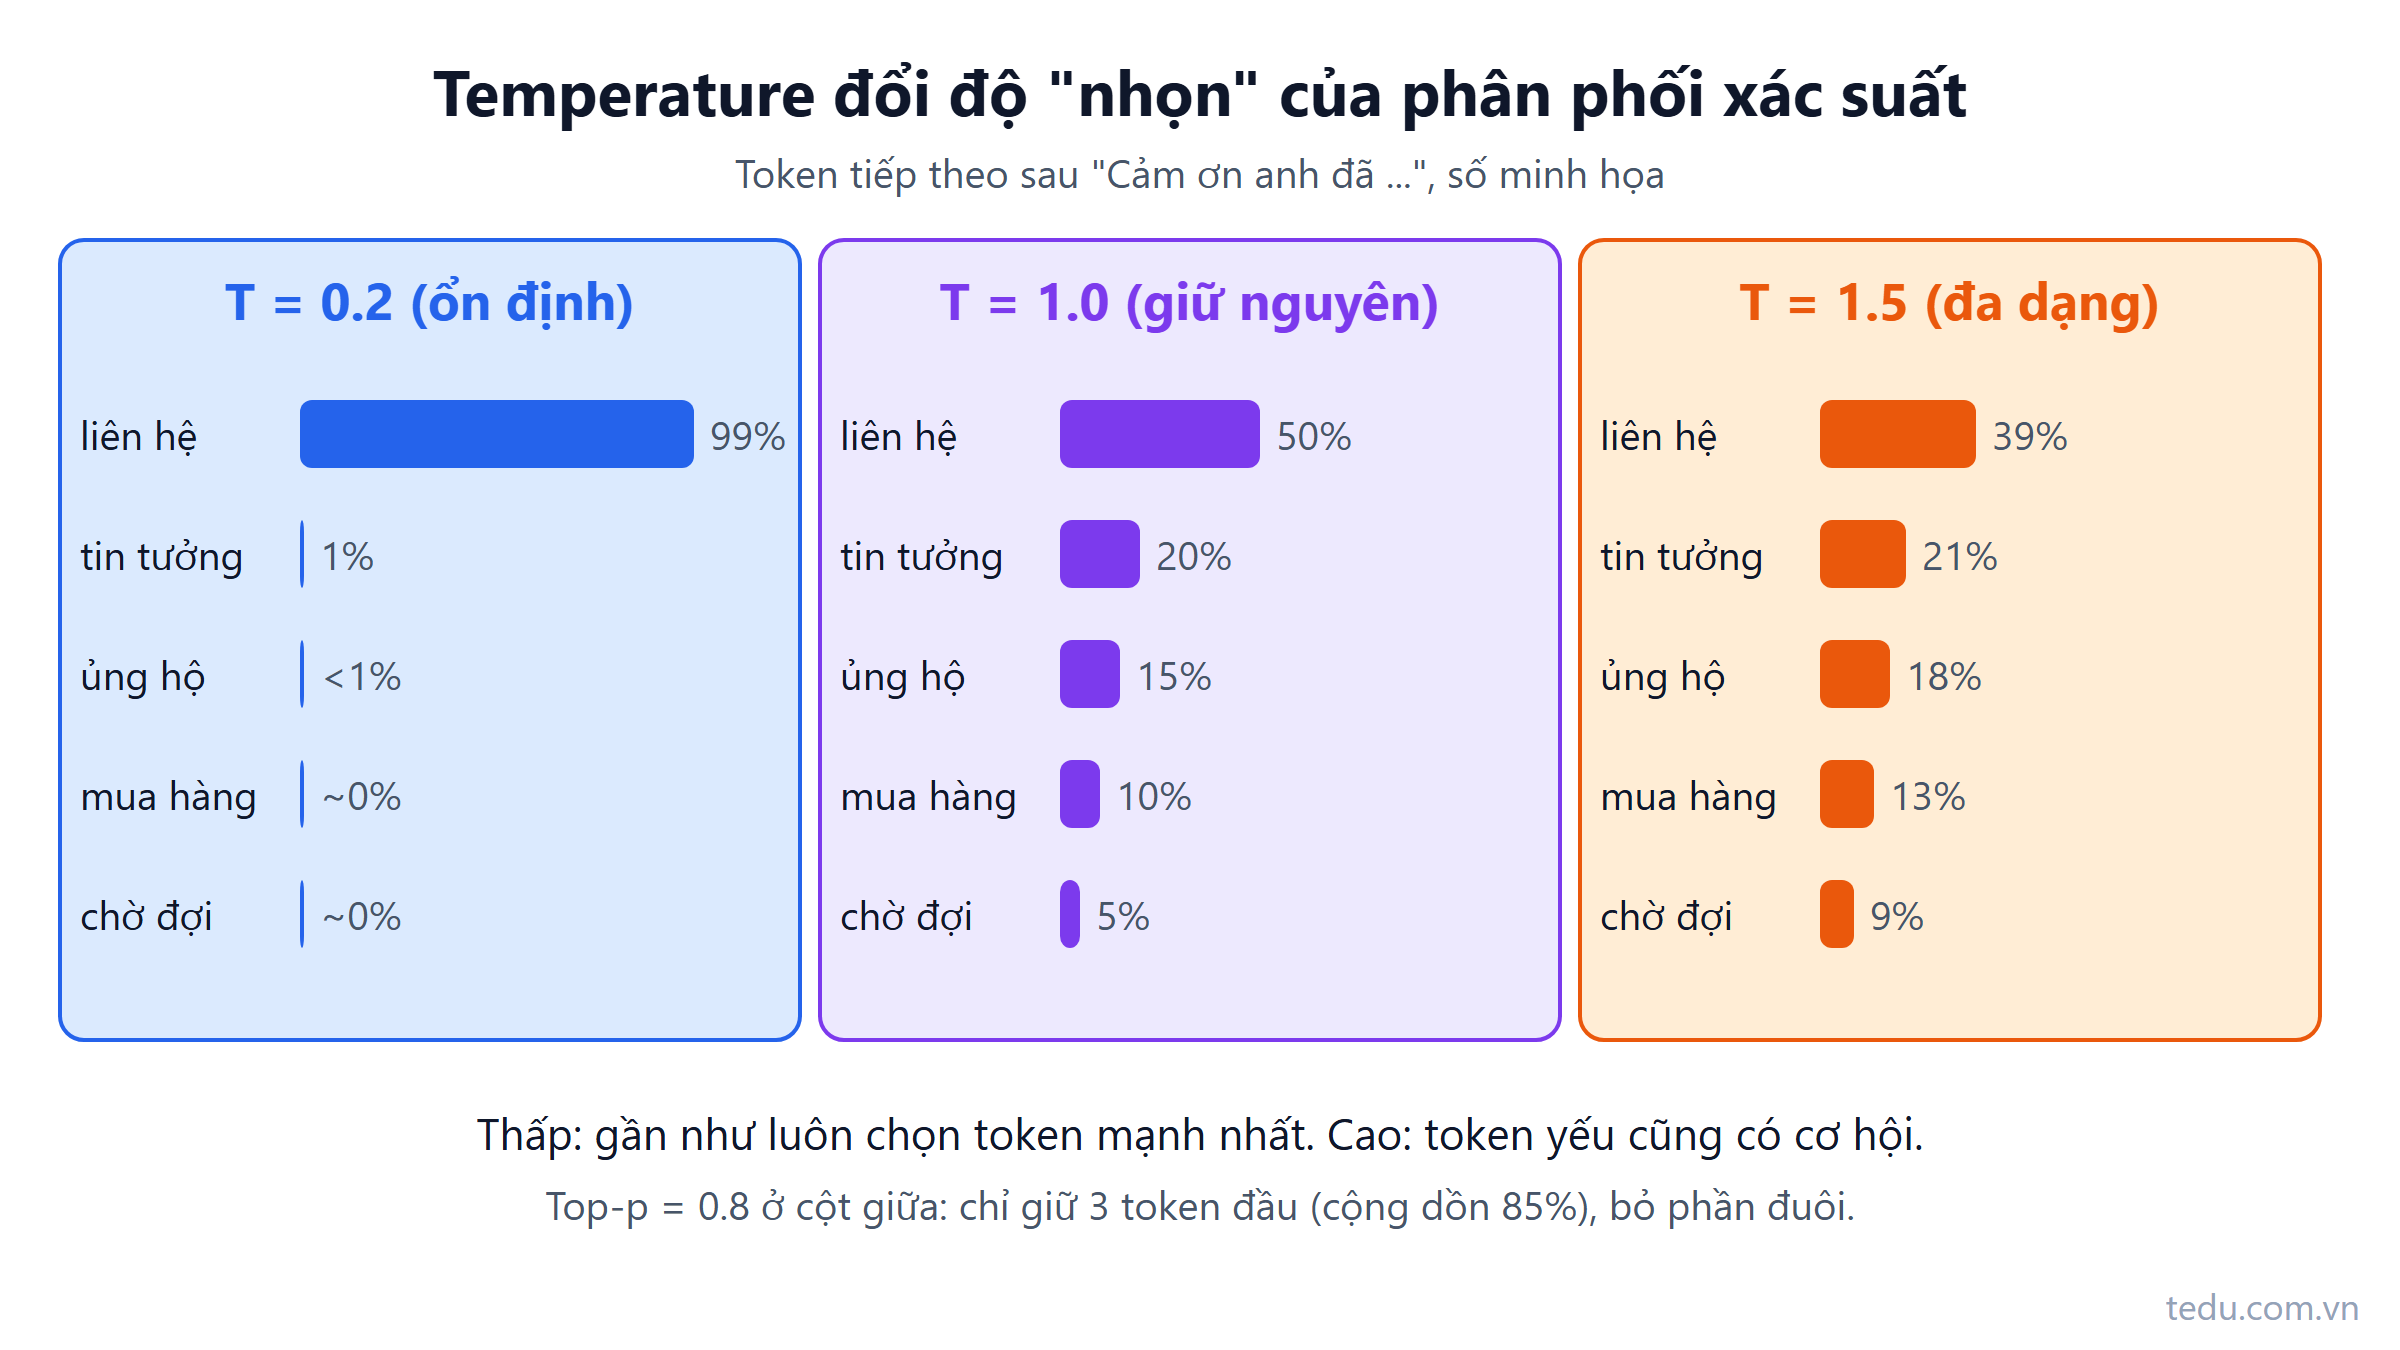
Temperature và top-p là gì? Chỉnh độ sáng tạo của LLM đúng cách
Temperature và top-p quyết định model chọn token tiếp theo an toàn hay phiêu lưu. Bài giải thích cơ chế bằng số cụ thể, code C# mô phỏng và cách chọn theo từng tác vụ.
Đọc thêm