

Pre-training, fine-tuning, RLHF: LLM được "dạy" thế nào
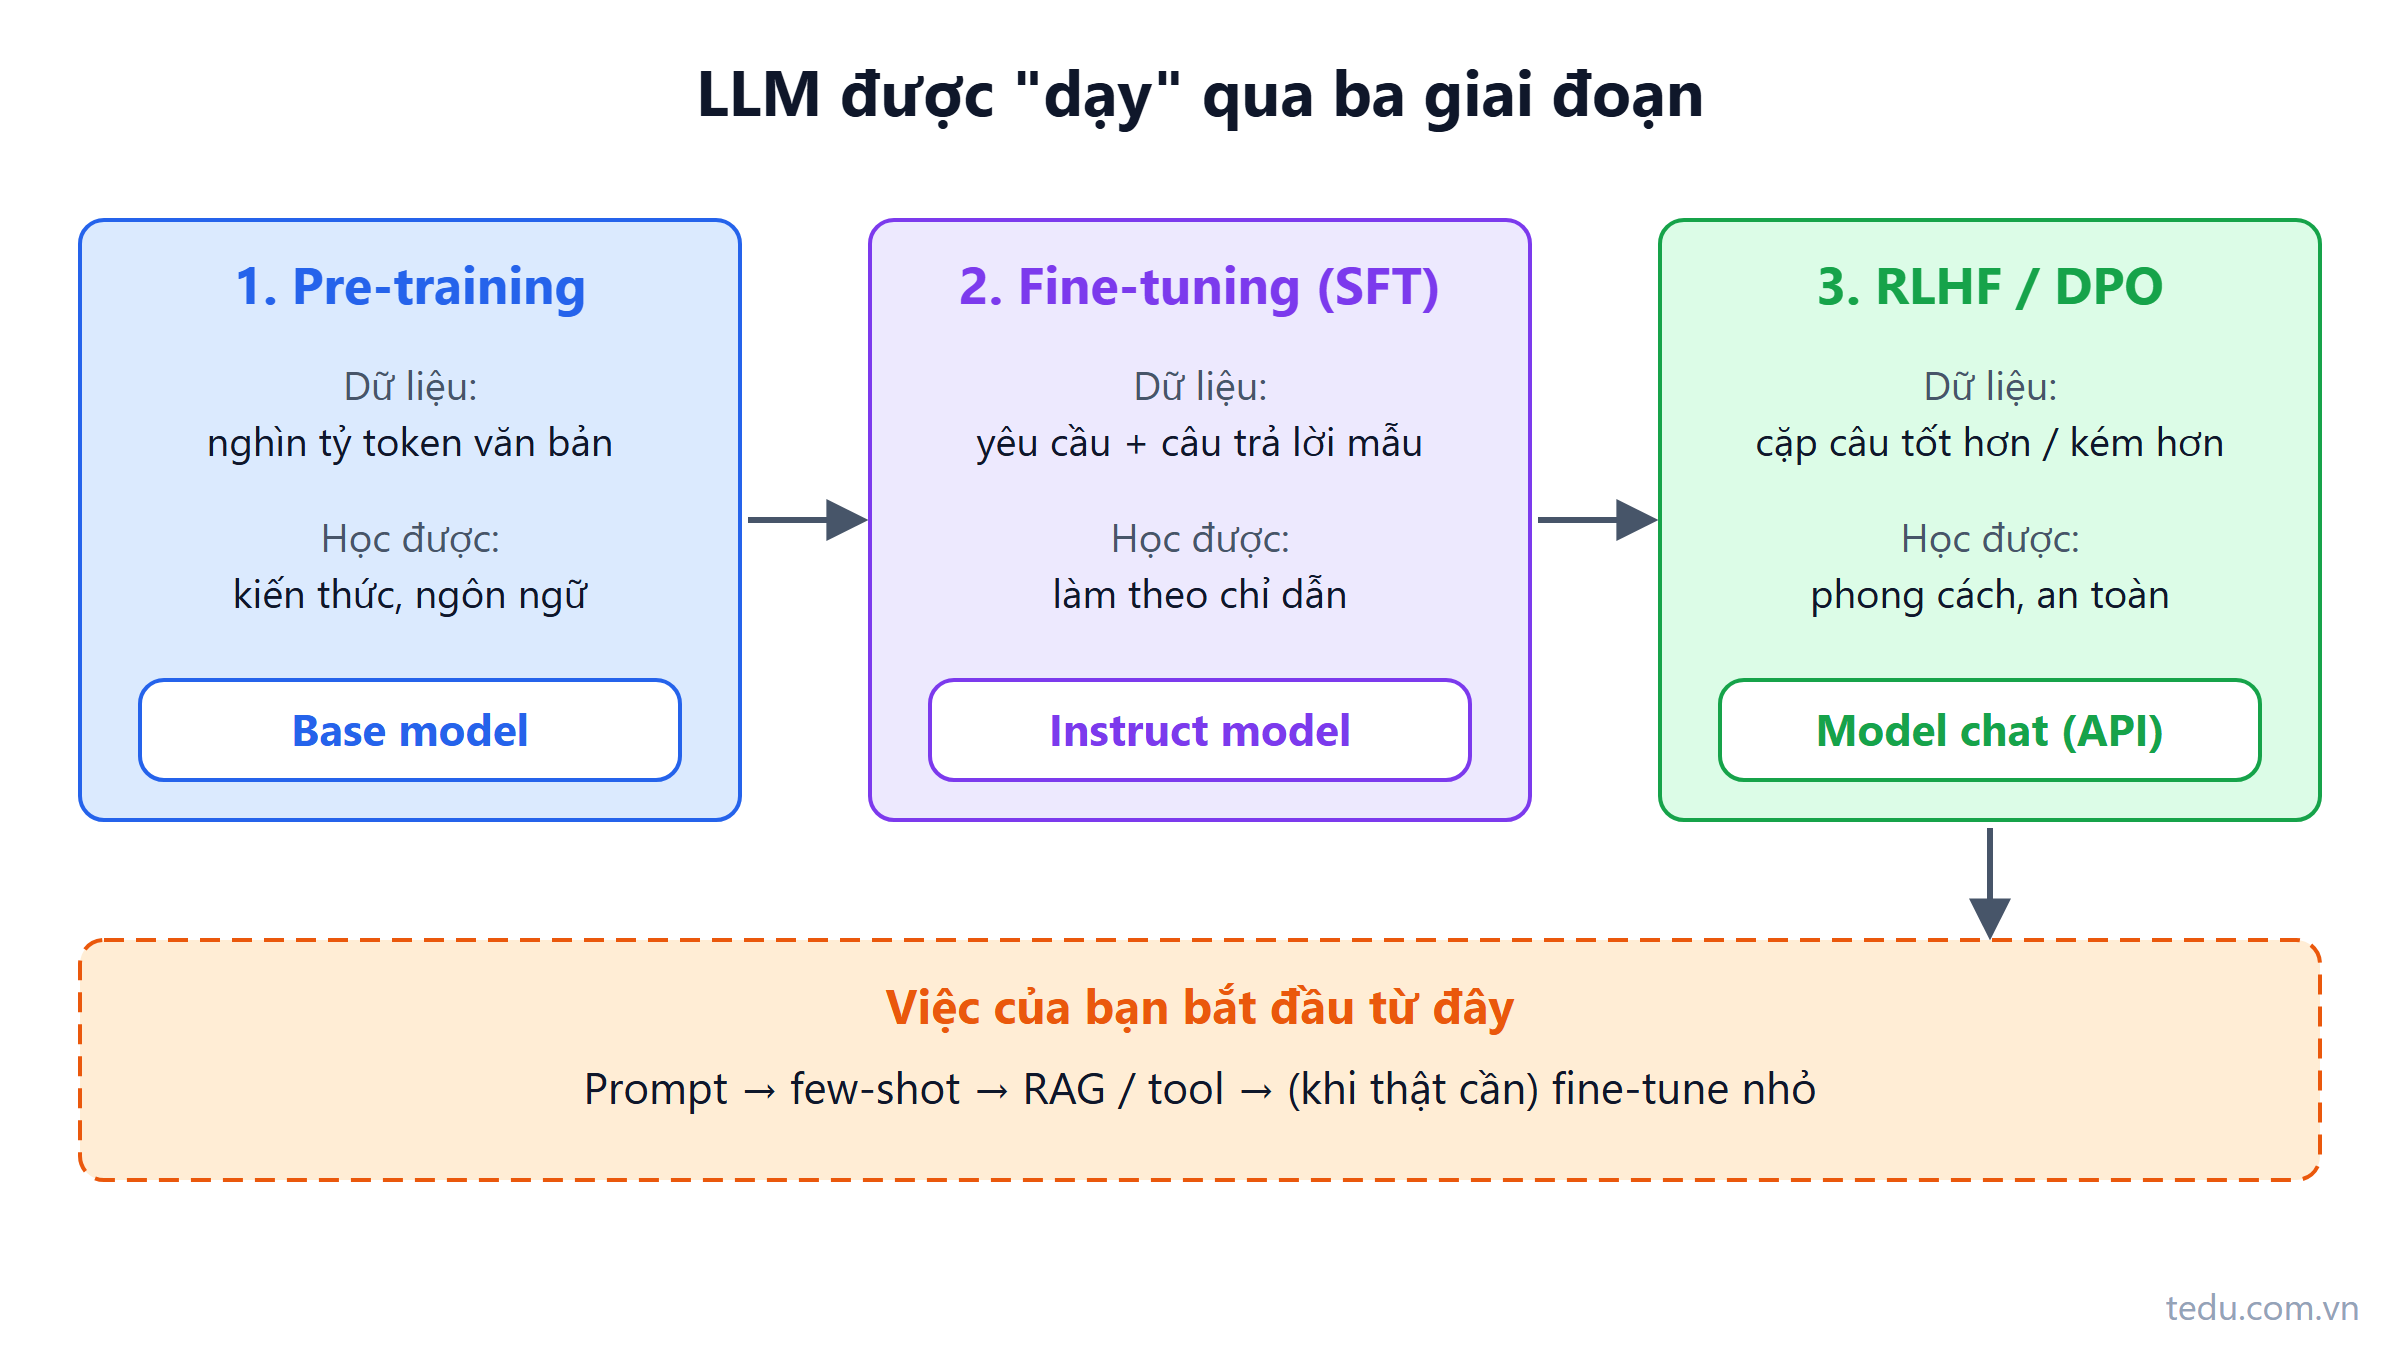
Trong buổi họp kick-off dự án chatbot nội bộ, sếp hỏi: "Sao mình không fine-tune model bằng bộ quy chế công ty, cho nó thuộc luôn, khỏi phải làm RAG gì cho phức tạp?". Cả phòng gật gù. Nghe rất hợp lý: model "học" quy chế thì trả lời về quy chế, đúng không?
Hầu như là không. Và để giải thích được vì sao trong vòng hai phút họp, bạn cần hiểu model được "dạy" thế nào. Bài này đi qua ba giai đoạn pre-training, fine-tuning và RLHF, mỗi giai đoạn tạo ra cái gì, và quan trọng nhất: điều đó nói gì về những quyết định bạn phải đưa ra khi làm sản phẩm AI.
Pre-training: đọc cả thư viện để đoán chữ tiếp theo
Giai đoạn đầu tiên, model được cho đọc một lượng văn bản khổng lồ: trang web, sách, mã nguồn, tài liệu kỹ thuật, hàng nghìn tỷ token. Nhiệm vụ duy nhất: đoán token tiếp theo. Đoán sai thì điều chỉnh tham số một chút, lặp lại hàng tỷ lần.
Kết quả là một base model. Nó biết rất nhiều: ngữ pháp, kiến thức phổ thông, cách viết code C#, cấu trúc một hợp đồng. Nhưng nó chưa biết "trả lời câu hỏi" là gì. Nó chỉ biết viết tiếp văn bản.
Ví dụ, đưa cho base model đoạn sau:
Câu hỏi: Thủ đô của Việt Nam là gì?Một base model có thể viết tiếp như sau:
Câu hỏi: Thủ đô của Lào là gì?
Câu hỏi: Thủ đô của Campuchia là gì?
Câu hỏi: Thủ đô của Thái Lan là gì?
Vì trong dữ liệu huấn luyện, một dòng "Câu hỏi: ..." thường nằm trong một đề kiểm tra địa lý có nhiều câu hỏi liên tiếp. Model đang hoàn thành tài liệu, không phải đang nói chuyện với bạn. Giống một nhân viên mới đọc hết tài liệu công ty nhưng chưa ai dặn việc của mình là ngồi quầy trả lời khách.
Ba điều cần nhớ về pre-training:
Cực kỳ tốn kém. Cần cụm GPU lớn chạy trong thời gian dài. Gần như chỉ các phòng lab lớn làm được. Bạn sẽ không pre-train, và cũng không cần.
Kiến thức có ngày hết hạn. Model chỉ biết những gì có trong dữ liệu đến thời điểm cắt dữ liệu (knowledge cutoff). Luật mới, giá mới, phiên bản .NET mới ra sau thời điểm đó, model không biết.
Đây là nơi model lấy gần như toàn bộ kiến thức. Các bước sau chủ yếu dạy cách cư xử, không nạp thêm bao nhiêu kiến thức.
Fine-tuning theo chỉ dẫn: dạy model làm trợ lý
Giai đoạn thứ hai thường gọi là supervised fine-tuning (SFT) hoặc instruction tuning. Người ta chuẩn bị một bộ ví dụ "yêu cầu và câu trả lời mẫu" do người viết hoặc người duyệt, rồi tiếp tục huấn luyện base model trên bộ này.
Một bản ghi huấn luyện thường có dạng hội thoại với các vai trò, ví dụ ở định dạng JSONL (mỗi dòng một JSON; tên field cụ thể khác nhau giữa các nhà cung cấp và framework):
{"messages": [{"role": "system", "content": "Bạn là trợ lý CSKH của một shop thời trang."}, {"role": "user", "content": "Áo này giặt máy được không?"}, {"role": "assistant", "content": "Dạ được ạ. Anh/chị nên giặt chế độ nhẹ, nước dưới 30 độ và lộn trái áo để giữ màu."}]}Sau vài chục nghìn đến vài trăm nghìn ví dụ kiểu này, model học được:
Khi thấy vai trò
userhỏi, việc của nó là trả lời ở vai tròassistant, không phải viết thêm câu hỏi.Định dạng phổ biến: danh sách, bảng, code block, trả lời ngắn khi câu hỏi ngắn.
Làm theo chỉ dẫn trong system prompt.
Chú ý quy mô: bộ dữ liệu này nhỏ hơn dữ liệu pre-training rất nhiều lần. Nó chỉnh hành vi và định dạng, không phải đổ thêm cả kho kiến thức mới.
RLHF: dạy model trả lời theo cách con người thích
Một model đã qua SFT có thể trả lời đúng định dạng nhưng vẫn chưa "tốt": có câu dài dòng, có câu thiếu an toàn, có câu đúng nhưng khó hiểu. Viết câu trả lời mẫu hoàn hảo cho mọi tình huống thì quá tốn công. Nhưng so sánh hai câu trả lời và chọn câu tốt hơn thì dễ hơn nhiều.
Đó là ý tưởng của RLHF (Reinforcement Learning from Human Feedback):
Cho model sinh hai hoặc nhiều câu trả lời cho cùng một câu hỏi.
Người đánh giá chọn câu nào tốt hơn (hữu ích hơn, đúng hơn, an toàn hơn).
Từ hàng nghìn lựa chọn đó, huấn luyện một reward model: model chấm điểm câu trả lời theo khẩu vị của người đánh giá.
Dùng reinforcement learning để tối ưu model chính sao cho câu trả lời đạt điểm reward cao.
Một bản ghi so sánh có thể trông như sau:
{
  "prompt": "Khách hỏi: Đơn của em giao trễ 3 ngày rồi, shop làm ăn kiểu gì vậy?",
  "chosen": "Dạ shop xin lỗi anh/chị vì đơn giao trễ. Anh/chị cho shop xin mã đơn để kiểm tra ngay với đơn vị vận chuyển ạ.",
  "rejected": "Việc giao hàng do đơn vị vận chuyển phụ trách, shop không chịu trách nhiệm."
}
Ngoài RLHF cổ điển, nhiều lab dùng các biến thể như DPO (Direct Preference Optimization), học trực tiếp từ cặp "chọn / không chọn" mà không cần reward model riêng, hoặc dùng AI hỗ trợ chấm thay một phần người chấm. Các model suy luận (reasoning) gần đây còn được huấn luyện thêm bằng reinforcement learning trên những bài toán có thể chấm đúng sai tự động, như toán và lập trình. Tên gọi khác nhau, nhưng ý chung là: tối ưu theo một tín hiệu "câu trả lời này tốt hơn".
Tác dụng phụ của RLHF mà bạn sẽ gặp
Tối ưu theo khẩu vị con người tạo ra model dễ chịu, nhưng cũng để lại vài thói quen:
Chiều lòng người hỏi (sycophancy). Bạn nói "tôi nghĩ đáp án là B", model dễ đồng ý dù A mới đúng. Hỏi "bạn có chắc không?", model dễ đổi ý.
Dài dòng. Người chấm thường thích câu trả lời đầy đủ, nên model có xu hướng viết dài hơn cần thiết.
Tự tin quá mức. Câu trả lời chắc chắn thường được chấm cao hơn câu "tôi không rõ", góp phần vào chuyện model bịa, như đã nói ở bài hallucination là gì.
Từ chối quá tay. Đôi khi model từ chối một yêu cầu vô hại vì nó "trông giống" yêu cầu nhạy cảm.
So sánh ba giai đoạn
| Pre-training | Fine-tuning (SFT) | RLHF / preference tuning | |
|---|---|---|---|
| Dữ liệu | Văn bản thô khổng lồ | Cặp yêu cầu và câu trả lời mẫu | Cặp câu trả lời được so sánh tốt hơn / kém hơn |
| Quy mô dữ liệu | Hàng nghìn tỷ token | Nhỏ hơn rất nhiều | Nhỏ hơn rất nhiều |
| Model học được | Kiến thức, ngôn ngữ, mẫu văn bản | Làm theo chỉ dẫn, định dạng hội thoại | Phong cách, mức an toàn, độ hữu ích |
| Ai làm | Phòng lab lớn | Lab lớn; doanh nghiệp có thể fine-tune thêm | Chủ yếu lab lớn |
| Kết quả | Base model | Instruct model | Model chat bạn gọi qua API |
Hệ quả thực tế cho AI Engineer
Quay lại câu hỏi của sếp. Giờ bạn có thể trả lời gọn: kiến thức chủ yếu vào model ở bước pre-training. Fine-tuning dạy cách cư xử, không phải cách tốt để nạp một bộ quy chế sẽ thay đổi mỗi quý.
Fine-tune bằng quy chế có ba vấn đề:
Quy chế sửa thì phải fine-tune lại. RAG chỉ cần cập nhật tài liệu.
Model fine-tune vẫn có thể "nhớ nhầm" và trả lời sai, mà bạn không có đoạn nguồn nào để kiểm tra như RAG.
Không phân quyền được: tài liệu chỉ ban giám đốc được xem, một khi đã nằm trong trọng số model, thì ai hỏi cũng có thể moi ra.
Bảng dưới giúp chọn đúng công cụ cho từng nhu cầu thường gặp:
| Nhu cầu | Nên bắt đầu bằng | Khi nào mới cân nhắc fine-tune |
|---|---|---|
| Bot trả lời theo quy chế, chính sách | RAG | Gần như không |
| Tra đơn hàng, tồn kho, công nợ | Tool calling gọi API thật | Không |
| Phân loại ticket vào 12 nhãn của công ty | Prompt rõ + vài ví dụ (few-shot) | Khi lượng request rất lớn, muốn dùng model nhỏ rẻ hơn mà vẫn đúng |
| Giọng văn thương hiệu nhất quán | Prompt + ví dụ mẫu | Khi prompt quá dài và kết quả vẫn lệch |
| Trích xuất từ loại chứng từ đặc thù | Structured output + ví dụ | Khi model nền liên tục sai định dạng đặc thù |
Thứ tự thử thực dụng: prompt tốt, rồi few-shot, rồi RAG hoặc tool, cuối cùng mới đến fine-tuning. Bài RAG, fine-tuning hay long context so sánh kỹ hơn, và bài fine-tuning LoRA nói về cách fine-tune với chi phí thấp khi thật sự cần.
Chuẩn bị dữ liệu fine-tune là việc của dev backend
Nếu đến lúc cần fine-tune, phần tốn công nhất thường không phải huấn luyện mà là chuẩn bị dữ liệu sạch. Đây là việc dev backend làm quen tay: truy vấn DB, lọc, chuẩn hóa, xuất file. Ví dụ xuất ticket đã gán nhãn thành JSONL:
using System.Text.Encodings.Web;
using System.Text.Json;

var options = new JsonSerializerOptions
{
    Encoder = JavaScriptEncoder.UnsafeRelaxedJsonEscaping   // giữ tiếng Việt dễ đọc
};

// LabeledTicket là bản ghi của bạn, lấy từ DB: ticket đã được nhân viên gán nhãn đúng
IEnumerable<LabeledTicket> tickets = await ticketRepository.GetVerifiedAsync();

await using var writer = new StreamWriter("train.jsonl");
foreach (var t in tickets)
{
    var record = new
    {
        messages = new object[]
        {
            new { role = "system", content = "Phân loại ticket CSKH vào đúng một nhãn." },
            new { role = "user", content = t.Content },
            new { role = "assistant", content = t.Label }
        }
    };
    await writer.WriteLineAsync(JsonSerializer.Serialize(record, options));
}
Định dạng chính xác của file huấn luyện tùy nhà cung cấp hoặc framework bạn dùng, hãy đọc docs của họ. Còn chất lượng dữ liệu thì luôn là việc của bạn: ticket gán nhãn sai, dữ liệu chứa số điện thoại khách hàng chưa che, hay một nhãn chiếm 90% bộ dữ liệu đều làm hỏng kết quả.
Hiểu lầm hay gặp và checklist
Những hiểu lầm phổ biến:
"Fine-tune để model biết dữ liệu công ty." Dùng RAG hoặc tool. Fine-tune để chỉnh hành vi, định dạng.
"Model biết cả những gì mới nhất." Nó chỉ biết đến thời điểm cắt dữ liệu. Muốn dùng thông tin mới, đưa vào context.
"Model đồng ý với mình nghĩa là mình đúng." Có thể chỉ là thói quen chiều lòng người hỏi.
"Cùng tên model thì hành vi không đổi." Nhà cung cấp có thể cập nhật model. Hãy ghim phiên bản cụ thể khi có thể và chạy lại bộ test khi đổi.
Checklist áp dụng:
Trước khi đề xuất fine-tune, ghi rõ: vấn đề là thiếu kiến thức hay sai hành vi? Thiếu kiến thức thì dùng RAG hoặc tool.
Đưa ngày hiện tại và dữ liệu mới vào context khi câu hỏi phụ thuộc thời gian.
Viết prompt và câu hỏi eval trung lập, tránh câu dẫn dắt kiểu "đáp án là B đúng không?".
Yêu cầu trả lời ngắn gọn tường minh nếu sản phẩm cần, vì mặc định model hay dài dòng.
Ghim phiên bản model, lưu kết quả eval theo phiên bản.
Tóm lại
Pre-training cho model kiến thức và khả năng ngôn ngữ bằng cách đoán chữ tiếp theo trên lượng văn bản khổng lồ. Fine-tuning theo chỉ dẫn dạy nó làm trợ lý. RLHF và các biến thể dạy nó trả lời theo cách con người ưa thích, kèm vài tác dụng phụ như chiều lòng người hỏi và tự tin quá mức. Với AI Engineer, bài học thực dụng là: kiến thức thay đổi thì đưa vào bằng RAG hoặc tool, fine-tune chỉ dành cho hành vi và định dạng khi prompt đã hết cách.
Phần tiếp theo của series chuyển sang làm việc trực tiếp với API. Bài kế tiếp: Một request gọi LLM gồm những gì.
Xem bản tóm tắt dưới một phút trên YouTube @teduco hoặc TikTok @teducolabs, và đọc thêm các bài khác trong chuyên mục AI cho Backend Developer.
Bài viết liên quan
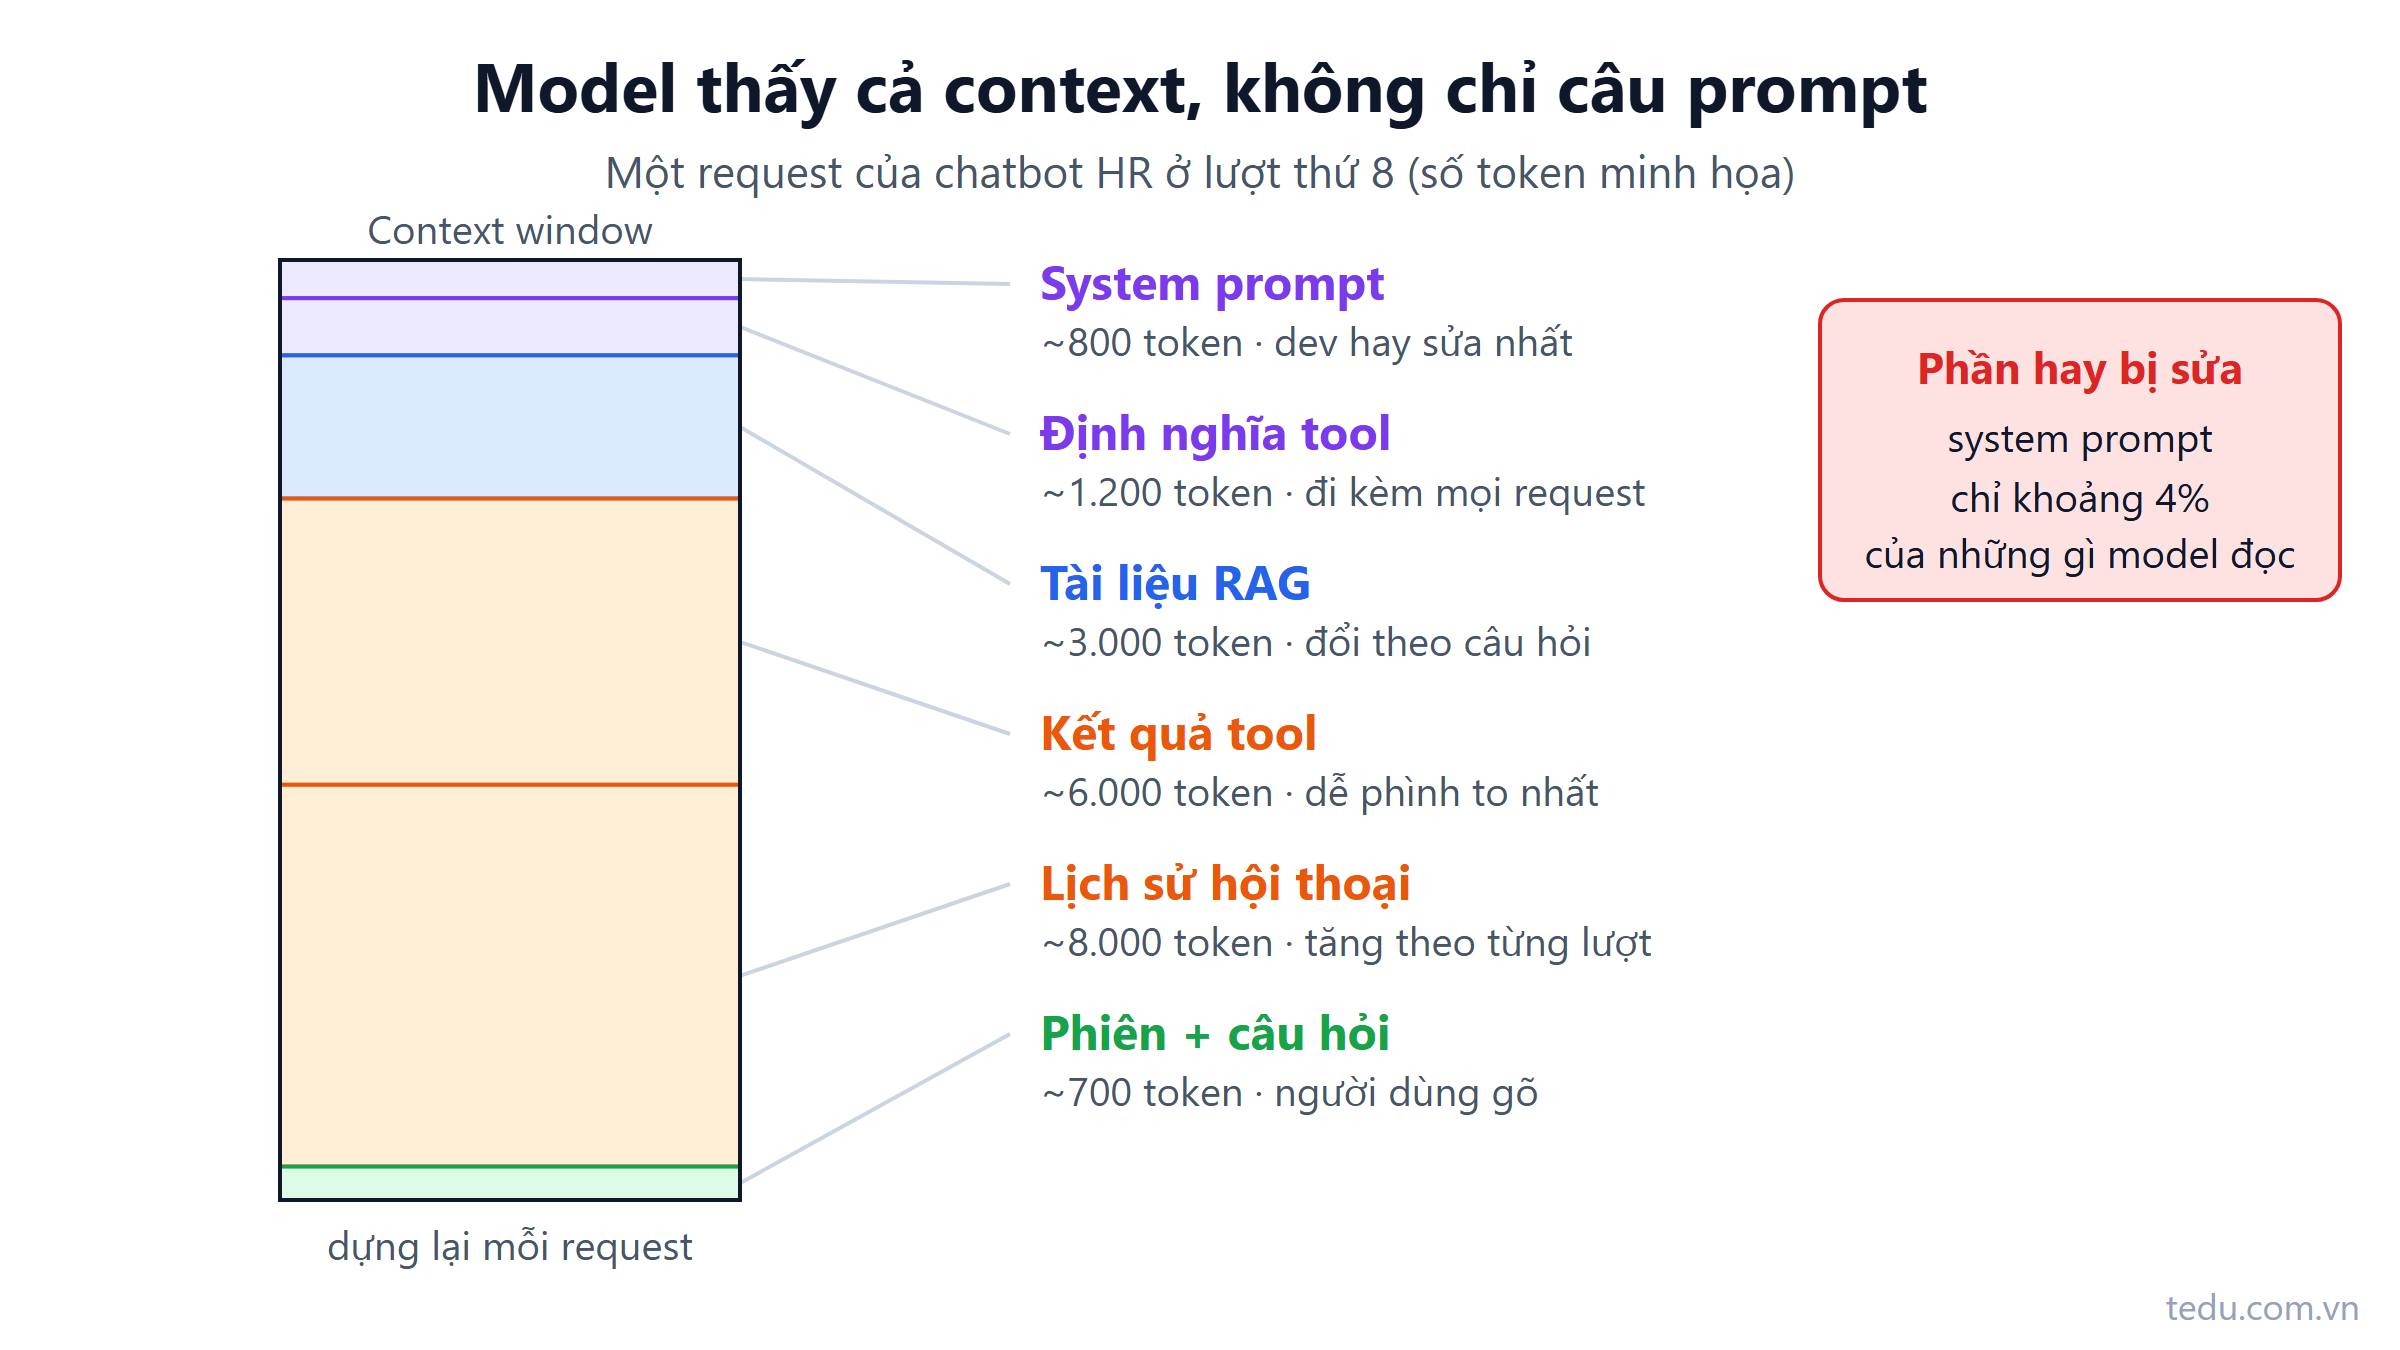
Context engineering là gì, vì sao quan trọng hơn prompt
Context engineering là quyết định cái gì vào context window, cái gì phải ra, theo thứ tự nào. Câu prompt chỉ là một phần nhỏ của những gì model thấy.
Đọc thêm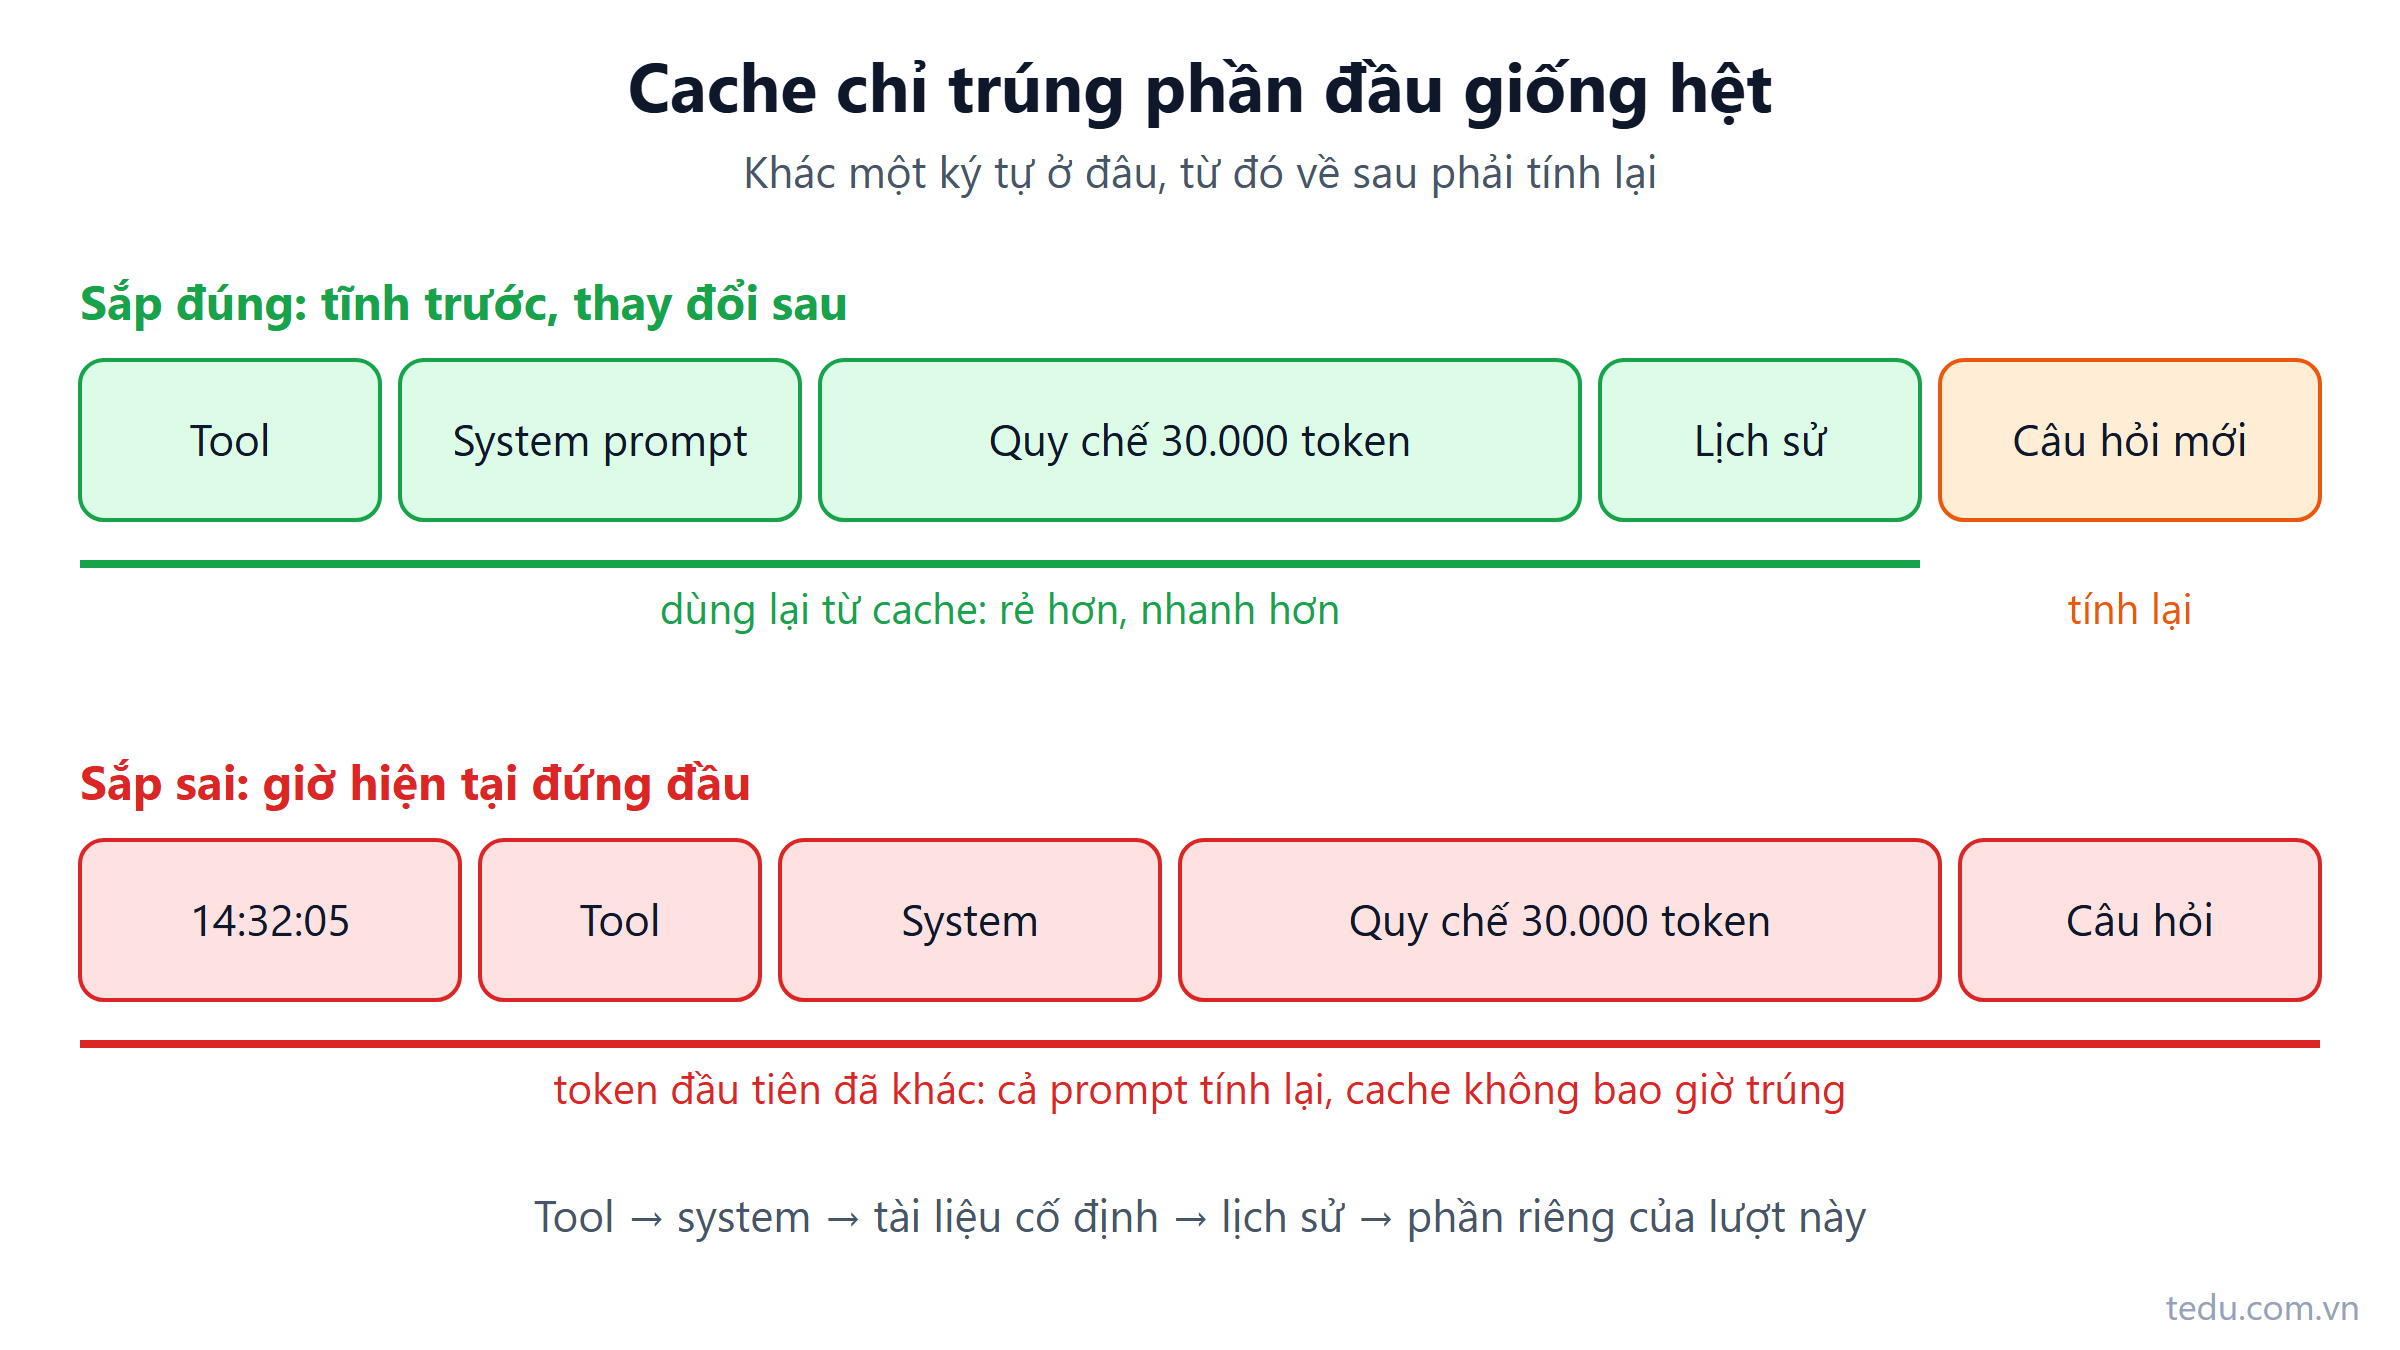
Prompt caching là gì? Cắt chi phí và độ trễ cho LLM
Prompt caching cho phép nhà cung cấp LLM dùng lại phần đầu prompt đã xử lý, giảm chi phí và độ trễ. Bài giải thích cơ chế prefix và cách sắp prompt.
Đọc thêm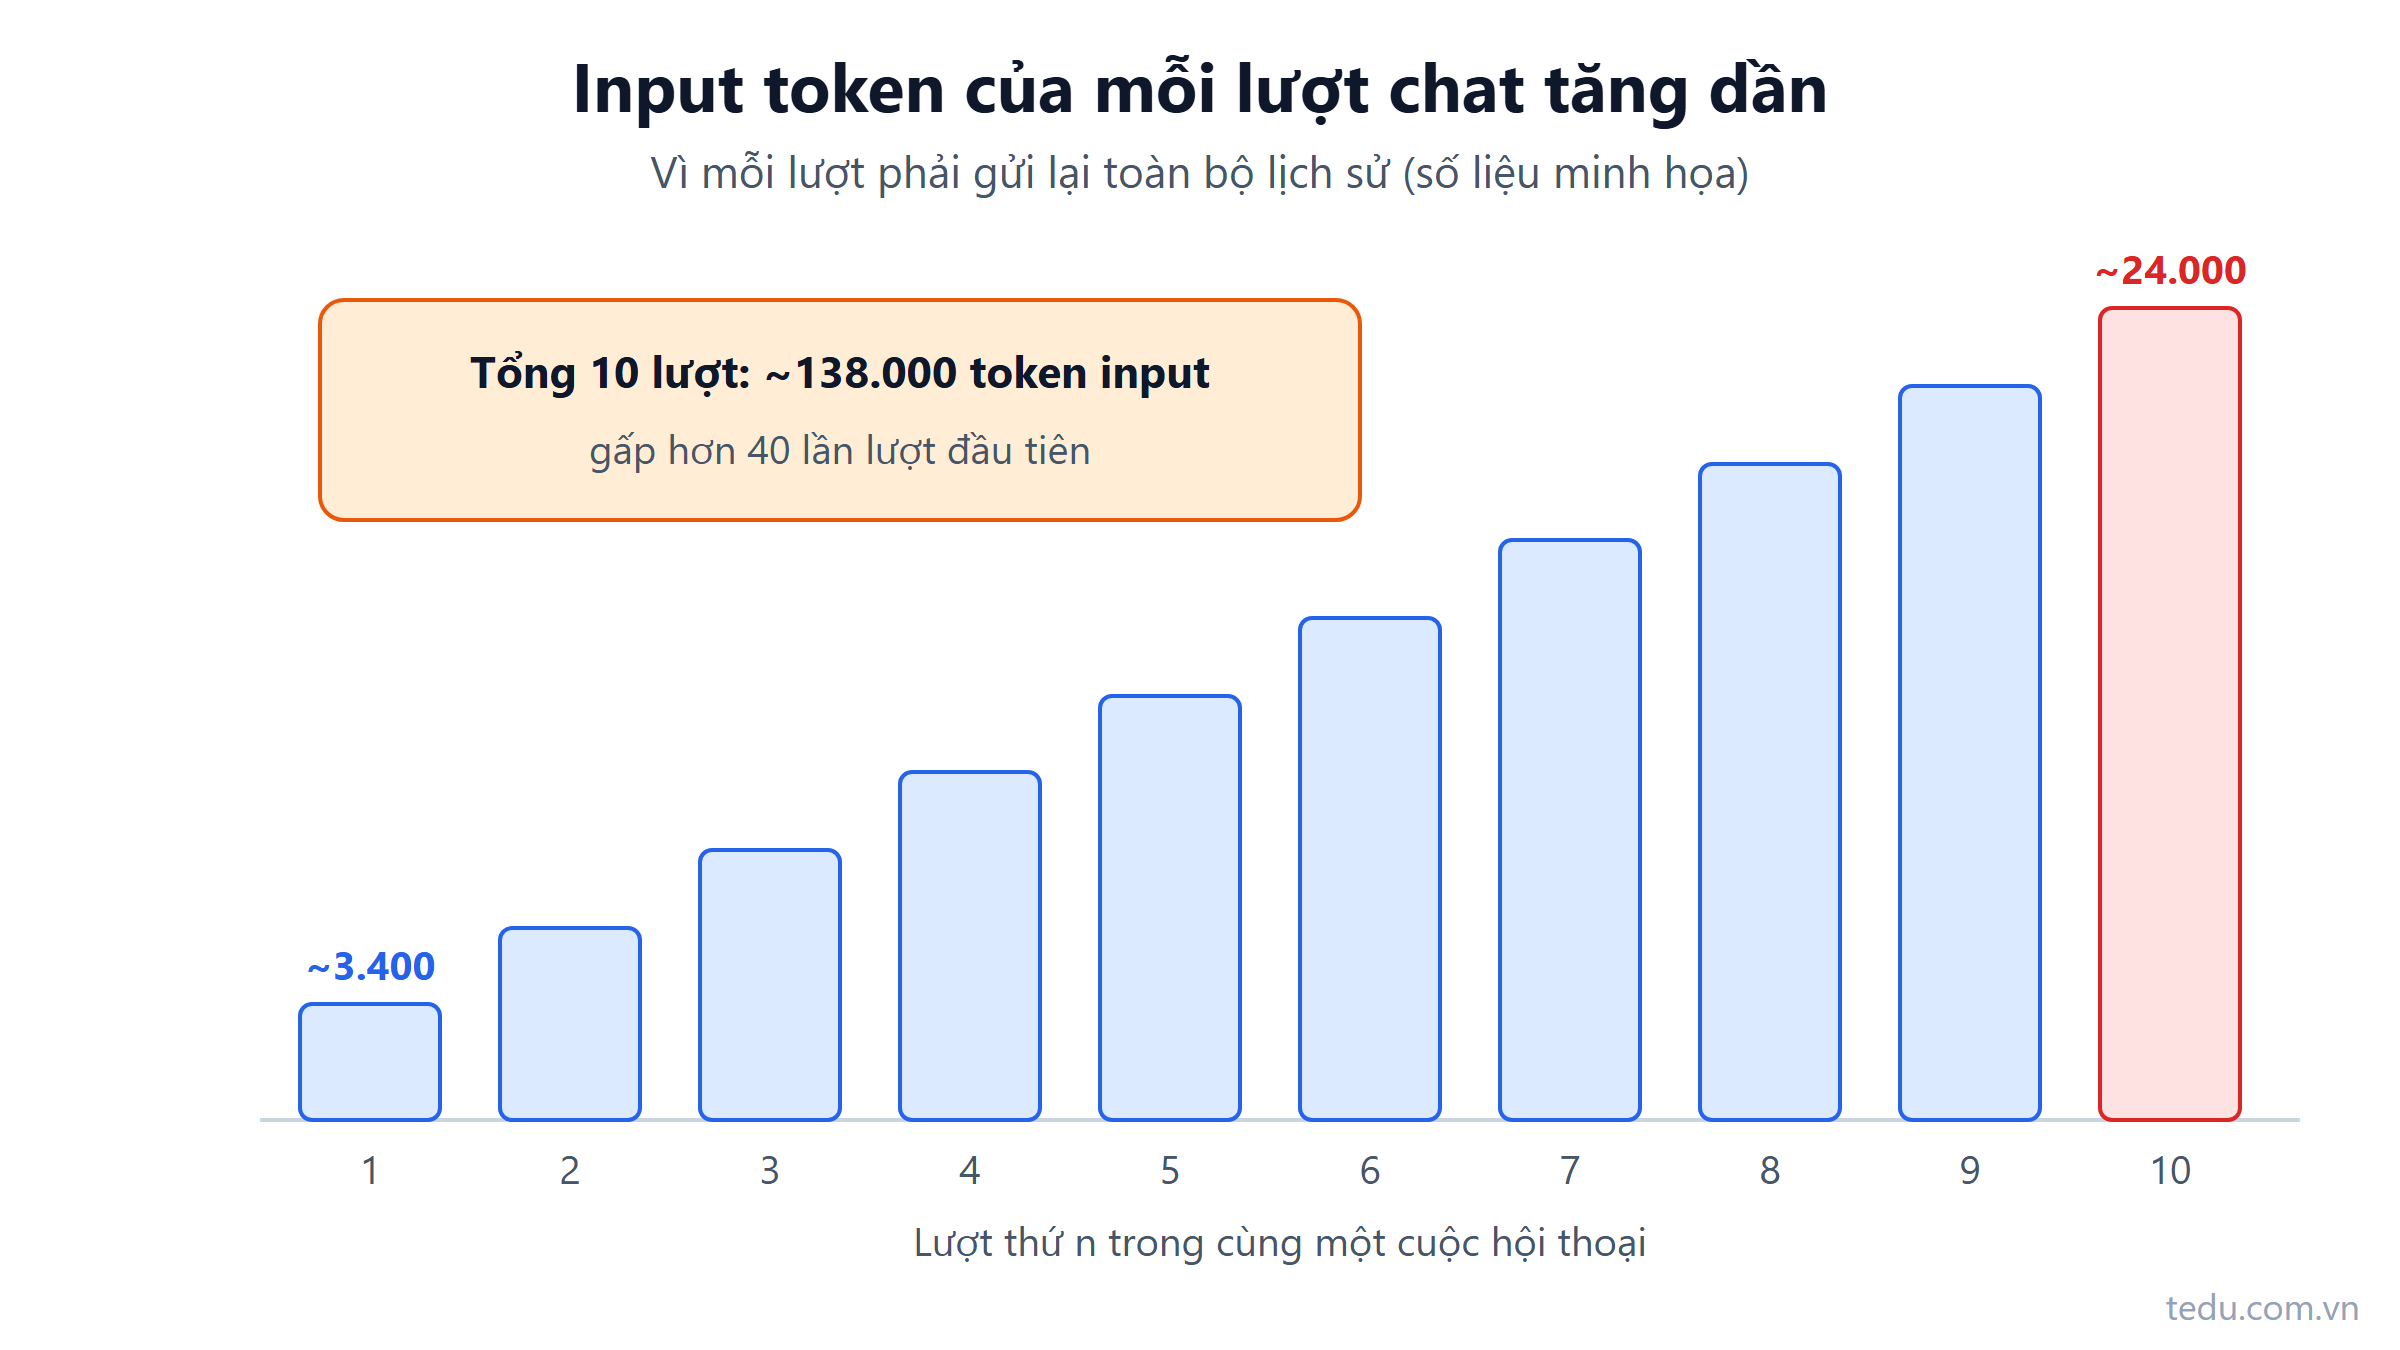
Chi phí LLM theo token: vì sao input và output giá khác nhau
Chi phí LLM tính theo token, input và output giá khác nhau. Bài hướng dẫn tự tính chi phí một chatbot, chỉ ra các khoản ẩn và cách cắt giảm.
Đọc thêm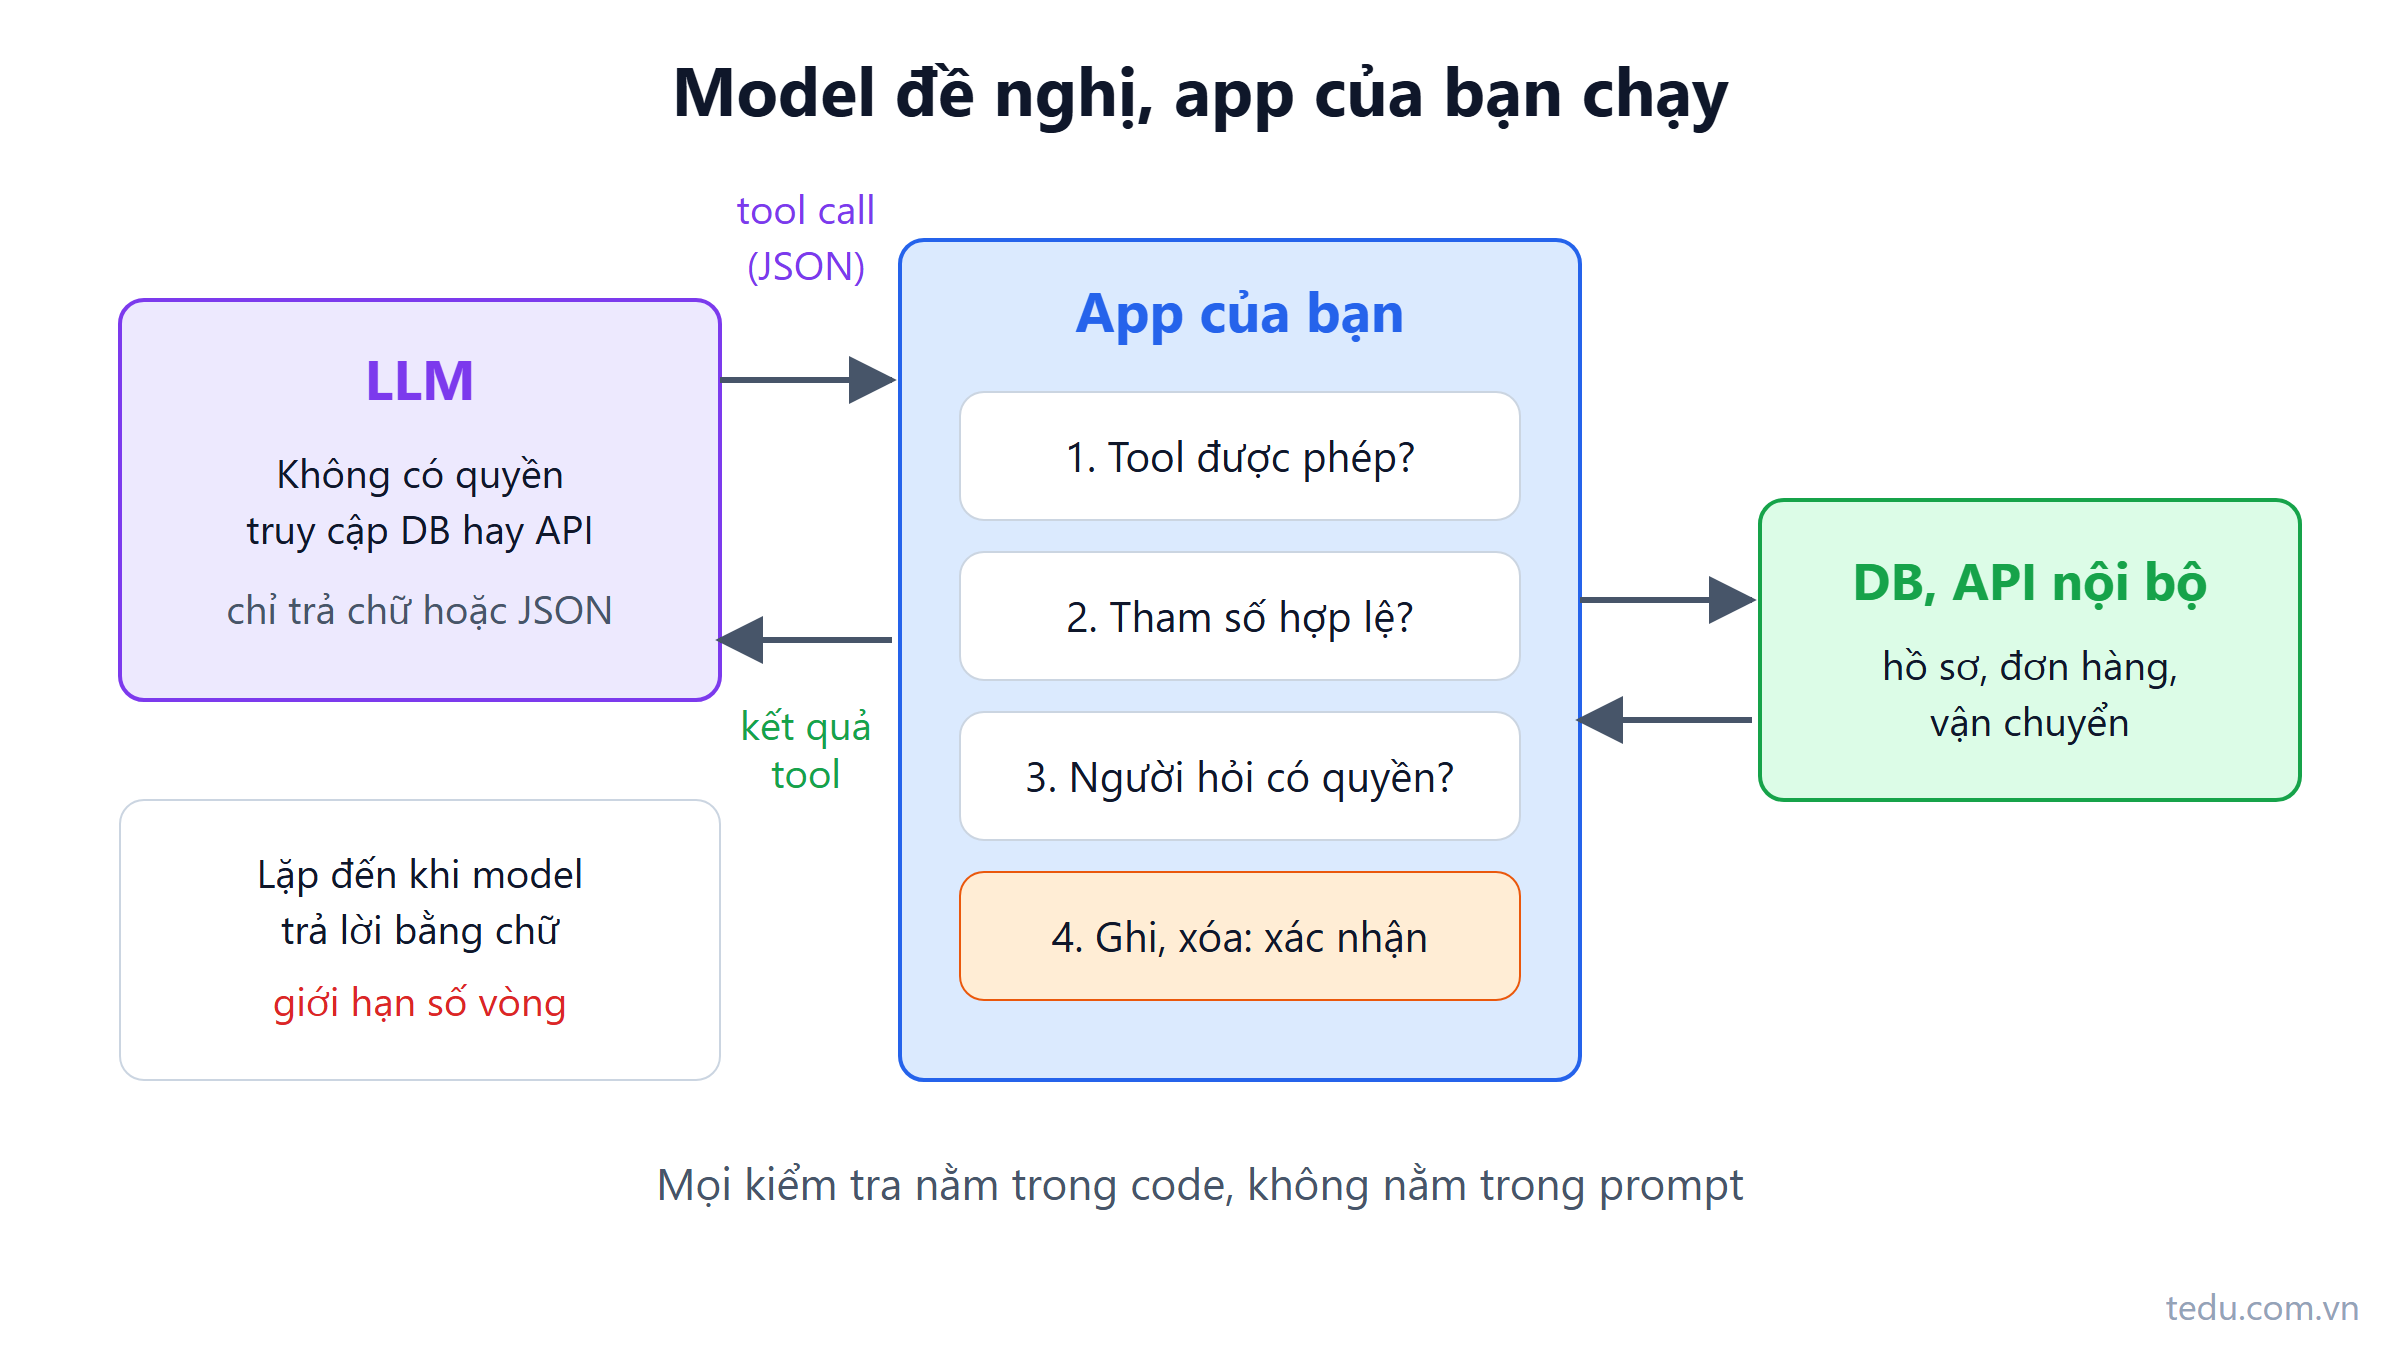
Function calling: model không tự chạy code
Function calling (tool calling) là model đề nghị gọi hàm bằng JSON, còn app của bạn validate, phân quyền và chạy. Ví dụ C# tra cứu hồ sơ, đơn hàng.
Đọc thêm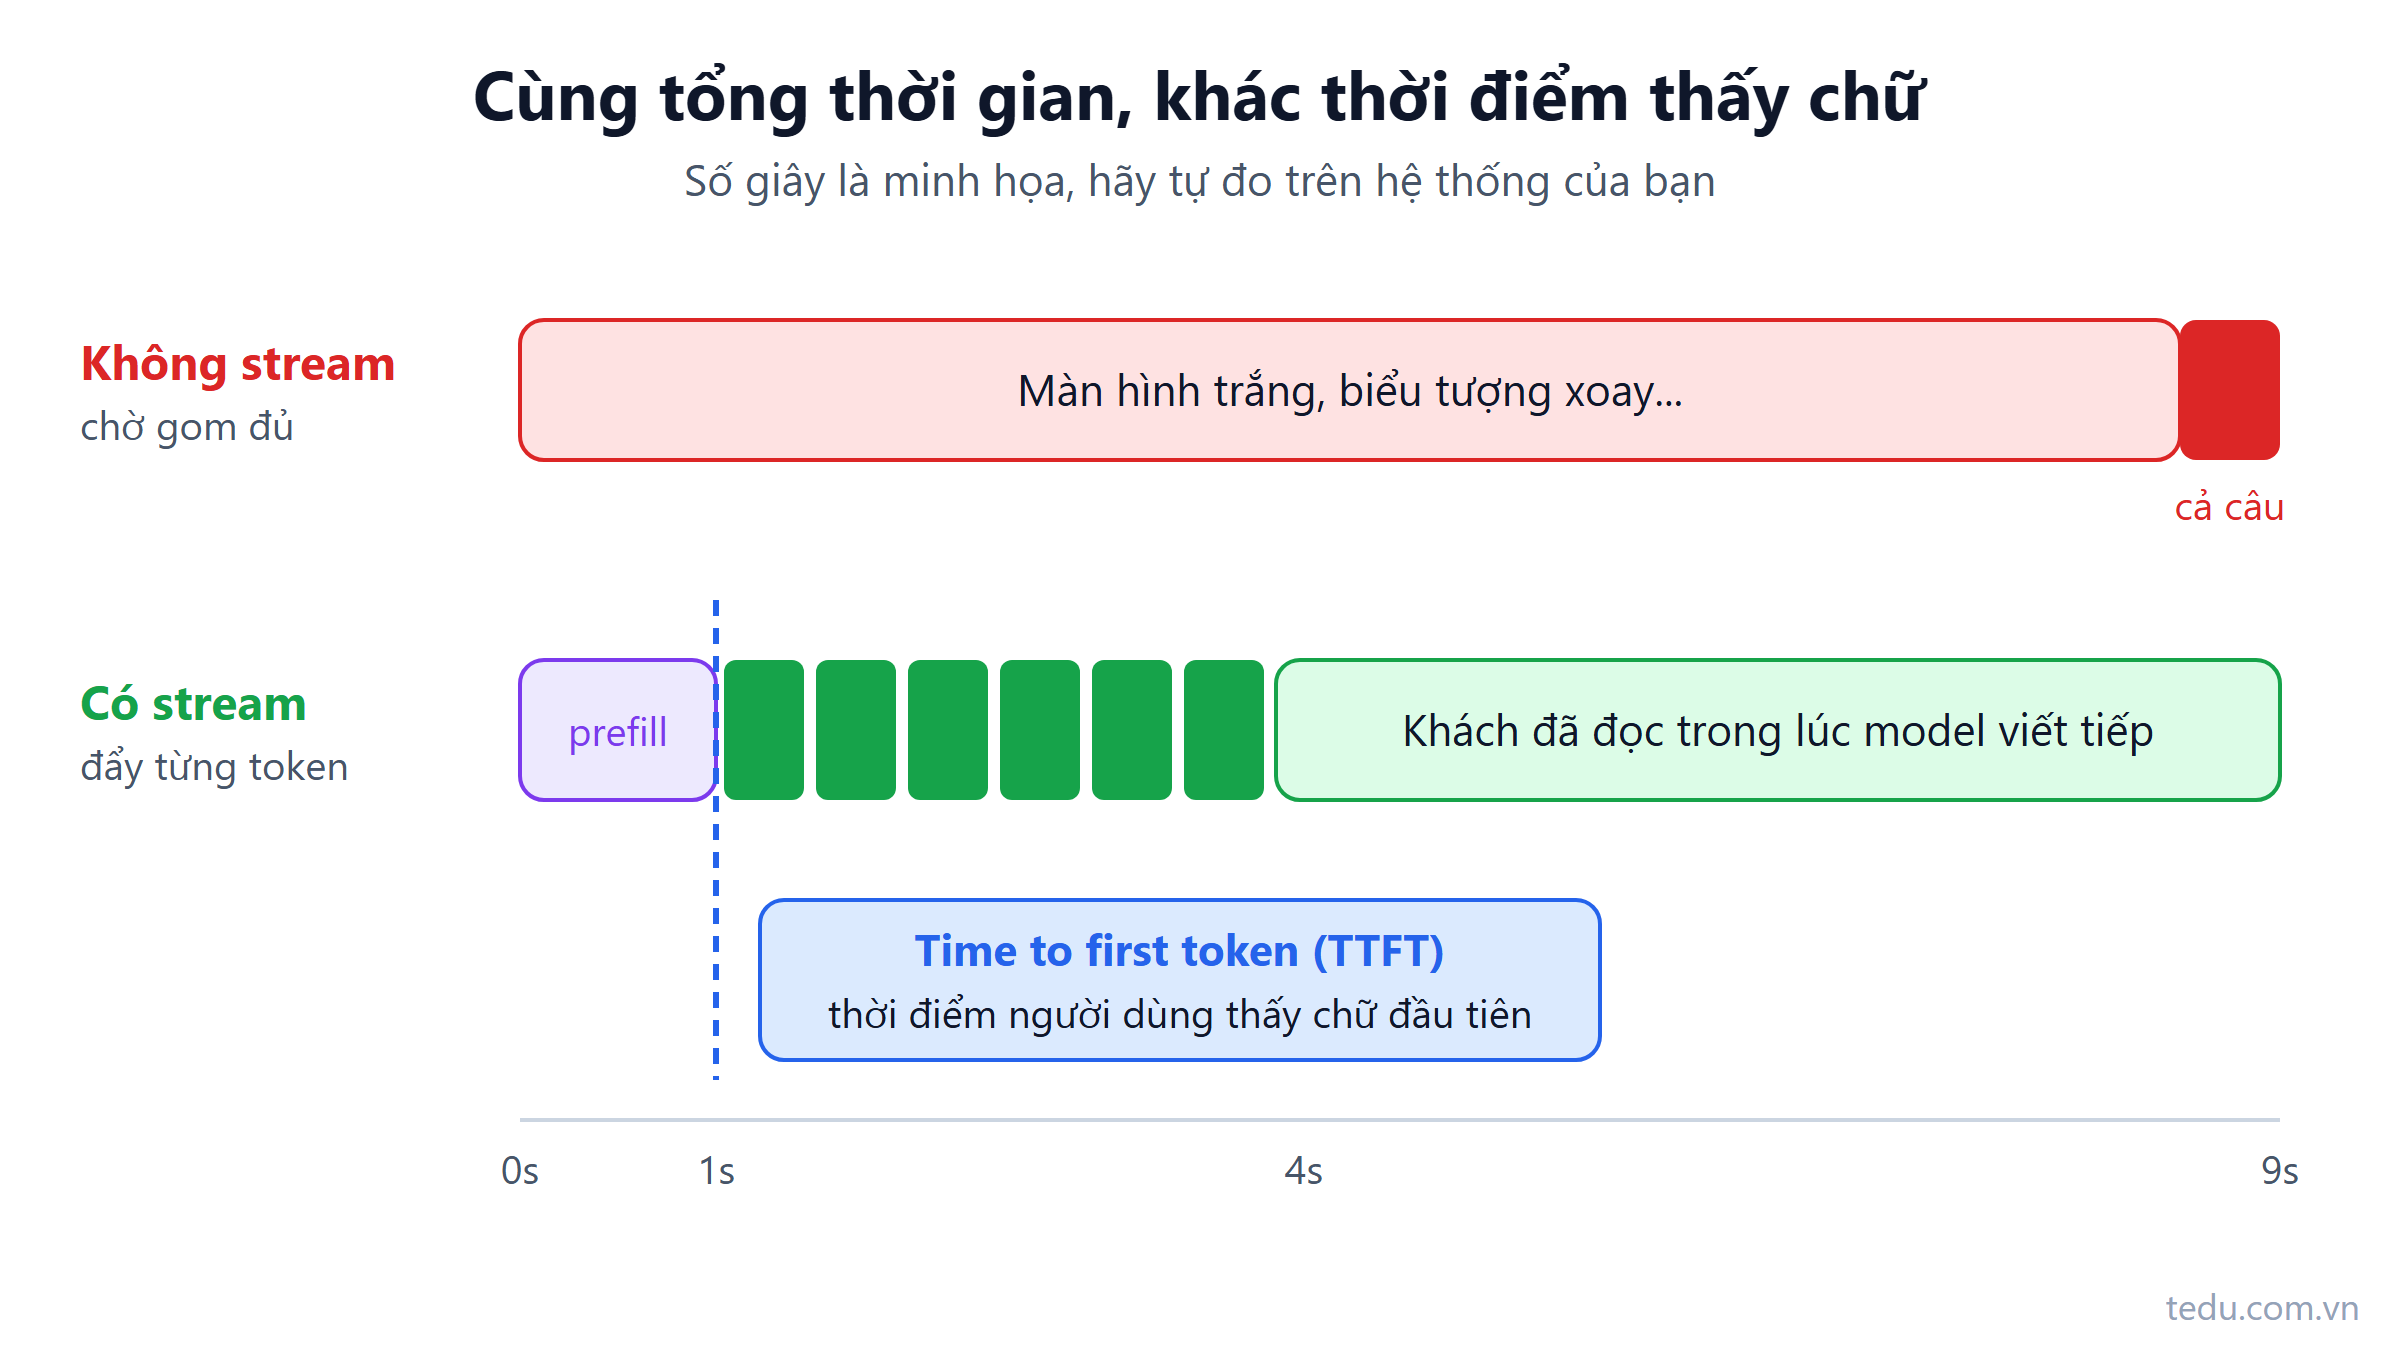
Streaming LLM: vì sao chữ hiện ra từng chút một
Streaming LLM gửi từng token về ngay khi model sinh ra, nên người dùng thấy chữ sau 1 giây thay vì chờ 10 giây. Cơ chế SSE và code C# đầy đủ.
Đọc thêm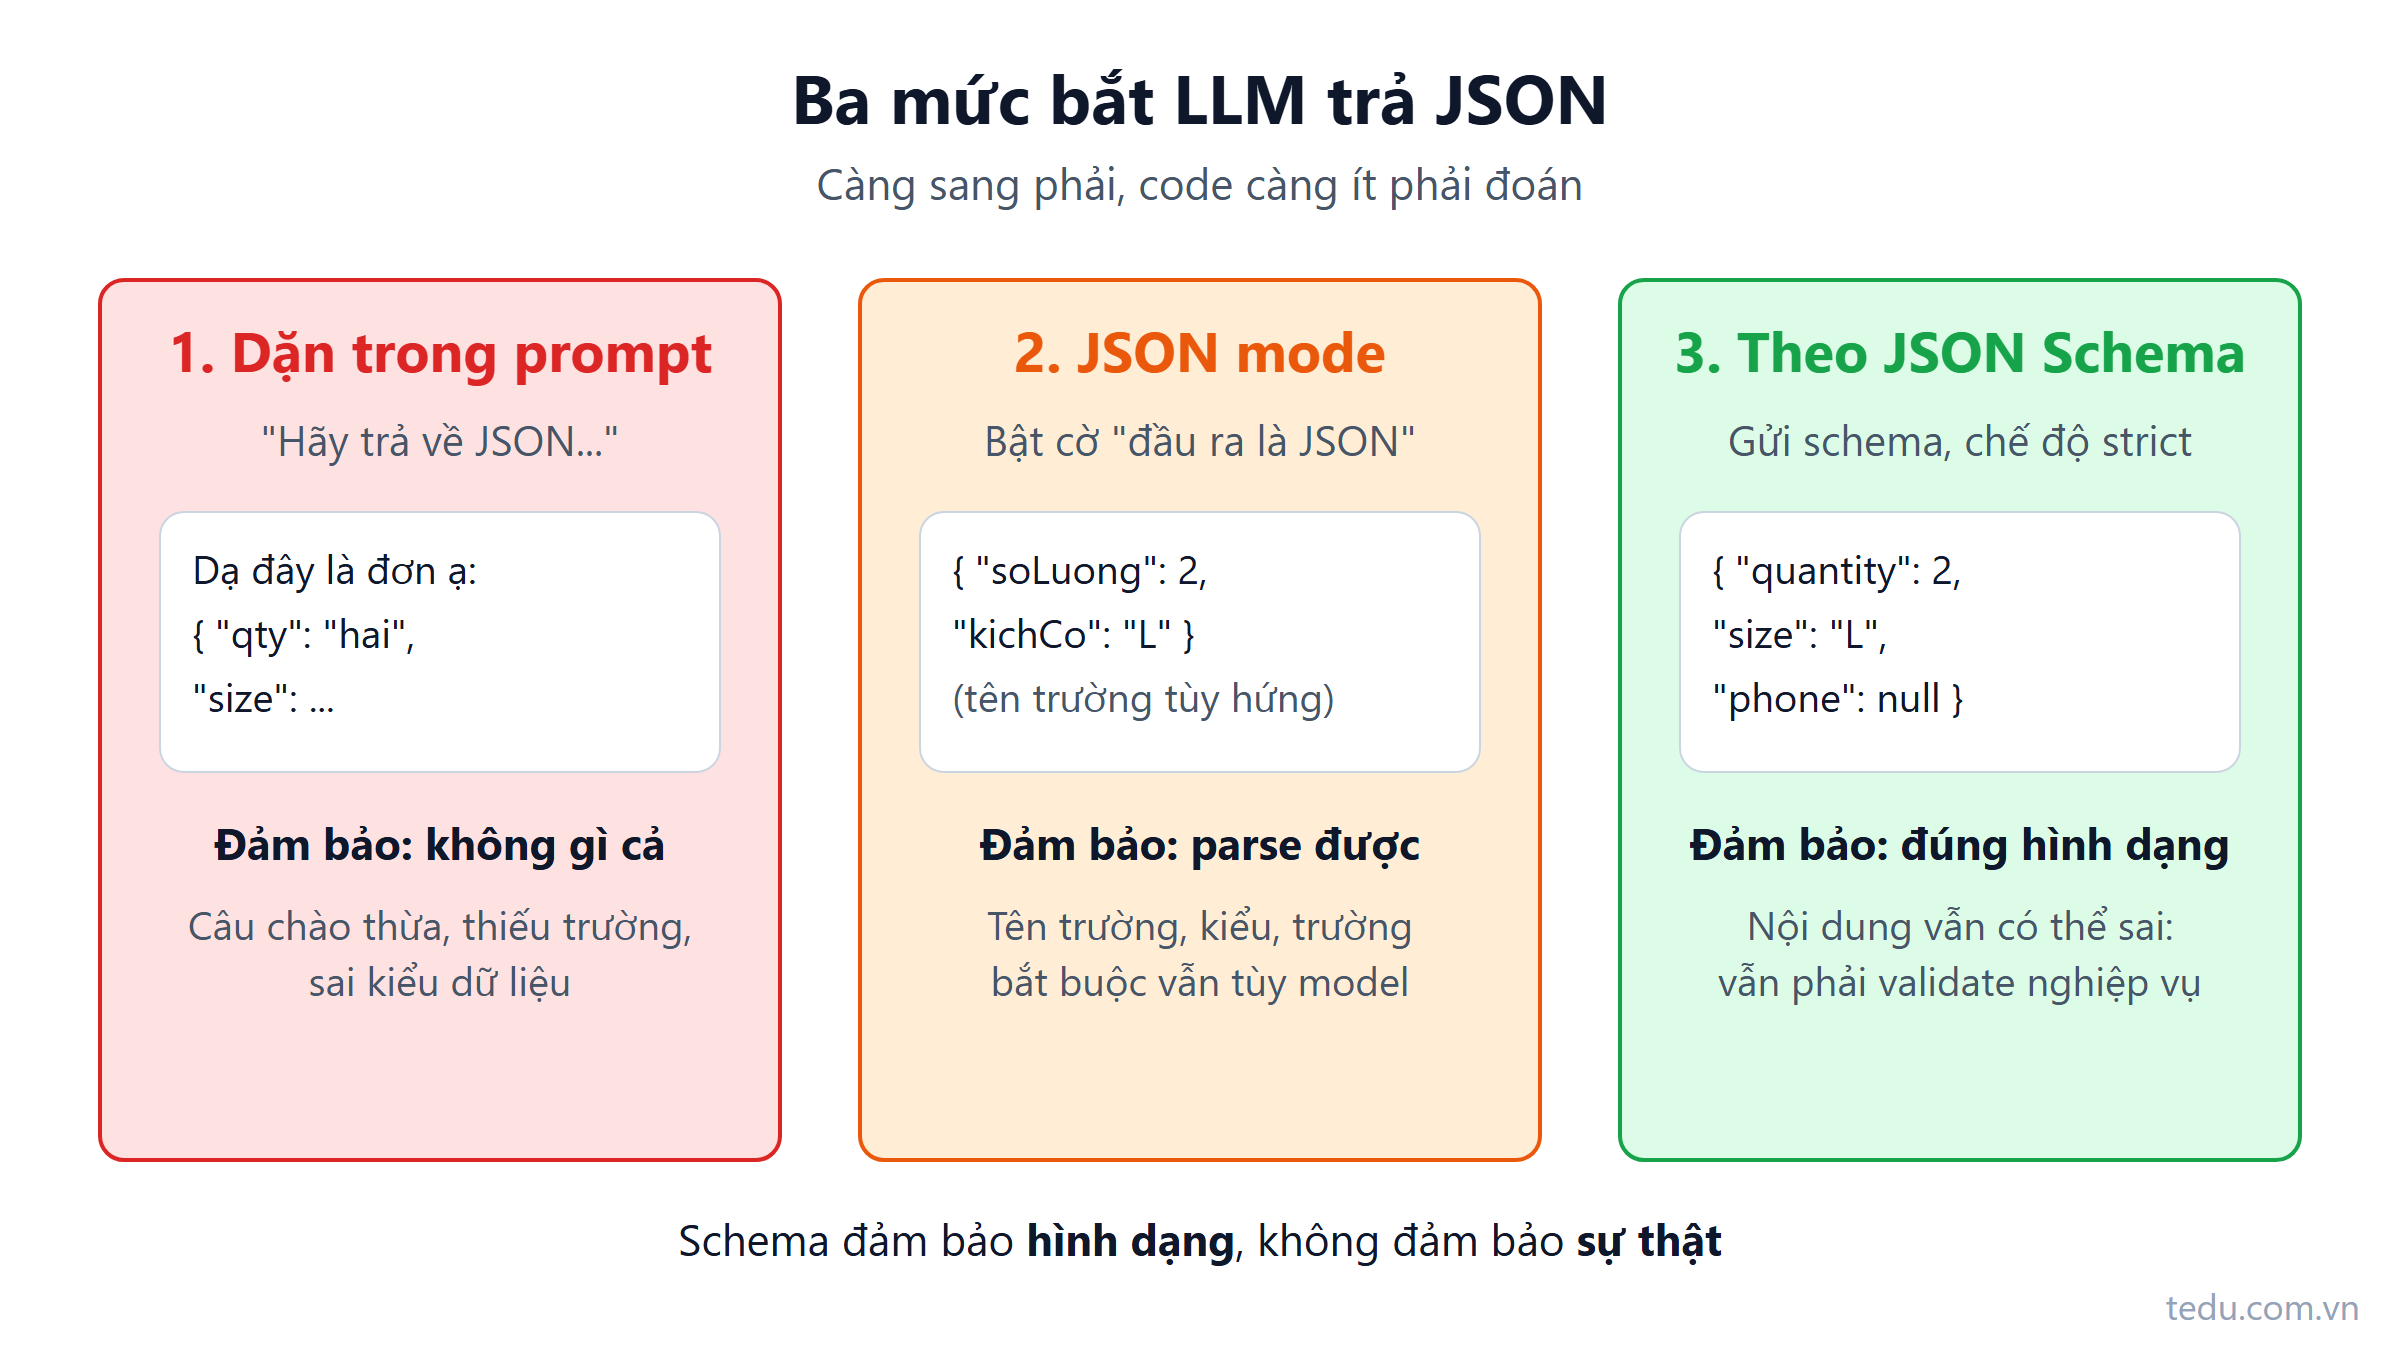
Structured output: bắt LLM trả JSON đúng schema
Structured output giúp LLM trả JSON đúng schema để code đọc được ngay. Bài so sánh 3 cách, kèm ví dụ C# bóc tách đơn hàng từ tin nhắn khách.
Đọc thêm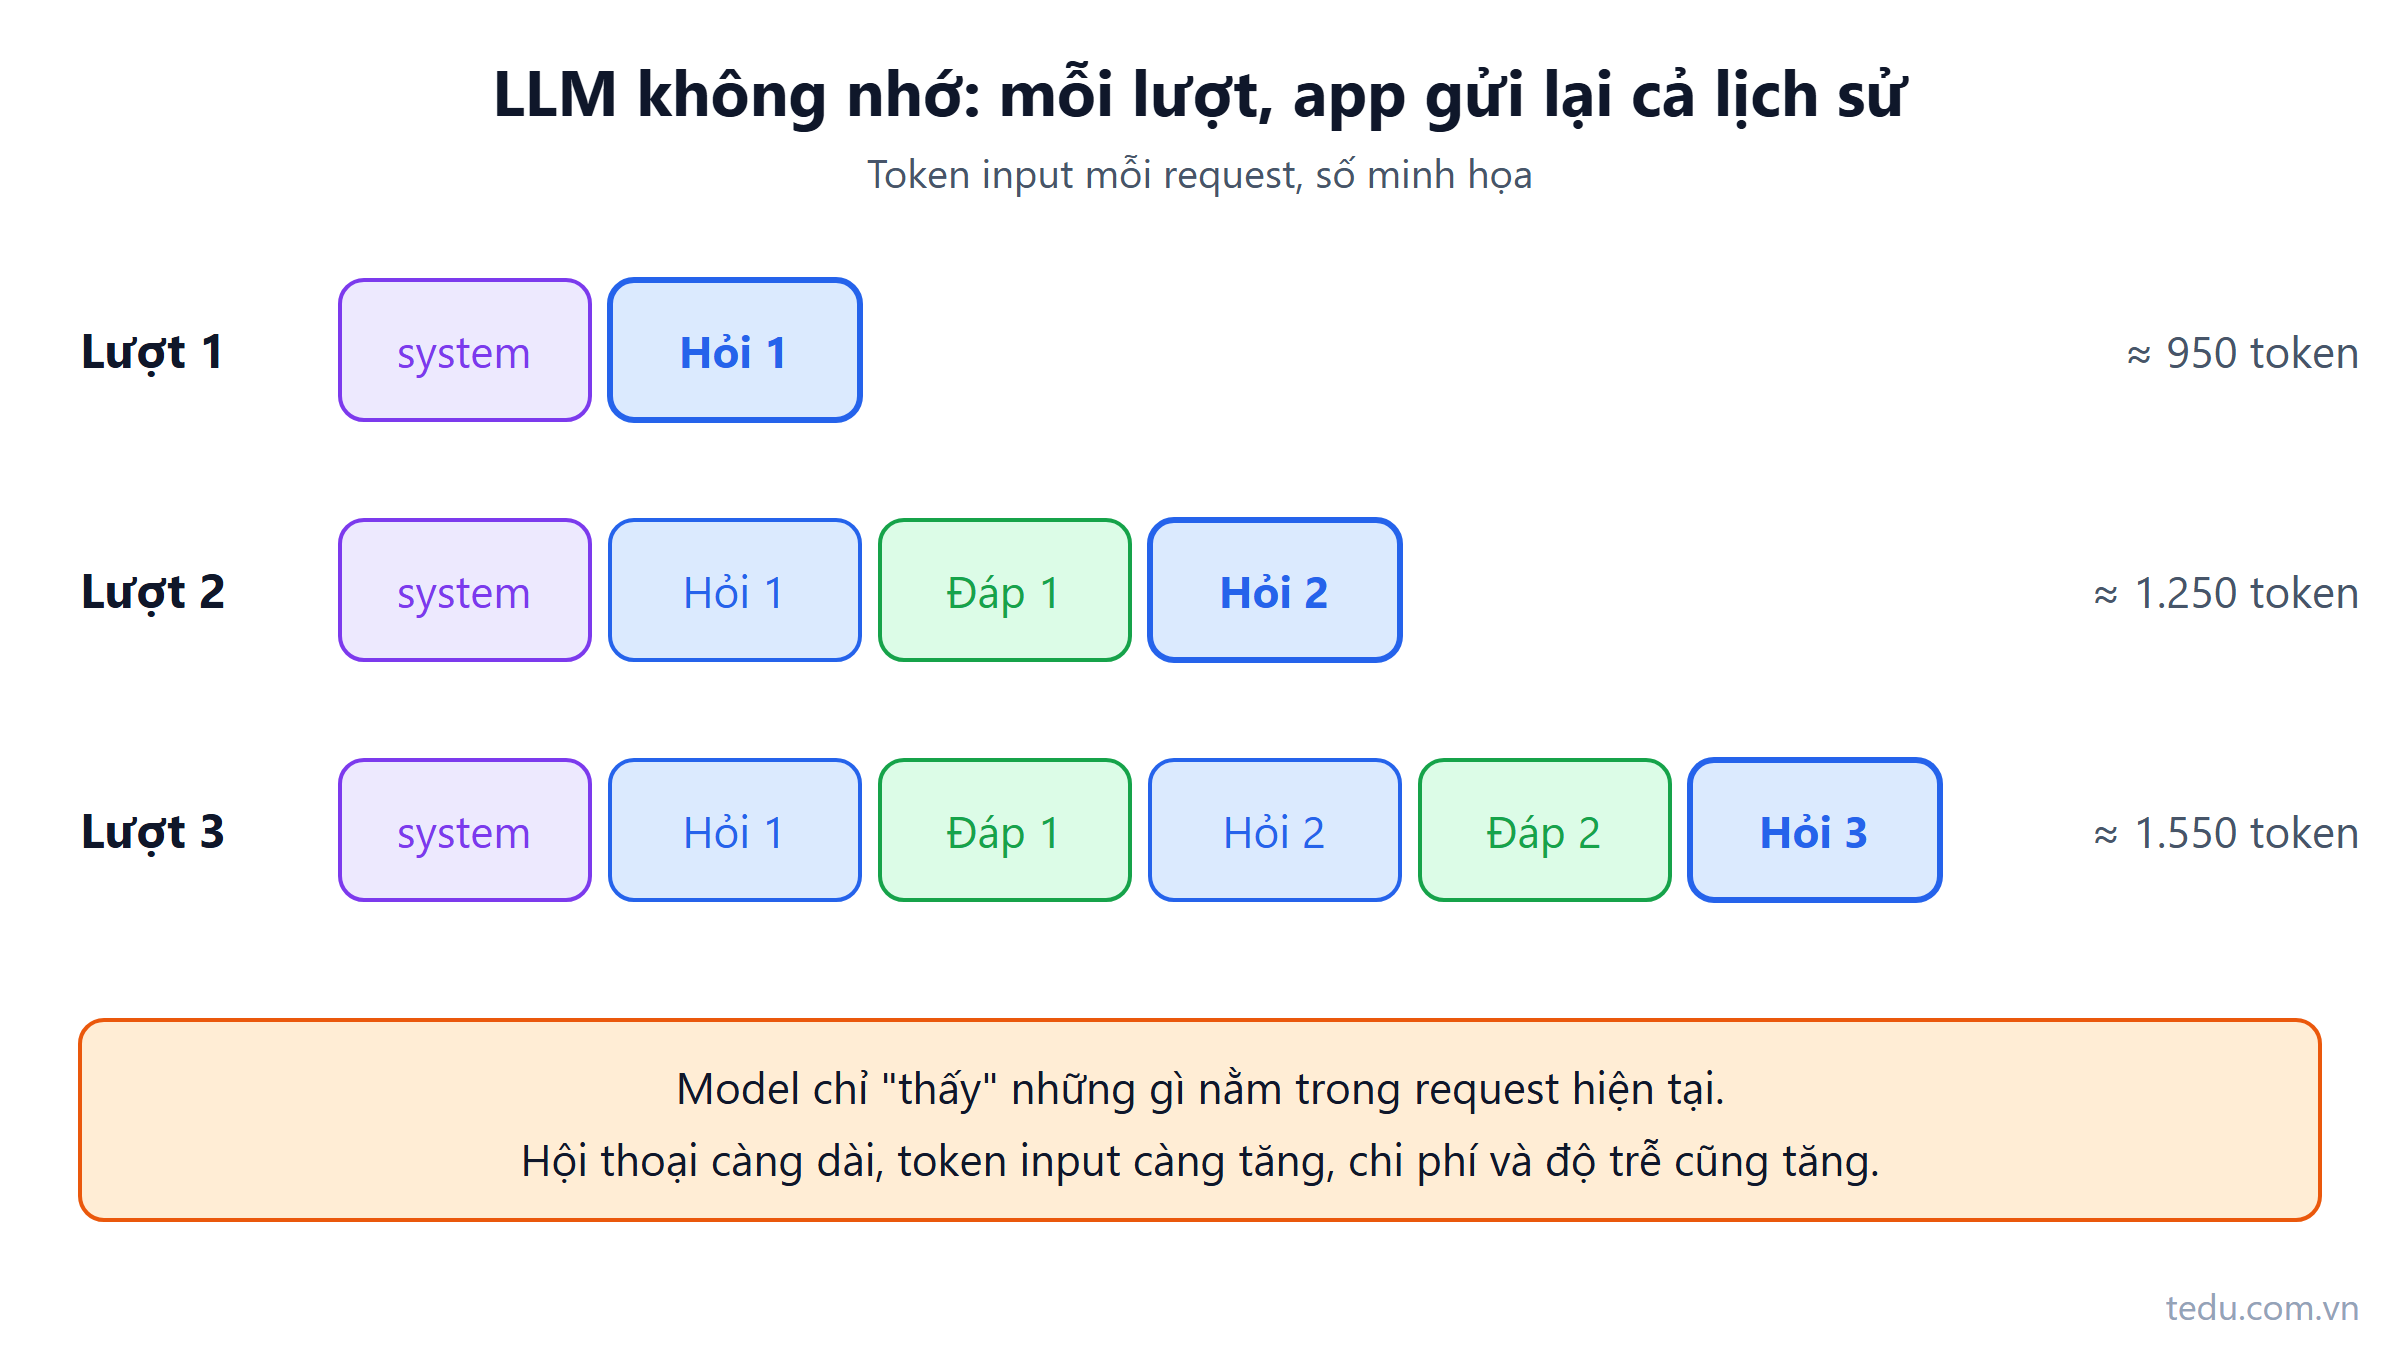
LLM là stateless: "memory" của chatbot thật ra là gửi lại lịch sử
LLM không nhớ gì giữa các request. Chatbot "nhớ" được là vì app gửi lại lịch sử hội thoại. Bài giải thích cơ chế, chi phí token và cách lưu hội thoại đúng trong backend.
Đọc thêm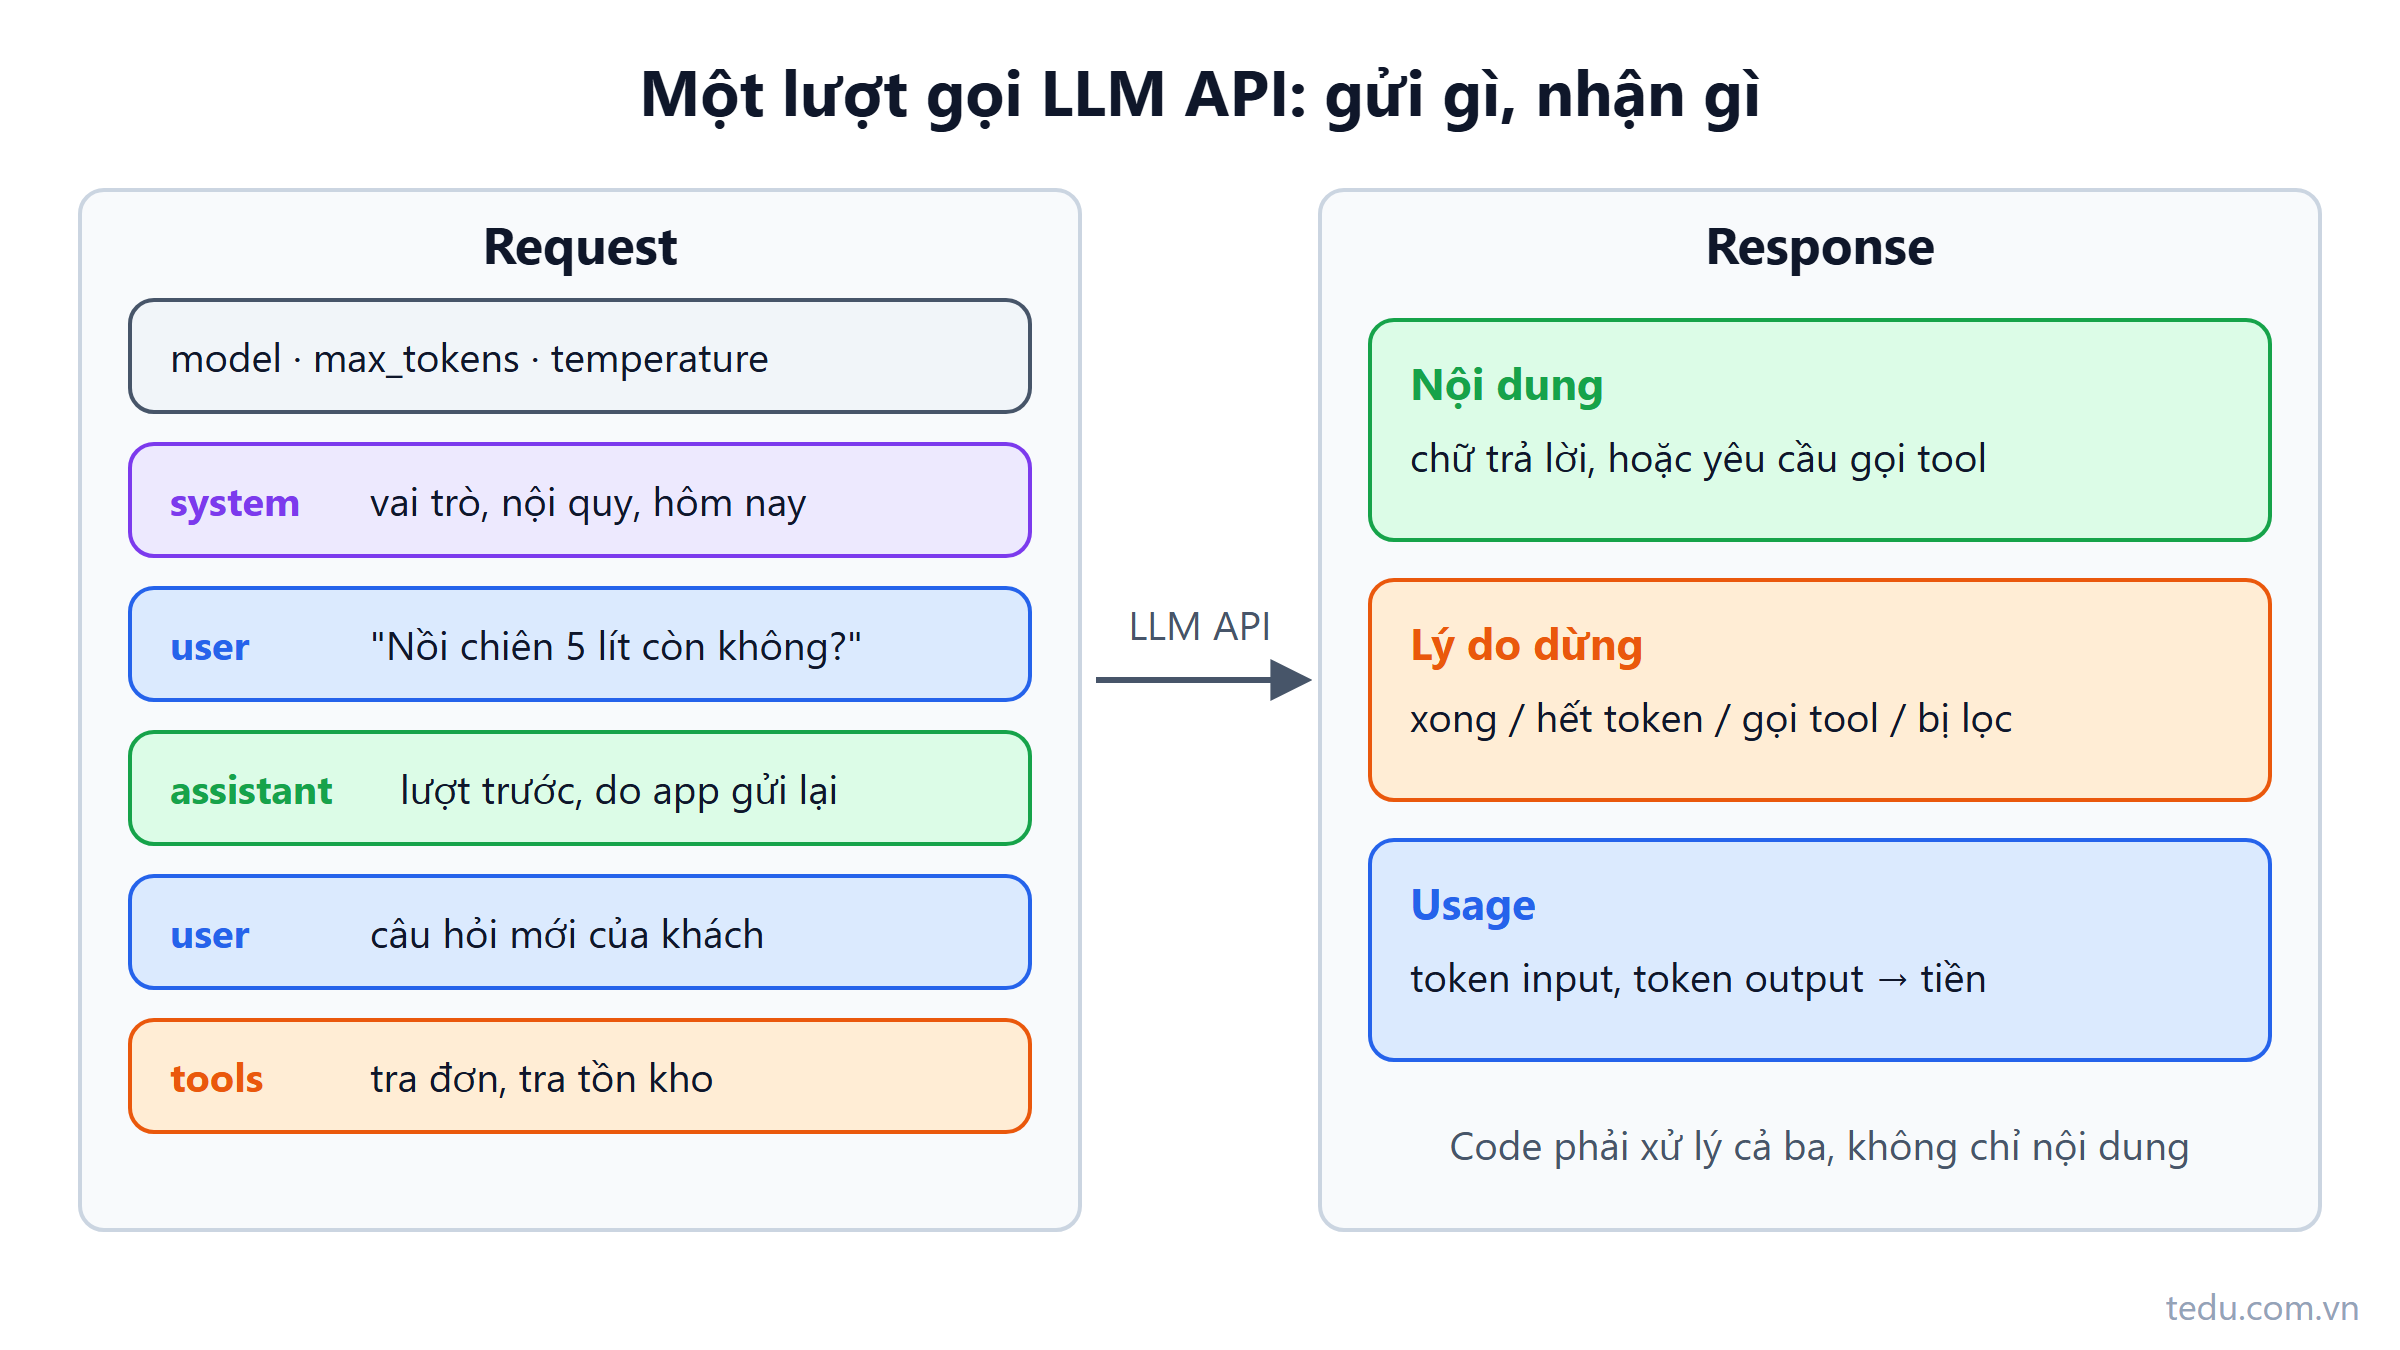
Cấu trúc request gọi LLM API: system, user, assistant gồm những gì
Một request gọi LLM API gồm model, tham số, danh sách message theo vai trò system, user, assistant và có thể có tools. Bài mổ xẻ từng phần kèm code C# gọi HTTP thô.
Đọc thêm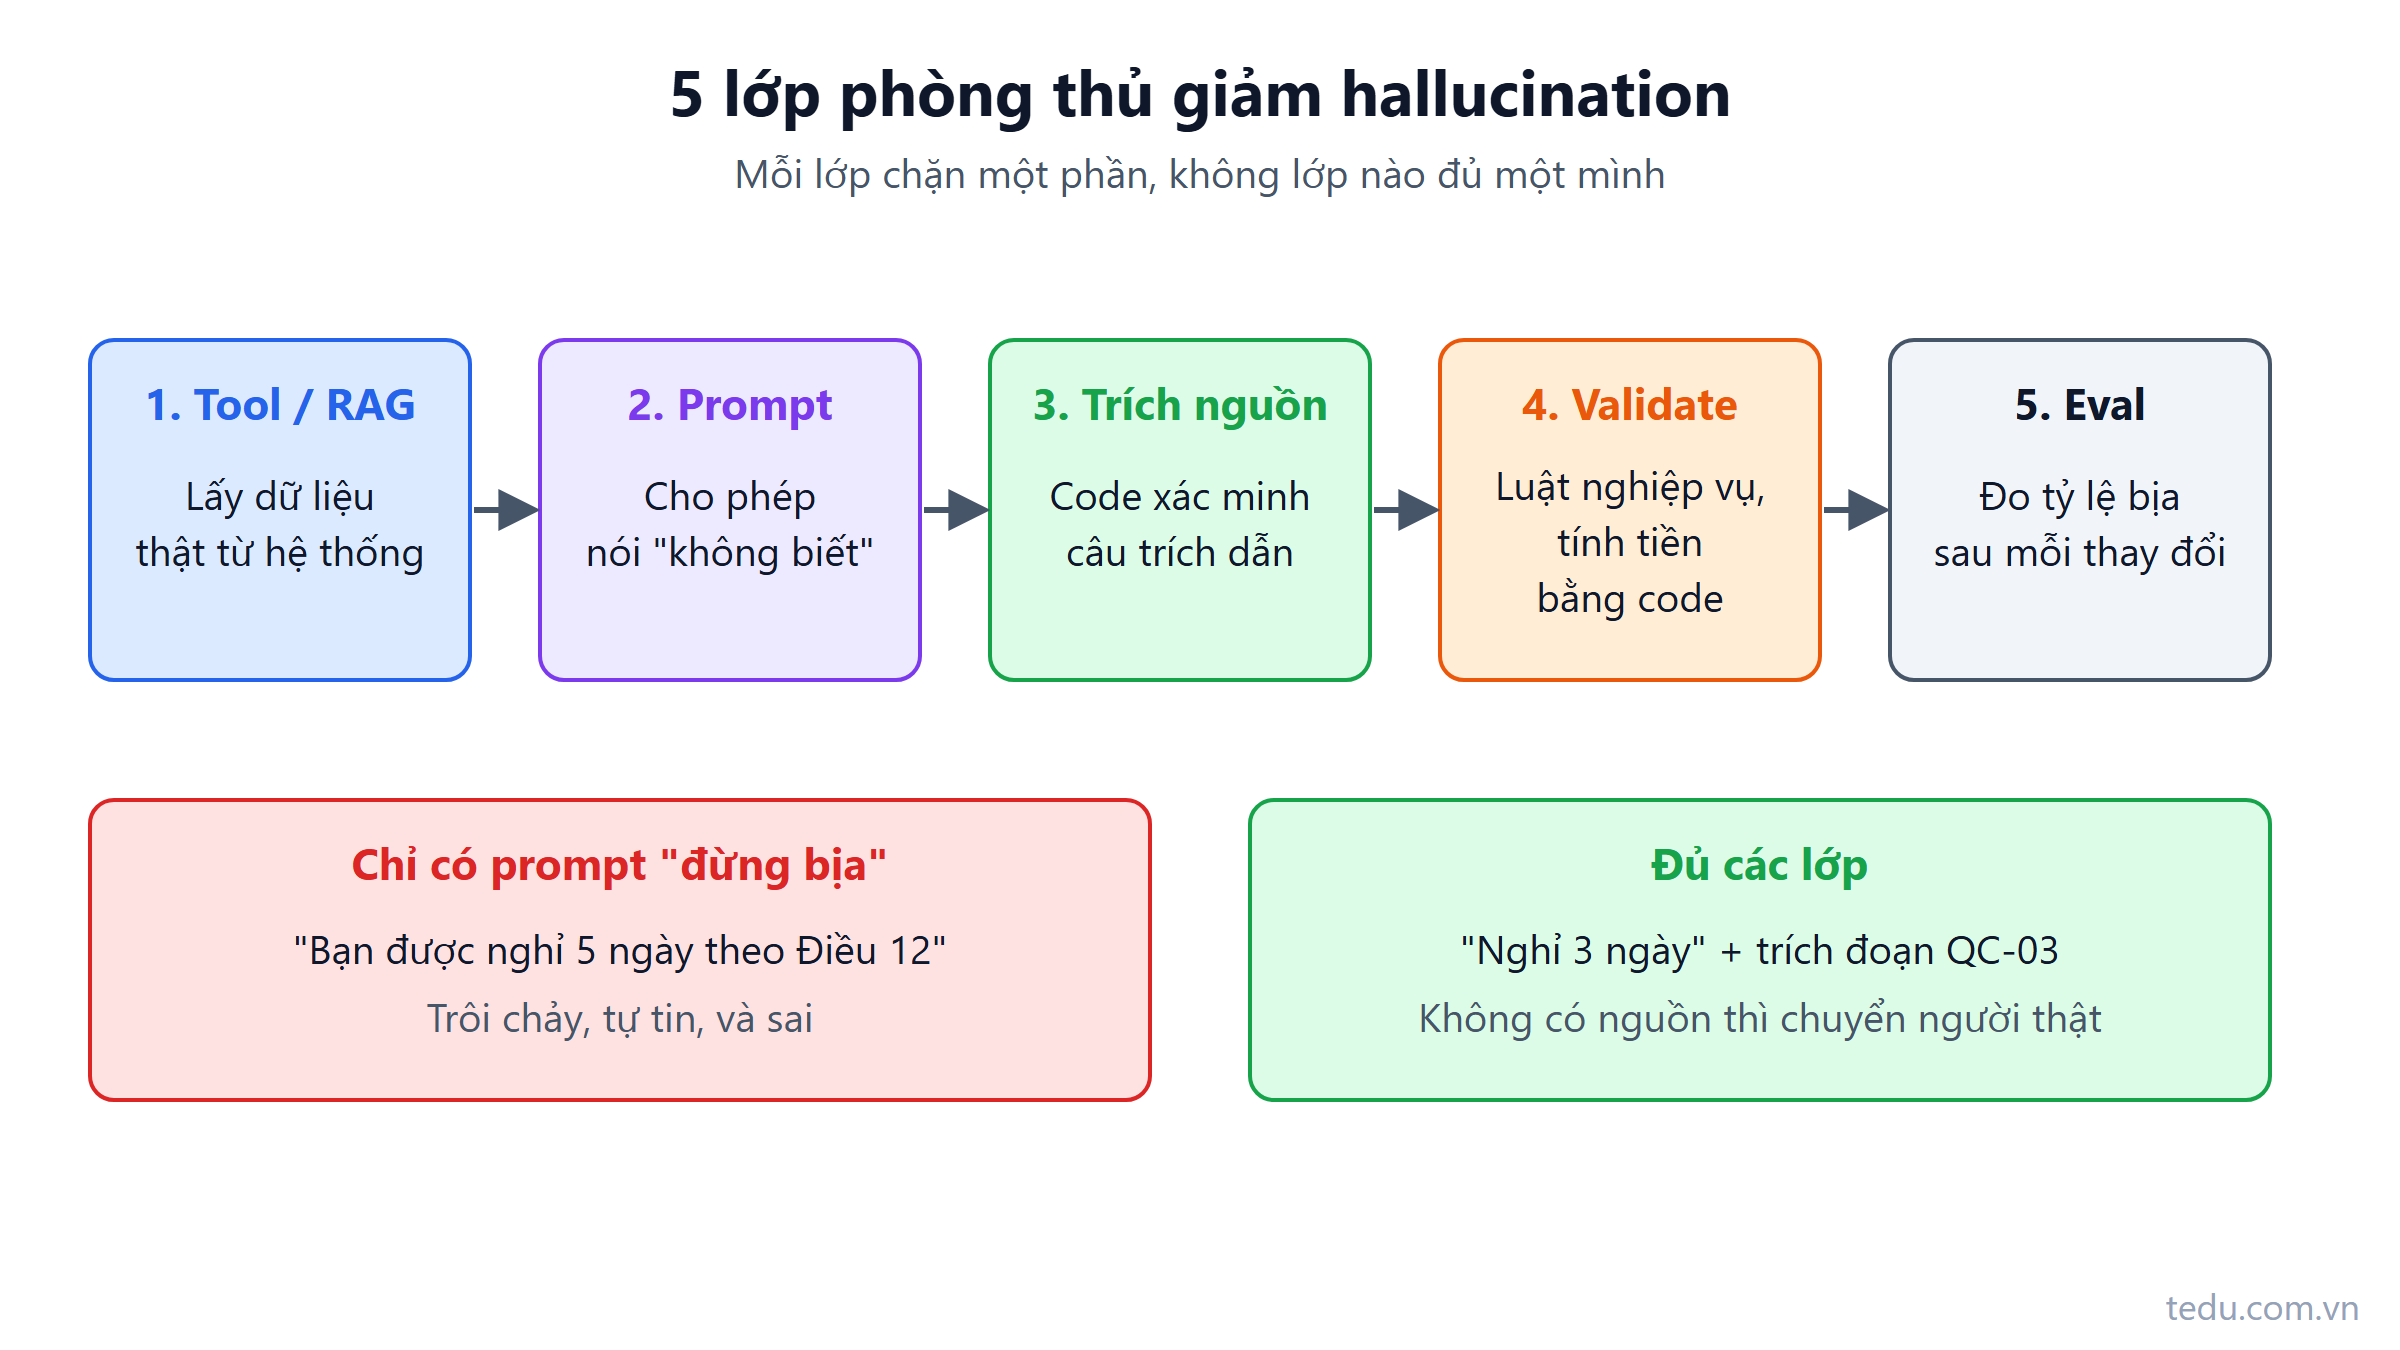
Hallucination là gì? Vì sao model "bịa" và cách hạn chế
Hallucination là khi LLM trả lời trôi chảy nhưng sai sự thật. Bài giải thích vì sao về bản chất model luôn có thể bịa, các dạng hay gặp và cách chặn bằng thiết kế hệ thống.
Đọc thêm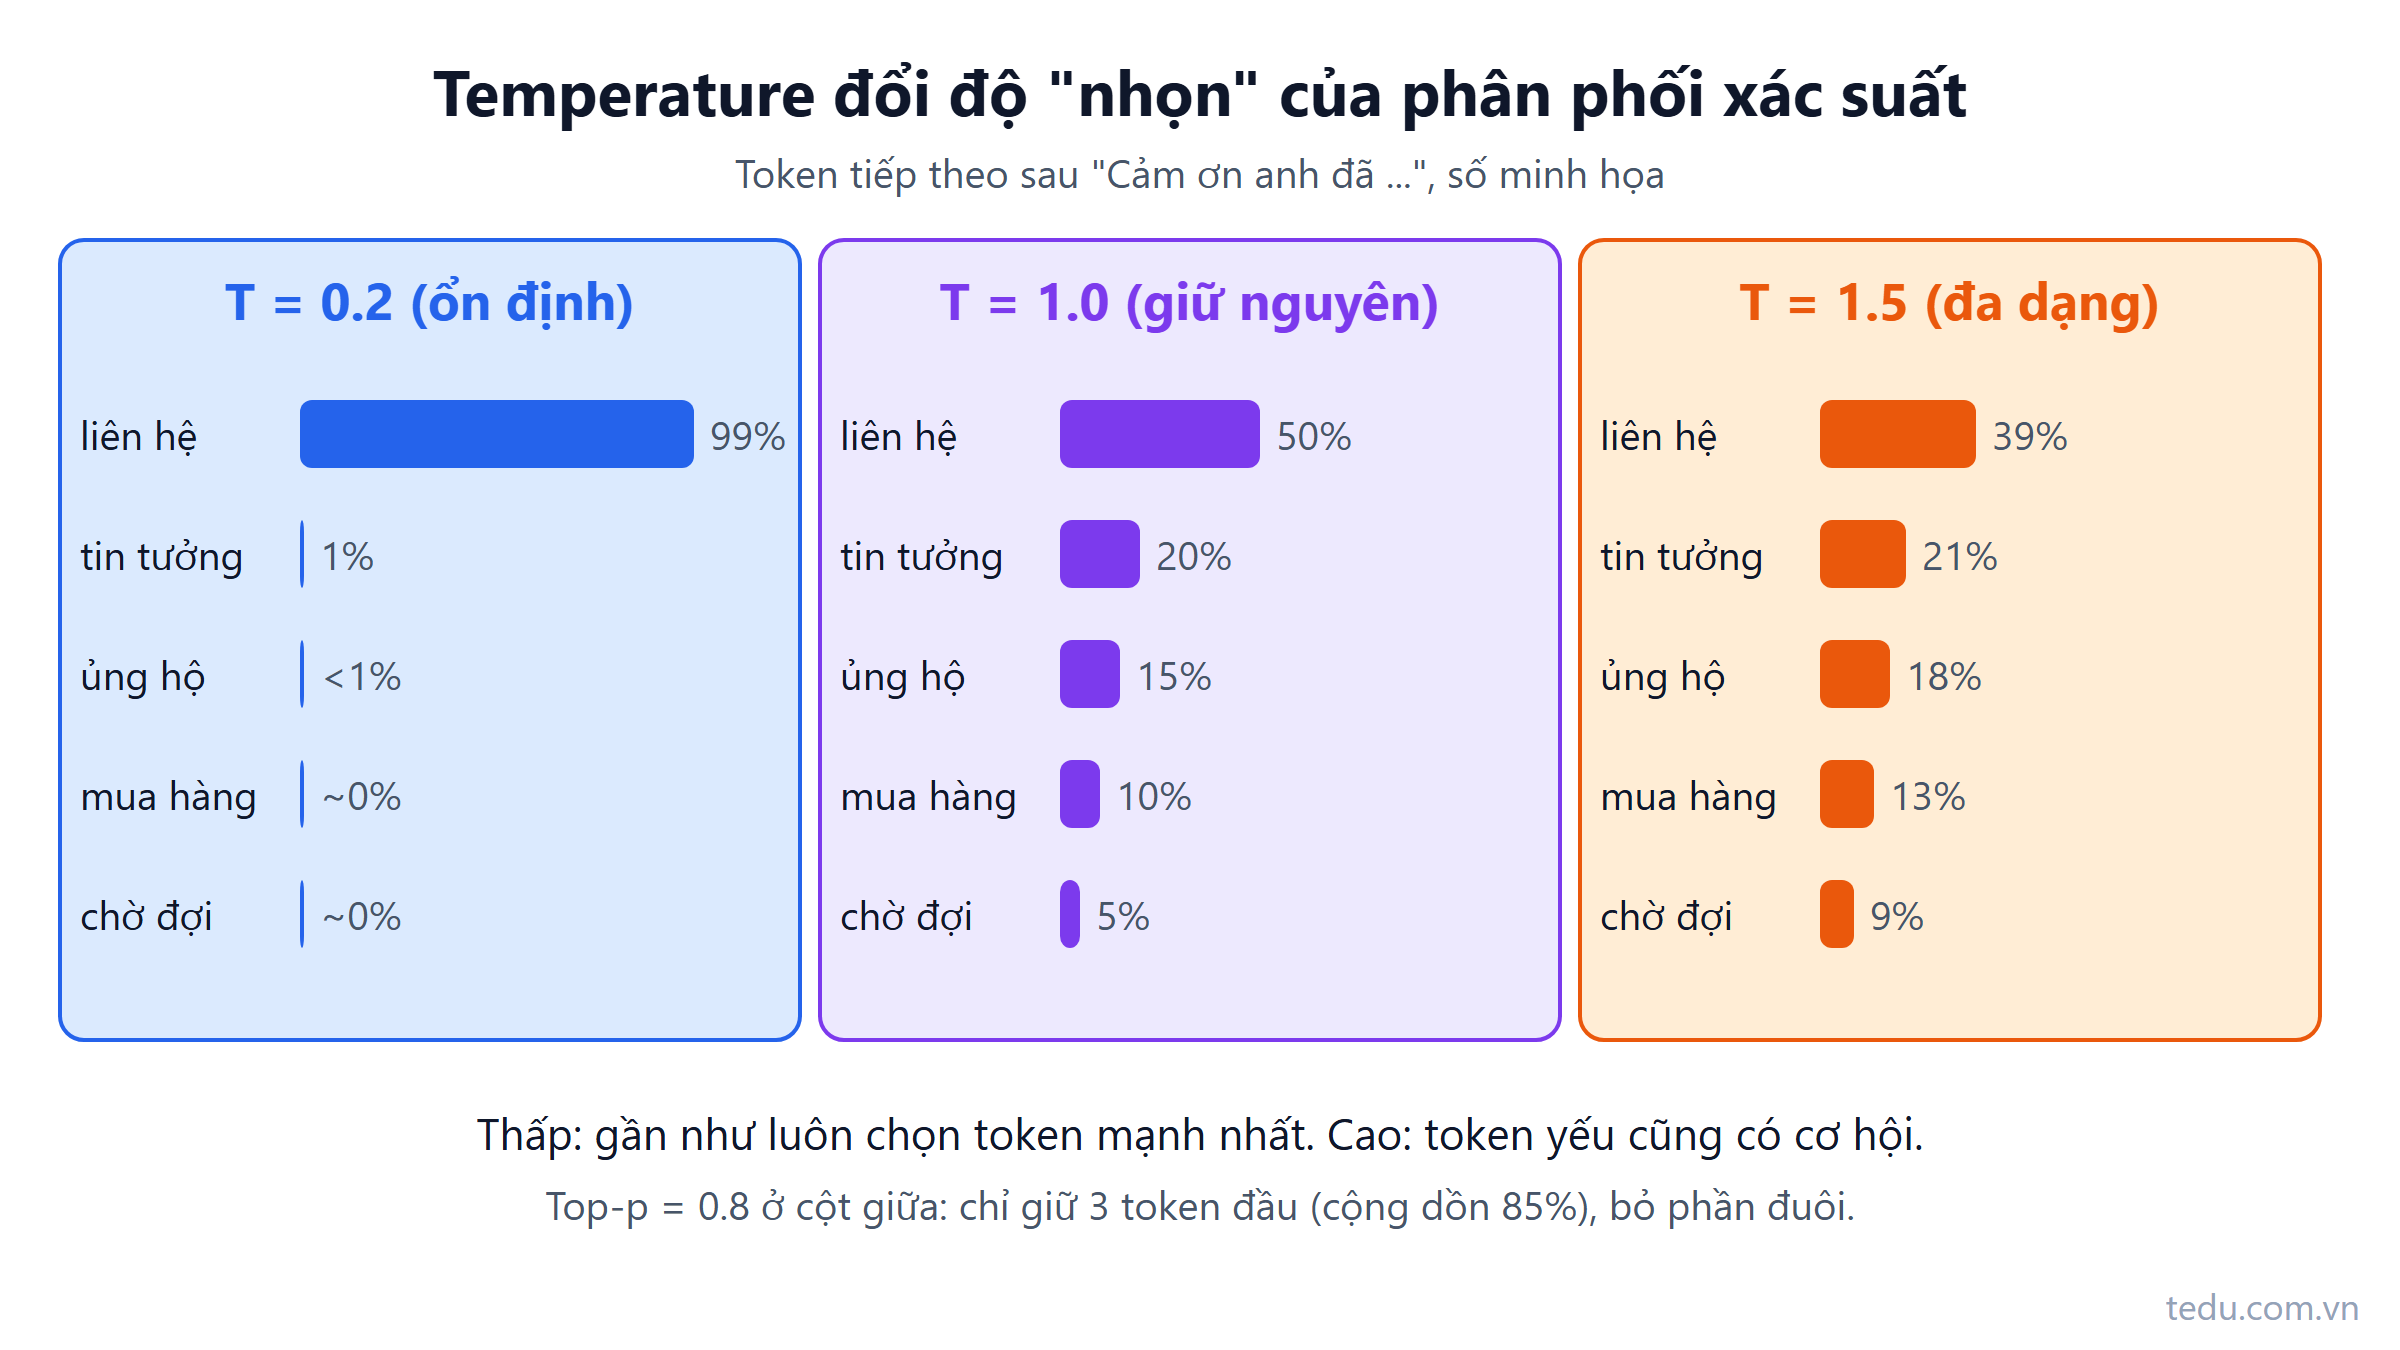
Temperature và top-p là gì? Chỉnh độ sáng tạo của LLM đúng cách
Temperature và top-p quyết định model chọn token tiếp theo an toàn hay phiêu lưu. Bài giải thích cơ chế bằng số cụ thể, code C# mô phỏng và cách chọn theo từng tác vụ.
Đọc thêm