B-tree trong PostgreSQL: trang chỉ mục có thứ tự và thưa dần sau VACUUM
Bài viết của Radim Marek tiếp nối loạt bài về cấu trúc lưu trữ nội bộ của PostgreSQL, lần này tập trung vào trang B-tree thay vì heap page. Trang B-tree dùng chung khung 8KB với header 24 byte, line pointer và tuple xếp từ dưới lên, nhưng khác biệt cốt lõi là trang B-tree có thứ tự và được liên kết với các trang anh em cùng cấp, trong khi heap page chỉ là một tập hợp các phiên bản dòng không có thứ tự.
Thiết lập thử nghiệm
Tác giả dùng extension pageinspect để đọc trang B-tree thô và pgstattuple để lấy thống kê cấp chỉ mục, chạy trên PostgreSQL 18.6. Bảng idx_demo có 100.000 dòng với cột value sinh ra từ phép nhân modulo một số nguyên tố, đảm bảo mọi giá trị đều khác nhau và xáo trộn ngẫu nhiên. Chỉ mục idx_demo_value sau khi tạo có tổng cộng 276 trang: metapage, root và 274 trang lá, với mật độ lá trung bình 89,78%.
Xóa 80% dữ liệu và chạy VACUUM
Sau khi xóa 80.000 dòng, chỉ mục không thay đổi ngay vì lệnh DELETE chỉ đánh dấu xmax trên heap tuple. Khi VACUUM chạy, nó quét mọi chỉ mục để loại bỏ các entry có TID nằm trong danh sách dead. Kết quả: kích thước chỉ mục vẫn giữ nguyên 2.260.992 byte, số trang lá vẫn là 274, nhưng mật độ lá trung bình tụt xuống còn 18,15%. VACUUM đã xóa entry chết nhưng để nguyên các trang tại chỗ.
Một trang lá trước và sau
Trang lá số 1 ban đầu chứa 367 item sống với 808 byte trống, tức khoảng 10% dung lượng vì CREATE INDEX lấp đầy mỗi lá tới 90%. Mỗi entry gồm khóa 4 byte và con trỏ ctid 4 byte, cộng padding cho tròn bội số 8 byte. Không có xmin hay xmax trong entry vì chỉ mục không biết gì về khả năng hiển thị, việc đó do heap đảm nhận.
Item đầu tiên là high key (pivot tuple): bản sao khóa đầu tiên của trang bên phải, đánh dấu giới hạn trên của trang. Trang lá ngoài cùng bên phải không có high key. Sau khi xóa và VACUUM, trang 1 chỉ còn 72 item sống với 6.708 byte trống, nhưng high key vẫn giữ nguyên vị trí.
Cách xác định khóa thuộc trang lá nào
Cấp trên các trang lá được xây từ chính các high key. Mỗi lá giữ một dải khóa liên tục, và root (block 3) là danh sách điểm bắt đầu của từng dải. Ở đây số block trong ctid trỏ tới trang lá chứ không phải heap page. Các trang tìm nhau qua liên kết chứ không dựa vào vị trí trong file, nên VACUUM có thể xóa một trang ở giữa và để lại khoảng trống.
Root được tìm qua metapage ở trang 0, nơi chỉ ghi vị trí root và số cấp phía trên lá. Một truy vấn điểm bắt đầu từ root, đi xuống lá rồi tới heap, còn quét khoảng thì tìm lá đầu tiên rồi lần theo liên kết btpo_next sang phải mà không cần quay lại cấp trên.
Khóa mới đi đâu
Heap page còn chỗ có thể nhận bất kỳ dòng mới nào, nhưng trang lá chỉ nhận các khóa sắp vào dải của nó. Trang 1 chỉ nhận giá trị từ 1 đến 366, nên trừ khi workload chèn lại đúng dải khóa đã xóa, 6.708 byte trống sẽ nằm đó vĩnh viễn. Đây chính là lý do VACUUM không thể hoàn tác hiện tượng phình chỉ mục (index bloat) – vấn đề mà tác giả nhấn mạnh là chủ đề lặp lại trong các buổi nói chuyện của mình.
Nguồn: Planet PostgreSQL
Trích nguồn từ: Planet PostgreSQL
Tags:
Bài viết liên quan

Cùng truy vấn, cùng index nhưng hiệu năng khác nhau khi chuyển PostgreSQL lên Azure
Câu chuyện khách hàng chuyển PostgreSQL lên Azure gặp truy vấn chậm gấp hàng chục lần dù vẫn dùng index scan, nguyên nhân nằm ở cách dữ liệu được sắp xếp trên đĩa chứ không phải index hay storage.
Đọc thêm
json và jsonb trong PostgreSQL: đo kích thước và tốc độ thực tế
So sánh json và jsonb trên PostgreSQL 17 và 18 với sáu dạng tài liệu, cho thấy jsonb có thể nhỏ hơn 23% hoặc lớn hơn 41%, kèm tốc độ đọc và chỉ mục GIN.
Đọc thêm
PostgreSQL có thực sự đang thắng? Bằng chứng vượt xa các bảng xếp hạng
Bài viết của Dave Stokes tổng hợp khảo sát người dùng, các thương vụ mua bán công ty PostgreSQL, sản phẩm của đối thủ và lựa chọn của AI agent để lập luận PostgreSQL đang dẫn đầu mảng cơ sở dữ liệu vận hành.
Đọc thêm
PostgreSQL, NUMA và điện toán đám mây: những lưu ý khi chạy trong VM và container
Bài cuối trong loạt 4 phần về PostgreSQL và NUMA, tập trung vào thách thức khi chạy PostgreSQL trên máy ảo và container trong môi trường đám mây, kèm các khuyến nghị thực hành.
Đọc thêm
Nâng cấp PostgreSQL tại chỗ không downtime trên cụm phân tán
Ahsan Hadi hướng dẫn nâng cấp tại chỗ từng node PostgreSQL từ 17.10 lên 18.6 trên cụm Spock đa master, giữ ứng dụng luôn có endpoint ghi trong khi mỗi node tạm ngừng vài phút.
Đọc thêm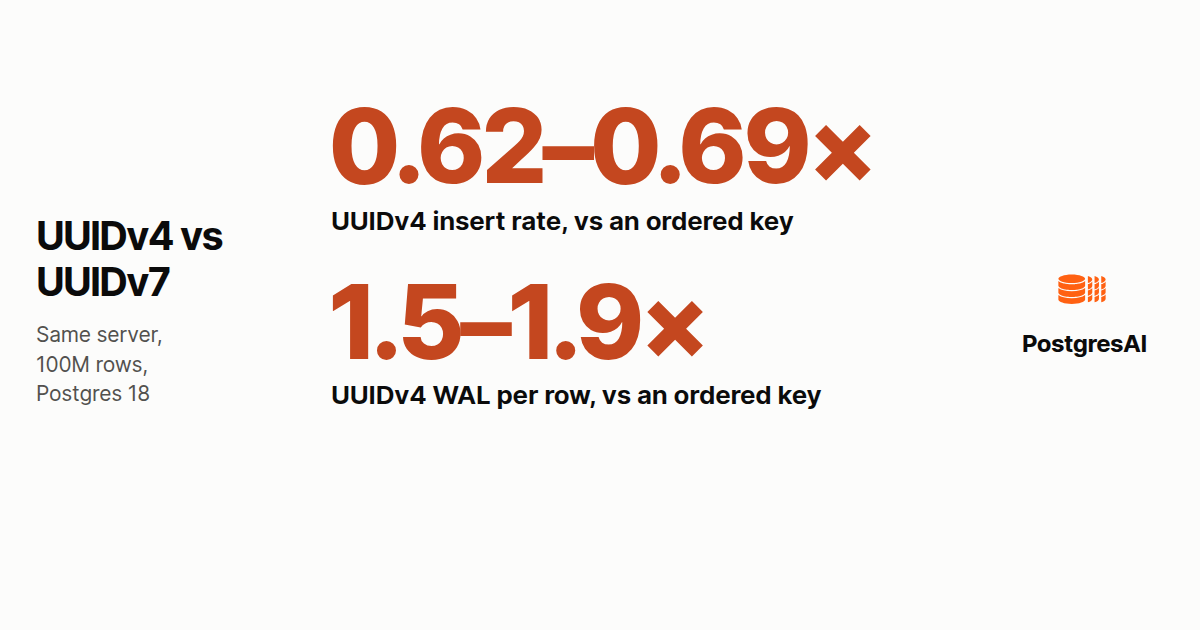
UUIDv4 và UUIDv7 trên Postgres: cái giá của khóa chính ngẫu nhiên
So sánh ba loại khóa chính trên Postgres 18 cho thấy UUIDv4 chèn chậm hơn khóa có thứ tự và ghi WAL nhiều hơn đáng kể ở mức 100 triệu dòng.
Đọc thêm
Ilya Kosmodemiansky bàn về file cấu hình postgresql.conf "mặc định"
Bài đầu tiên trong loạt bốn phần của Ilya Kosmodemiansky (Data Egret) về cách PostgreSQL đọc cấu hình và nhóm thiết lập kết nối, dựa trên bản PostgreSQL 18.
Đọc thêm
Chris van Eijk: Lỗi 'server closed the connection unexpectedly' trong PostgreSQL
Phân tích lỗi PostgreSQL đóng kết nối bất ngờ khi có sáu client, cách đọc log máy chủ theo từng nguyên nhân, nơi lưu lý do và các COMMIT bị mất.
Đọc thêm
Christophe Pettus: Hiểu đúng về row_security trong PostgreSQL
Chuyên gia tư vấn PostgreSQL Christophe Pettus giải thích rằng đặt row_security = off không tắt bảo mật cấp dòng mà sẽ gây lỗi khi có chính sách được áp dụng.
Đọc thêm
Mô hình Data Warehouse: Sơ đồ ngôi sao
Trình bày về mô hình ngôi sao (star schema) khi xây dựng một dat a warehouse phục vụ mục đích báo cáo và phân tích cho doanh nghiệp.
Đọc thêm