

Hybrid search trong RAG: kết hợp keyword và vector
Chatbot chăm sóc khách hàng của một shop điện máy chạy RAG bằng vector search. Khách hỏi "Nồi chiên không dầu bị bốc mùi nhựa lần đầu dùng có sao không?", bot tìm đúng đoạn hướng dẫn và trả lời rất ổn. Khách khác hỏi "Mã AF-5520 bảo hành bao lâu?", bot trả lời theo chính sách bảo hành của mã AF-5250, một mẫu khác hoàn toàn.
Không phải model kém. Với vector search, "AF-5520" và "AF-5250" là hai chuỗi trông rất giống nhau, nằm trong hai đoạn văn có cùng chủ đề "bảo hành nồi chiên", nên vector của chúng gần nhau. Embedding giỏi hiểu nghĩa, nhưng không được thiết kế để phân biệt chính xác từng ký tự trong một mã sản phẩm.
Trong khi đó, tìm kiếm theo từ khóa kiểu cũ (full-text search) sẽ khớp đúng "AF-5520" ngay lập tức, nhưng lại trượt câu hỏi về "bốc mùi nhựa" nếu tài liệu viết là "có mùi lạ khi sử dụng lần đầu". Hybrid search kết hợp cả hai để lấy điểm mạnh của từng bên. Bài này giải thích vì sao cần nó, cách gộp kết quả bằng RRF, và cách làm ngay trên PostgreSQL bạn đang có.
Vector search và keyword search giỏi ở đâu, trượt ở đâu
Hai cách tìm kiếm có điểm mù gần như đối xứng:
| Loại câu hỏi | Ví dụ | Vector search | Keyword search |
|---|---|---|---|
| Diễn đạt khác tài liệu | "bốc mùi nhựa" và tài liệu viết "mùi lạ" | Tốt | Trượt |
| Đồng nghĩa, viết tắt | "nghỉ ốm" và "nghỉ hưởng chế độ ốm đau" | Tốt | Thường trượt |
| Mã sản phẩm, mã đơn | "AF-5520", "DH-2026-00123" | Hay nhầm mã gần giống | Tốt |
| Số hiệu văn bản | "Quyết định 125/QĐ-HĐQT" | Hay nhầm số | Tốt |
| Tên riêng, tên hiếm | Tên khách hàng, tên dự án nội bộ | Không ổn định | Tốt |
| Câu hỏi dài, mơ hồ | "hàng mua online bị lỗi thì làm sao" | Tốt | Trung bình |
Tài liệu doanh nghiệp Việt Nam có rất nhiều mã: mã sản phẩm, mã đơn, số hiệu văn bản, mã nhân viên, mã hồ sơ. Người dùng cũng hay gõ thẳng mã vào ô hỏi. Vì vậy chỉ dùng vector search thường không đủ cho RAG trong doanh nghiệp.
Một điều nữa: không phải câu hỏi nào có mã cũng nên đi qua RAG. "Đơn DH-2026-00123 đang ở đâu" là câu hỏi về dữ liệu trong bảng, nên dùng tool truy vấn đơn hàng (xem bài RAG là gì). Hybrid search dành cho trường hợp mã nằm trong tài liệu: chính sách bảo hành theo mã sản phẩm, quy chế được dẫn chiếu bằng số hiệu.
Hybrid search hoạt động thế nào
Ý tưởng gồm ba bước:
Chạy vector search, lấy khoảng 20 kết quả đầu.
Chạy keyword search (full-text), cũng lấy khoảng 20 kết quả đầu.
Gộp hai danh sách thành một, lấy vài kết quả tốt nhất đưa vào prompt (hoặc đưa sang bước reranking).
Bước 3 là chỗ cần suy nghĩ. Điểm của vector search là khoảng cách cosine, điểm của full-text là một điểm relevance theo thang khác hẳn. Cộng thẳng hai con số này giống như cộng điểm thi đại học với chỉ số BMI: phép cộng chạy được, kết quả vô nghĩa.
Reciprocal Rank Fusion (RRF): gộp theo thứ hạng, không theo điểm
RRF né vấn đề thang điểm bằng cách chỉ dùng thứ hạng. Mỗi tài liệu nhận điểm từ mỗi danh sách theo công thức:
score(d) = Σ 1 / (k + rank_i(d))Trong đó rank_i(d) là thứ hạng của tài liệu d trong danh sách i (1, 2, 3...), và k là một hằng số làm mượt, giá trị hay dùng là 60. Tài liệu không có mặt trong một danh sách thì không nhận điểm từ danh sách đó.
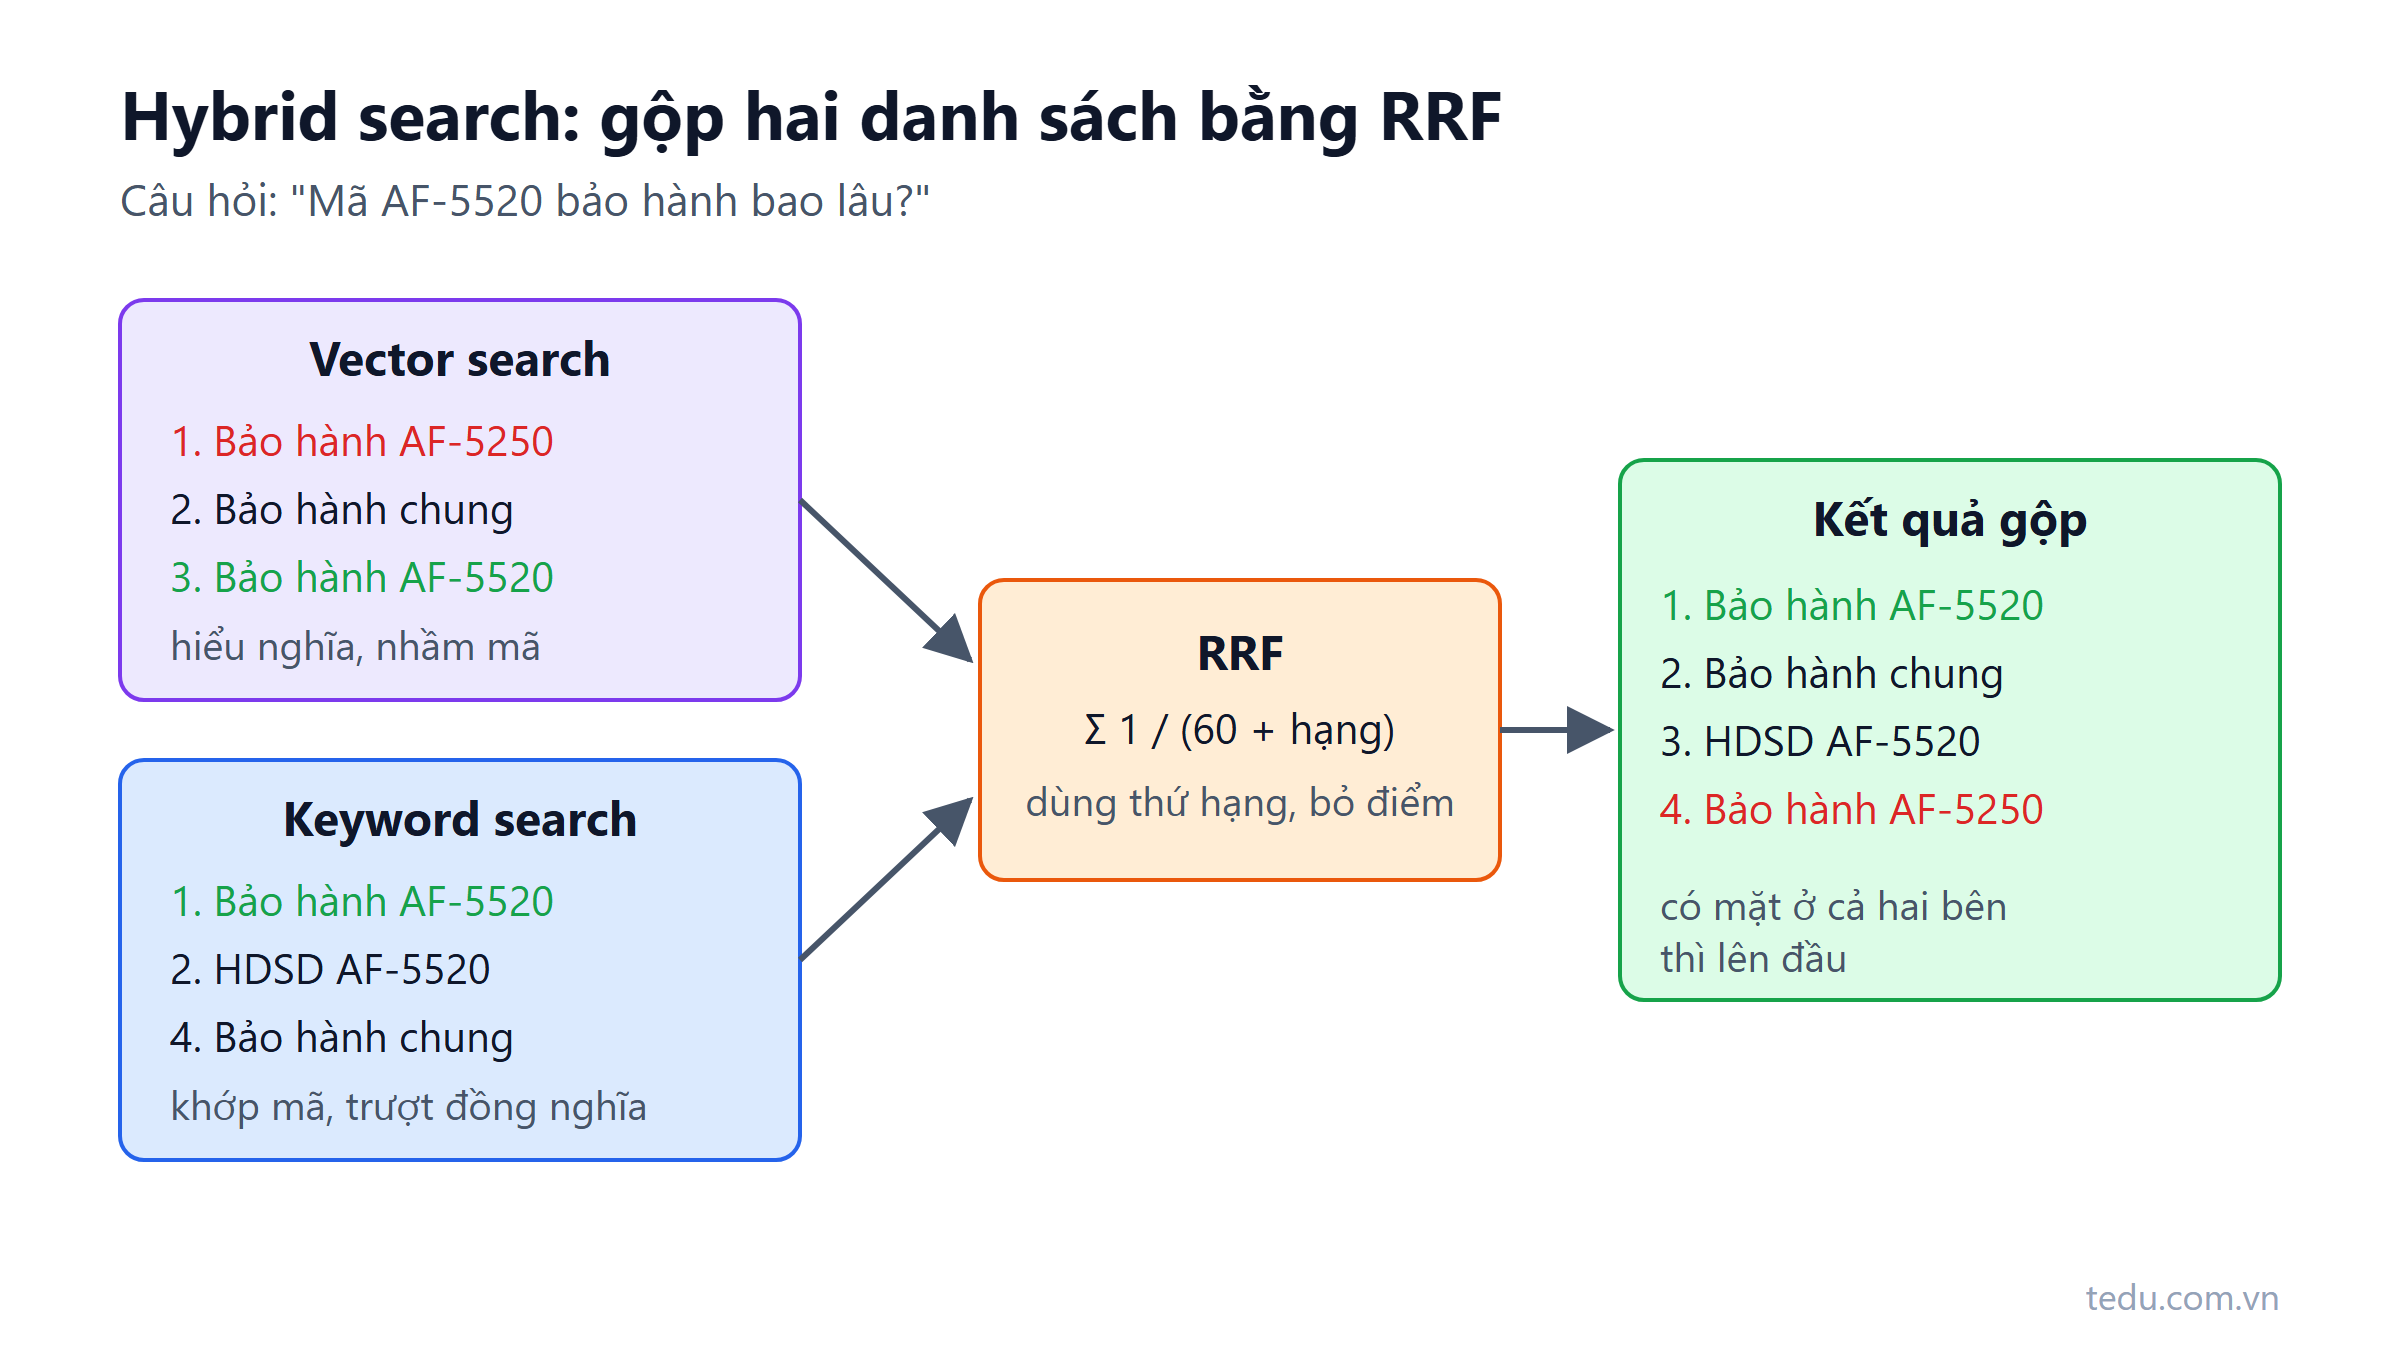
Ví dụ với câu hỏi "Mã AF-5520 bảo hành bao lâu?":
| Đoạn | Hạng vector | Hạng keyword | Điểm RRF (k = 60) |
|---|---|---|---|
| Bảo hành AF-5250 | 1 | không có | 1/61 ≈ 0,0164 |
| Bảo hành AF-5520 | 3 | 1 | 1/63 + 1/61 ≈ 0,0323 |
| Chính sách bảo hành chung | 2 | 4 | 1/62 + 1/64 ≈ 0,0318 |
| Hướng dẫn sử dụng AF-5520 | 8 | 2 | 1/68 + 1/62 ≈ 0,0308 |
Đoạn đúng (bảo hành AF-5520) lên đầu vì nó xuất hiện ở cả hai danh sách. Đoạn sai (AF-5250) đứng nhất bên vector nhưng không có mặt bên keyword, nên tụt xuống cuối. Đó là trực giác của RRF: thứ được cả hai phương pháp đồng ý thì đáng tin hơn.
Ưu điểm của RRF là không cần chuẩn hóa điểm và gần như không cần tinh chỉnh. Nhược điểm là nó bỏ qua độ chênh điểm: hạng 1 cách hạng 2 rất xa hay rất gần đều như nhau. Cách thay thế là chuẩn hóa điểm từng bên về khoảng 0–1 rồi cộng có trọng số, nhưng cách này cần tinh chỉnh trọng số trên bộ câu hỏi thật.
| Cách gộp | Ưu điểm | Nhược điểm |
|---|---|---|
| RRF | Đơn giản, không cần chuẩn hóa, ít tham số | Bỏ qua độ chênh lệch điểm |
| Chuẩn hóa + trọng số | Tận dụng được độ tự tin của từng bên | Phải tinh chỉnh trọng số, dễ overfit |
| Gộp rồi rerank | Chất lượng thường tốt nhất | Thêm một bước, thêm độ trễ và chi phí |
Làm hybrid search trên PostgreSQL
Nếu bạn đã dùng pgvector, phần keyword search có sẵn trong PostgreSQL: full-text search với tsvector và chỉ mục GIN. Không cần thêm hệ thống nào.
Thêm cột full-text và chỉ mục
ALTER TABLE document_chunks
    ADD COLUMN search_tsv tsvector
    GENERATED ALWAYS AS (to_tsvector('simple', content)) STORED;

CREATE INDEX ON document_chunks USING gin (search_tsv);
PostgreSQL không có cấu hình full-text dành riêng cho tiếng Việt, nên ví dụ dùng cấu hình simple: tách từ theo khoảng trắng và dấu câu, chuyển chữ thường, không bỏ stop word, không đưa về từ gốc. Với tiếng Việt, đây thường là điểm khởi đầu chấp nhận được, nhất là khi mục tiêu chính của keyword search là bắt mã và số hiệu.
Hai điểm cần lưu ý với tiếng Việt:
Người dùng gõ không dấu. "bao hanh" sẽ không khớp "bảo hành". Có thể lưu thêm một cột đã bỏ dấu (bằng extension
unaccenthoặc xử lý trong code C# trước khi lưu) và tìm trên cả hai. Lưu ýunaccentkhông được khai báo là hàm immutable, nên không dùng thẳng trong cột generated được; hãy đọc tài liệu PostgreSQL hoặc bỏ dấu ở tầng ứng dụng.Mã có dấu gạch. Cách bộ tách từ xử lý "AF-5520" (giữ nguyên hay tách thành nhiều phần) ảnh hưởng tới việc khớp. Hãy thử
SELECT to_tsvector('simple', 'AF-5520')để xem chính xác nó sinh ra gì, rồi chọn cách chuẩn hóa mã cho phù hợp.
Nếu nhu cầu keyword search phức tạp hơn (xếp hạng BM25, tách từ tiếng Việt tốt hơn), có thể dùng extension bên thứ ba hoặc một search engine như Elasticsearch, OpenSearch. Hãy bắt đầu với full-text có sẵn và chỉ nâng cấp khi đo thấy cần.
Một câu SQL cho hybrid search với RRF
WITH semantic AS (
    SELECT id, ROW_NUMBER() OVER (ORDER BY embedding <=> $1) AS rank
    FROM document_chunks
    WHERE tenant_id = $3
    ORDER BY embedding <=> $1
    LIMIT 20
),
keyword AS (
    SELECT id, ROW_NUMBER() OVER (ORDER BY ts_rank_cd(search_tsv, query) DESC) AS rank
    FROM document_chunks, plainto_tsquery('simple', $2) AS query
    WHERE tenant_id = $3 AND search_tsv @@ query
    ORDER BY ts_rank_cd(search_tsv, query) DESC
    LIMIT 20
)
SELECT COALESCE(s.id, k.id) AS id,
       COALESCE(1.0 / (60 + s.rank), 0.0) + COALESCE(1.0 / (60 + k.rank), 0.0) AS score
FROM semantic s
FULL OUTER JOIN keyword k ON s.id = k.id
ORDER BY score DESC
LIMIT 5;
Tham số $1 là vector của câu hỏi, $2 là câu hỏi dạng chữ, $3 là tenant. FULL OUTER JOIN giữ lại cả đoạn chỉ có ở một bên. Số 20 và 60 là giá trị khởi đầu, không phải chân lý. Lưu ý plainto_tsquery nối các từ bằng phép AND, nên câu hỏi dài có thể không khớp đoạn nào ở nhánh keyword; khi đó kết quả chỉ còn nhánh vector, hệ thống vẫn chạy, chỉ là không được lợi từ hybrid. Bạn có thể thử websearch_to_tsquery hoặc tự trích mã, số hiệu trong câu hỏi để tìm keyword riêng cho chúng.
Hoặc gộp trong C#
Nếu hai nhánh tìm kiếm đến từ hai nguồn khác nhau (ví dụ pgvector và Elasticsearch), gộp ở tầng ứng dụng cũng đơn giản:
public static class Rrf
{
    public static IReadOnlyList<(long Id, double Score)> Fuse(
        IEnumerable<IReadOnlyList<long>> rankedLists, int k = 60, int top = 5)
    {
        var scores = new Dictionary<long, double>();

        foreach (var list in rankedLists)
        {
            for (var i = 0; i < list.Count; i++)
            {
                var rank = i + 1;
                scores[list[i]] = scores.GetValueOrDefault(list[i]) + 1.0 / (k + rank);
            }
        }

        return scores
            .OrderByDescending(kv => kv.Value)
            .Take(top)
            .Select(kv => (kv.Key, kv.Value))
            .ToList();
    }
}

// Sử dụng
var vectorIds = await vectorSearch.SearchAsync(questionEmbedding, limit: 20);
var keywordIds = await keywordSearch.SearchAsync(question, limit: 20);
var fused = Rrf.Fuse([vectorIds, keywordIds]);
vectorSearch và keywordSearch là các lớp bọc do bạn tự định nghĩa, trả về danh sách id đã sắp xếp theo mức liên quan. Cú pháp [vectorIds, keywordIds] là collection expression của C# 12 trở lên.
Đo xem hybrid có thật sự tốt hơn không
Hybrid search không miễn phí: thêm một truy vấn, thêm chỉ mục, thêm độ phức tạp. Hãy đo trước khi giữ nó:
Lấy bộ câu hỏi thật (30–50 câu) đã dùng khi thử chunking, bổ sung thêm các câu có mã sản phẩm, số hiệu văn bản, tên riêng.
Chạy ba cấu hình: chỉ vector, chỉ keyword, hybrid RRF.
Đo hit rate: tỷ lệ câu hỏi có đoạn đúng trong 5 kết quả đầu. Tách riêng kết quả cho nhóm câu có mã và nhóm câu hỏi tự do.
Kết quả thường thấy là hybrid cải thiện rõ ở nhóm câu có mã, và giữ nguyên hoặc nhích nhẹ ở nhóm câu hỏi tự do. Nhưng "thường thấy" không thay được số đo trên dữ liệu của bạn.
Lỗi hay gặp và checklist
Lỗi hay gặp:
Cộng thẳng điểm cosine với điểm full-text. Hai thang điểm khác nhau, kết quả gộp bị một bên lấn át.
Quên tiếng Việt không dấu. Người dùng gõ "doi tra hang" và nhánh keyword không khớp gì cả.
Không áp cùng bộ lọc cho hai nhánh. Nhánh vector lọc theo tenant, nhánh keyword quên lọc, và tài liệu của tenant khác lọt vào kết quả. Đây là lỗi bảo mật, không chỉ là lỗi chất lượng.
Dùng hybrid search cho câu hỏi dữ liệu. "Đơn DH-2026-00123 ở đâu" cần tool truy vấn đơn, không cần tìm tài liệu.
Không đo theo nhóm câu hỏi. Hit rate trung bình tăng 2% có thể che giấu việc nhóm câu có mã tăng mạnh còn nhóm khác giảm.
Checklist:
Người dùng của bạn có hay hỏi bằng mã, số hiệu, tên riêng không? Nếu có, hybrid search đáng thử.
Đã có cột full-text và chỉ mục GIN cạnh cột vector?
Đã xử lý trường hợp gõ không dấu?
Hai nhánh tìm kiếm áp cùng bộ lọc quyền và hiệu lực?
Gộp bằng thứ hạng (RRF) thay vì cộng điểm thô?
Đã đo hit rate theo từng nhóm câu hỏi ở cả ba cấu hình?
Kết luận
Vector search hiểu nghĩa nhưng hay nhầm mã và số hiệu; keyword search bắt chính xác mã nhưng trượt khi người dùng diễn đạt khác tài liệu. Hybrid search chạy cả hai và gộp bằng RRF, ưu tiên những đoạn được cả hai phương pháp đồng ý. Trên PostgreSQL, bạn làm được điều này trong một câu SQL với pgvector và full-text search có sẵn, không cần thêm hệ thống nào.
Bước tiếp theo: liệt kê 10 câu hỏi có mã sản phẩm hoặc số hiệu văn bản từ log thật của hệ thống, chạy thử với vector search hiện tại và xem bao nhiêu câu trượt. Sau khi gộp được kết quả từ hai nhánh, bước giúp chọn ra đúng vài đoạn tốt nhất là reranking, bước bị bỏ qua nhiều nhất, chủ đề của bài kế tiếp.
Xem bản tóm tắt dưới một phút trên YouTube @teduco hoặc TikTok @teducolabs, và đọc thêm các bài khác trong chuyên mục AI cho Backend Developer.
Bài viết liên quan
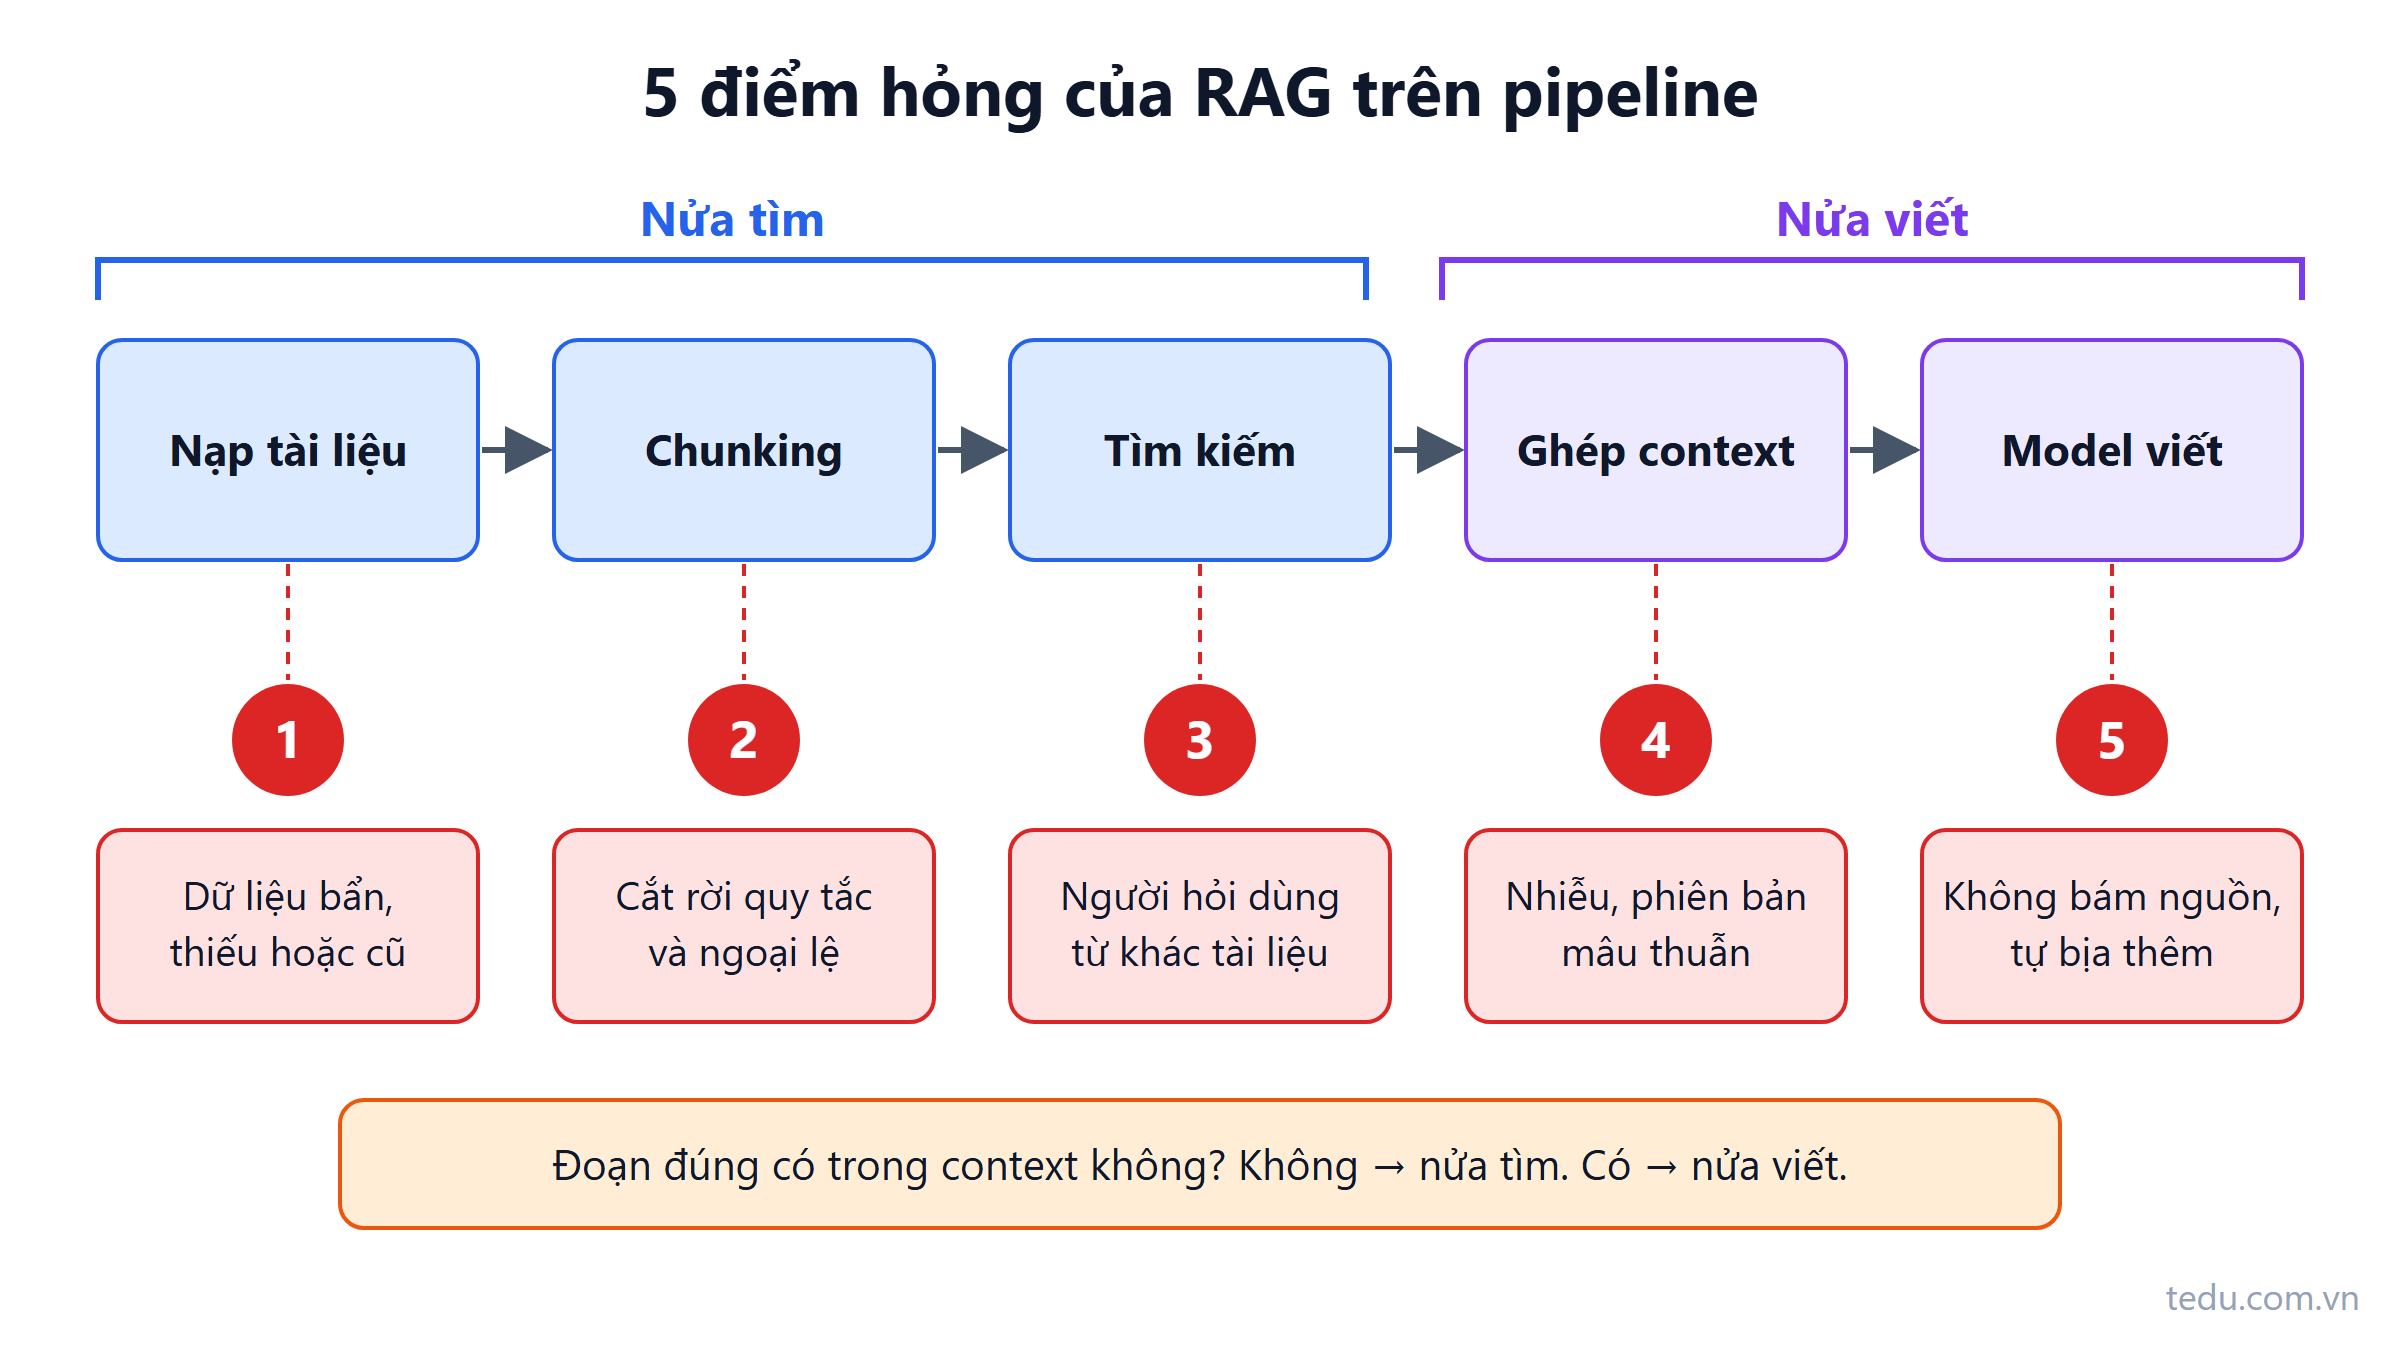
5 lý do RAG trả lời sai và cách tìm đúng chỗ hỏng
RAG trả lời sai hiếm khi do model kém. Bài chỉ ra 5 chỗ hỏng thường gặp từ dữ liệu, chunking, tìm kiếm đến prompt, kèm cách khoanh vùng lỗi bằng log.
Đọc thêm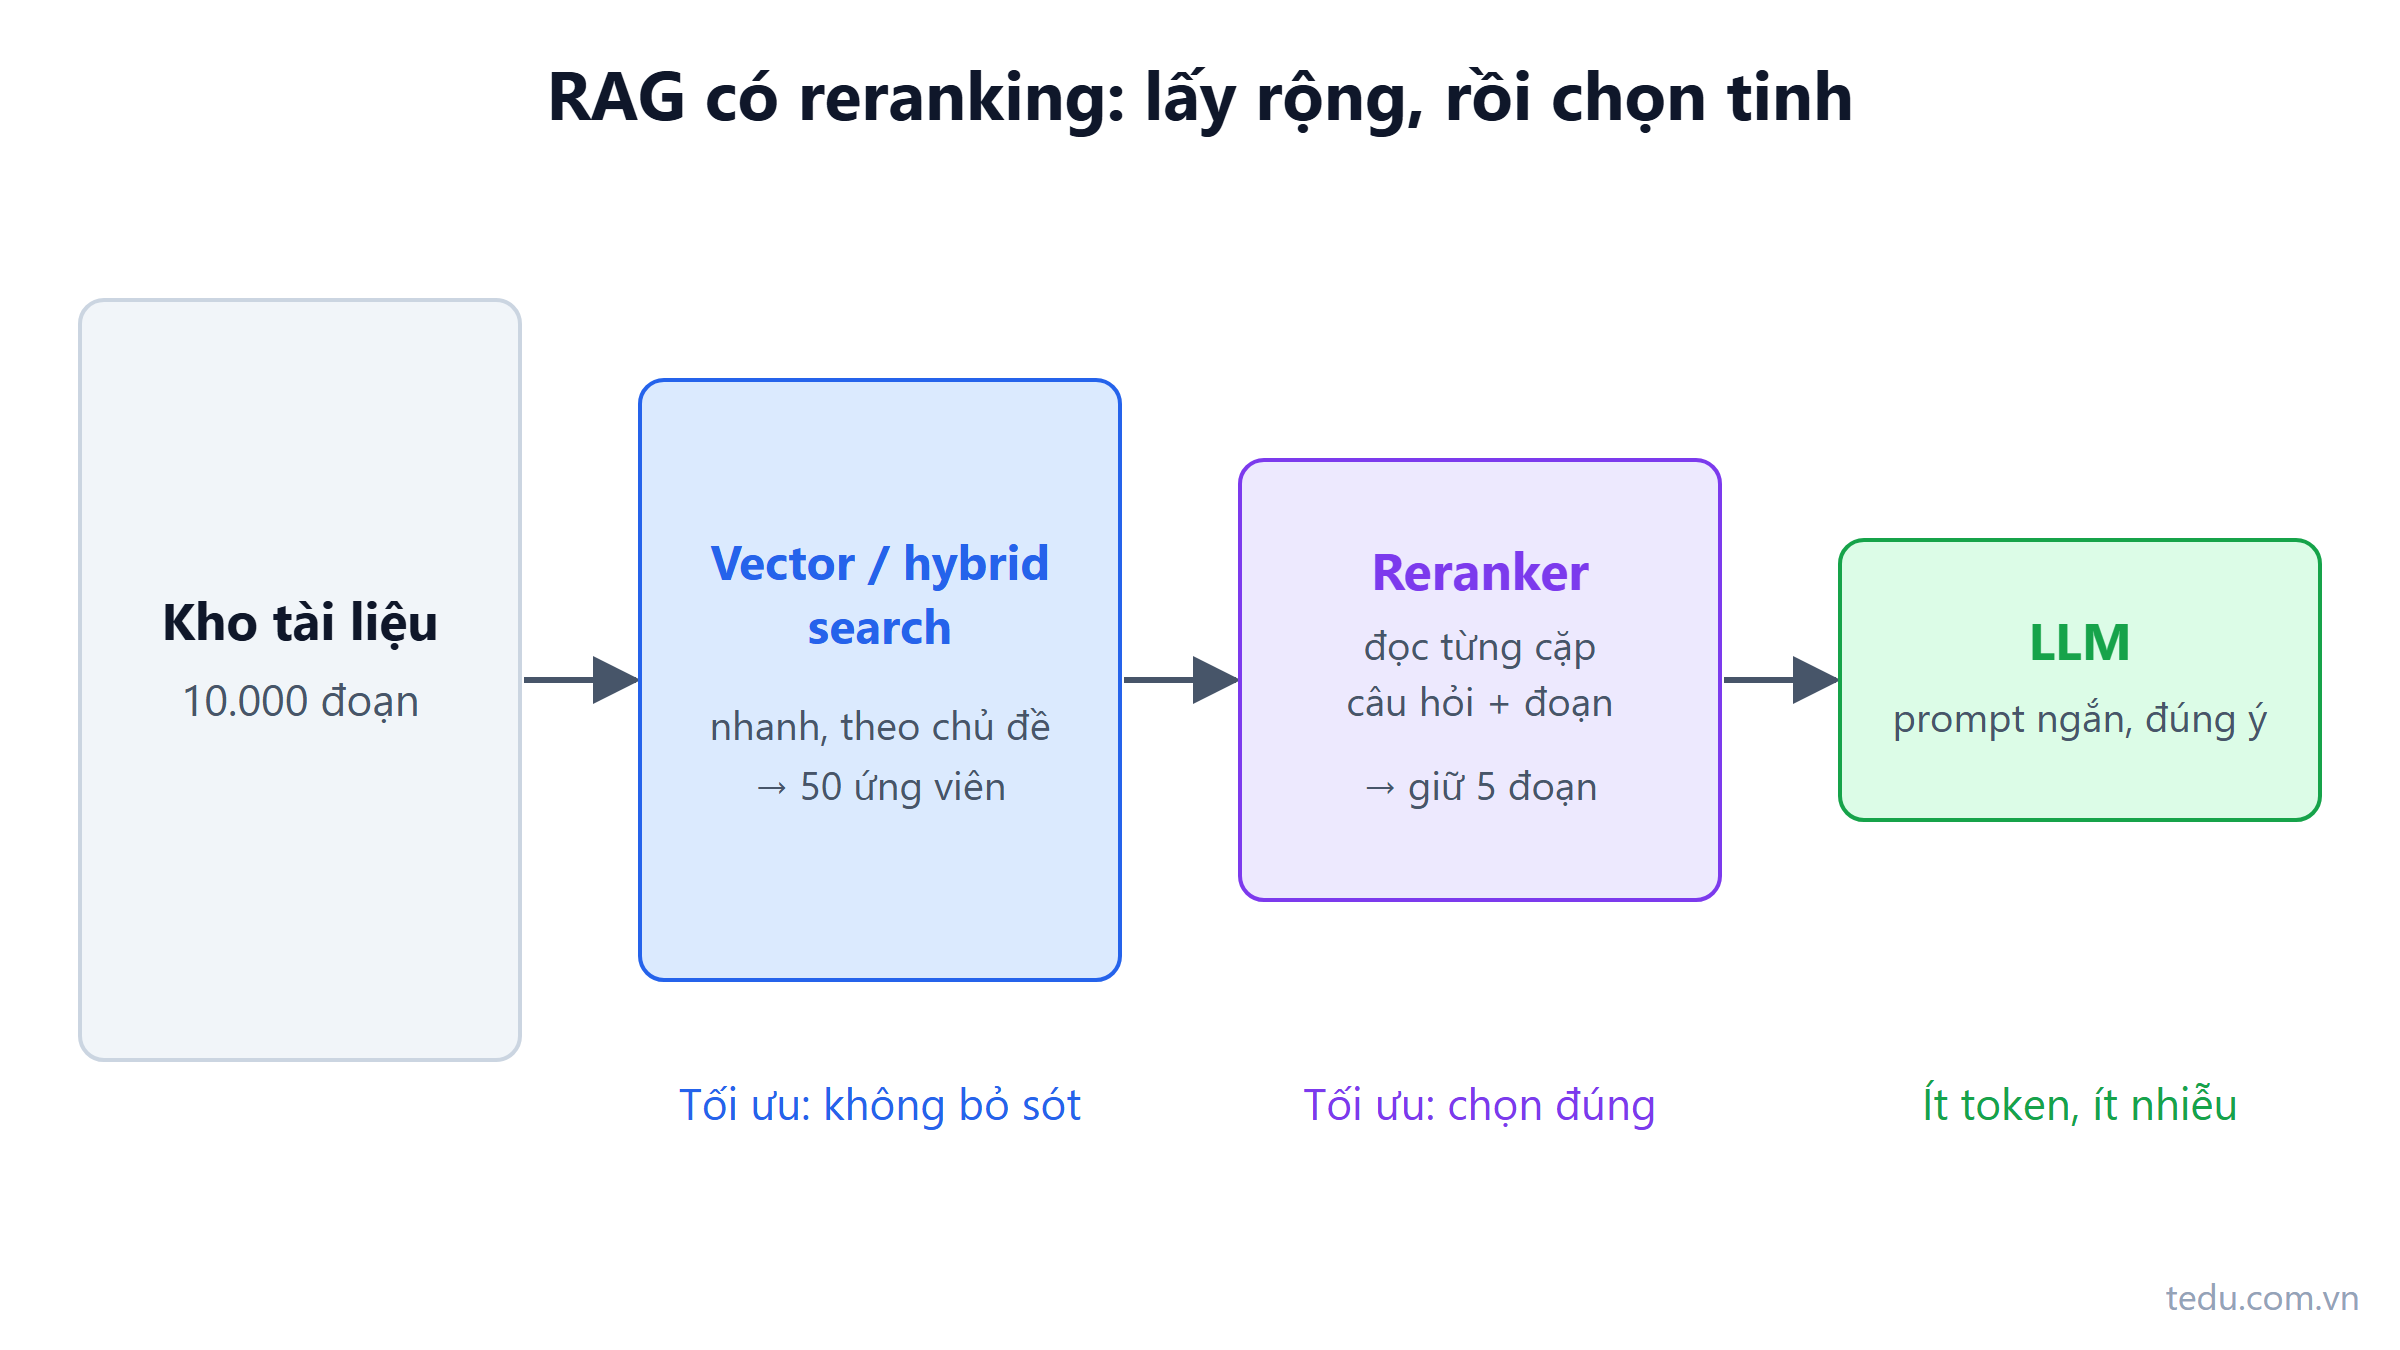
Reranking trong RAG: bước bị bỏ qua nhiều nhất
Reranking chấm lại vài chục đoạn tìm được để chọn ra vài đoạn thật sự trả lời câu hỏi. Bài giải thích cơ chế, cách gắn vào pipeline C# và lỗi hay gặp.
Đọc thêm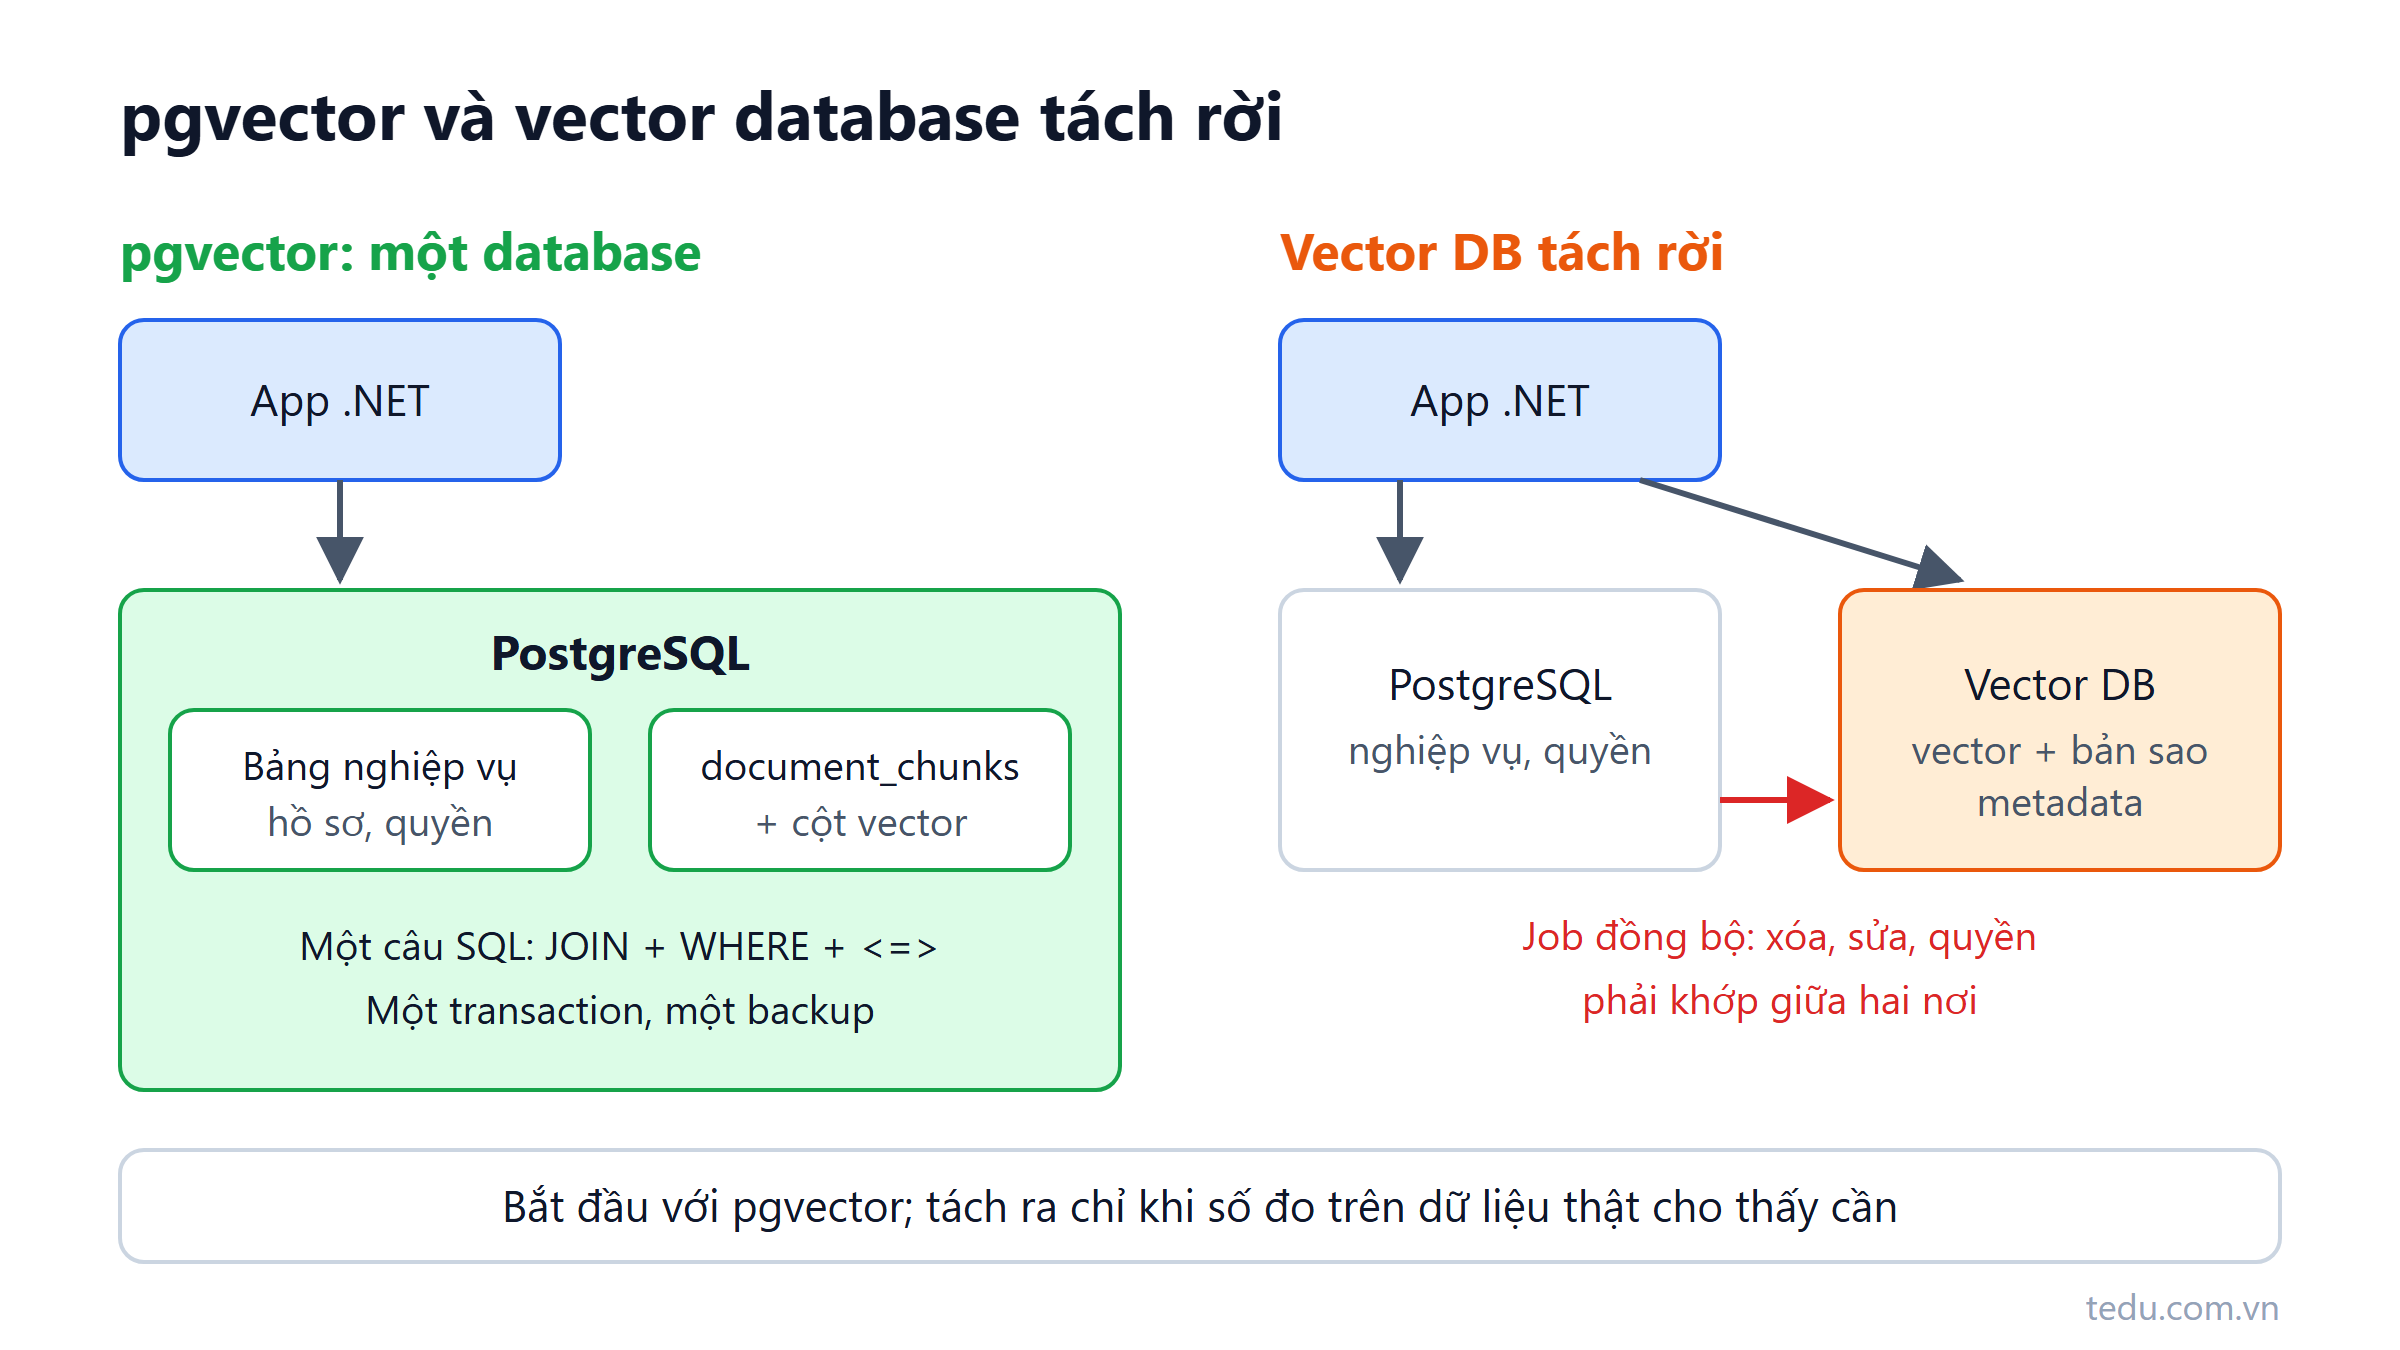
pgvector: vì sao PostgreSQL thường đủ làm vector DB
pgvector biến PostgreSQL thành vector database cho RAG. Hướng dẫn SQL, C#, so sánh với vector DB chuyên dụng và khi nào pgvector không đủ.
Đọc thêm
Chunking trong RAG: cắt tài liệu sai thì kết quả hỏng
Chunking là bước cắt tài liệu thành đoạn nhỏ trước khi đưa vào RAG. Bài so sánh các cách chunking, ví dụ với quy chế tiếng Việt và code C# cắt theo Điều, Khoản.
Đọc thêm
RAG là gì? Khi nào cần và khi nào không cần
RAG là cách đưa đúng đoạn tài liệu vào prompt để model trả lời theo dữ liệu thật. Bài này giải thích pipeline và khi nào bạn không cần RAG.
Đọc thêm
Quản lý prompt như code: versioning, review và test
Prompt là logic nghiệp vụ, sửa một câu có thể đổi hành vi cả hệ thống. Bài hướng dẫn quản lý prompt như code: lưu trong repo, versioning, review, test và rollback.
Đọc thêm
Chain-of-thought: cho model suy nghĩ trước khi trả lời
Chain-of-thought là cho model viết các bước suy luận trước khi chốt đáp án. Bài giải thích vì sao nó hiệu quả, khi nào nên dùng và cách dùng trong production.
Đọc thêm
Vì sao nhồi nhiều context lại làm model kém đi
Context window lớn không có nghĩa là nhồi càng nhiều càng tốt. Bài giải thích vì sao model trả lời kém đi khi context dài và cách chọn lọc context đúng.
Đọc thêm
Few-shot prompting: cho LLM ví dụ thay vì giải thích dài dòng
Few-shot prompting là đưa vài ví dụ đầu vào và đầu ra mẫu để LLM bắt chước. Bài chỉ cách chọn ví dụ, lỗi hay gặp và few-shot động bằng C#.
Đọc thêm
Context engineering là gì, vì sao quan trọng hơn prompt
Context engineering là quyết định cái gì vào context window, cái gì phải ra, theo thứ tự nào. Câu prompt chỉ là một phần nhỏ của những gì model thấy.
Đọc thêm