

Vì sao nhồi nhiều context lại làm model kém đi
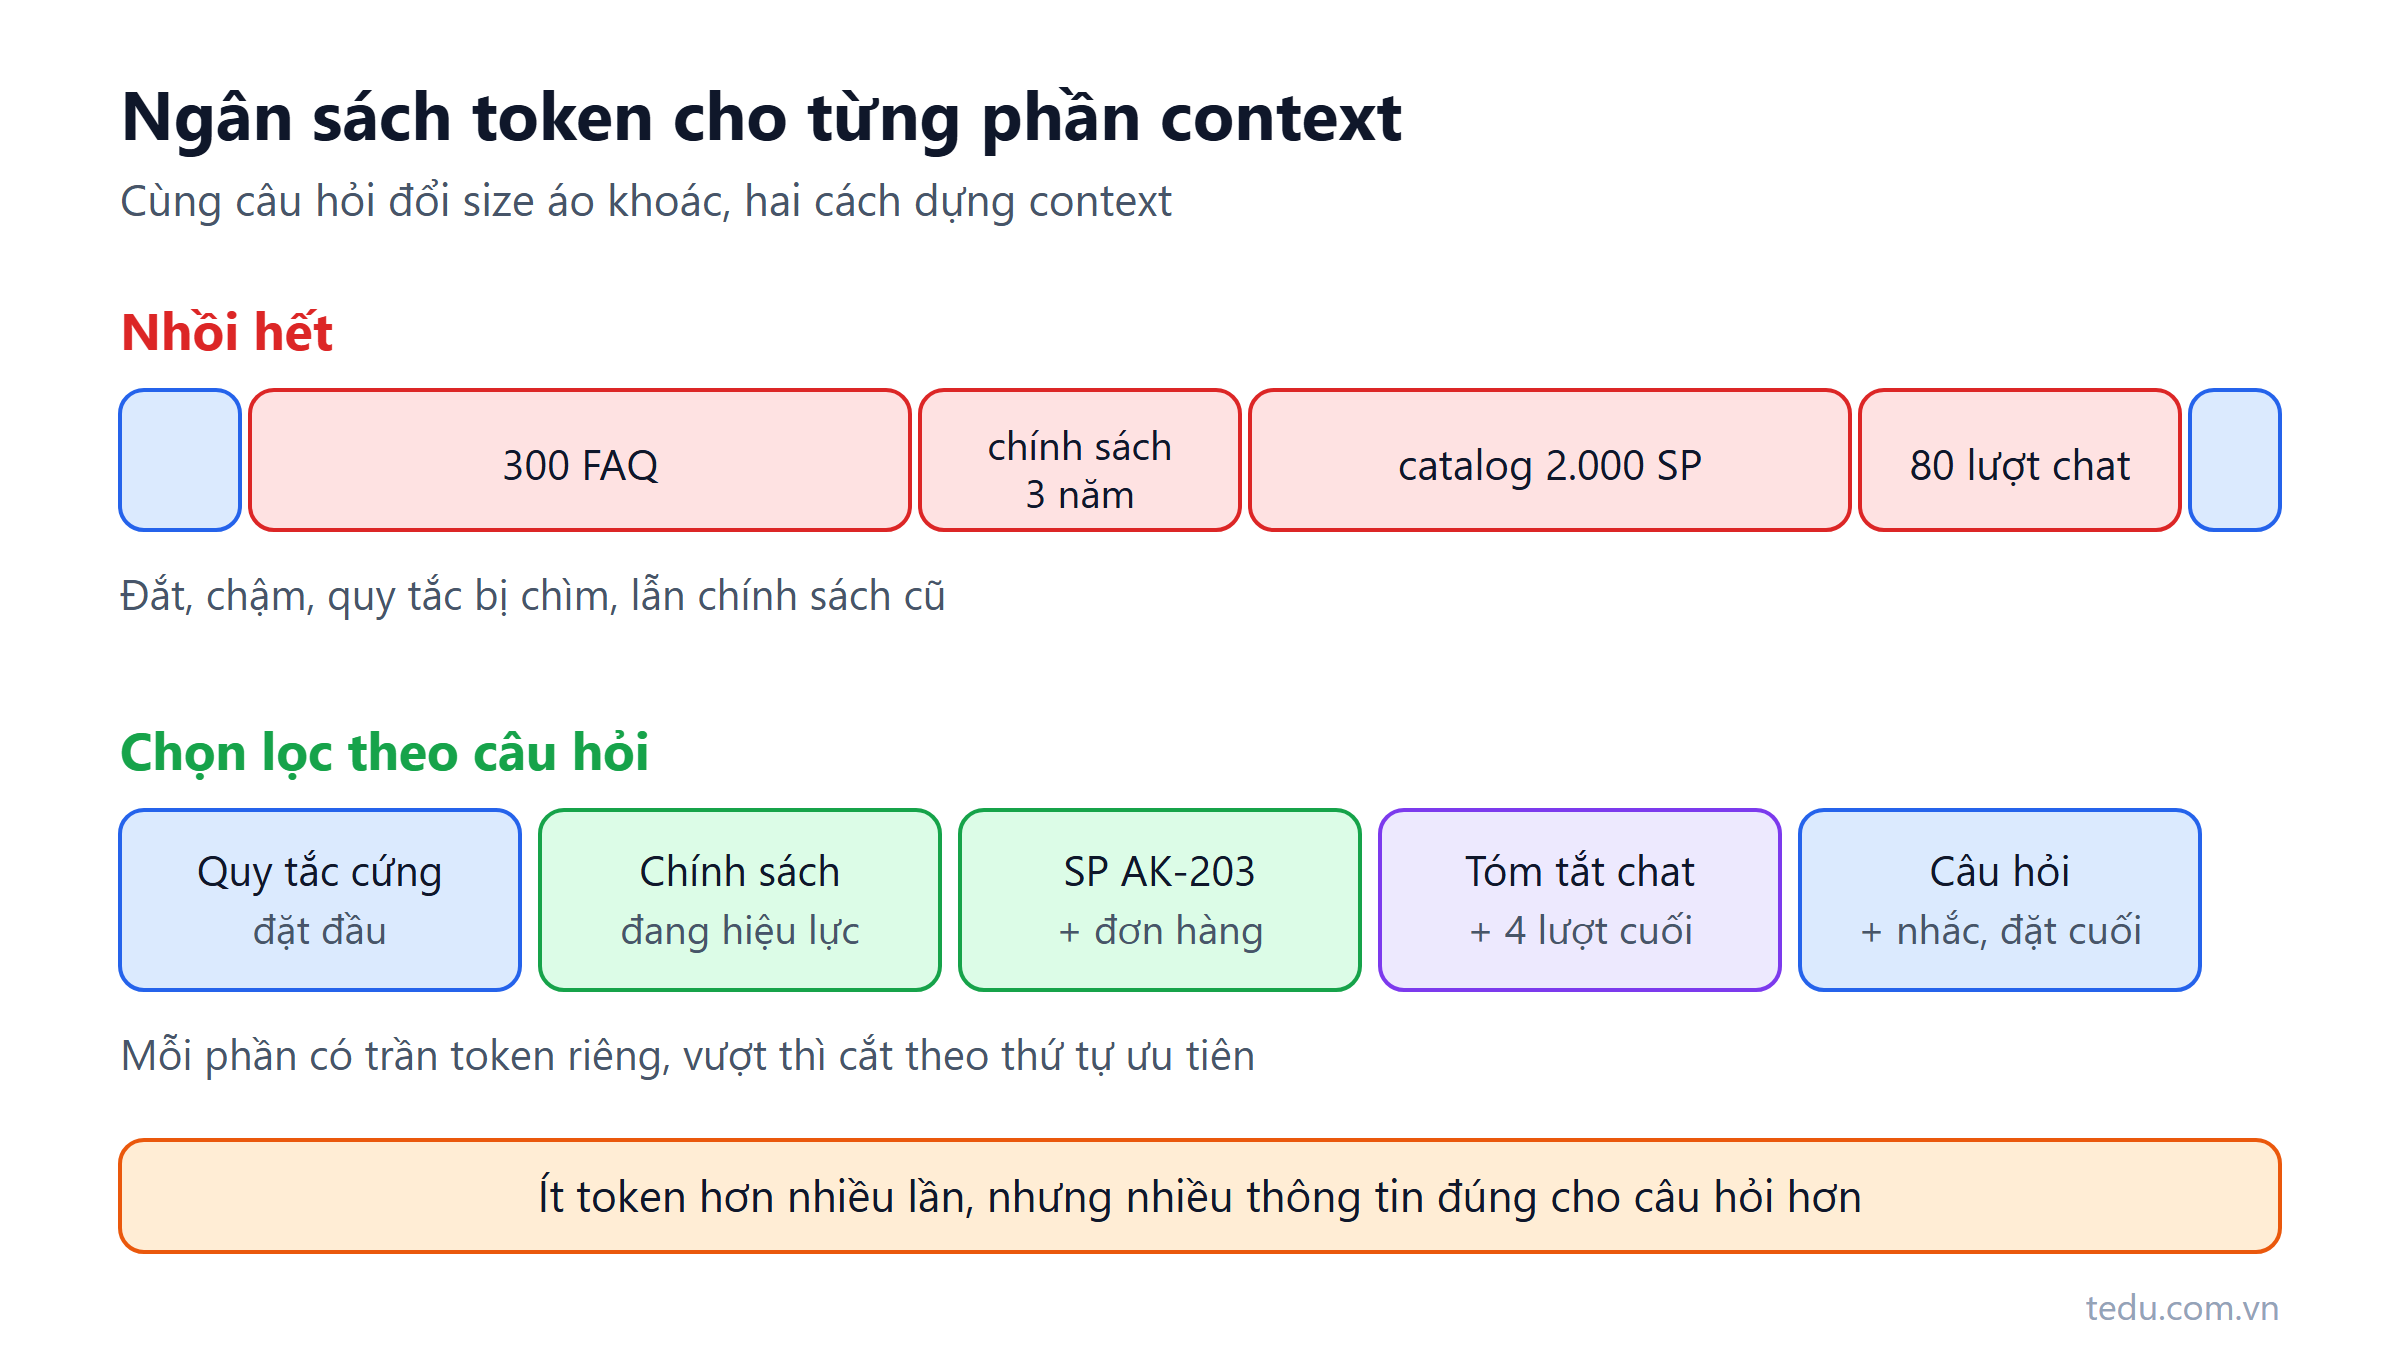
Một shop online làm chatbot chăm sóc khách hàng. Phiên bản đầu chạy khá ổn: system prompt ngắn, kèm 20 câu hỏi thường gặp. Rồi mỗi lần có khách phàn nàn, đội lại "cho thêm context cho chắc": toàn bộ 300 câu FAQ, chính sách đổi trả của 3 năm, catalog 2.000 sản phẩm, cả lịch sử chat 80 lượt. Context window của model dư sức chứa, nên ai cũng nghĩ bot sẽ thông minh hơn.
Kết quả ngược lại. Bot bắt đầu trả lời theo chính sách đổi trả cũ đã hết hiệu lực, quên luôn quy tắc "không hứa hoàn tiền khi chưa có mã đơn" nằm ở đầu prompt, và thỉnh thoảng nhầm giá giữa hai sản phẩm có tên gần giống nhau. Hóa đơn API thì tăng gấp mấy lần.
Bài này giải thích vì sao nhồi nhiều context lại làm model kém đi, dù về lý thuyết model "đọc được hết", và cách chọn context sao cho vừa đủ.
Context window lớn không có nghĩa là model đọc kỹ hết
Context window là giới hạn số token model nhận được trong một lần gọi. Nó giống dung lượng RAM: cho biết nhét được bao nhiêu, không cho biết xử lý tốt đến đâu. Một model nhận được vài trăm nghìn token vẫn có thể bỏ sót một câu quan trọng nằm giữa đống đó.
Hãy nghĩ tới một nhân viên mới được giao 500 trang tài liệu và hỏi một câu. Về mặt kỹ thuật, anh ta "có" đáp án trong tay. Nhưng nếu đáp án là một dòng ở trang 247, lại có một trang khác nói điều ngược lại, khả năng anh ta trả lời sai cao hơn nhiều so với khi bạn đưa đúng 2 trang liên quan.
Có bốn cơ chế khiến context dài làm chất lượng giảm. Chúng thường xảy ra cùng lúc.
Bốn lý do nhồi context làm model kém đi
1. Thông tin ở giữa dễ bị bỏ qua (lost in the middle)
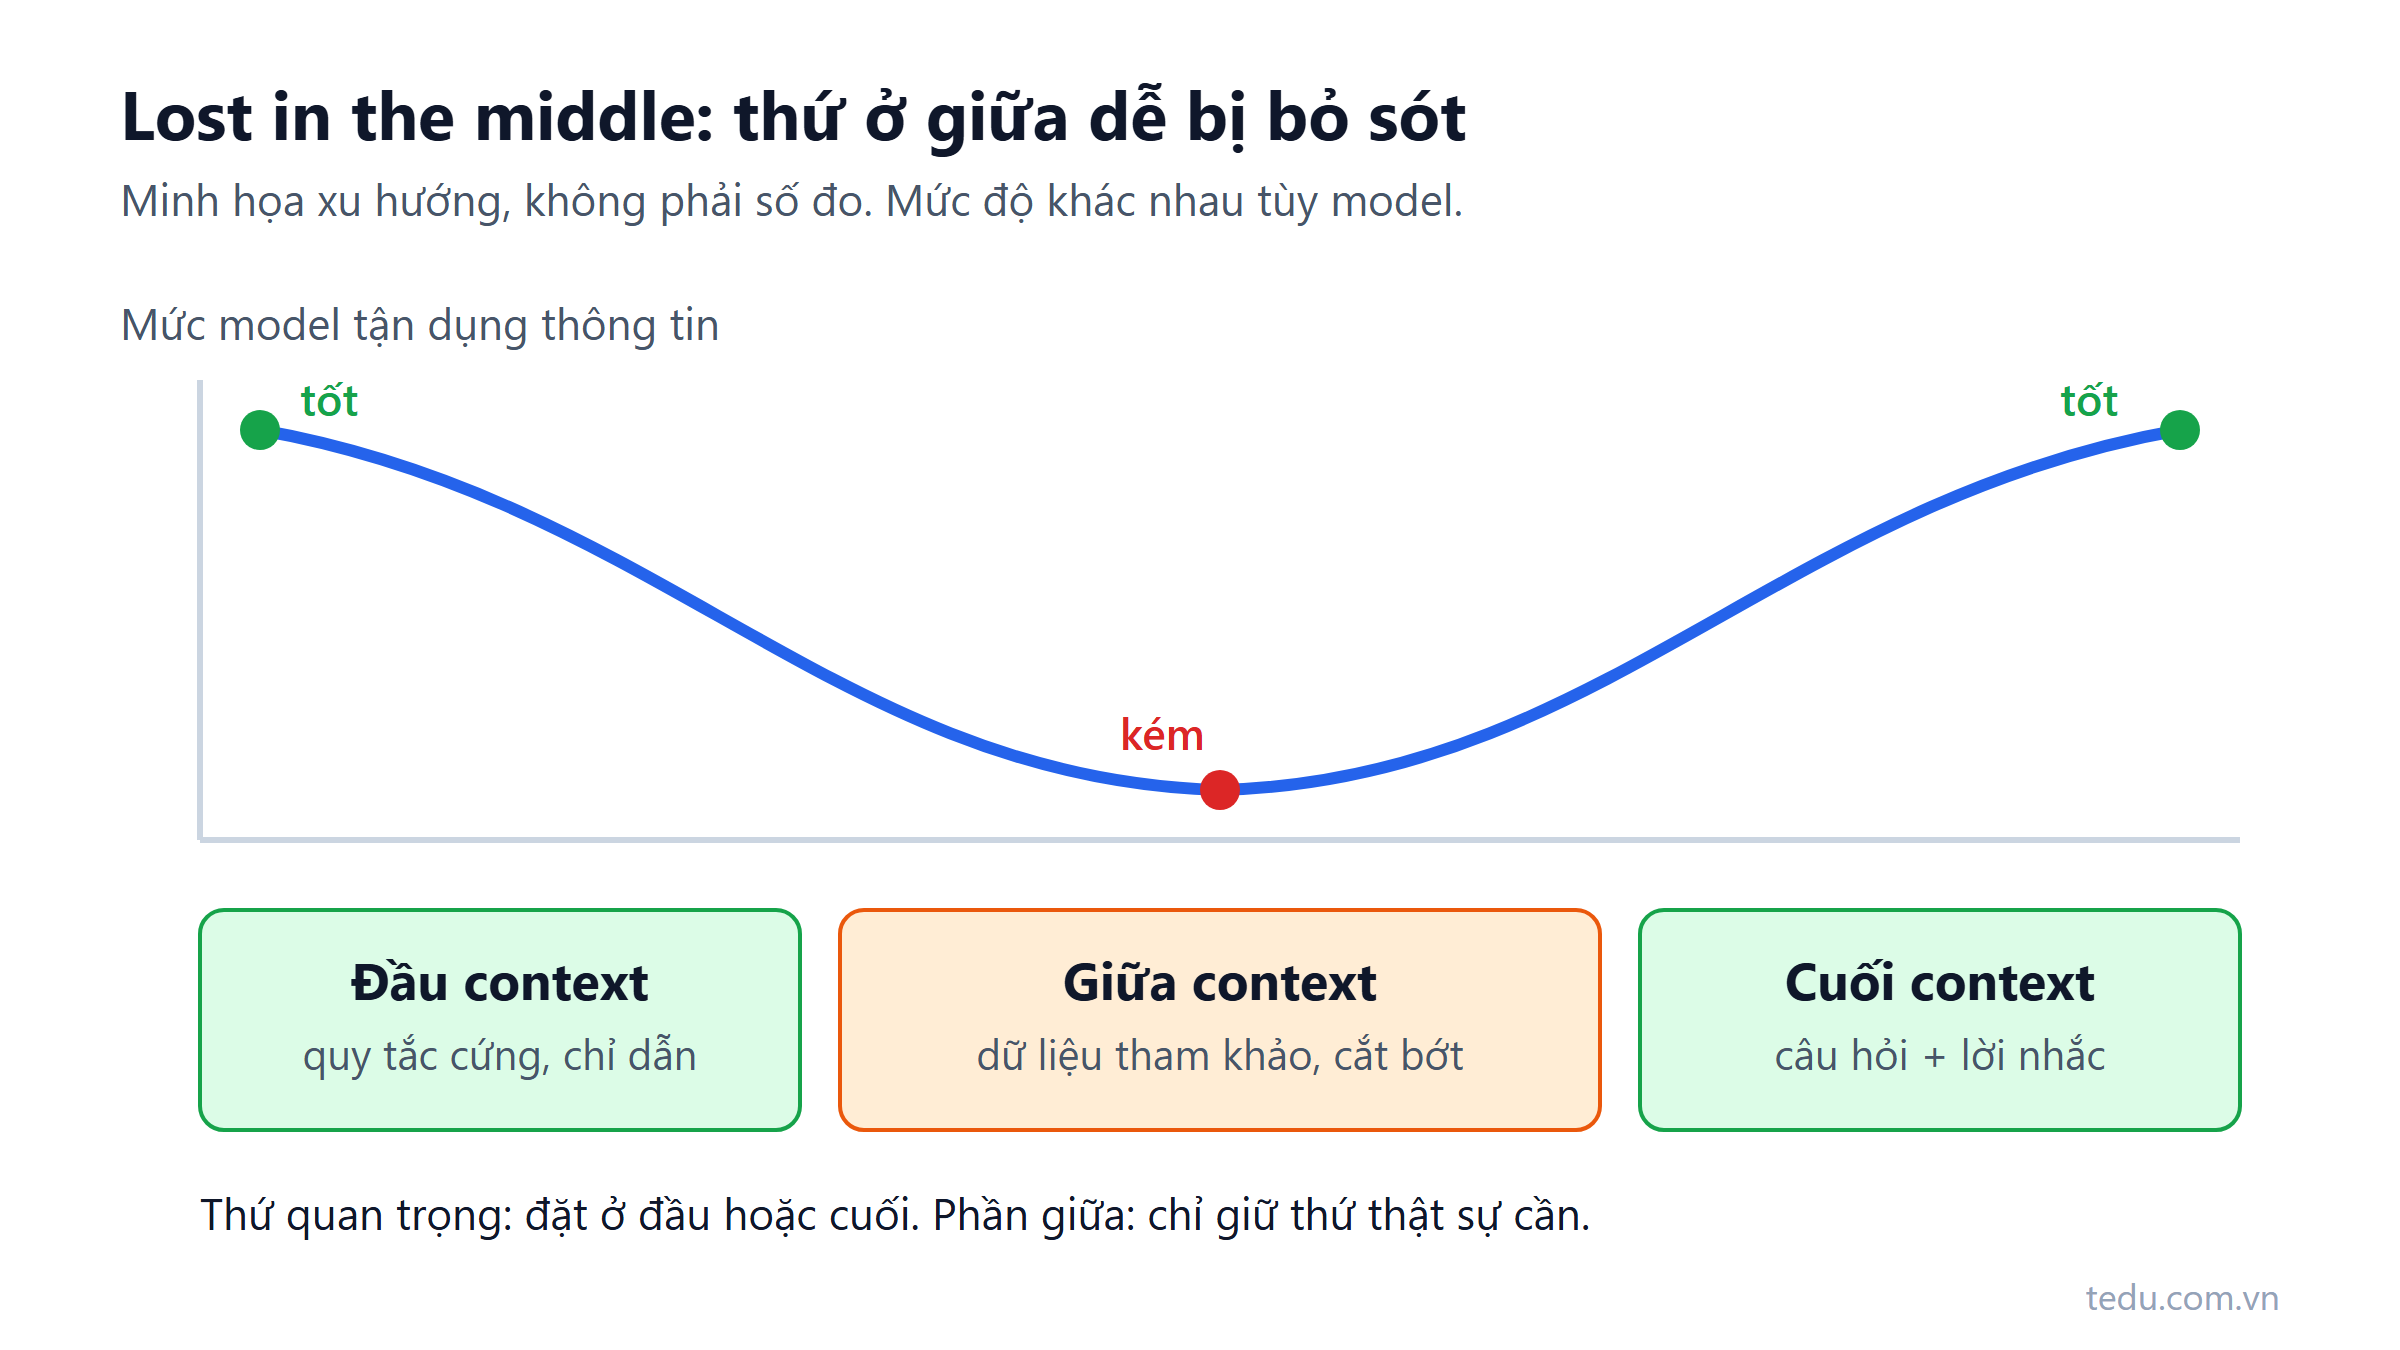
Hiện tượng "lost in the middle" đã được mô tả trong nghiên cứu về LLM: khi thông tin cần dùng nằm ở đầu hoặc cuối context, model thường tận dụng tốt; khi nó nằm lọt thỏm ở giữa một context dài, khả năng model dùng đúng thông tin đó giảm đi. Mức độ khác nhau giữa các model và các thế hệ model, model mới đã cải thiện nhiều, nhưng nguyên tắc "đừng giấu thứ quan trọng ở giữa đống chữ" vẫn đáng giữ.
Với chatbot shop online ở trên, quy tắc "không hứa hoàn tiền" nằm ở đầu system prompt, nhưng sau đó là 30.000 token FAQ và catalog, rồi mới tới câu hỏi. Quy tắc vẫn ở đó, chỉ là nó bị chìm.
2. Nhiễu và tài liệu "gần đúng" làm model phân tâm
Càng nhiều tài liệu, càng nhiều đoạn trông có vẻ liên quan nhưng không phải đáp án. Khách hỏi về "áo khoác gió nam size L", context có 15 sản phẩm áo khoác với giá khác nhau. Model phải chọn, và đôi khi chọn nhầm. Đây là lỗi khó phát hiện nhất, vì câu trả lời sai vẫn trích dẫn một con số có thật trong context.
3. Thông tin mâu thuẫn
Chính sách đổi trả 2024 cho đổi trong 30 ngày, bản 2026 chỉ còn 7 ngày. Nhồi cả hai vào context mà không ghi rõ bản nào còn hiệu lực, model không có cách nào biết nên tin bản nào. Nó có thể chọn bản cũ, hoặc tệ hơn, trộn cả hai thành một chính sách không tồn tại.
4. Chỉ dẫn bị loãng, chi phí và độ trễ tăng
Khi prompt có 20 dòng hướng dẫn và 50.000 token dữ liệu, tỷ trọng của hướng dẫn rất nhỏ. Model vẫn "thấy" hướng dẫn, nhưng mức độ tuân thủ thường giảm khi phần dữ liệu lấn át. Song song đó, mỗi token đều tốn tiền và tốn thời gian xử lý: context dài nghĩa là thời gian chờ chữ đầu tiên lâu hơn và hóa đơn cao hơn, kể cả khi 95% số token đó không dùng tới.
| Cơ chế | Biểu hiện thường gặp | Cách giảm |
|---|---|---|
| Lost in the middle | Bỏ qua quy tắc hoặc dữ kiện nằm giữa | Đặt chỉ dẫn và dữ kiện quan trọng ở đầu hoặc cuối, cắt bớt phần giữa |
| Nhiễu | Lấy nhầm sản phẩm, nhầm điều khoản gần giống | Chỉ đưa vài đoạn liên quan nhất (retrieval), lọc theo metadata |
| Mâu thuẫn | Trả lời theo bản cũ hoặc trộn hai bản | Loại bản hết hiệu lực trước khi đưa vào, ghi rõ ngày hiệu lực |
| Chỉ dẫn bị loãng | "Quên" định dạng, quên giới hạn | Giữ prompt chỉ dẫn ngắn, nhắc lại điều quan trọng gần câu hỏi |
| Chi phí, độ trễ | Hóa đơn tăng, phản hồi chậm | Đặt ngân sách token cho từng phần |
Trước và sau: cùng một chatbot, hai cách đưa context
Quay lại shop online. Đây là hai cách dựng context cho câu hỏi "Áo khoác gió mã AK-203 mua tuần trước, mặc chật, đổi size được không?".
Trước (nhồi hết):
System prompt 25 dòng.
Toàn bộ 300 FAQ.
Chính sách đổi trả 2024, 2025, 2026.
Catalog 2.000 sản phẩm.
80 lượt chat gần nhất của khách, gồm cả chuyện hỏi phí ship từ tháng trước.
Câu hỏi.
Sau (chọn lọc):
System prompt 12 dòng, quy tắc cứng đặt đầu tiên.
Chính sách đổi trả đang hiệu lực (1 đoạn).
Thông tin sản phẩm AK-203 lấy từ database (1 bản ghi, gồm bảng size).
Đơn hàng gần nhất của khách có AK-203, lấy bằng tool tra cứu đơn.
Tóm tắt 3 dòng về cuộc hội thoại trước đó, cộng 4 lượt chat gần nhất nguyên văn.
Câu hỏi, kèm một dòng nhắc: "Chỉ trả lời theo chính sách ở trên, không hứa hoàn tiền."
Bản "sau" ngắn hơn hàng chục lần, nhưng chứa nhiều thông tin hữu ích hơn cho đúng câu hỏi này: ngày mua thật, chính sách đúng, bảng size đúng sản phẩm. Đây chính là tinh thần của context engineering: việc chính không phải viết câu lệnh hay, mà là quyết định đưa gì vào và bỏ gì ra.
Cách chọn context vừa đủ
Lấy theo câu hỏi, không lấy theo kho
Thay vì đưa cả kho tài liệu, hãy tìm phần liên quan tới câu hỏi rồi mới đưa vào. Với tài liệu tự do (quy chế, FAQ, hướng dẫn), đó là RAG. Với dữ liệu có cấu trúc (đơn hàng, tồn kho, ngày phép còn lại), hãy dùng tool truy vấn database. Đưa cả catalog 2.000 sản phẩm vào prompt để model "tự tìm" là dùng LLM như một câu LIKE '%...%' đắt tiền và kém chính xác.
Lọc trước khi đưa: hiệu lực, quyền, trùng lặp
Trước khi ghép context, loại những thứ chắc chắn không nên có:
Văn bản đã hết hiệu lực (lọc theo ngày hiệu lực trong metadata).
Tài liệu người hỏi không có quyền xem.
Các đoạn trùng nhau hoặc gần trùng (cùng một FAQ xuất hiện ở hai file).
Việc lọc này nên làm bằng code và SQL, không giao cho model. Code lọc đúng 100%, model thì "thường đúng".
Rút gọn lịch sử hội thoại
LLM không có bộ nhớ, mỗi lượt app phải gửi lại lịch sử. Gửi nguyên 80 lượt là cách nhanh nhất để context phình to. Cách phổ biến: giữ nguyên văn vài lượt gần nhất, phần cũ hơn thay bằng một bản tóm tắt ngắn (do model tóm tắt định kỳ), và giữ riêng các dữ kiện quan trọng như mã đơn khách đã cung cấp.
Đặt ngân sách token cho từng phần
Đây là chỗ dev backend làm rất tốt, vì nó giống việc đặt giới hạn cho cache hay connection pool. Chia ngân sách rõ ràng: chỉ dẫn tối đa bao nhiêu, tài liệu bao nhiêu, lịch sử bao nhiêu. Phần nào vượt thì cắt theo thứ tự ưu tiên.
Ví dụ bằng C#. ITokenCounter là interface bạn tự định nghĩa (bọc tokenizer của nhà cung cấp hoặc ước lượng), các con số ngân sách chỉ là minh họa:
public sealed record ContextPart(string Name, string Text, int Priority);

public sealed class ContextBuilder(ITokenCounter counter)
{
    public string Build(IEnumerable<ContextPart> parts, int budget)
    {
        var selected = new List<ContextPart>();
        var used = 0;

        // Ưu tiên cao (số nhỏ) được giữ trước
        foreach (var part in parts.OrderBy(p => p.Priority))
        {
            var tokens = counter.Count(part.Text);
            if (used + tokens > budget) continue; // bỏ phần không vừa
            selected.Add(part);
            used += tokens;
        }

        return string.Join("\n\n", selected.Select(p =>
            $"<{p.Name}>\n{p.Text}\n</{p.Name}>"));
    }
}
Bọc từng phần bằng thẻ như <policy>, <order>, <history> giúp model phân biệt đâu là chính sách, đâu là dữ liệu đơn, đâu là lời khách nói. Nó cũng giúp bạn khi đọc log: nhìn vào là biết lượt này đưa gì vào.
Đặt thứ quan trọng ở đầu và cuối
Quy tắc cứng (không hứa hoàn tiền, không tiết lộ thông tin khách khác) đặt ở đầu. Câu hỏi và một dòng nhắc lại yêu cầu quan trọng nhất đặt ở cuối, ngay trước chỗ model bắt đầu viết. Phần dữ liệu tham khảo nằm giữa. Cách sắp xếp này tận dụng đúng chỗ model thường chú ý tốt nhất.
Tự đo trên dữ liệu của bạn, đừng tin cảm giác
Mỗi model chịu context dài khác nhau, và nhà cung cấp liên tục cải thiện. Thay vì tin một con số chung chung, hãy làm một thí nghiệm nhỏ trong một buổi chiều:
Chọn 20–30 câu hỏi thật của khách, mỗi câu biết rõ đáp án đúng nằm ở đoạn nào.
Chạy ba cấu hình: chỉ đưa đoạn đúng; đưa đoạn đúng cùng 10 đoạn nhiễu; đưa đoạn đúng lẫn trong toàn bộ kho.
Với cấu hình thứ ba, thử đặt đoạn đúng ở đầu, giữa và cuối.
Đo tỷ lệ trả lời đúng, số token input và thời gian phản hồi của từng cấu hình.
Bảng kết quả này sẽ trả lời câu hỏi "có nên nhồi thêm không" cho đúng model và đúng dữ liệu của bạn, tốt hơn mọi bài viết (kể cả bài này). Đây cũng là bước đầu của một bộ eval mà sớm muộn bạn sẽ cần.
Lỗi hay gặp và checklist áp dụng
Những lỗi hay gặp khi làm ứng dụng LLM với context:
"Cho thêm cho chắc." Mỗi khi bot trả lời sai lại thêm tài liệu, trong khi lỗi thật là tài liệu đúng bị lẫn trong tài liệu thừa.
Không ghi ngày hiệu lực. Hai phiên bản chính sách cùng nằm trong context, không có metadata để phân biệt.
Gửi nguyên lịch sử chat. Context tăng tuyến tính theo độ dài hội thoại, đến lượt thứ 50 thì chậm và đắt.
Dùng LLM để lọc dữ liệu có cấu trúc. Đưa cả bảng đơn hàng vào để model "tìm đơn của khách A", thay vì một câu SQL.
Không log context thực tế. Khi bot sai, không ai biết lượt đó model đã được đưa những gì.
Checklist trước khi thêm một phần context mới:
Phần này có cần cho câu hỏi hiện tại không, hay chỉ "có thể cần"?
Có thể lấy theo câu hỏi (retrieval, tool, SQL) thay vì đưa cả khối?
Đã loại bản hết hiệu lực, bản trùng và phần người dùng không có quyền xem?
Phần này có ngân sách token riêng và thứ tự ưu tiên khi bị cắt?
Quy tắc quan trọng nằm ở đầu, câu hỏi và lời nhắc nằm ở cuối?
Đã đo trên bộ câu hỏi thật rằng thêm phần này làm kết quả tốt hơn?
Kết luận
Context window cho biết model nhận được bao nhiêu, không cho biết model dùng tốt bao nhiêu. Nhồi nhiều context làm model kém đi vì bốn lý do: thông tin ở giữa dễ bị bỏ sót, nhiễu làm phân tâm, mâu thuẫn làm model chọn sai, và chỉ dẫn bị loãng, chưa kể tiền và độ trễ. Cách sửa là chọn lọc: lấy theo câu hỏi, lọc bằng code, rút gọn lịch sử, đặt ngân sách token và sắp xếp thứ quan trọng ở đầu, cuối.
Bước tiếp theo: lấy chatbot hoặc tính năng AI bạn đang làm, log ra toàn bộ context của 10 lượt gọi gần nhất và đếm xem bao nhiêu phần trăm thật sự được dùng. Bài kế tiếp trong series nói về cách cho model suy nghĩ trước khi trả lời bằng chain-of-thought.
Xem bản tóm tắt dưới một phút trên YouTube @teduco hoặc TikTok @teducolabs, và đọc thêm các bài khác trong chuyên mục AI cho Backend Developer.
Bài viết liên quan
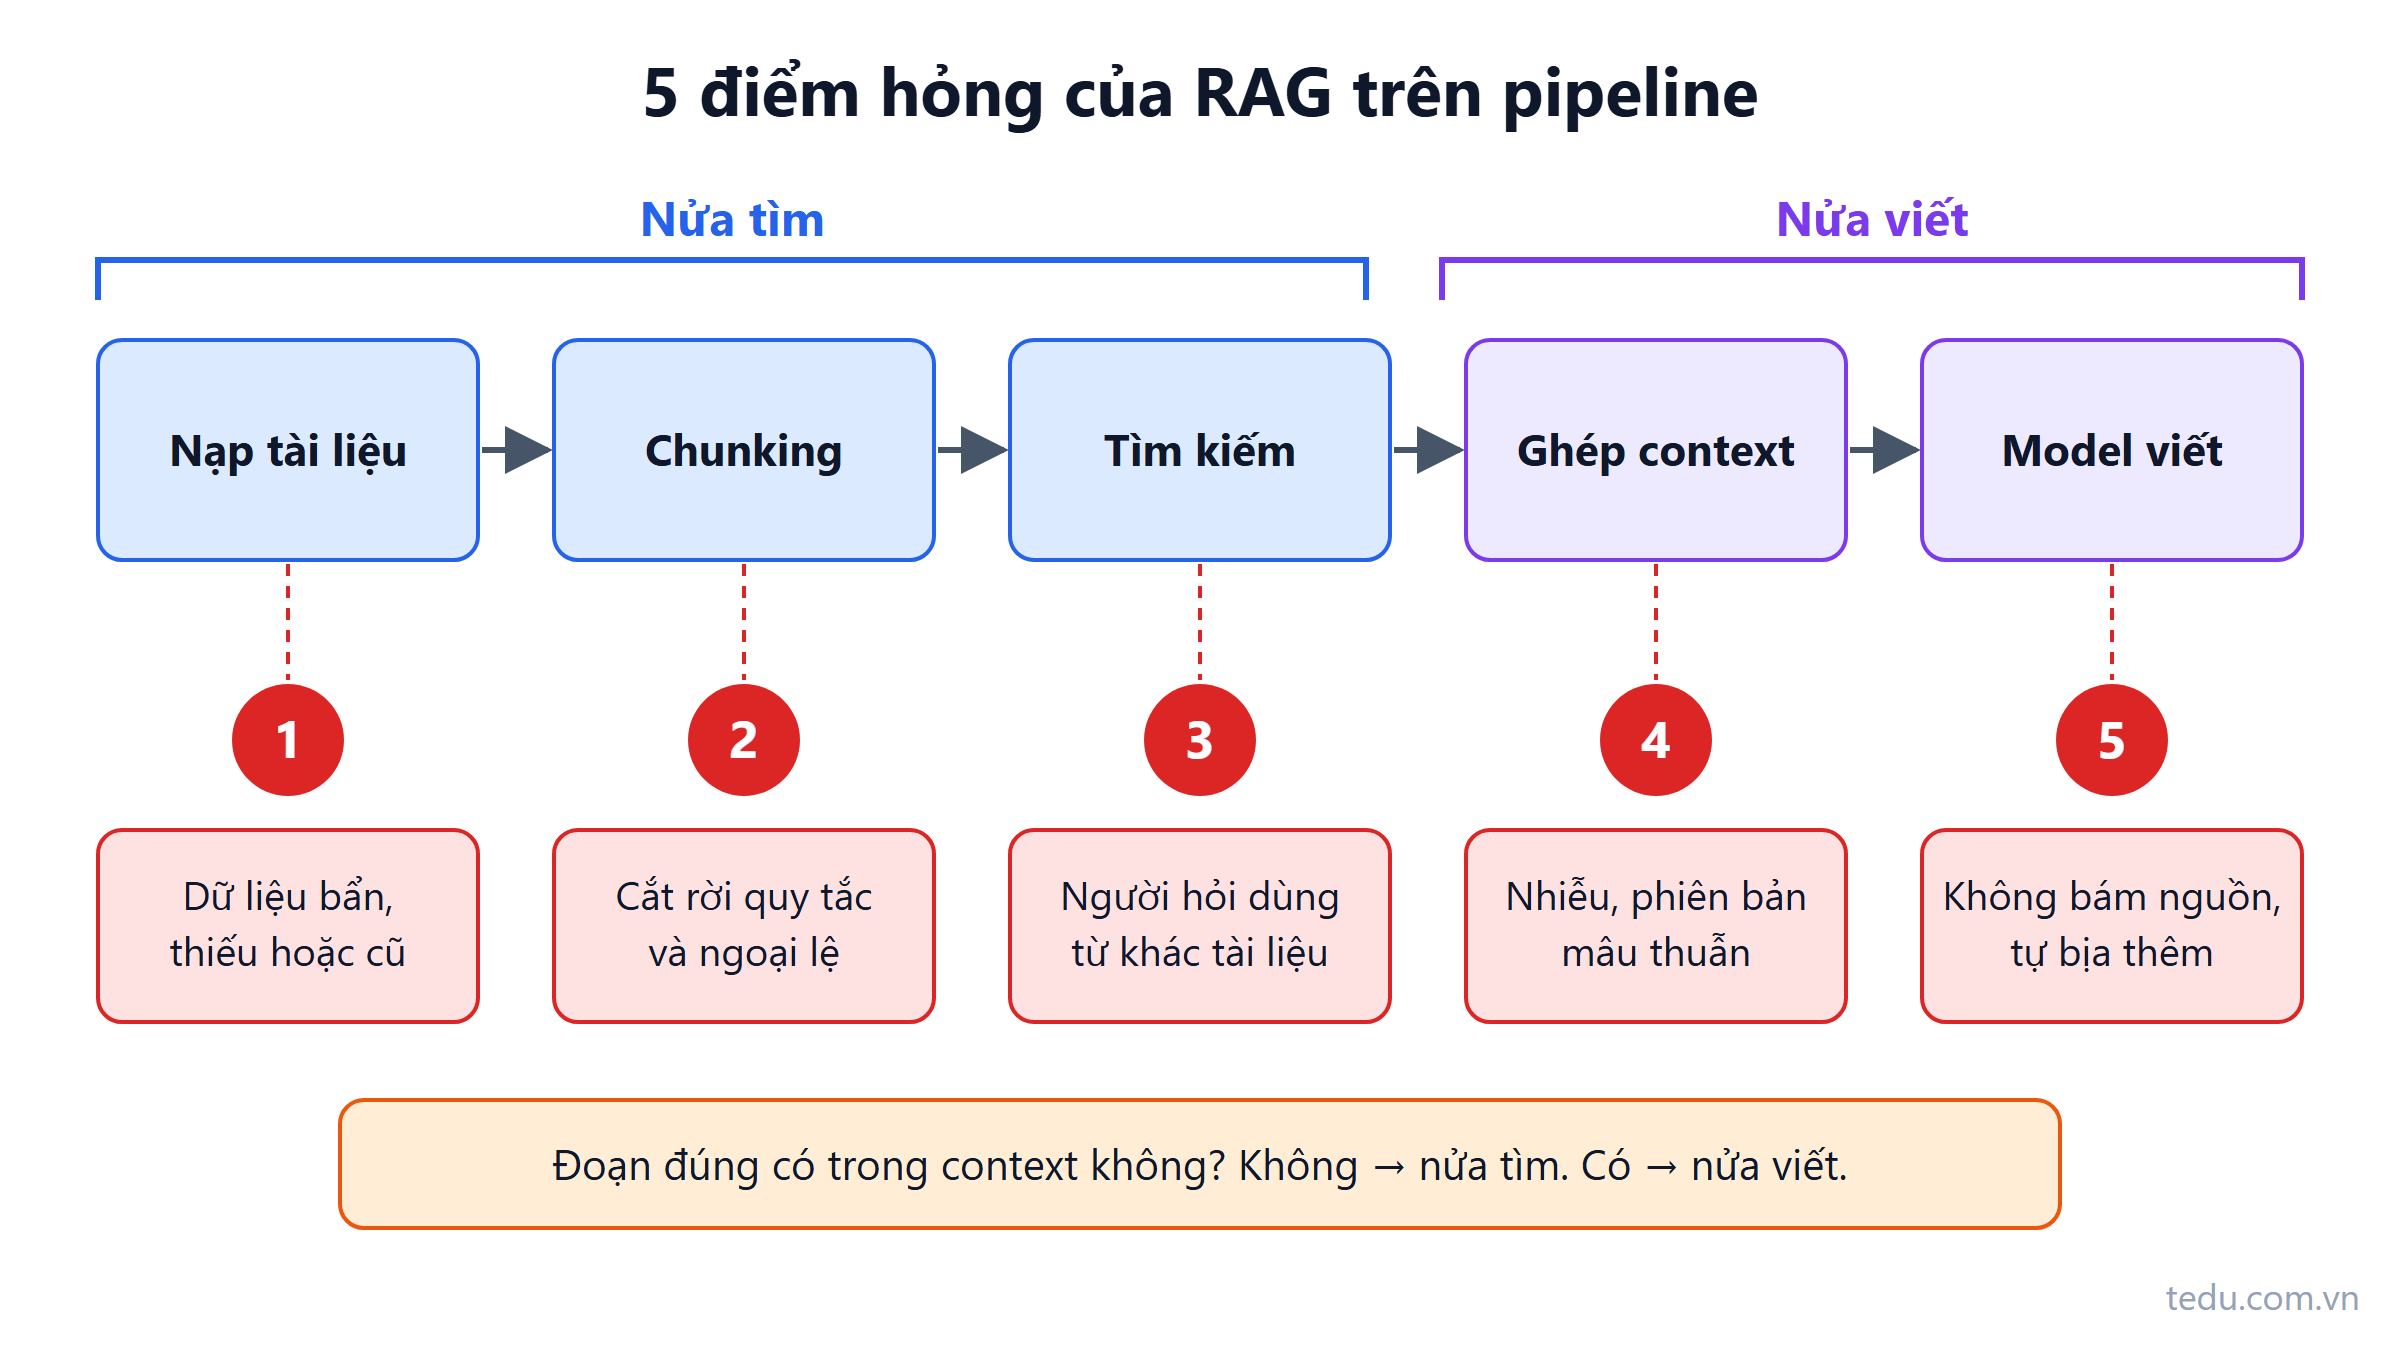
5 lý do RAG trả lời sai và cách tìm đúng chỗ hỏng
RAG trả lời sai hiếm khi do model kém. Bài chỉ ra 5 chỗ hỏng thường gặp từ dữ liệu, chunking, tìm kiếm đến prompt, kèm cách khoanh vùng lỗi bằng log.
Đọc thêm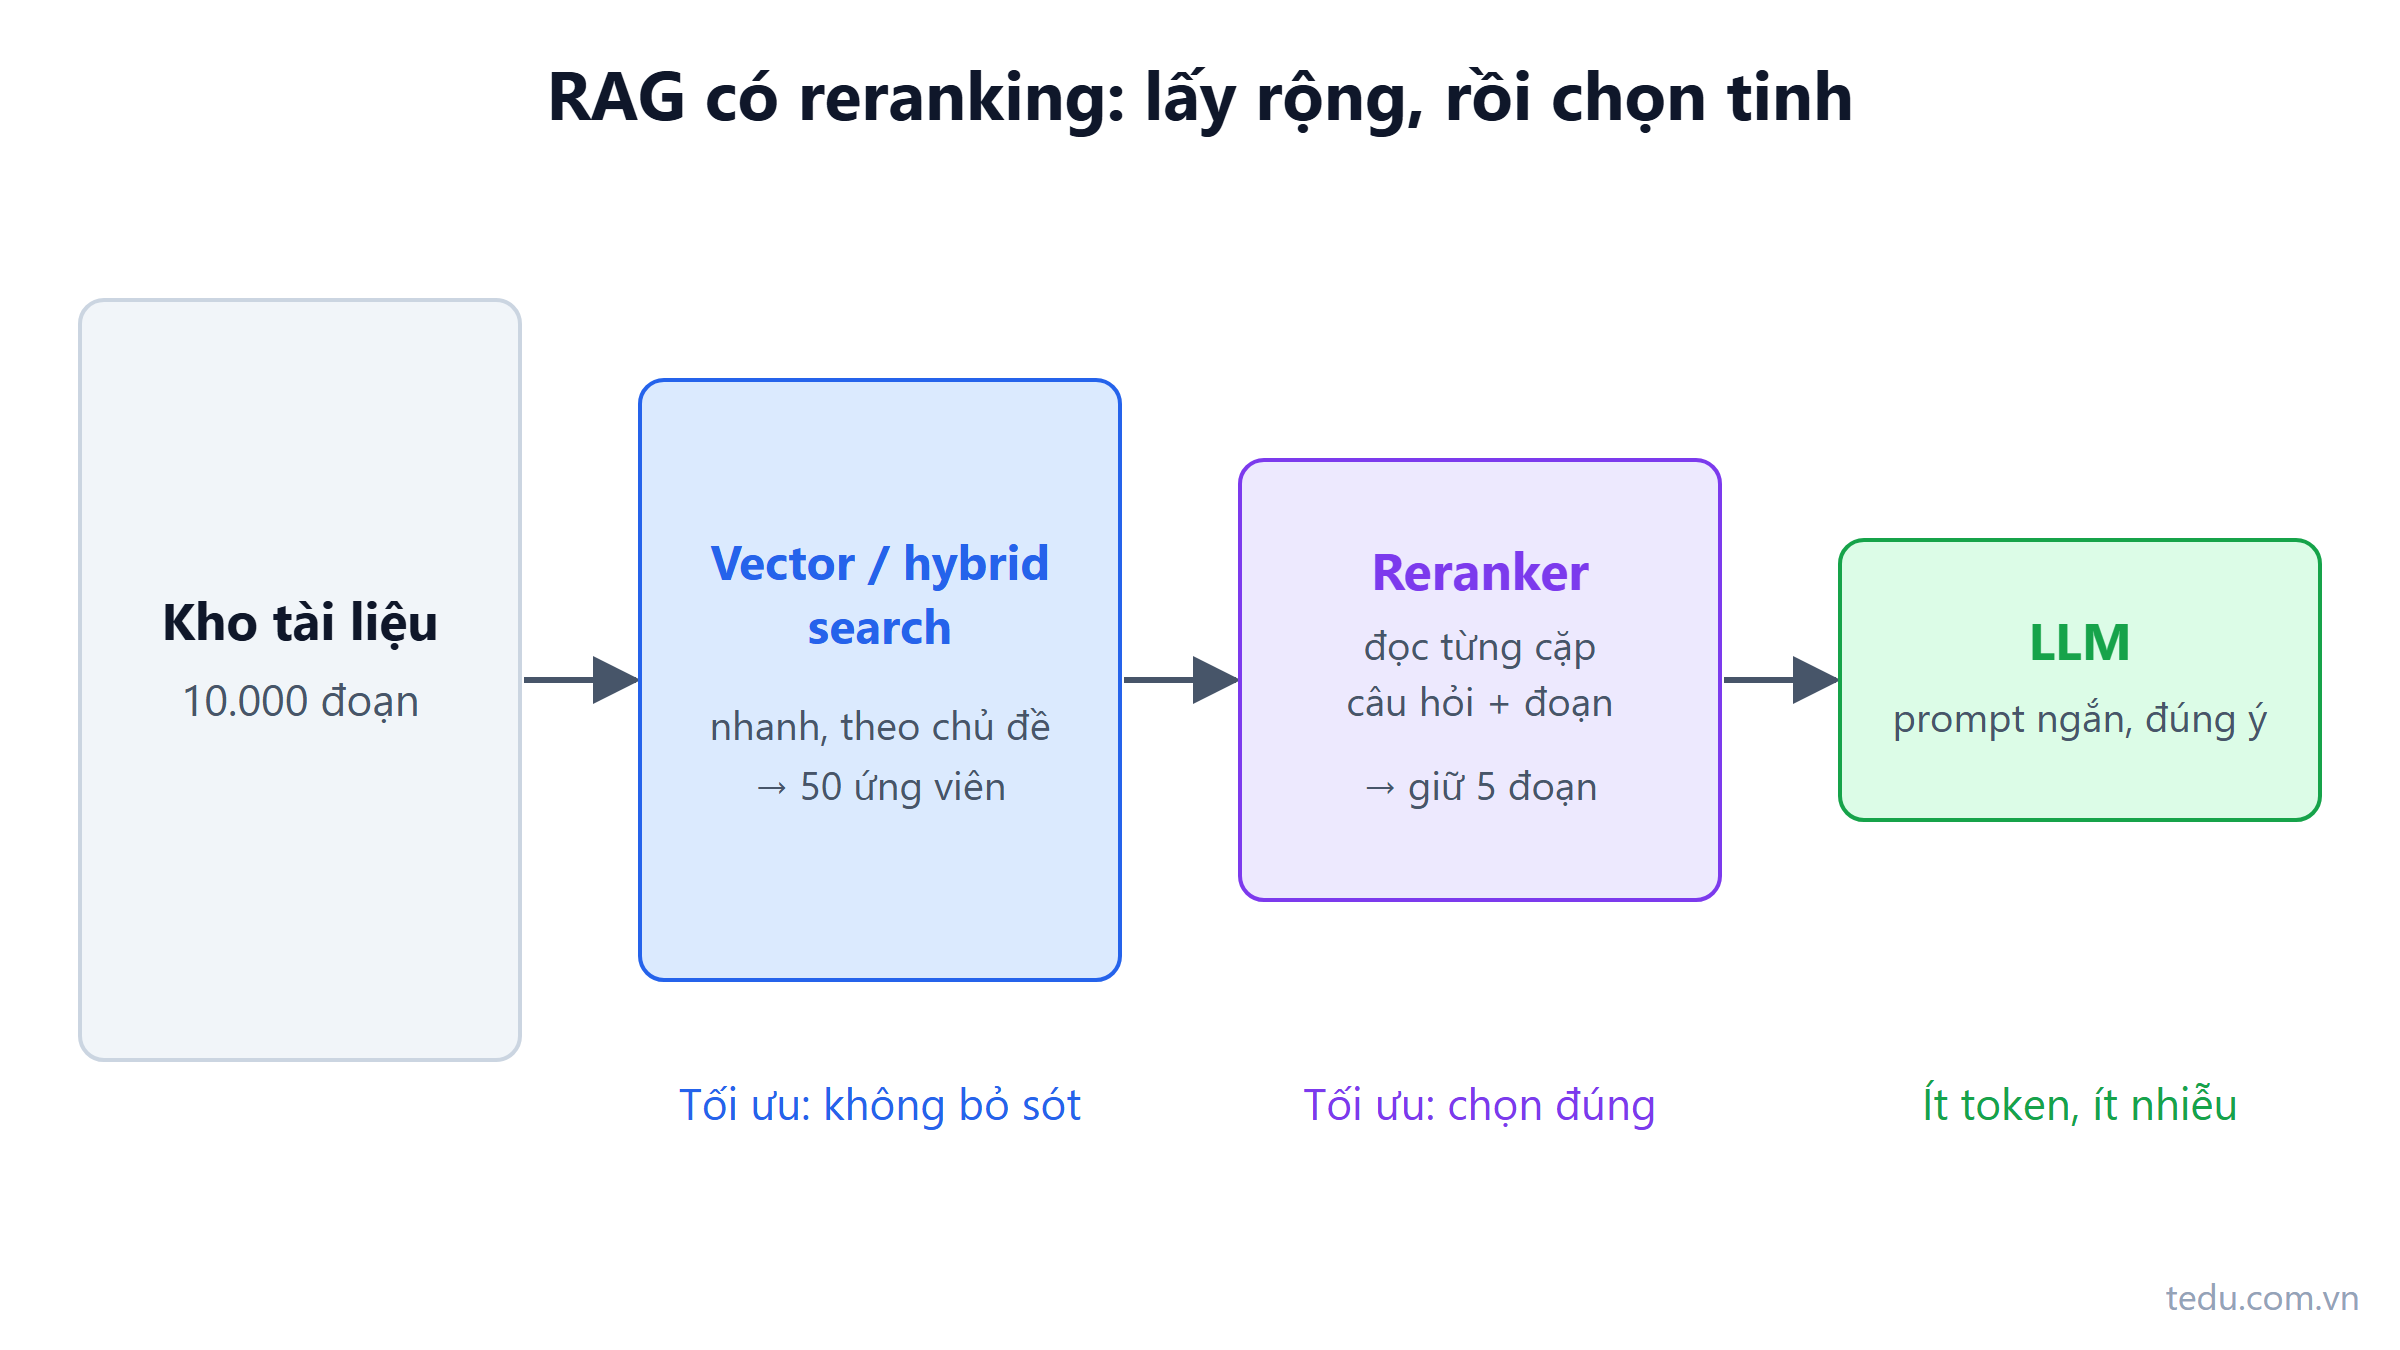
Reranking trong RAG: bước bị bỏ qua nhiều nhất
Reranking chấm lại vài chục đoạn tìm được để chọn ra vài đoạn thật sự trả lời câu hỏi. Bài giải thích cơ chế, cách gắn vào pipeline C# và lỗi hay gặp.
Đọc thêm
Hybrid search trong RAG: kết hợp keyword và vector
Vector search giỏi hiểu nghĩa nhưng hay trượt mã đơn hàng, số hiệu văn bản. Hybrid search kết hợp keyword và vector bằng RRF, có ví dụ SQL PostgreSQL và C#.
Đọc thêm
pgvector: vì sao PostgreSQL thường đủ làm vector DB
pgvector biến PostgreSQL thành vector database cho RAG. Hướng dẫn SQL, C#, so sánh với vector DB chuyên dụng và khi nào pgvector không đủ.
Đọc thêm
Chunking trong RAG: cắt tài liệu sai thì kết quả hỏng
Chunking là bước cắt tài liệu thành đoạn nhỏ trước khi đưa vào RAG. Bài so sánh các cách chunking, ví dụ với quy chế tiếng Việt và code C# cắt theo Điều, Khoản.
Đọc thêm
RAG là gì? Khi nào cần và khi nào không cần
RAG là cách đưa đúng đoạn tài liệu vào prompt để model trả lời theo dữ liệu thật. Bài này giải thích pipeline và khi nào bạn không cần RAG.
Đọc thêm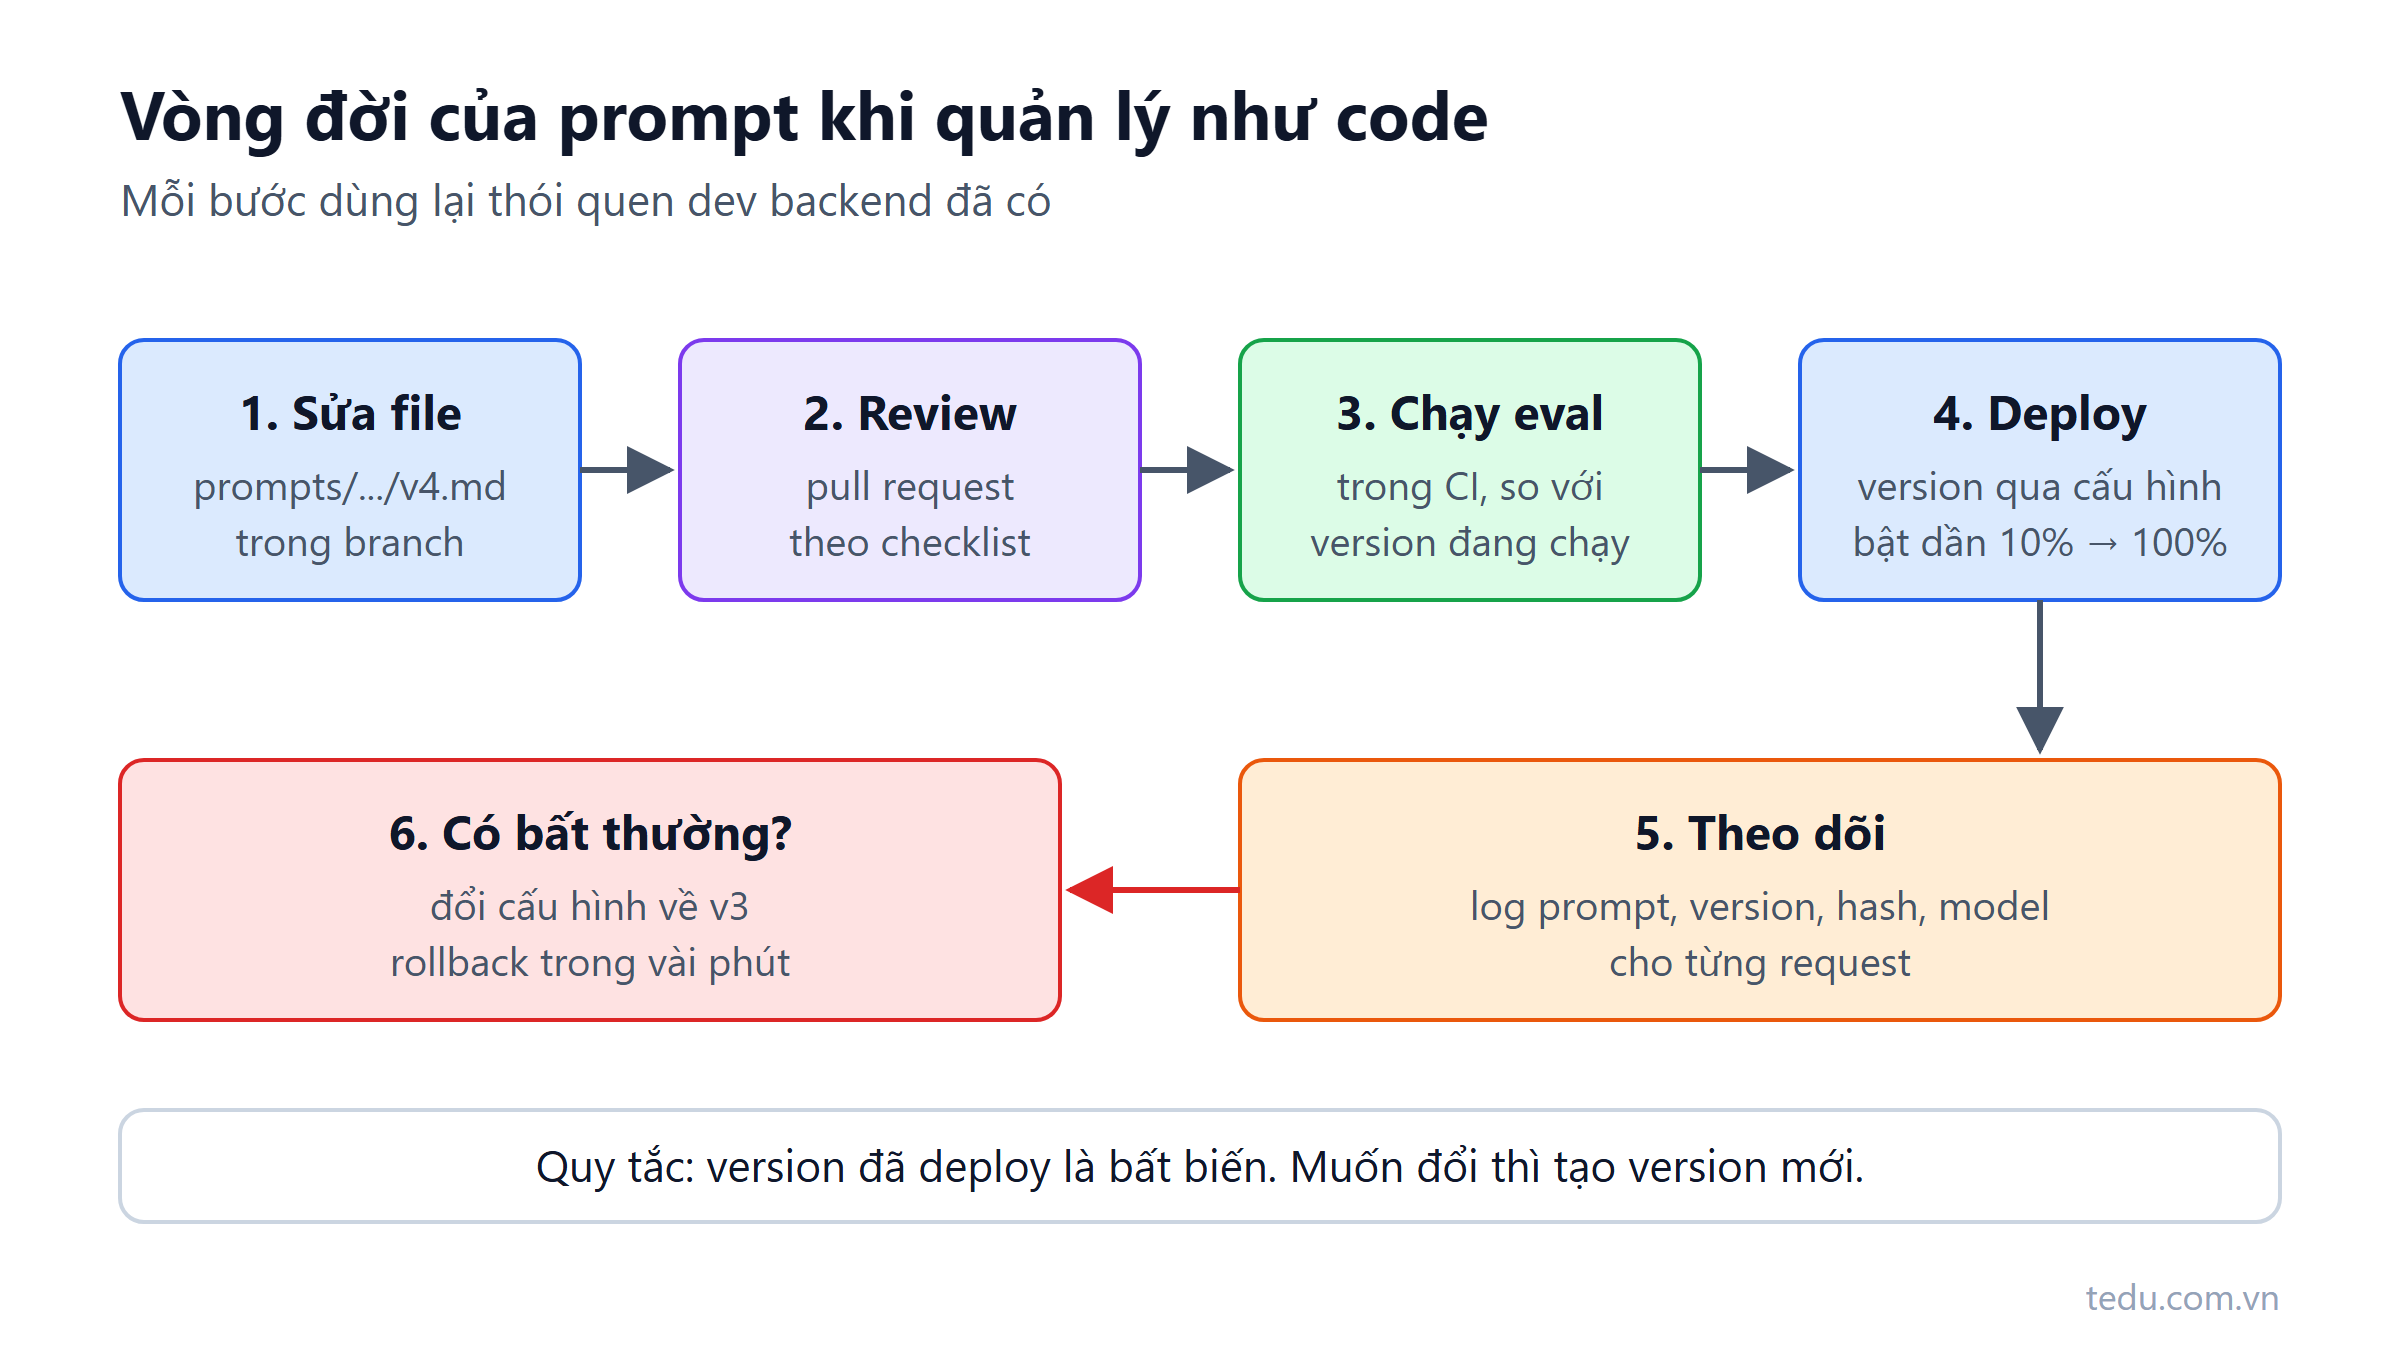
Quản lý prompt như code: versioning, review và test
Prompt là logic nghiệp vụ, sửa một câu có thể đổi hành vi cả hệ thống. Bài hướng dẫn quản lý prompt như code: lưu trong repo, versioning, review, test và rollback.
Đọc thêm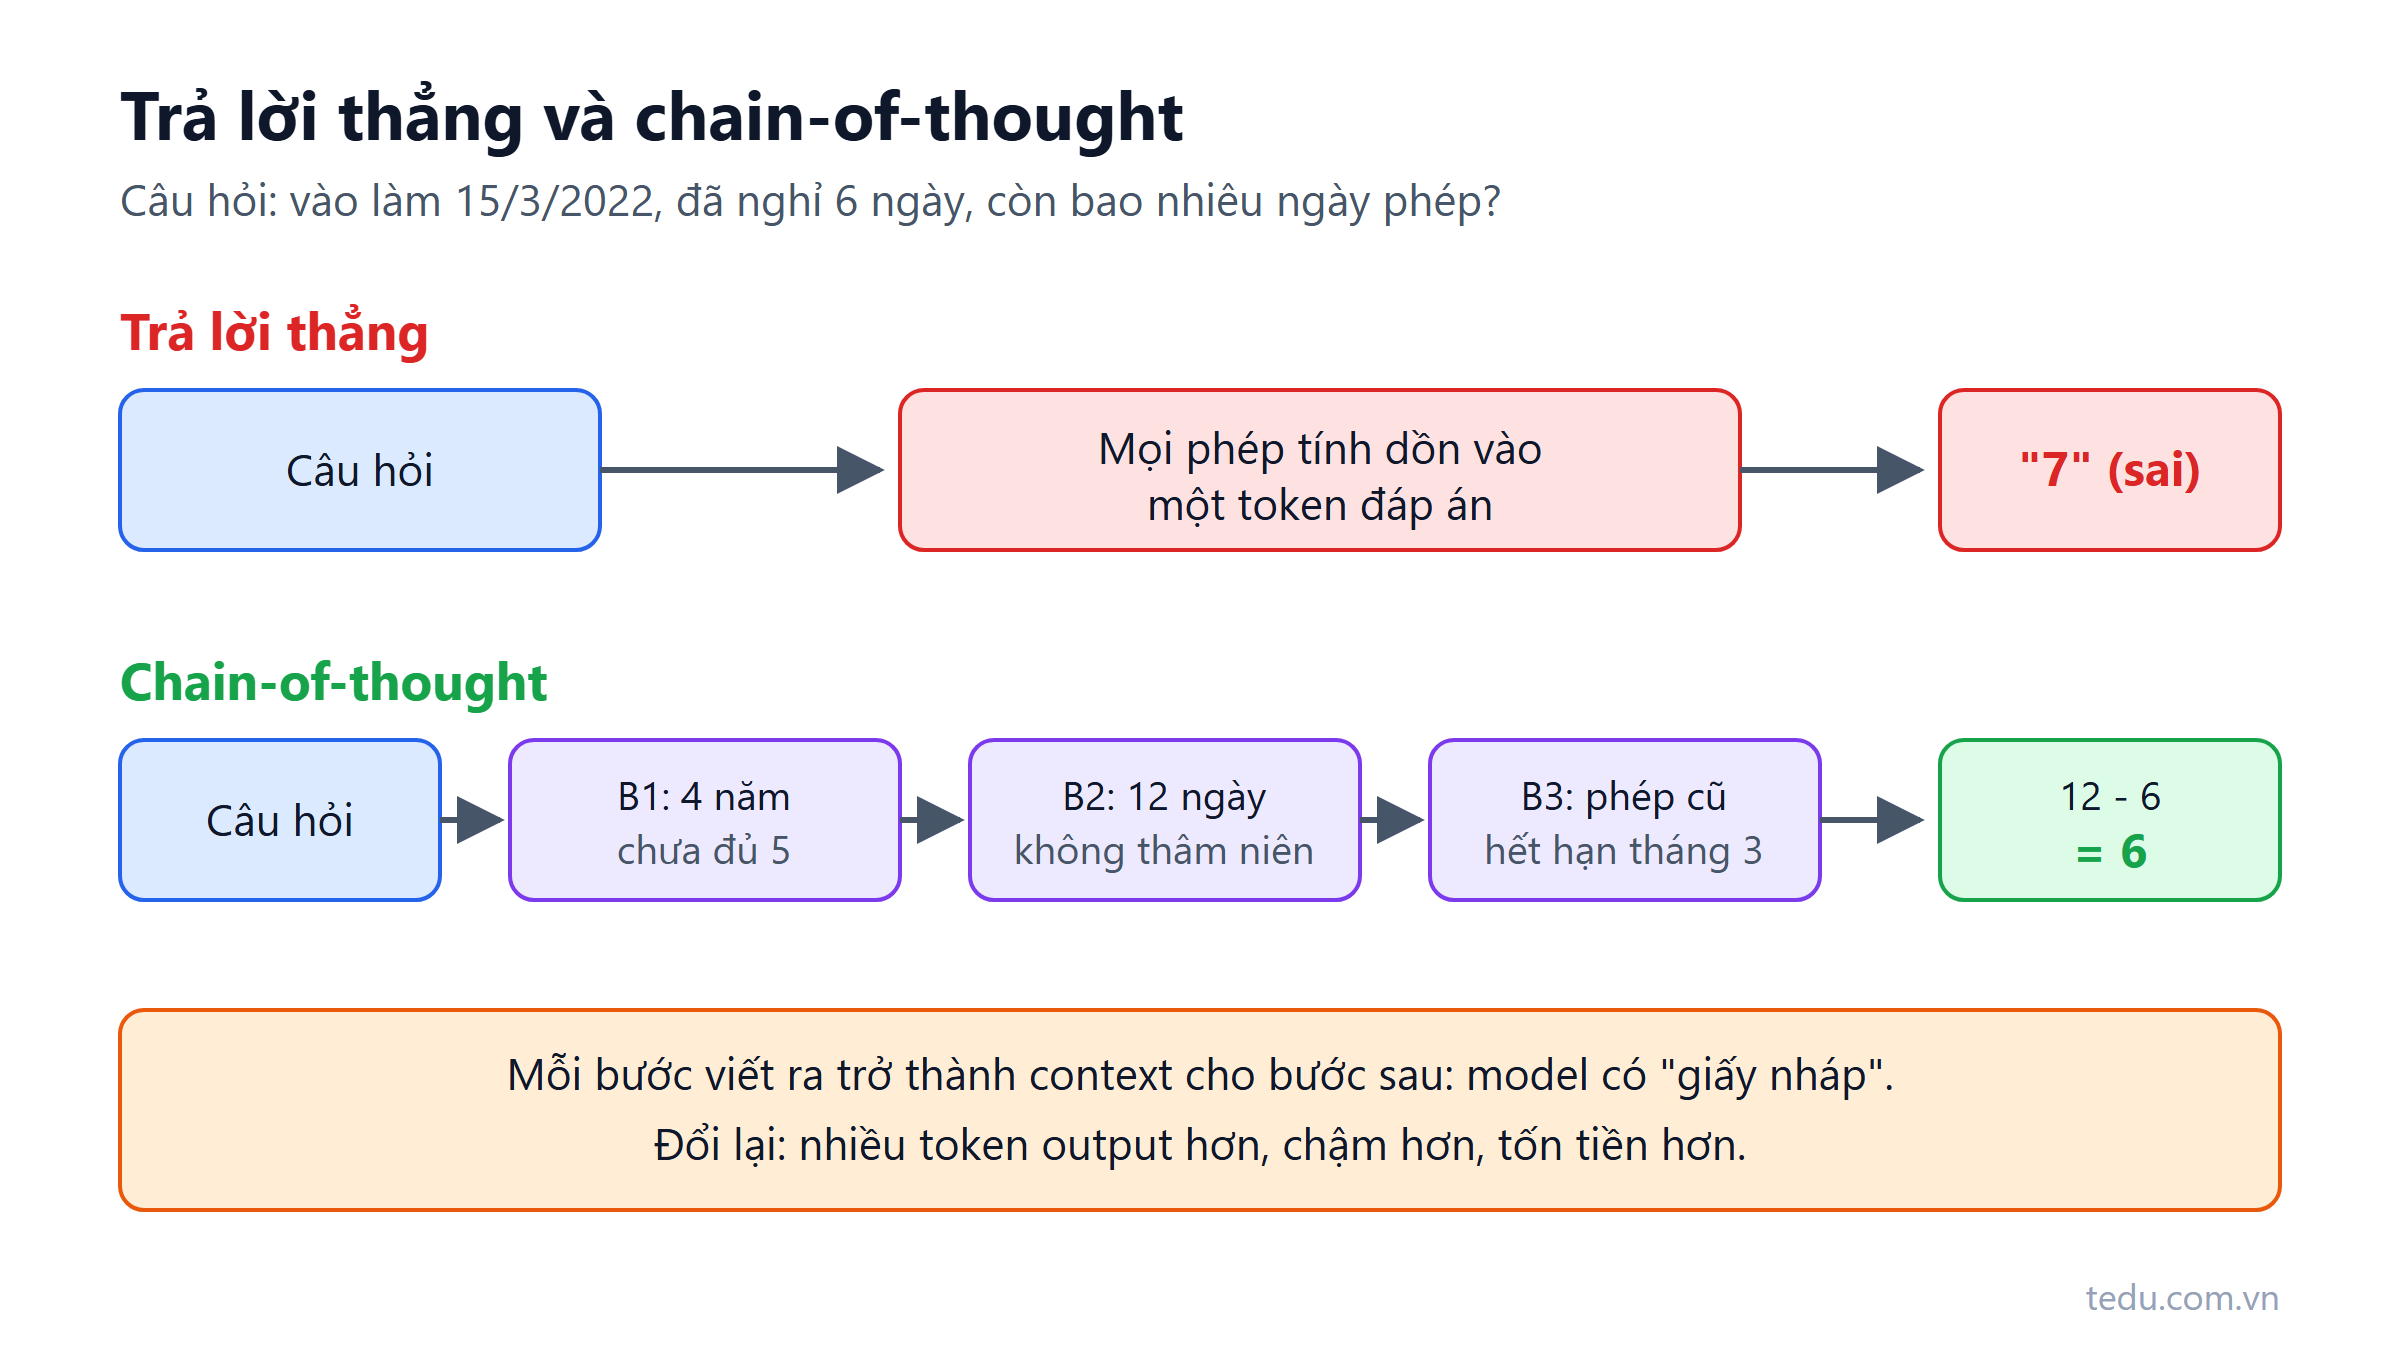
Chain-of-thought: cho model suy nghĩ trước khi trả lời
Chain-of-thought là cho model viết các bước suy luận trước khi chốt đáp án. Bài giải thích vì sao nó hiệu quả, khi nào nên dùng và cách dùng trong production.
Đọc thêm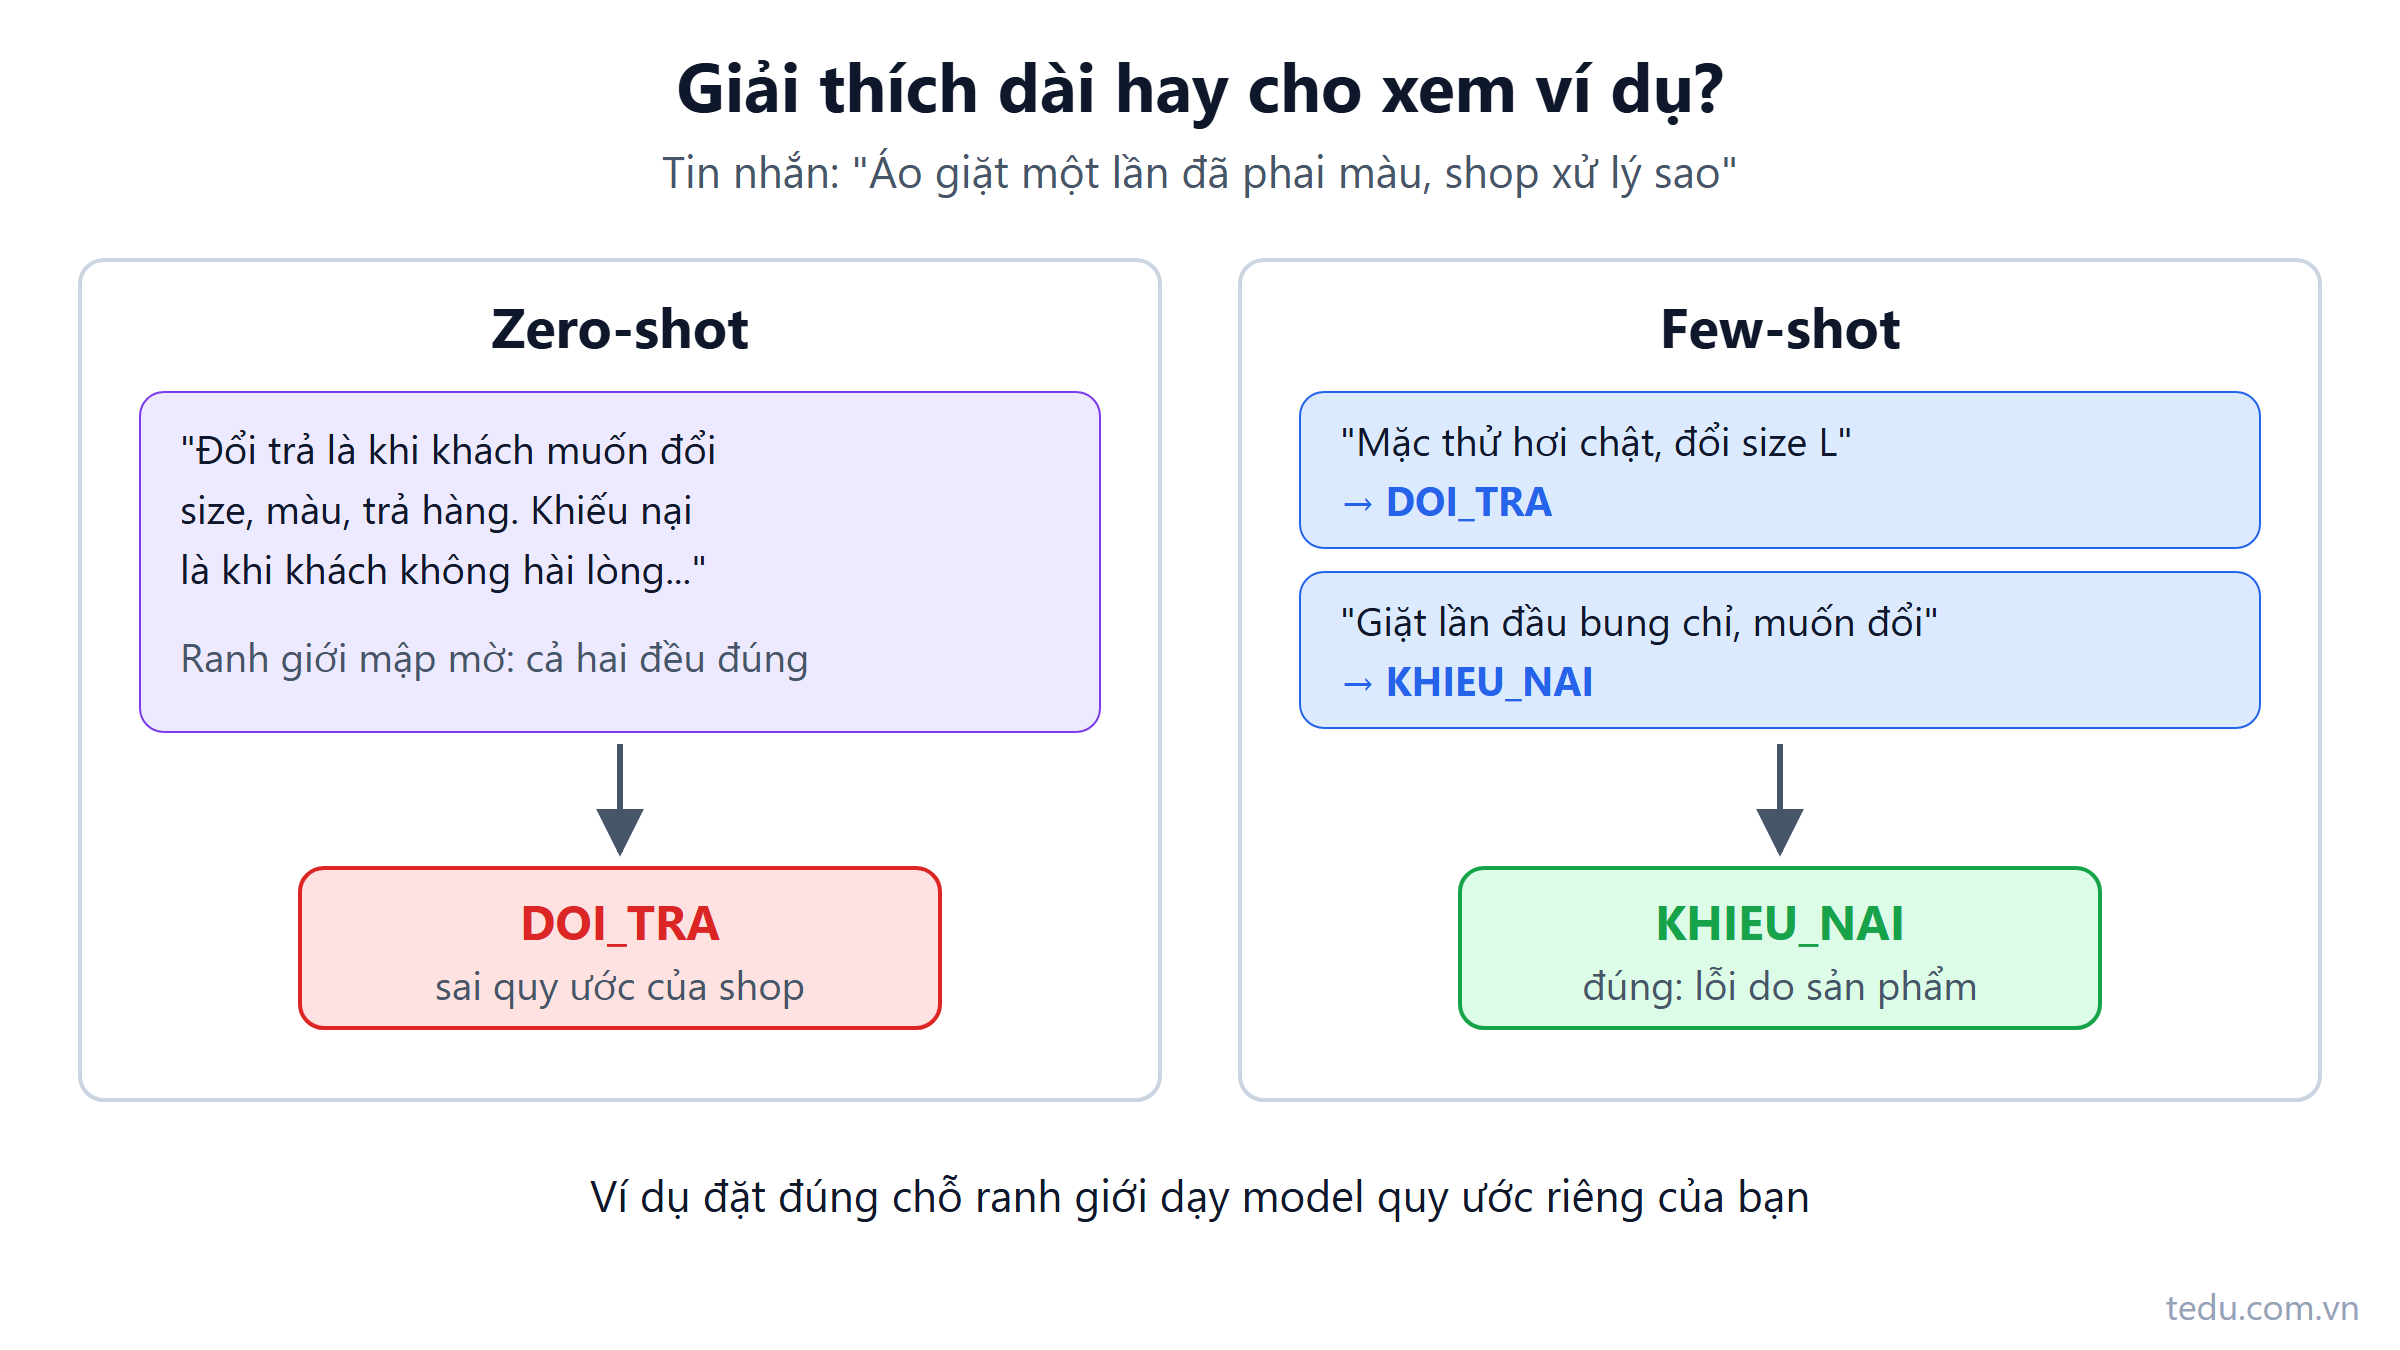
Few-shot prompting: cho LLM ví dụ thay vì giải thích dài dòng
Few-shot prompting là đưa vài ví dụ đầu vào và đầu ra mẫu để LLM bắt chước. Bài chỉ cách chọn ví dụ, lỗi hay gặp và few-shot động bằng C#.
Đọc thêm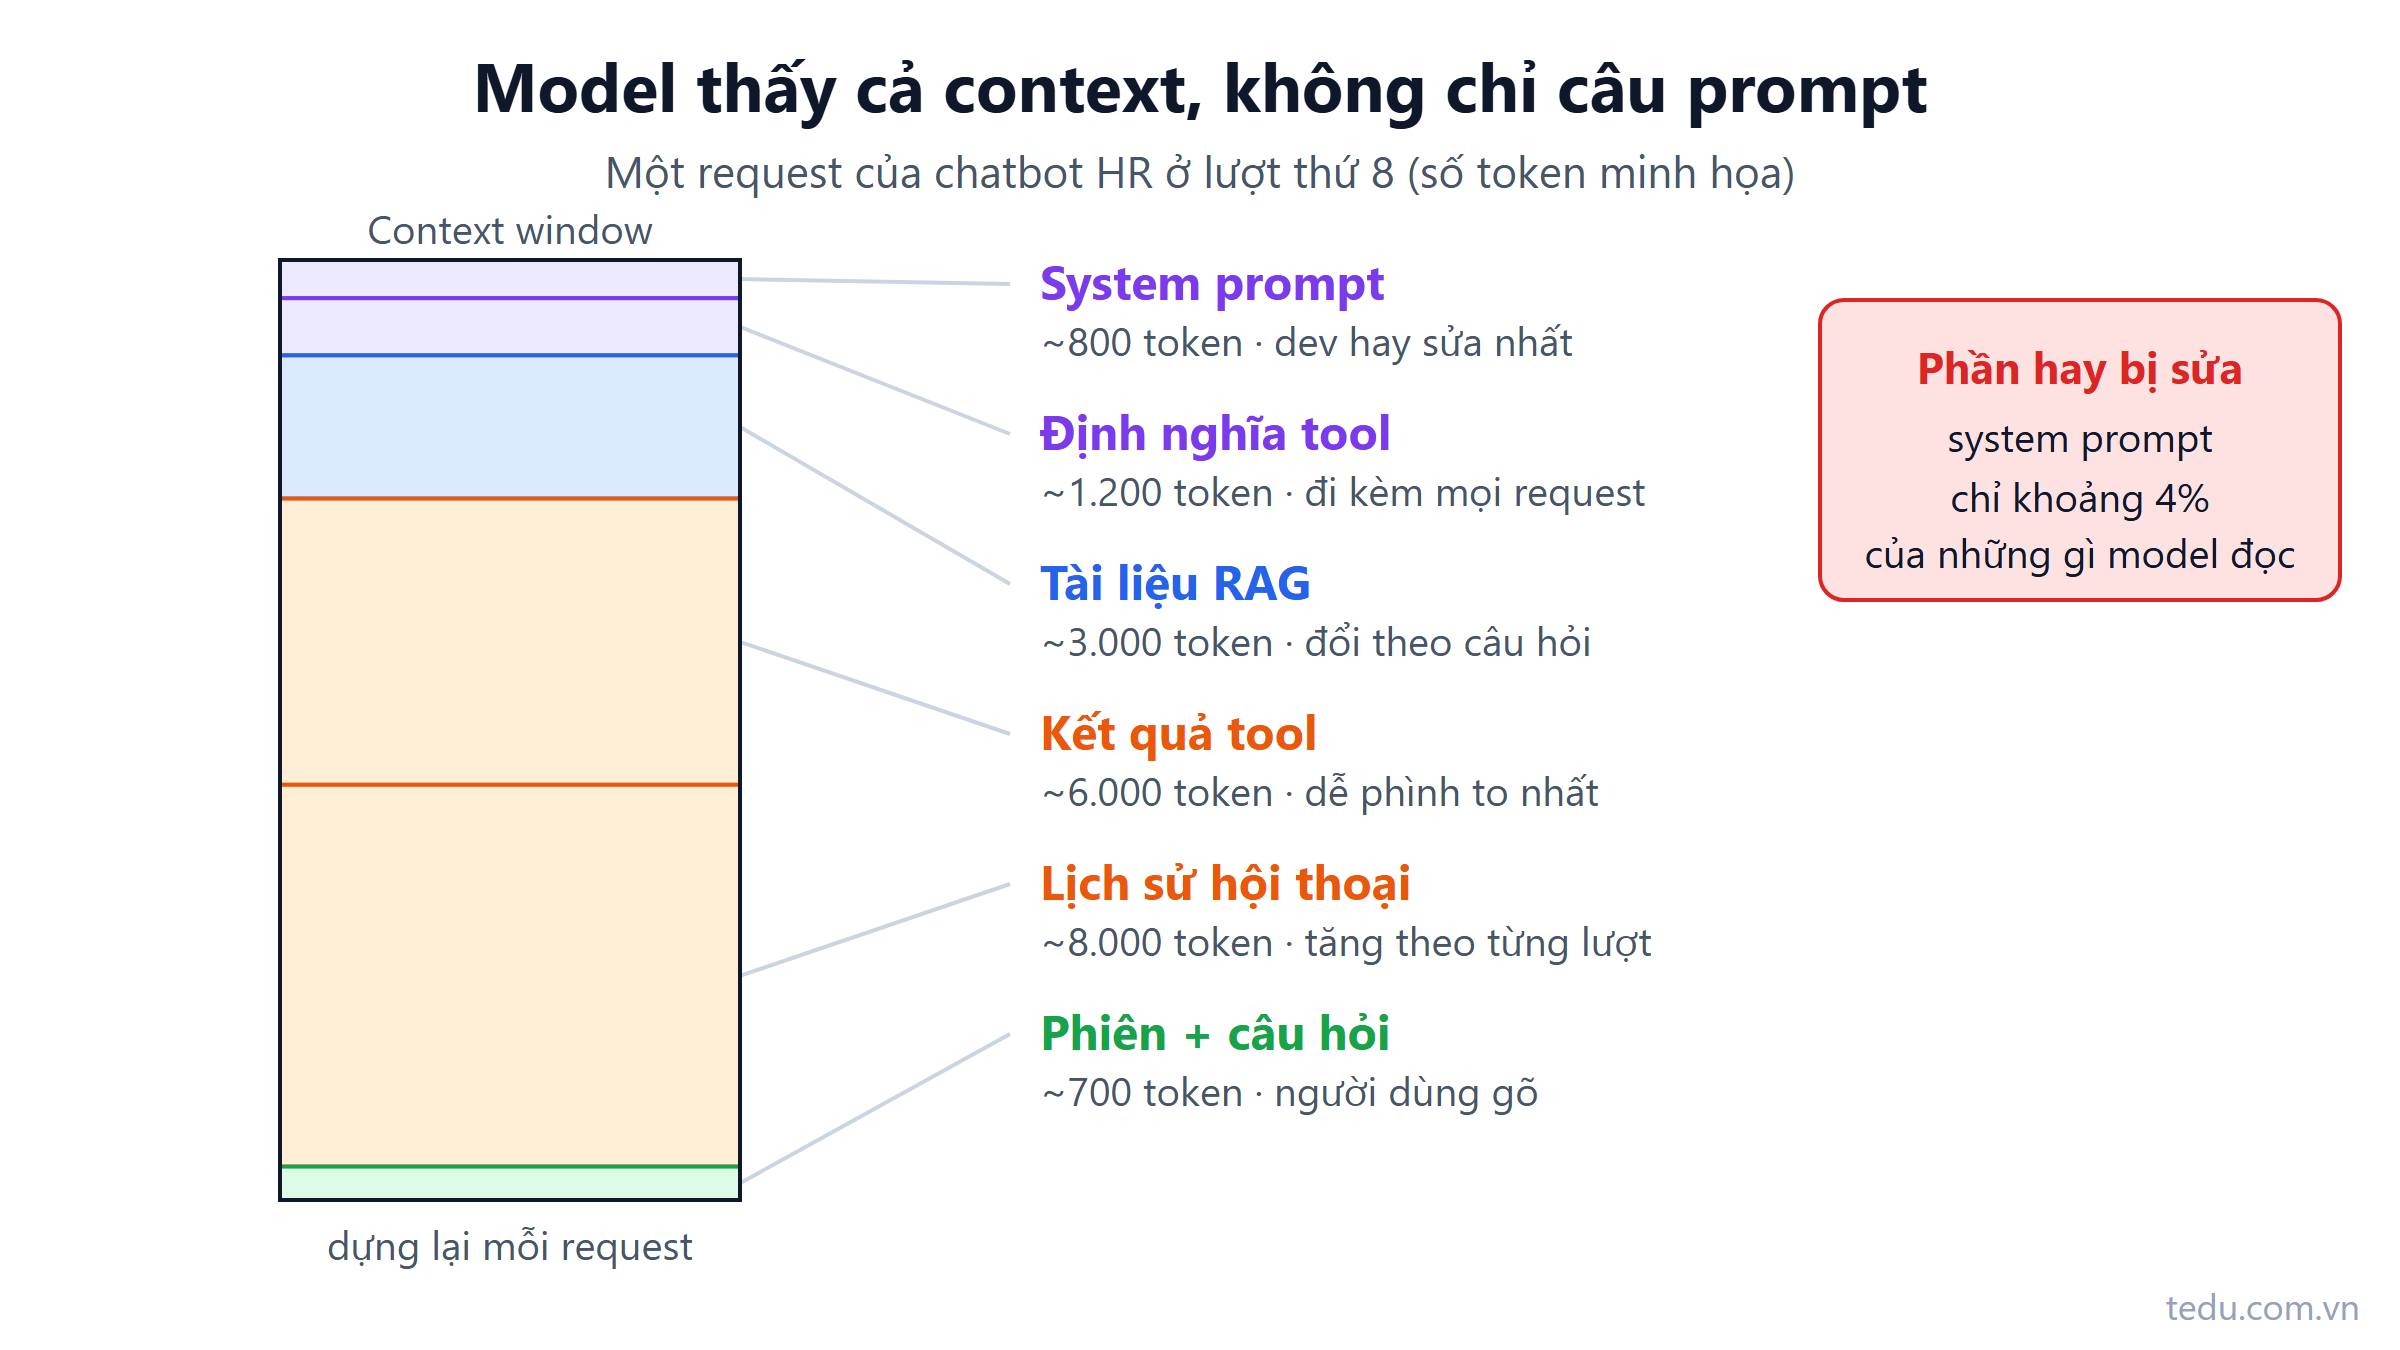
Context engineering là gì, vì sao quan trọng hơn prompt
Context engineering là quyết định cái gì vào context window, cái gì phải ra, theo thứ tự nào. Câu prompt chỉ là một phần nhỏ của những gì model thấy.
Đọc thêm