

Chain-of-thought: cho model suy nghĩ trước khi trả lời
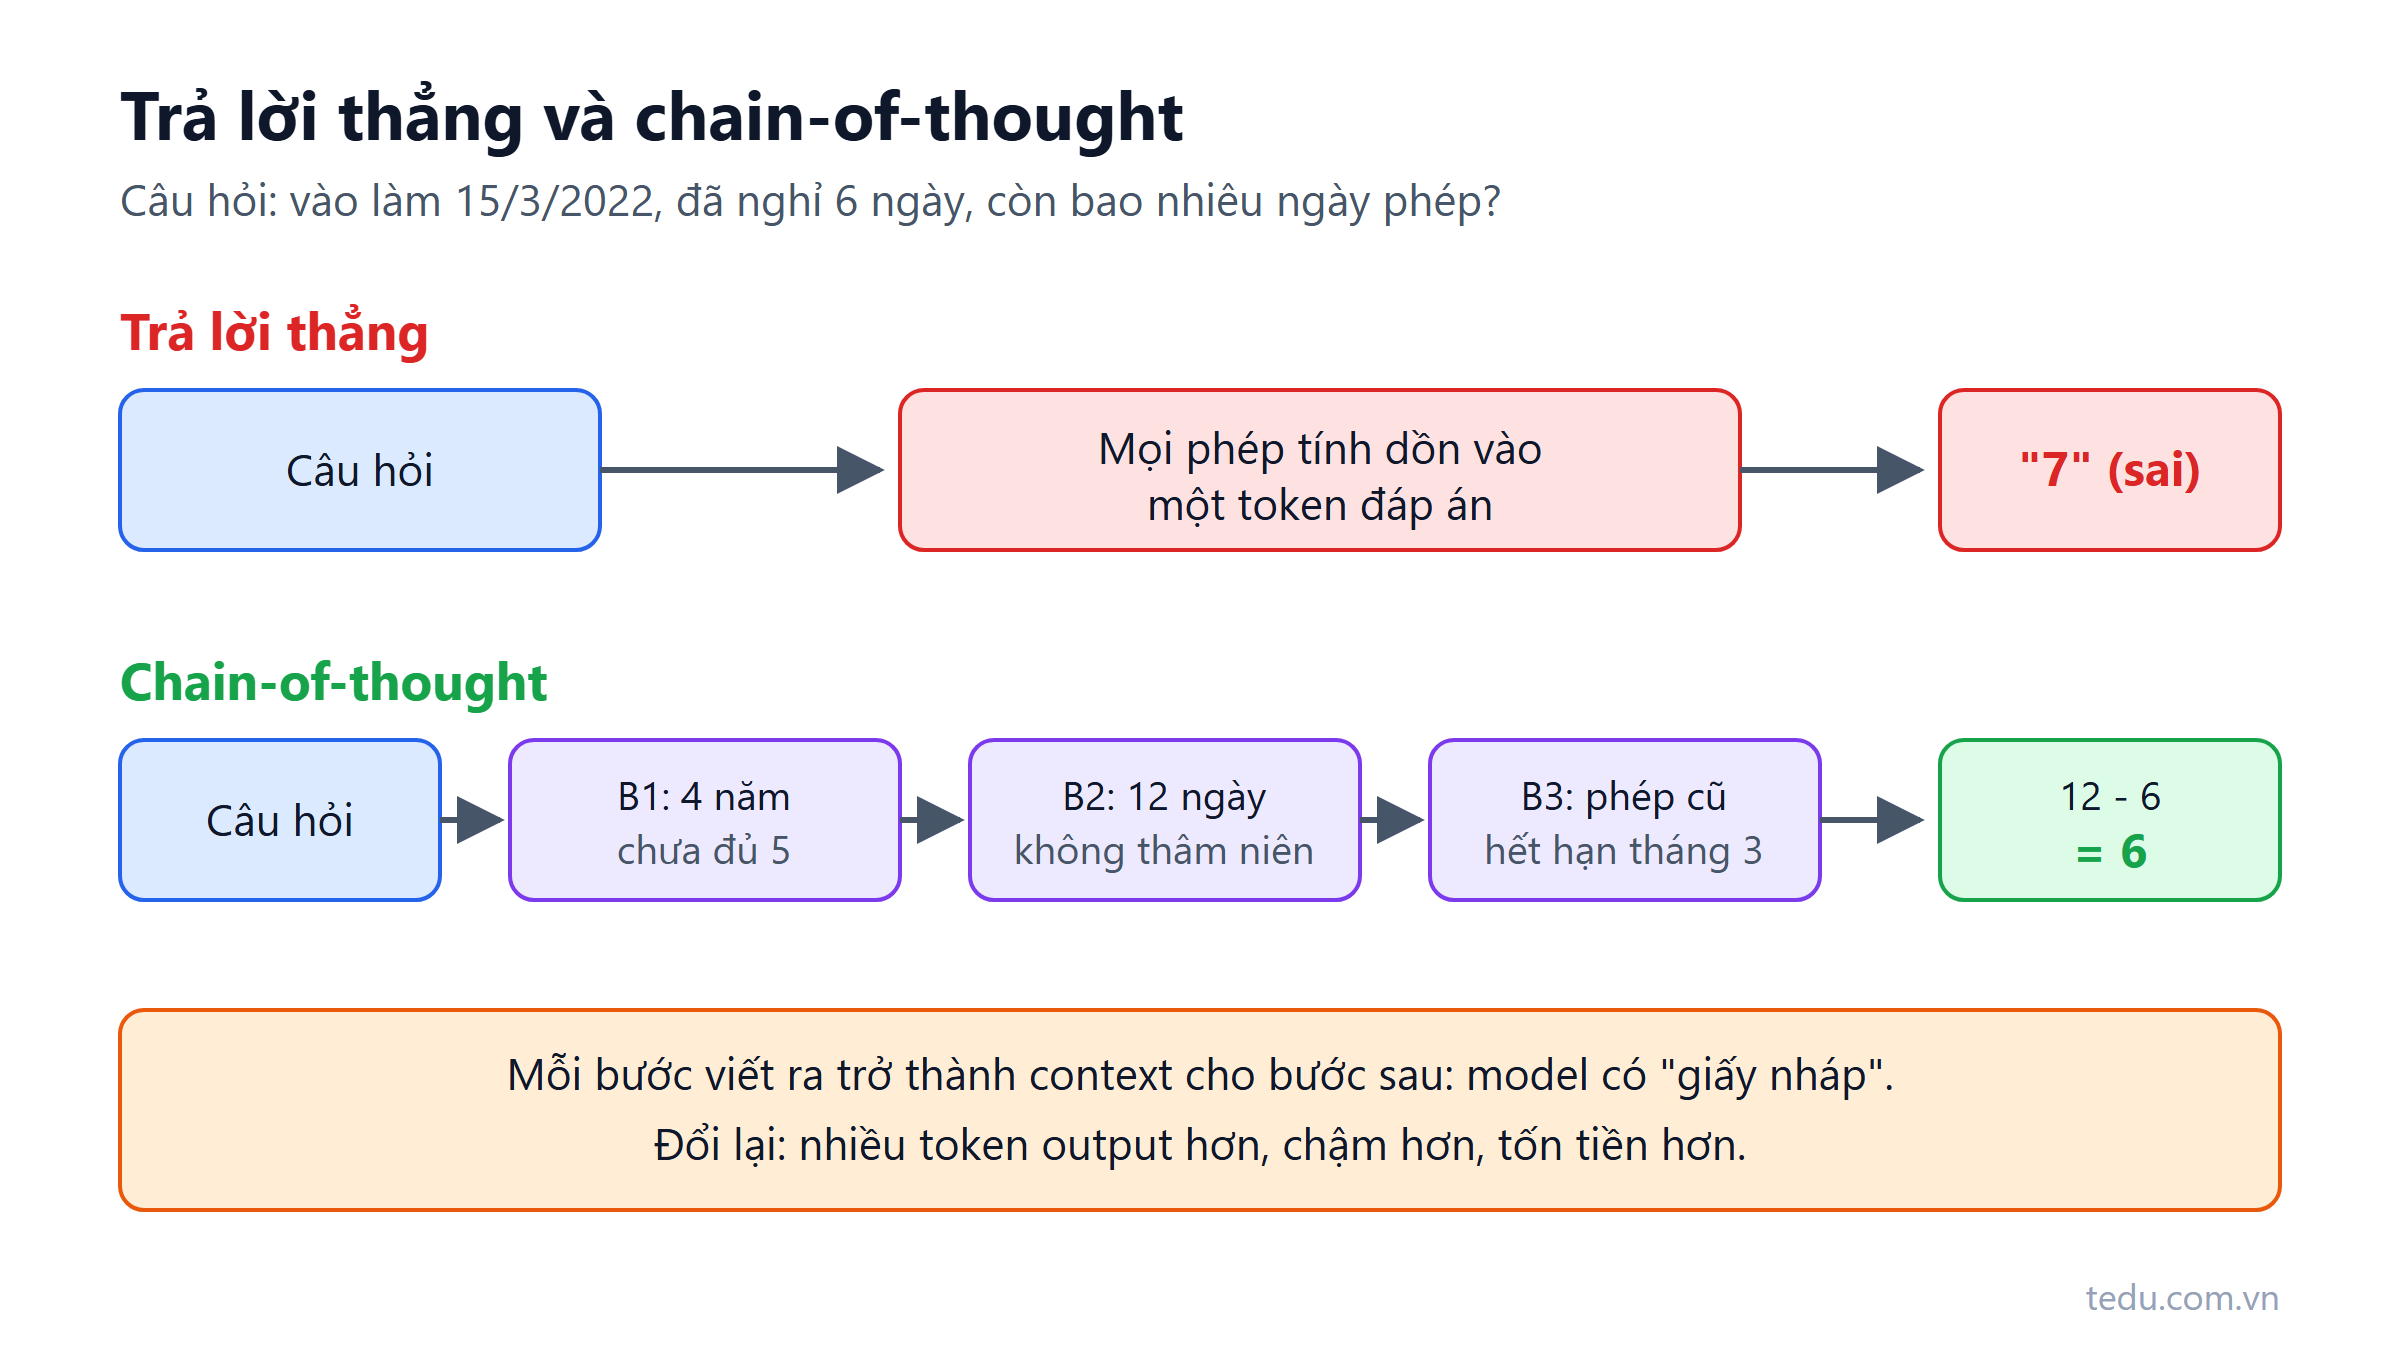
Phòng nhân sự làm một trợ lý AI trả lời câu hỏi về ngày phép. Một nhân viên hỏi: "Em vào công ty ngày 15/3/2022, năm nay đã nghỉ 6 ngày, tháng 12 em còn được nghỉ bao nhiêu ngày phép?". Quy chế có ba điều kiện: 12 ngày phép cơ bản, cứ đủ 5 năm làm việc thì cộng thêm 1 ngày, và phép năm trước chỉ được dùng đến hết tháng 3.
Hỏi thẳng, model trả lời ngay "Bạn còn 7 ngày". Nghe hợp lý, sai. Thêm một câu vào prompt "Hãy suy luận từng bước trước khi trả lời", model viết ra: số năm làm việc, có được cộng thâm niên không, phép năm trước còn hiệu lực không, trừ số ngày đã nghỉ. Lần này đáp án đúng.
Kỹ thuật đó gọi là chain-of-thought (CoT): cho model viết ra các bước suy nghĩ trước khi chốt đáp án. Bài này giải thích vì sao một câu lệnh đơn giản lại có tác dụng, khi nào nó giúp, khi nào nó chỉ làm chậm và tốn tiền, và cách dùng nó đúng trong một ứng dụng thật.
Vì sao "viết ra từng bước" lại giúp model đúng hơn
Để hiểu, cần nhớ lại LLM hoạt động thế nào: model sinh từng token một, mỗi token mới được tính dựa trên toàn bộ token trước đó. Với mỗi token, lượng tính toán model bỏ ra là xấp xỉ cố định.
Hệ quả: khi bạn bắt model trả lời ngay "Bạn còn X ngày", toàn bộ việc tính thâm niên, kiểm tra hạn phép, trừ ngày đã nghỉ phải dồn vào việc chọn đúng một token "7" hay "8". Đó là quá nhiều việc cho một bước.
Khi model viết ra các bước trung gian, mỗi bước trở thành token nằm trong context. Bước sau được tính dựa trên kết quả bước trước đã viết sẵn. Model không cần "nhẩm trong đầu" nữa, nó có giấy nháp.
Ví von gần gũi: bạn có thể nhẩm 17 × 24 trong đầu, nhưng tỷ lệ sai cao hơn hẳn so với khi được đặt bút tính từng hàng. Model cũng vậy, chỉ khác là "đặt bút" với model là sinh thêm token.
Hai hệ quả thực tế cần nhớ:
Thứ tự quan trọng. Suy luận phải đứng trước đáp án. Nếu bạn yêu cầu "trả lời rồi giải thích", đáp án đã được chốt trước khi có lời giải thích, phần giải thích chỉ là biện minh cho đáp án đã có.
Suy luận tốn token output. Thêm 200 token suy luận mỗi lượt nghĩa là thêm tiền và thêm thời gian chờ, mà token output thường đắt hơn token input.
Prompt tệ và prompt tốt
Cùng bài toán ngày phép, ba cách viết:
Cách 1: hỏi thẳng.
Dựa vào quy chế bên dưới, nhân viên còn bao nhiêu ngày phép?
Chỉ trả lời một con số.
Câu "chỉ trả lời một con số" vô tình cấm model suy nghĩ. Với câu hỏi một bước thì không sao, với câu hỏi nhiều điều kiện thì đây là công thức cho sai số.
Cách 2: "suy nghĩ từng bước" chung chung.
Dựa vào quy chế bên dưới, nhân viên còn bao nhiêu ngày phép?
Hãy suy nghĩ từng bước.
Tốt hơn, nhưng đầu ra là một đoạn văn dài lẫn đáp án ở đâu đó trong đó. App của bạn phải đoán con số cuối cùng nằm ở dòng nào.
Cách 3: chỉ rõ các bước và tách đáp án.
Dựa vào quy chế bên dưới, tính số ngày phép còn lại.

Suy luận trong thẻ <reasoning> theo đúng các bước:
1. Tính số năm làm việc đủ tính đến ngày hỏi.
2. Xác định số ngày phép năm nay (cơ bản + thâm niên).
3. Kiểm tra phép năm trước còn được dùng không.
4. Trừ số ngày đã nghỉ.

Sau đó ghi đáp án cuối trong thẻ <answer>, chỉ một con số.
Nếu thiếu dữ kiện, ghi <answer>KHONG_DU_DU_LIEU</answer>.
Cách 3 có ba điểm hơn: các bước bám theo đúng quy chế (model không tự bịa quy trình), đáp án nằm ở vị trí cố định để code đọc được, và có lối thoát khi thiếu dữ kiện thay vì đoán.
| Tiêu chí | Hỏi thẳng | "Suy nghĩ từng bước" | Bước rõ + tách đáp án |
|---|---|---|---|
| Độ đúng với bài nhiều bước | Thấp | Cao hơn | Cao hơn, ổn định hơn |
| Code đọc đáp án | Dễ | Khó, phải đoán | Dễ, đọc thẻ <answer> |
| Kiểm tra được lý do | Không | Có, nhưng lộn xộn | Có, theo từng bước |
| Token output | Ít | Nhiều | Nhiều, nhưng có kiểm soát |
Reasoning model: CoT đã được "đóng gói" sẵn
Nhiều nhà cung cấp hiện có các model hoặc chế độ "reasoning" (còn gọi là thinking): model tự sinh một đoạn suy luận nội bộ trước khi trả lời, không cần bạn viết "hãy suy nghĩ từng bước". Tên tham số để bật chế độ này, cách tính tiền phần suy luận và việc phần suy luận có được trả về cho bạn xem hay không thì khác nhau giữa các nhà cung cấp, nên hãy đọc tài liệu của model bạn dùng.
Với reasoning model, vài điều thay đổi:
Không cần (và thường không nên) viết chi tiết "bước 1, bước 2" kiểu ra lệnh cách nghĩ. Mô tả rõ bài toán, ràng buộc và định dạng đầu ra thường hiệu quả hơn.
Bạn vẫn trả tiền cho token suy luận dù có thể không thấy toàn bộ nội dung. Một câu hỏi đơn giản cũng có thể tốn nhiều token hơn bạn nghĩ.
Độ trễ tăng rõ. Với chatbot cần phản hồi nhanh, đây là đánh đổi lớn.
Một cách làm thực dụng: dùng model thường cho phần lớn câu hỏi đơn giản, chỉ chuyển sang reasoning model (hoặc bật chế độ suy luận) cho loại câu hỏi đã đo được là cần. Đây là dạng đơn giản của model routing.
Khi nào nên và không nên dùng chain-of-thought
Chain-of-thought hữu ích khi câu trả lời phụ thuộc vào nhiều bước hoặc nhiều điều kiện:
Tính toán theo quy chế: ngày phép, công tác phí theo hạng khách sạn và số đêm, phụ cấp theo bậc.
Đối chiếu nhiều điều kiện: đơn hàng có đủ điều kiện đổi trả không (thời gian, tình trạng hàng, loại sản phẩm, đã dùng mã giảm giá chưa).
Phân tích nguyên nhân: đọc log lỗi và đoán bước nào trong luồng thanh toán hỏng.
Lập kế hoạch cho agent trước khi gọi tool.
Không đáng dùng (hoặc lợi ích nhỏ hơn chi phí) khi:
Phân loại đơn giản: ticket này thuộc nhóm "giao hàng" hay "thanh toán".
Trích xuất thông tin có sẵn: lấy số điện thoại, mã đơn từ email.
Viết lại, dịch, tóm tắt ngắn.
Tác vụ cần phản hồi tức thì và đã đạt độ chính xác mong muốn khi không có CoT.
Một nguyên tắc quan trọng hơn cả: phép tính chính xác nên để code làm. Model có thể suy luận đúng rằng "cần lấy 12 cộng 1 trừ 6", nhưng phép tính ngày giữa hai mốc thời gian, cộng tiền có VAT, quy đổi tỷ giá thì C# làm đúng 100%. Cách kết hợp tốt: model suy luận cần tính gì, rồi gọi tool để code tính.
Dùng chain-of-thought trong production
Tách suy luận khỏi đáp án
Người dùng cuối thường chỉ cần đáp án và một câu giải thích ngắn, không cần đọc cả trang nháp. Hãy tách hai phần và chỉ hiển thị phần cần thiết. Ví dụ đọc thẻ <answer> bằng C#:
using System.Text.RegularExpressions;

public static class CotParser
{
    private static readonly Regex AnswerRegex =
        new(@"<answer>\s*(.*?)\s*</answer>", RegexOptions.Singleline);

    public static (string? Answer, string Raw) Parse(string modelOutput)
    {
        var match = AnswerRegex.Match(modelOutput);
        return (match.Success ? match.Groups[1].Value : null, modelOutput);
    }
}

// Sử dụng
var (answer, raw) = CotParser.Parse(output);
if (answer is null || answer == "KHONG_DU_DU_LIEU")
{
    logger.LogWarning("Không đọc được đáp án. Output: {Raw}", raw);
    return "Mình chưa đủ thông tin để tính, bạn liên hệ phòng nhân sự giúp mình nhé.";
}
Nếu dùng structured output, bạn có thể làm tương tự với JSON: đặt trường reasoning trước trường answer trong schema để model viết suy luận trước. Tên tính năng và cách khai báo schema khác nhau giữa các nhà cung cấp.
Log suy luận, đừng tin tuyệt đối vào nó
Phần suy luận rất có giá trị khi debug: nhìn vào là biết model hiểu sai điều khoản nào. Hãy log nó (cùng với prompt version) để tra cứu khi có khiếu nại.
Nhưng nhớ một điểm: đoạn suy luận model viết ra không đảm bảo là lý do thật khiến model ra đáp án. Có trường hợp suy luận hợp lý mà đáp án vẫn sai, hoặc đáp án đúng mà suy luận lủng củng. Dùng nó làm manh mối, không dùng làm bằng chứng.
Đo trước khi bật cho tất cả
Thêm CoT làm tăng token output và độ trễ. Trước khi bật cho toàn bộ tính năng, chạy bộ câu hỏi thật (vài chục câu có đáp án đúng) ở hai cấu hình có và không có CoT, so sánh độ đúng, token và thời gian. Nếu độ đúng không tăng đáng kể với loại câu hỏi đó, bỏ CoT đi là tiết kiệm thật.
Lỗi hay gặp và checklist áp dụng
Lỗi hay gặp:
Đáp án trước, suy luận sau. Thứ tự ngược làm CoT mất tác dụng.
Hiển thị toàn bộ nháp cho người dùng. Khách hỏi đổi size mà nhận về nửa trang "Bước 1: xác định loại sản phẩm..." thì trải nghiệm rất tệ.
Cấm model suy nghĩ mà không biết. Câu "chỉ trả lời một con số" hoặc giới hạn output quá ngắn chặn luôn chỗ cho suy luận.
Để model tự tính số học phức tạp. Suy luận thì tốt, phép tính thì nên giao cho code.
Bật reasoning cho mọi request. Hóa đơn tăng, phản hồi chậm, trong khi phần lớn câu hỏi không cần.
Checklist:
Câu hỏi có cần nhiều bước hoặc nhiều điều kiện không? Nếu không, bỏ CoT.
Các bước suy luận có bám theo quy trình nghiệp vụ thật (quy chế, chính sách) không?
Suy luận có đứng trước đáp án, và đáp án có nằm ở vị trí code đọc được không?
Có lối thoát khi thiếu dữ kiện thay vì đoán?
Phép tính chính xác đã được giao cho code hoặc tool chưa?
Đã đo độ đúng, token và độ trễ trên bộ câu hỏi thật ở cả hai cấu hình?
Kết luận
Chain-of-thought hiệu quả vì nó cho model "giấy nháp": mỗi bước suy luận viết ra trở thành context cho bước sau, thay vì dồn mọi thứ vào một token đáp án. Nó đáng dùng cho bài toán nhiều bước, nhiều điều kiện; không đáng dùng cho phân loại hay trích xuất đơn giản. Trong production, hãy đặt suy luận trước đáp án, tách đáp án ra vị trí cố định, giao phép tính cho code, và đo trước khi bật cho toàn bộ.
Bước tiếp theo: chọn một loại câu hỏi nhiều bước trong hệ thống của bạn (tính phí, kiểm tra điều kiện), viết prompt theo cách 3 ở trên và so sánh với cách hỏi thẳng trên 20 câu thật. Khi prompt bắt đầu có nhiều phiên bản như vậy, bạn sẽ cần quản lý prompt như code, chủ đề của bài kế tiếp.
Xem bản tóm tắt dưới một phút trên YouTube @teduco hoặc TikTok @teducolabs, và đọc thêm các bài khác trong chuyên mục AI cho Backend Developer.
Bài viết liên quan
5 lý do RAG trả lời sai và cách tìm đúng chỗ hỏng
RAG trả lời sai hiếm khi do model kém. Bài chỉ ra 5 chỗ hỏng thường gặp từ dữ liệu, chunking, tìm kiếm đến prompt, kèm cách khoanh vùng lỗi bằng log.
Đọc thêm
Reranking trong RAG: bước bị bỏ qua nhiều nhất
Reranking chấm lại vài chục đoạn tìm được để chọn ra vài đoạn thật sự trả lời câu hỏi. Bài giải thích cơ chế, cách gắn vào pipeline C# và lỗi hay gặp.
Đọc thêm
Hybrid search trong RAG: kết hợp keyword và vector
Vector search giỏi hiểu nghĩa nhưng hay trượt mã đơn hàng, số hiệu văn bản. Hybrid search kết hợp keyword và vector bằng RRF, có ví dụ SQL PostgreSQL và C#.
Đọc thêm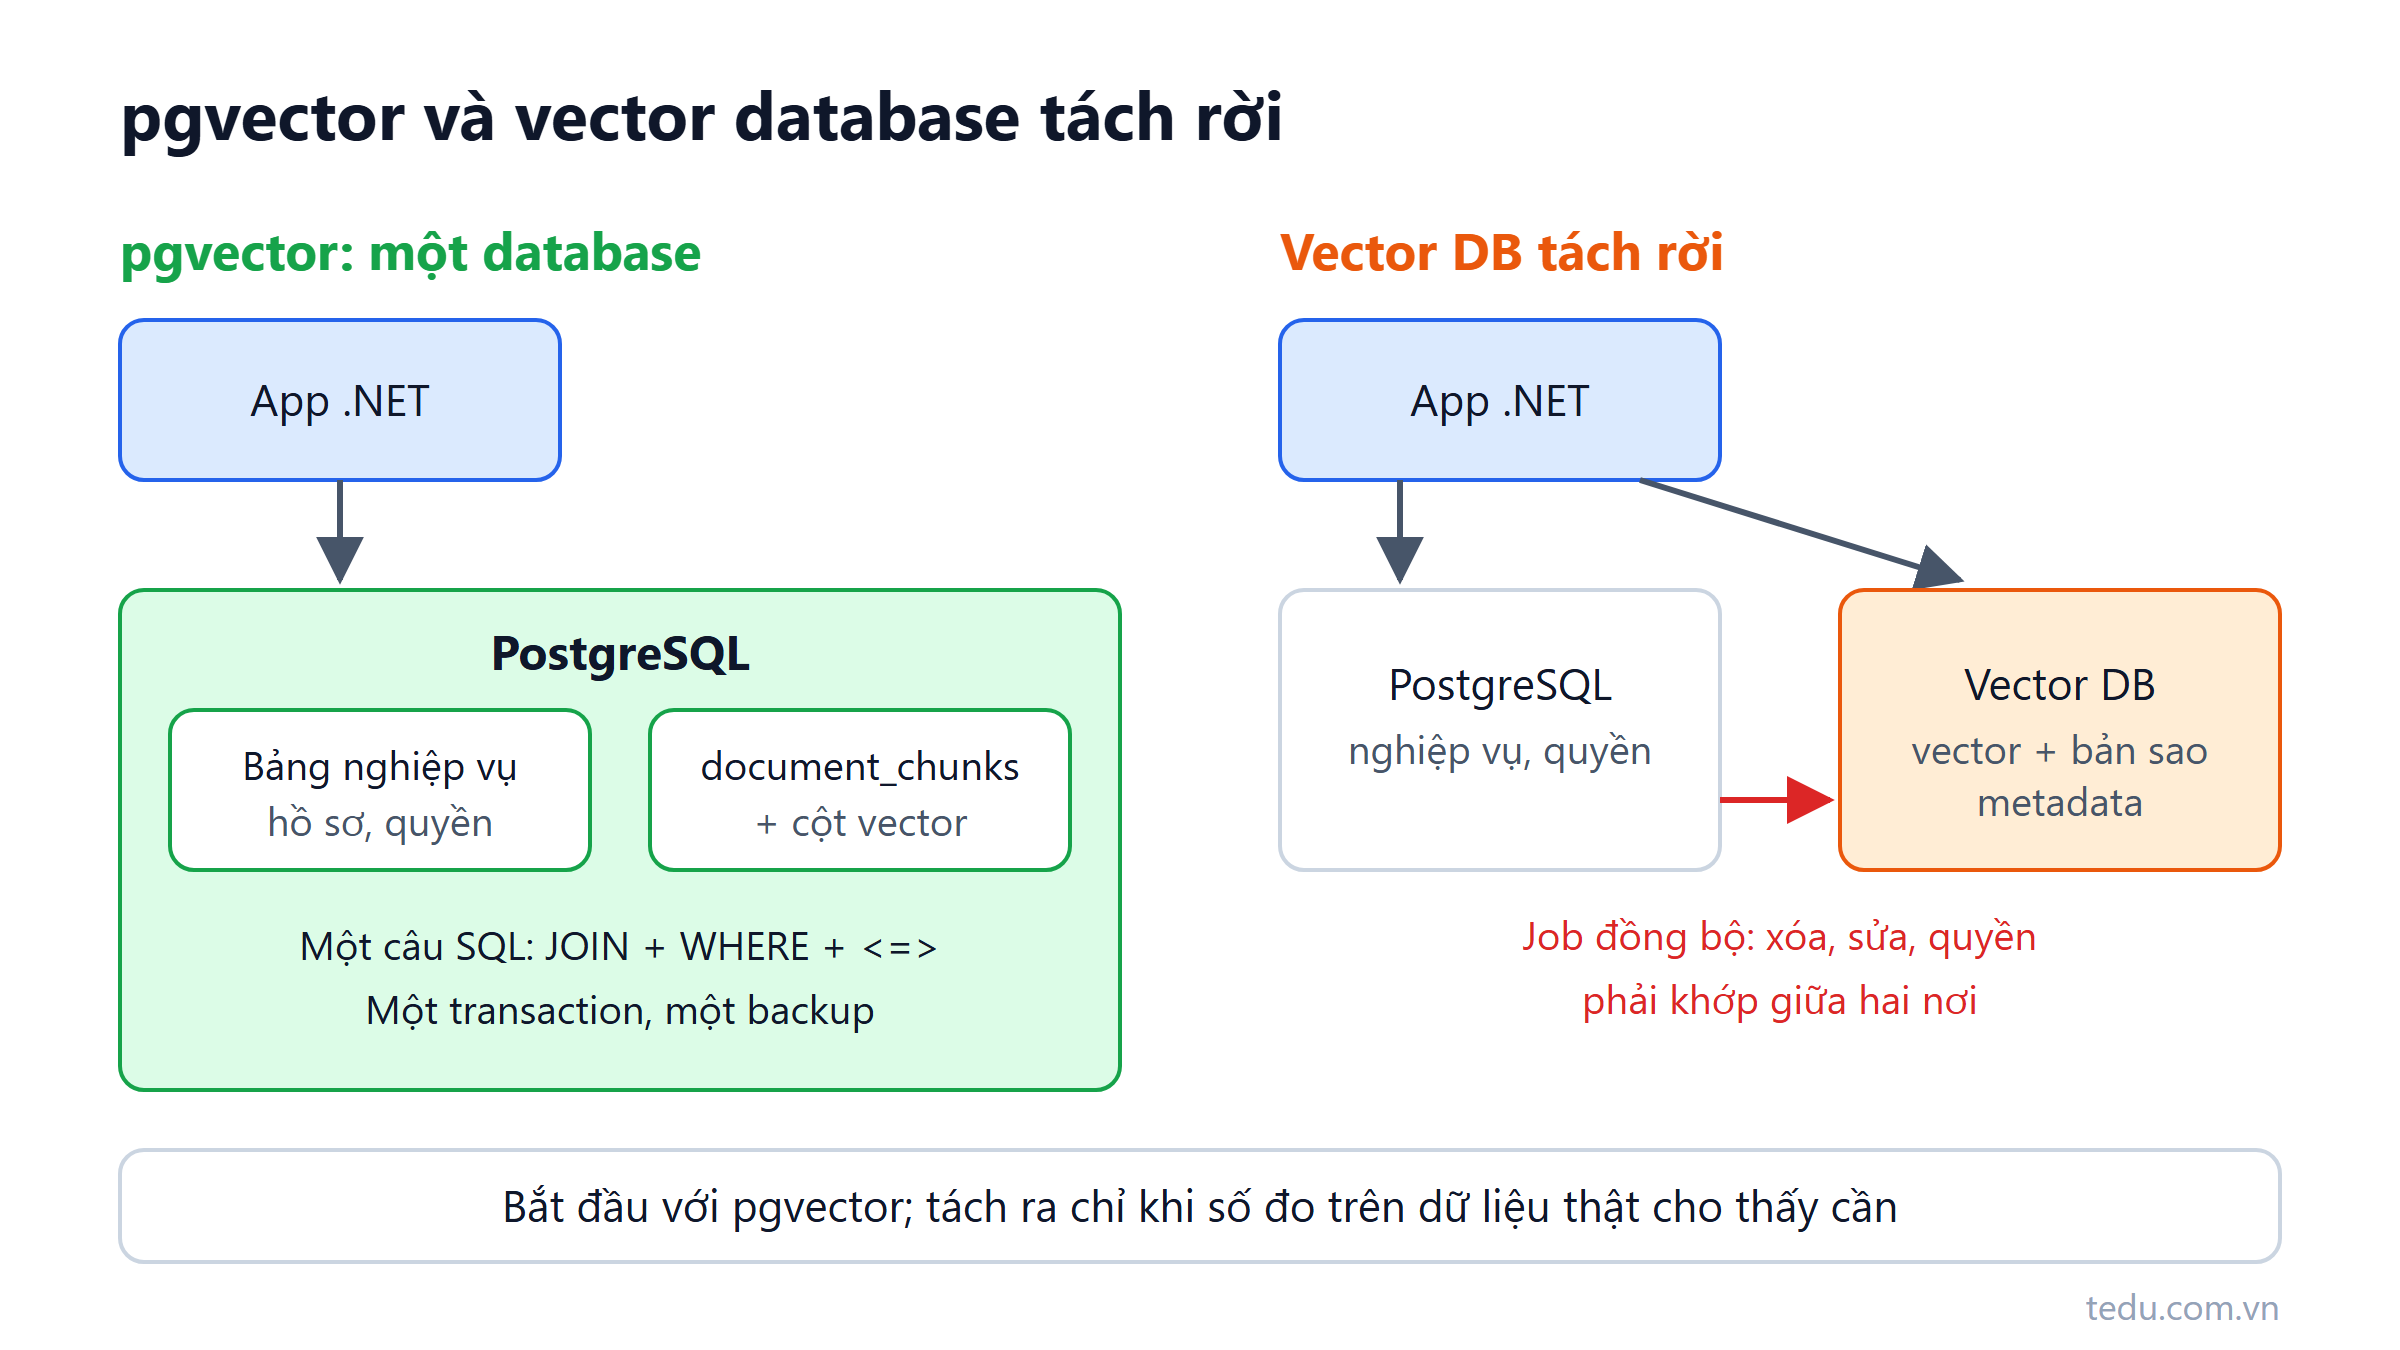
pgvector: vì sao PostgreSQL thường đủ làm vector DB
pgvector biến PostgreSQL thành vector database cho RAG. Hướng dẫn SQL, C#, so sánh với vector DB chuyên dụng và khi nào pgvector không đủ.
Đọc thêm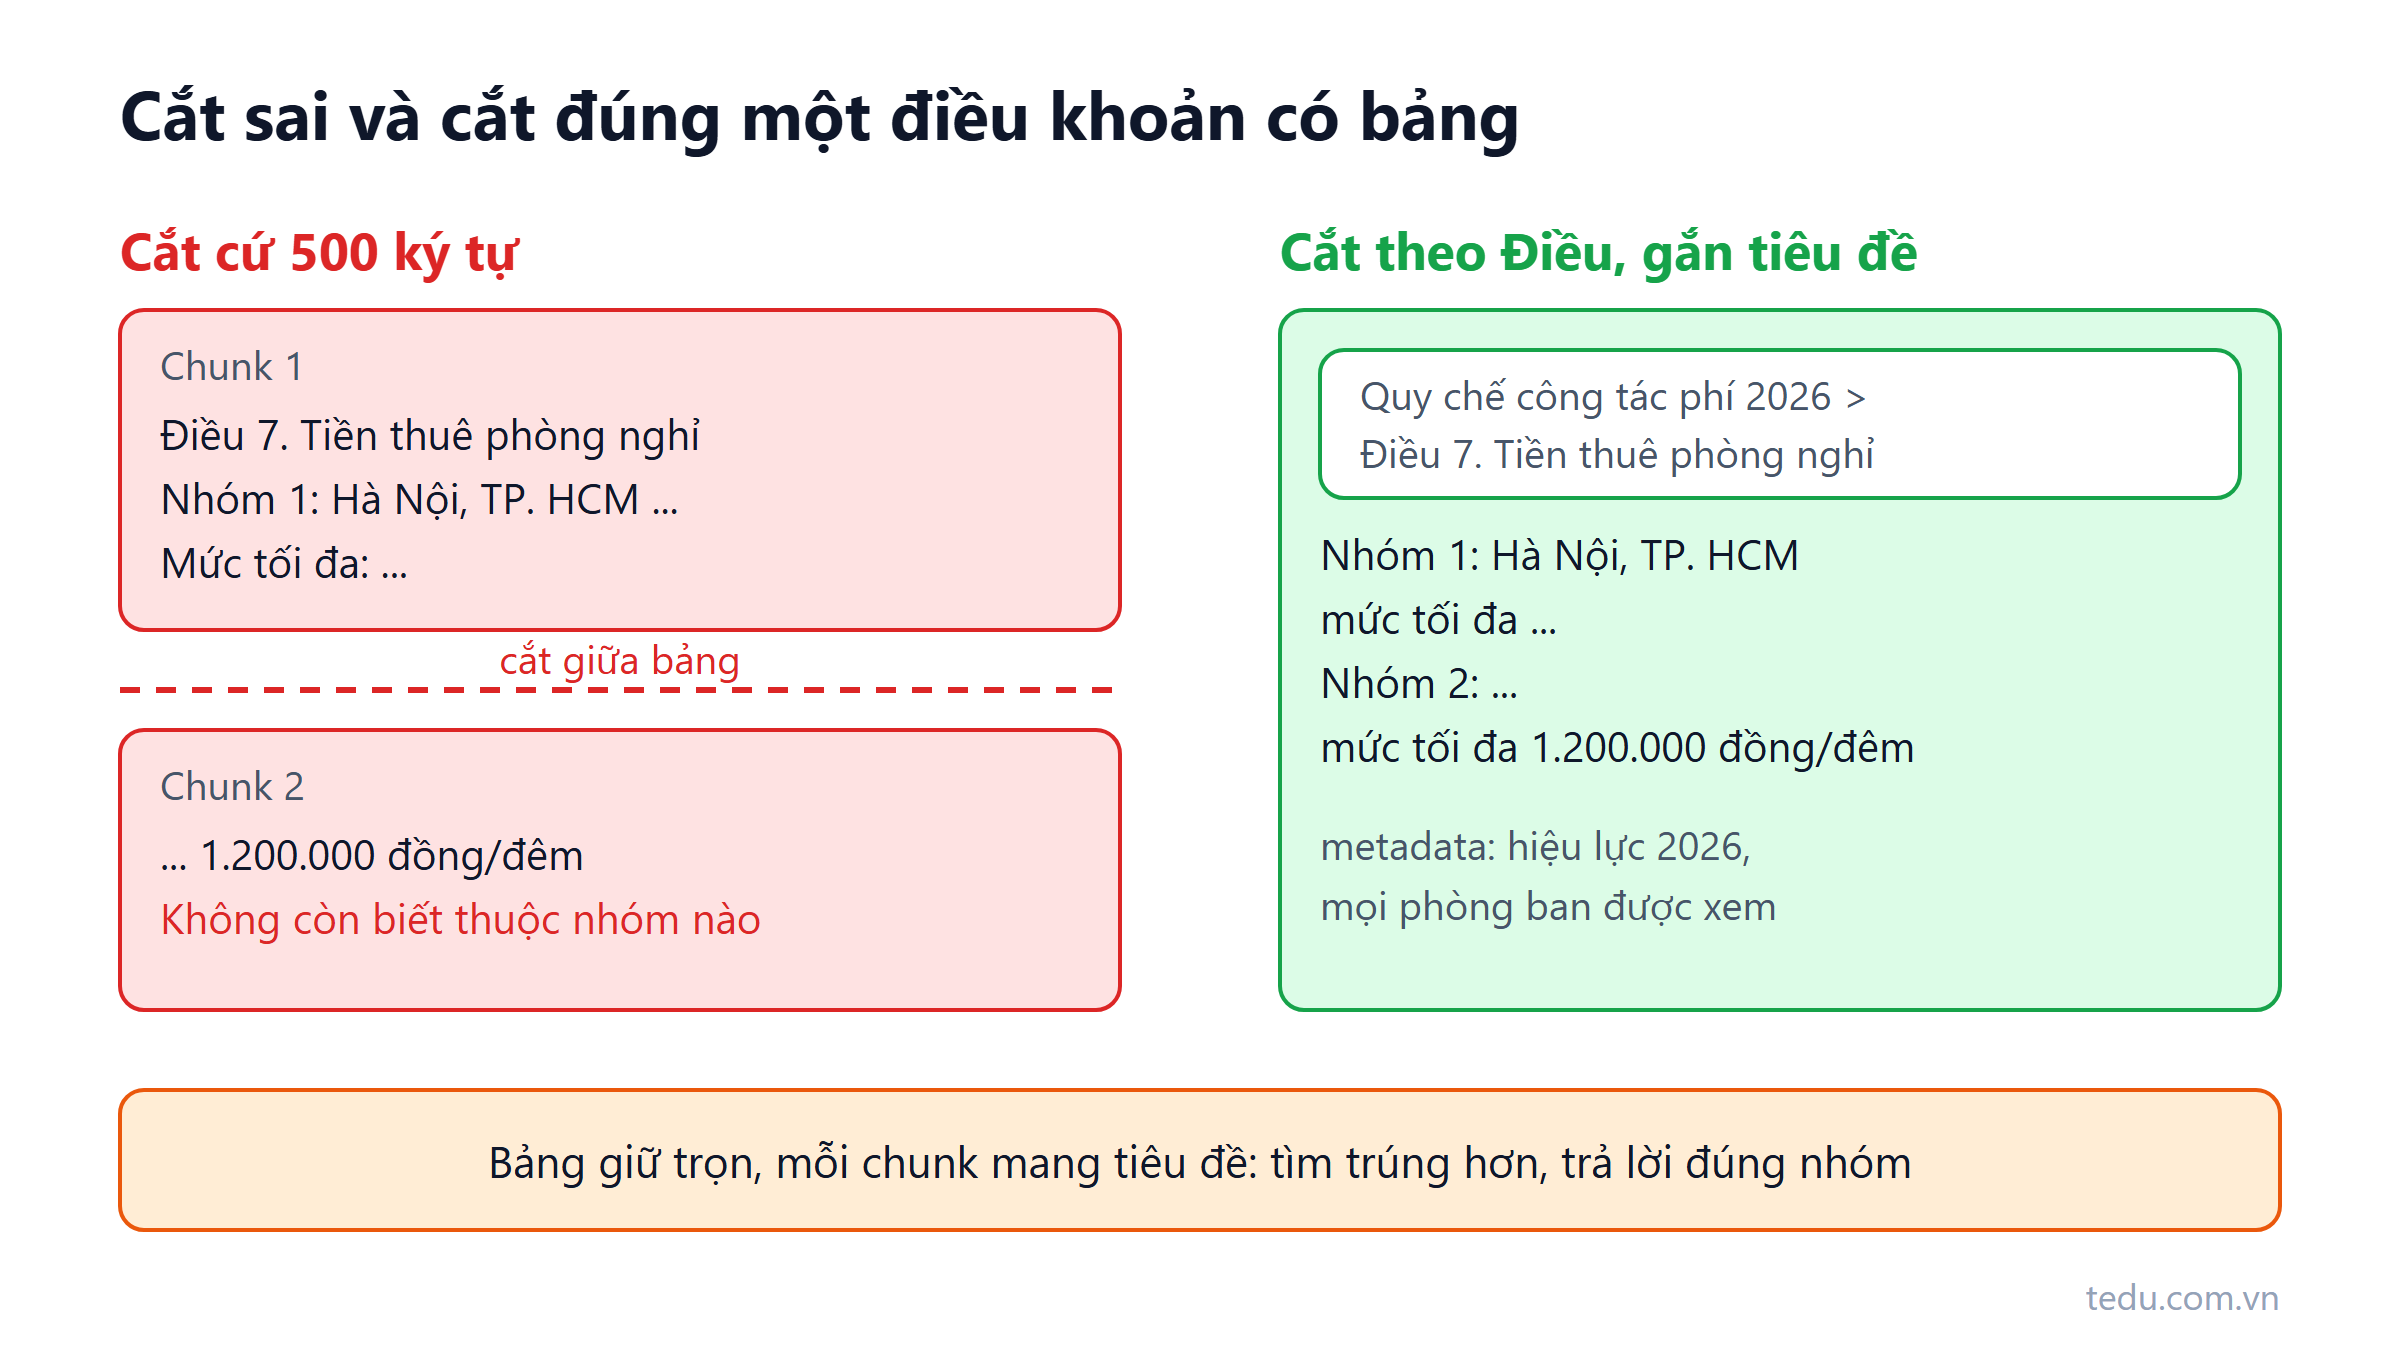
Chunking trong RAG: cắt tài liệu sai thì kết quả hỏng
Chunking là bước cắt tài liệu thành đoạn nhỏ trước khi đưa vào RAG. Bài so sánh các cách chunking, ví dụ với quy chế tiếng Việt và code C# cắt theo Điều, Khoản.
Đọc thêm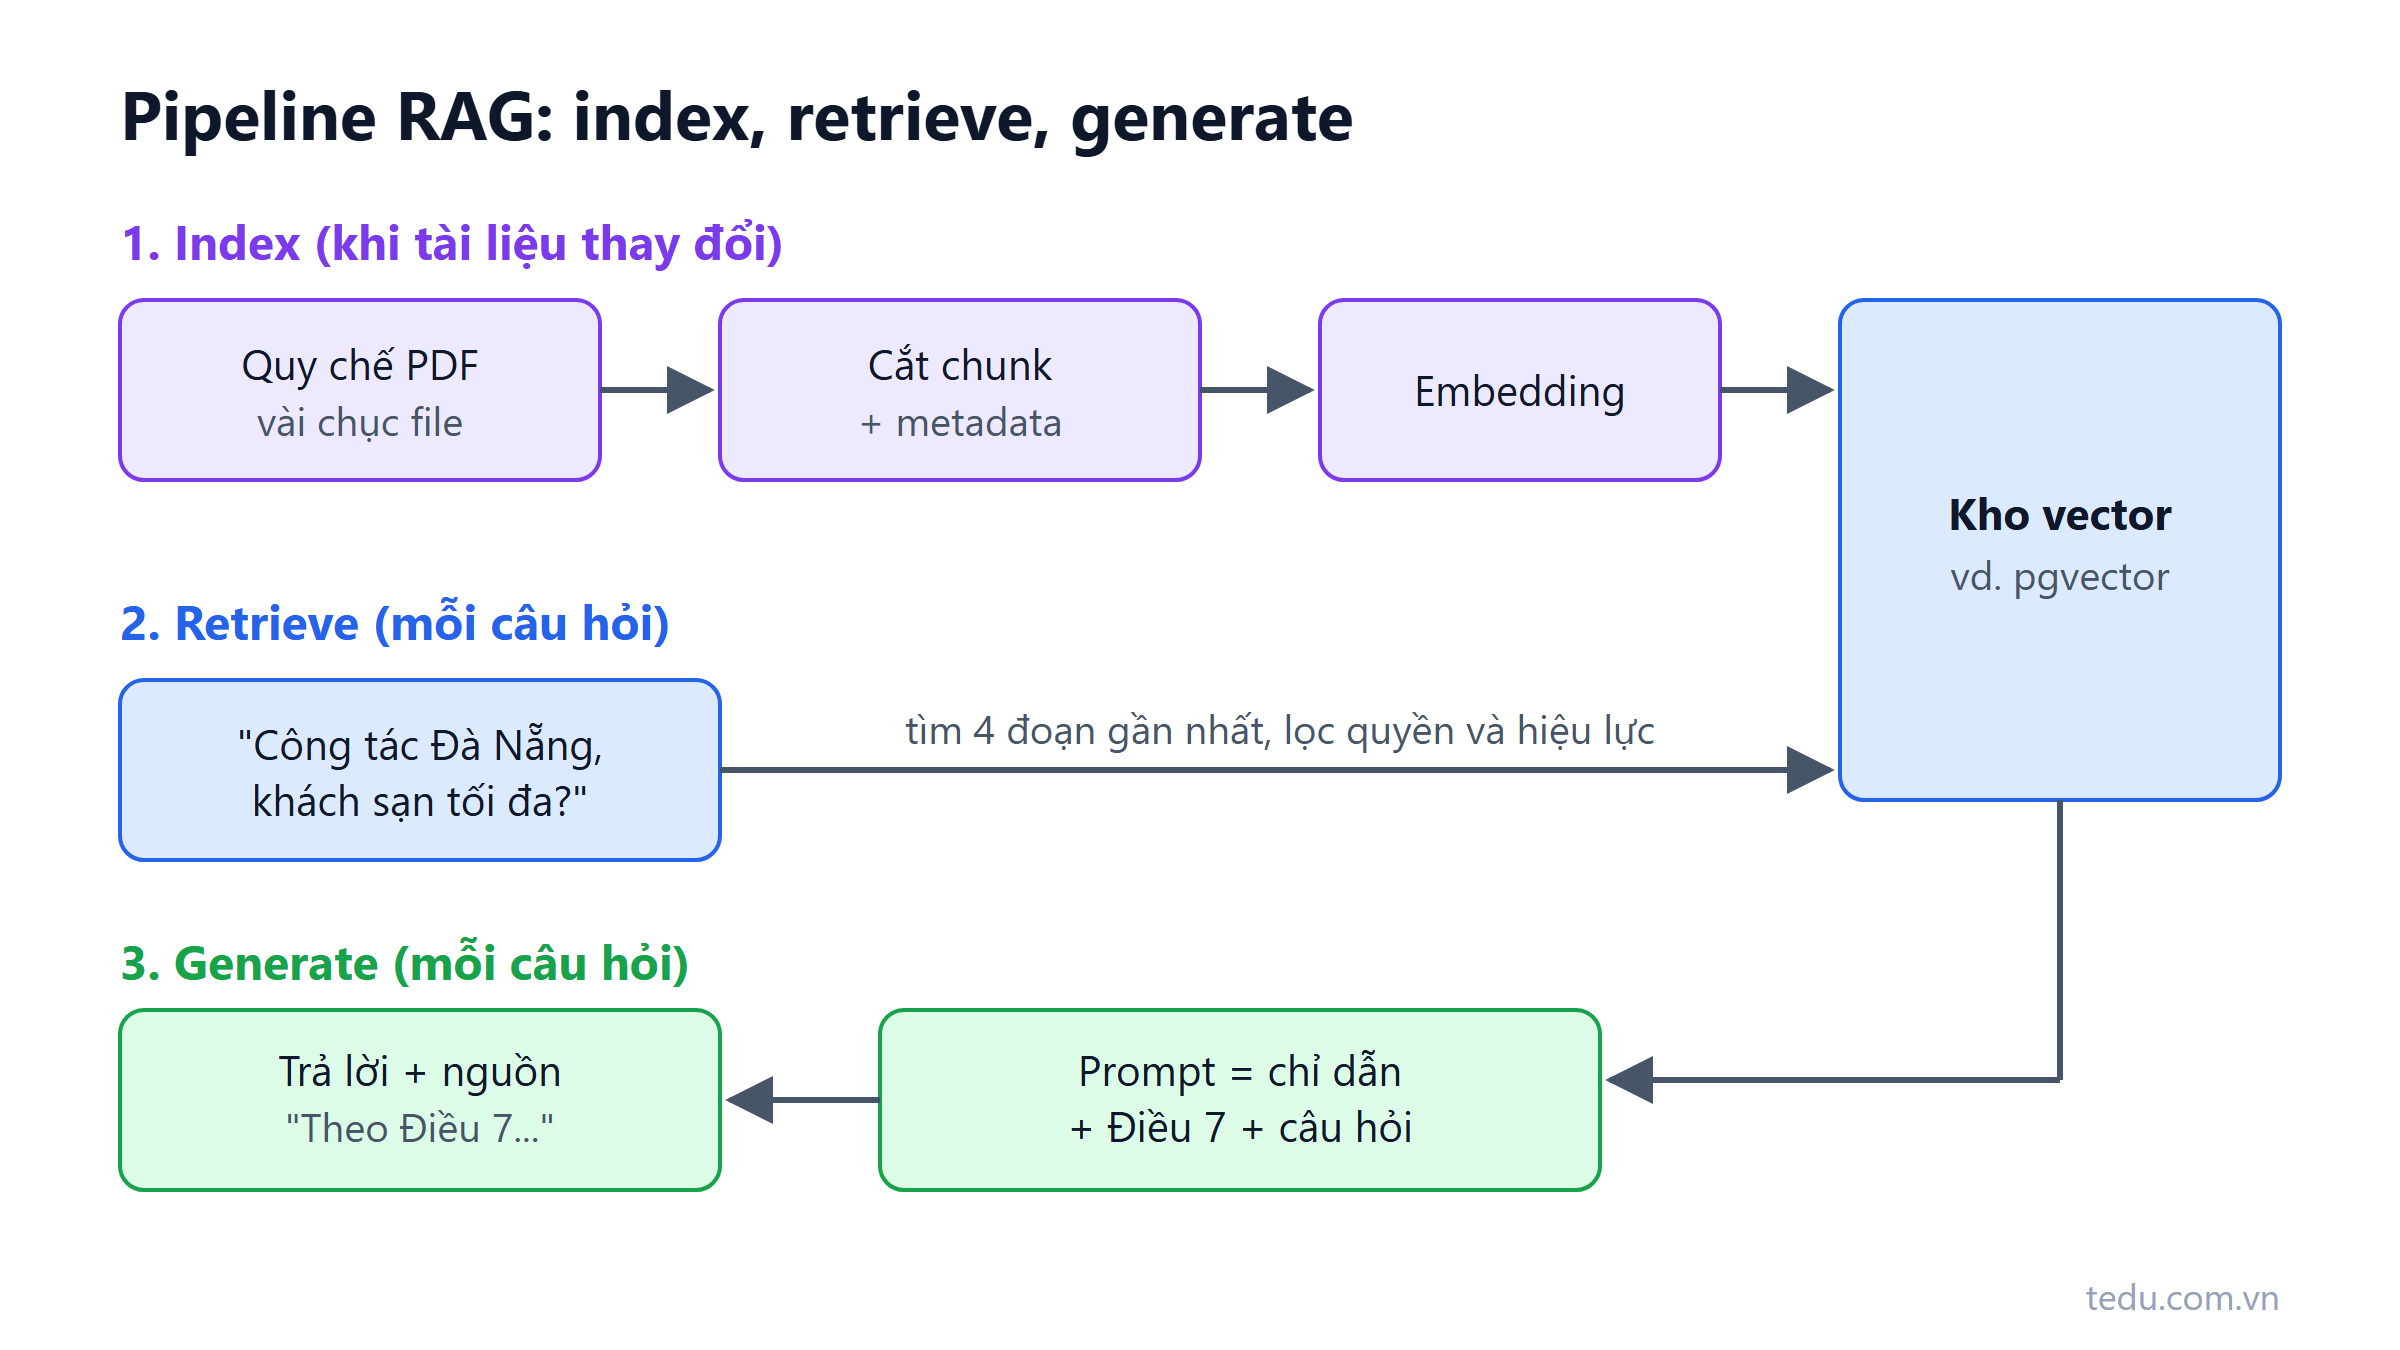
RAG là gì? Khi nào cần và khi nào không cần
RAG là cách đưa đúng đoạn tài liệu vào prompt để model trả lời theo dữ liệu thật. Bài này giải thích pipeline và khi nào bạn không cần RAG.
Đọc thêm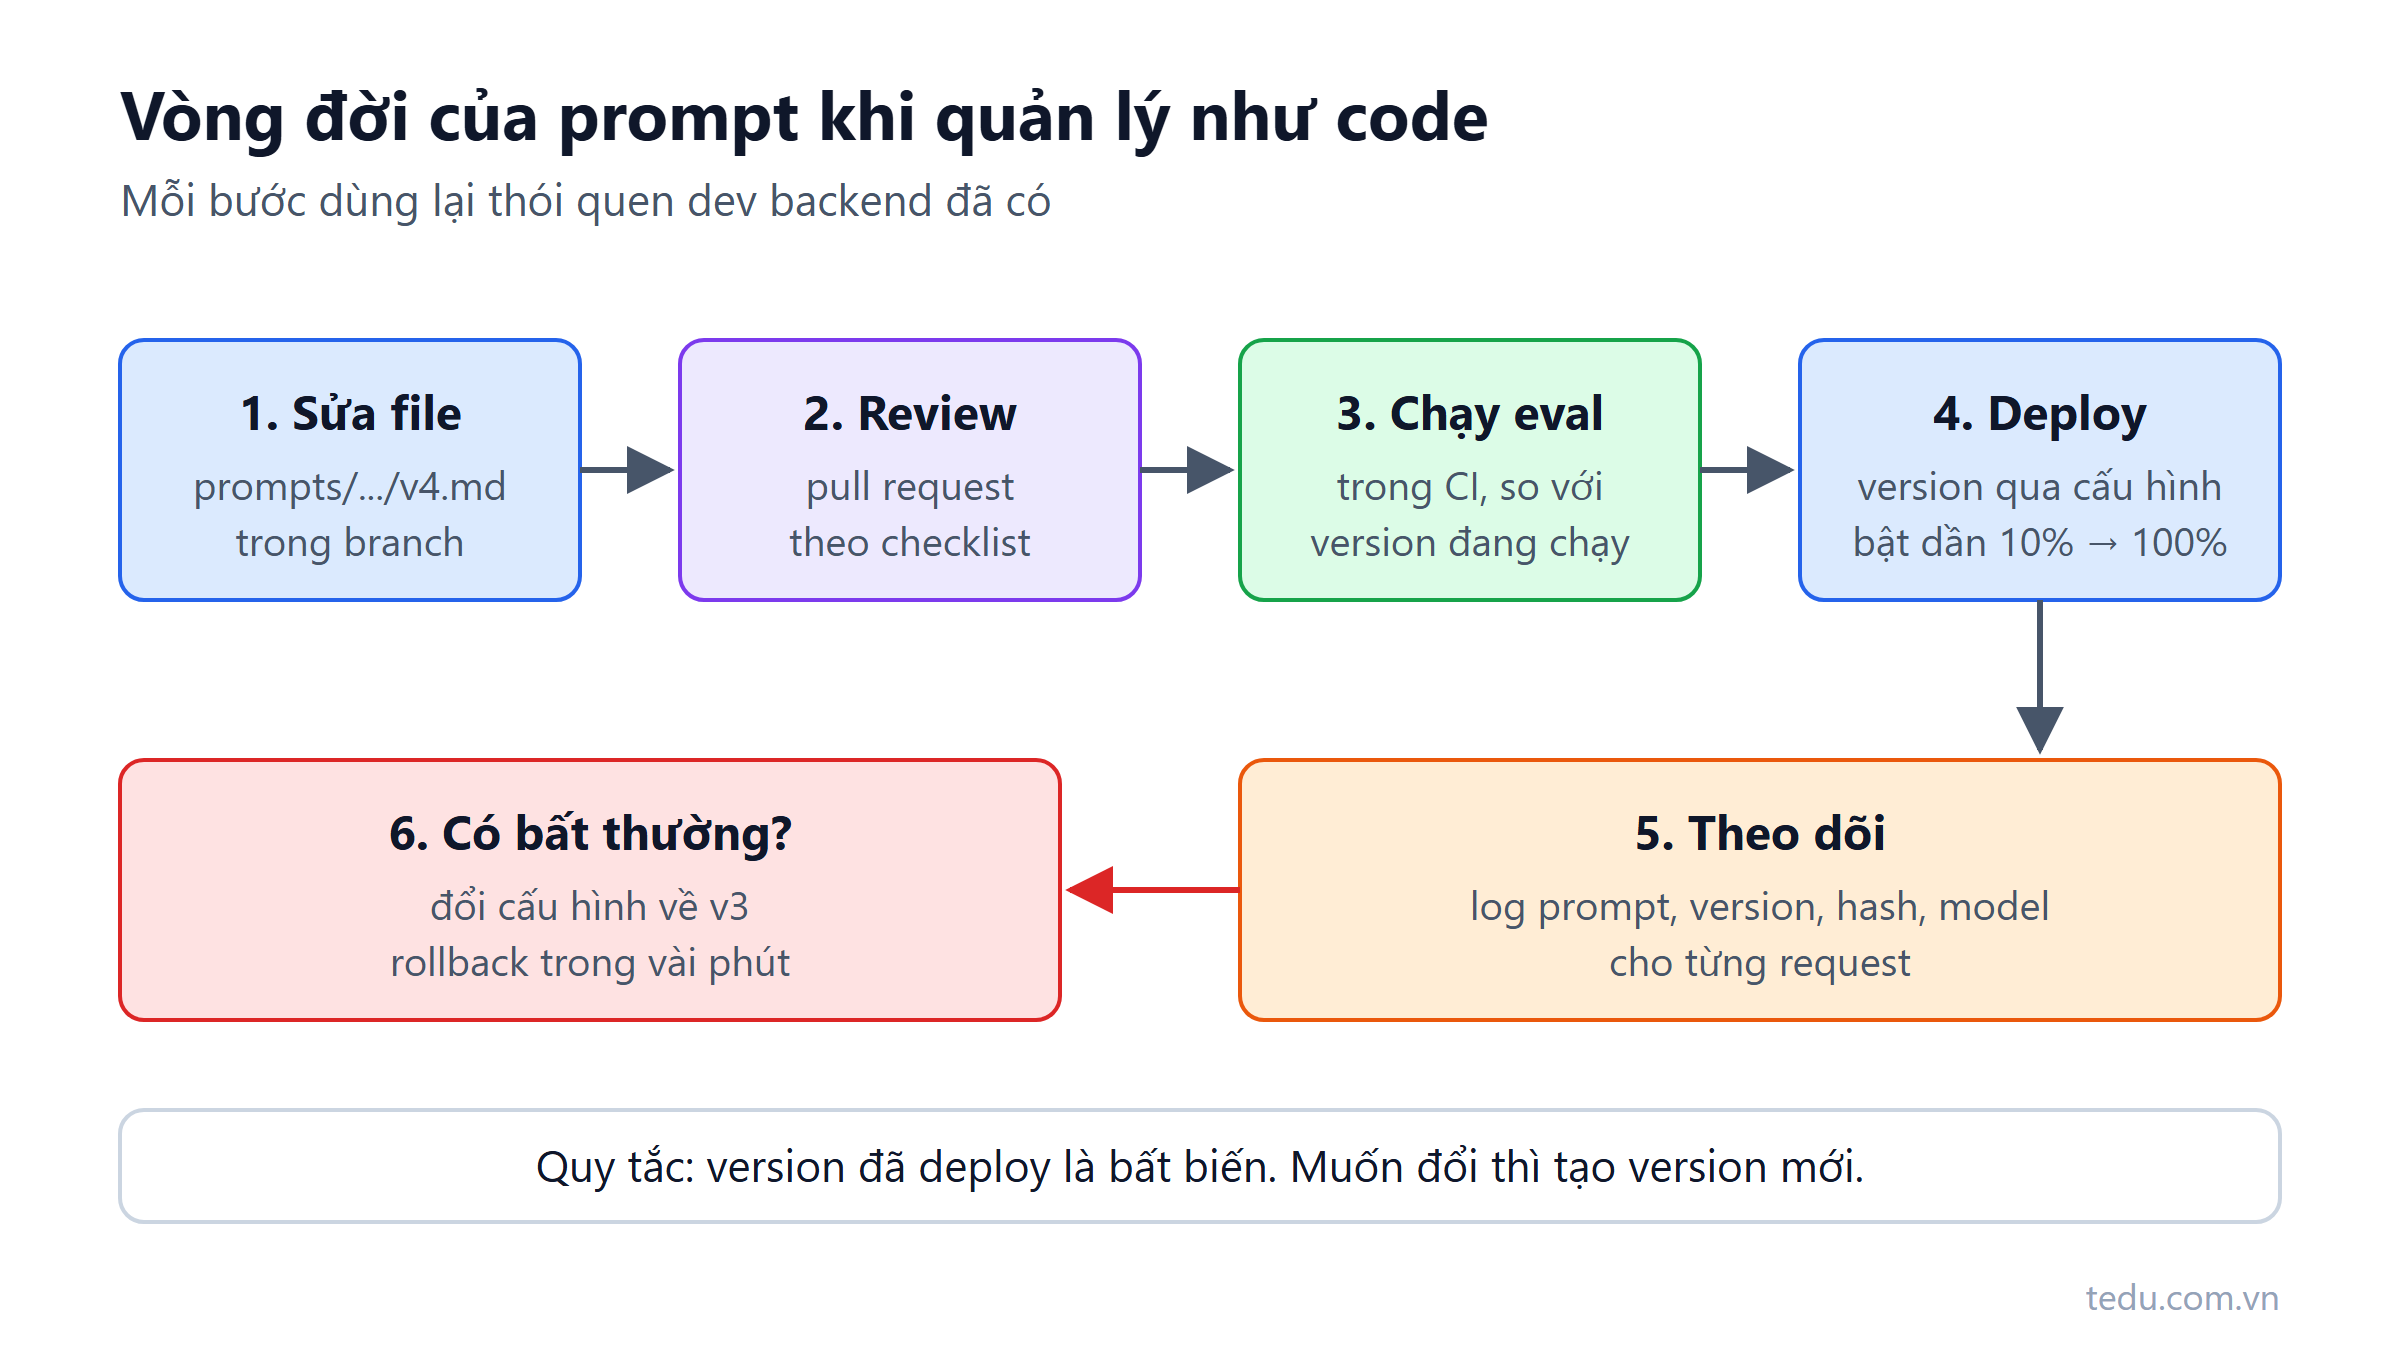
Quản lý prompt như code: versioning, review và test
Prompt là logic nghiệp vụ, sửa một câu có thể đổi hành vi cả hệ thống. Bài hướng dẫn quản lý prompt như code: lưu trong repo, versioning, review, test và rollback.
Đọc thêm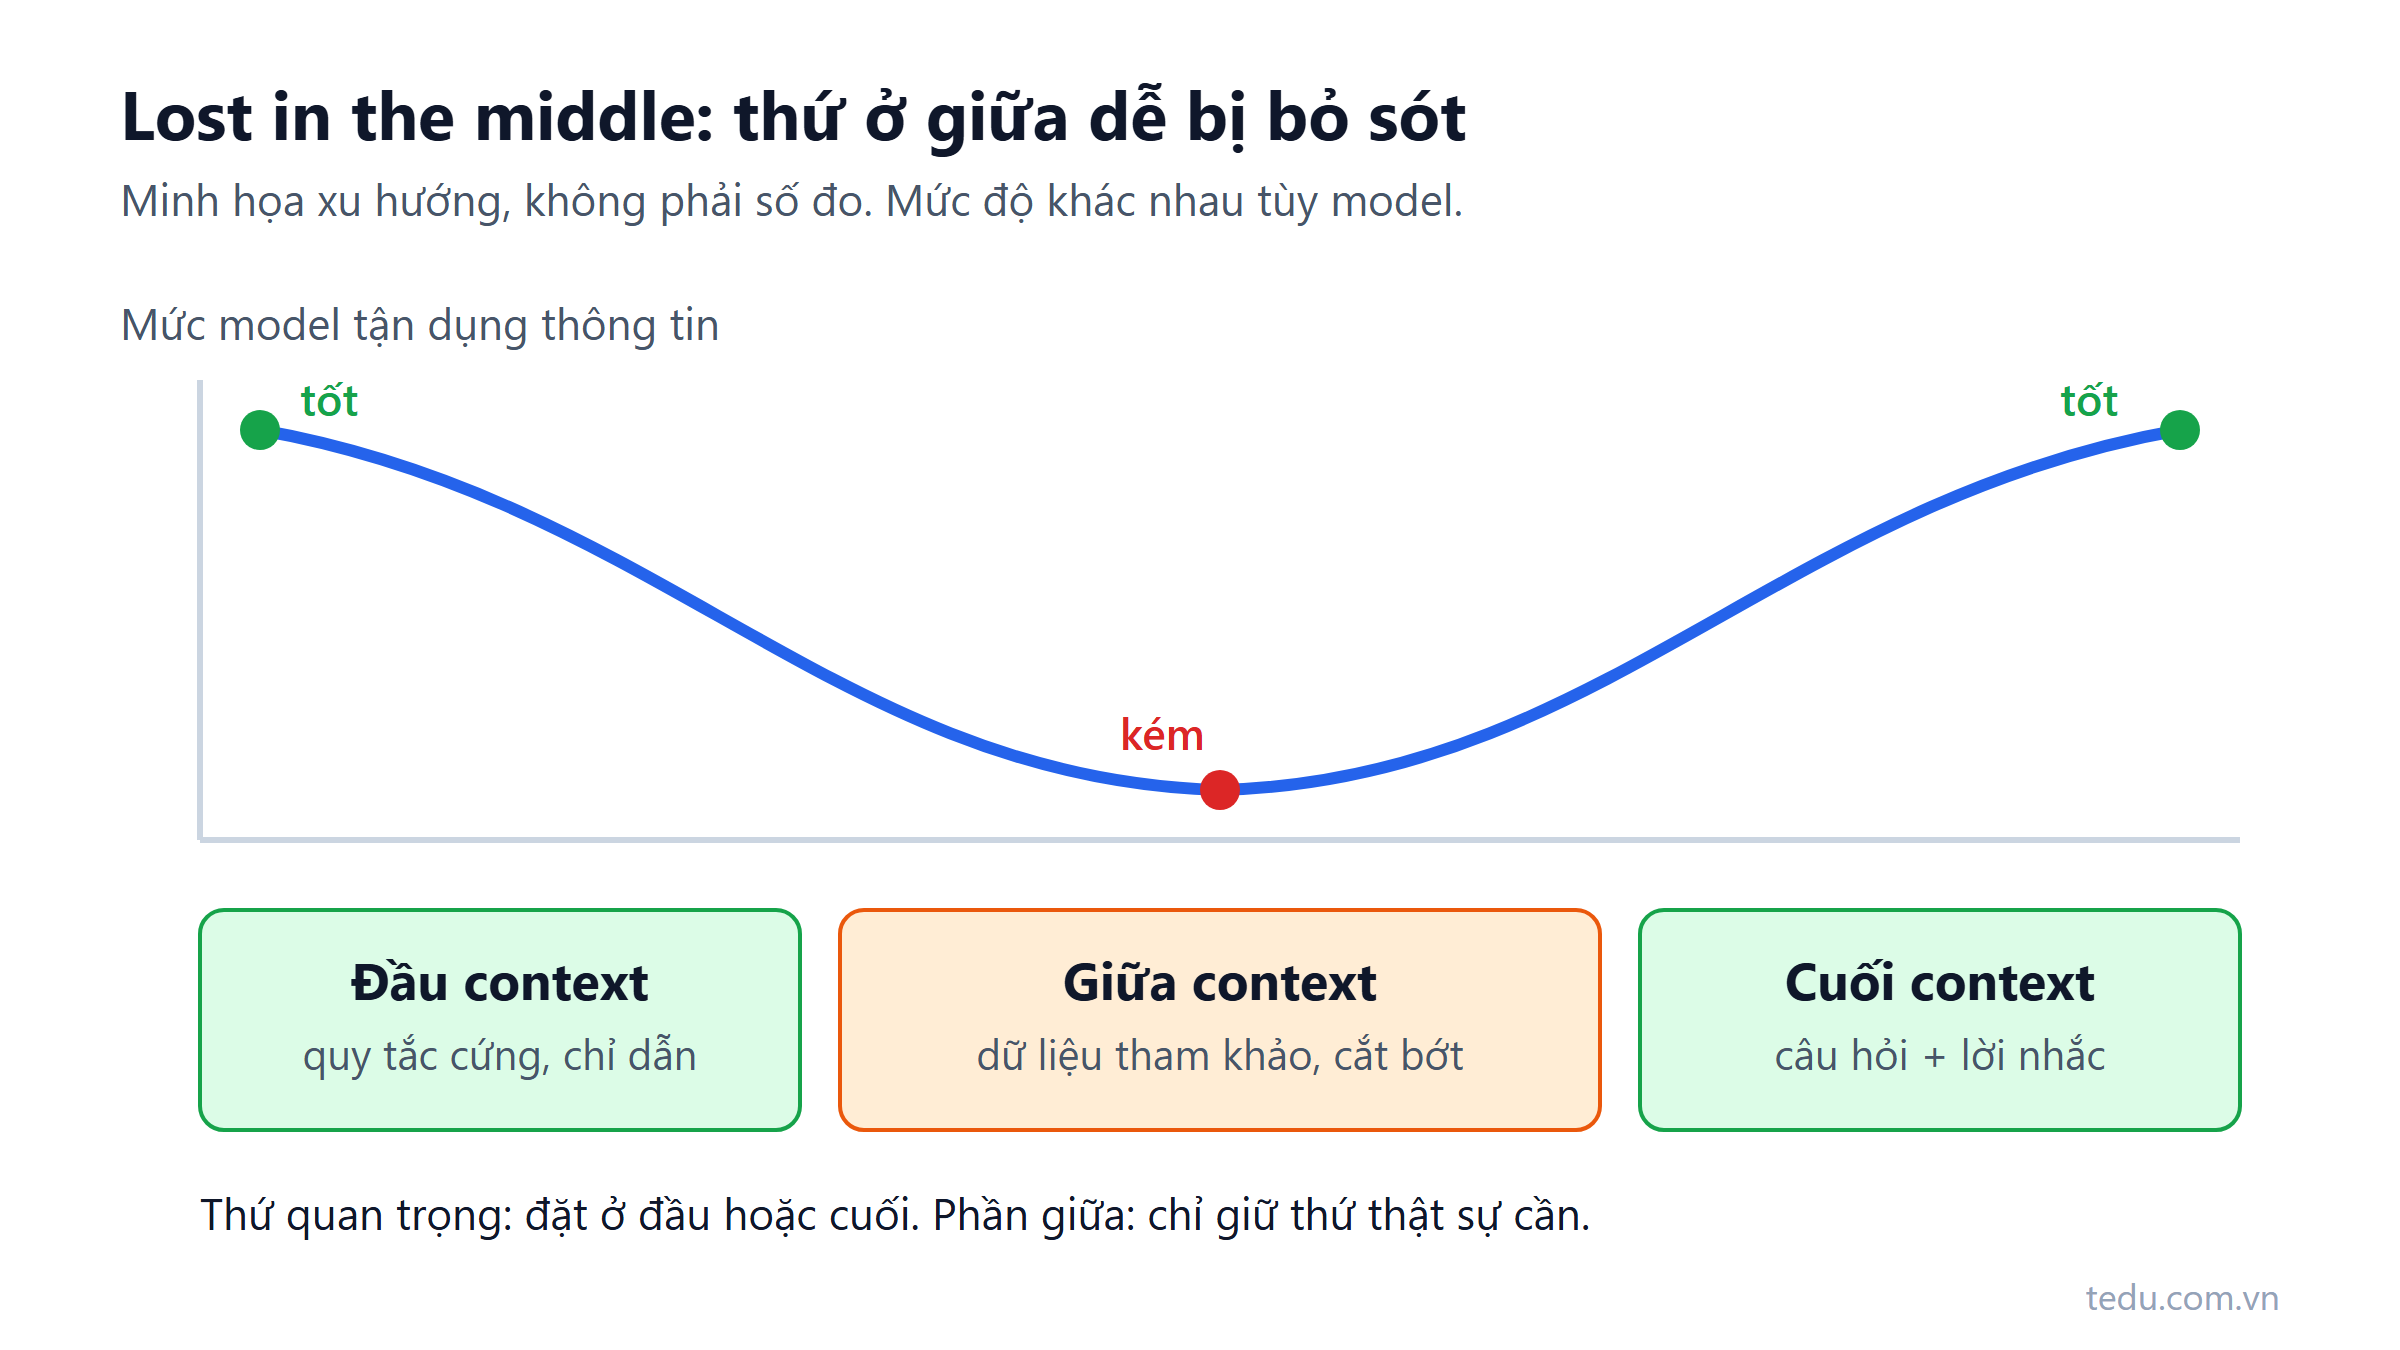
Vì sao nhồi nhiều context lại làm model kém đi
Context window lớn không có nghĩa là nhồi càng nhiều càng tốt. Bài giải thích vì sao model trả lời kém đi khi context dài và cách chọn lọc context đúng.
Đọc thêm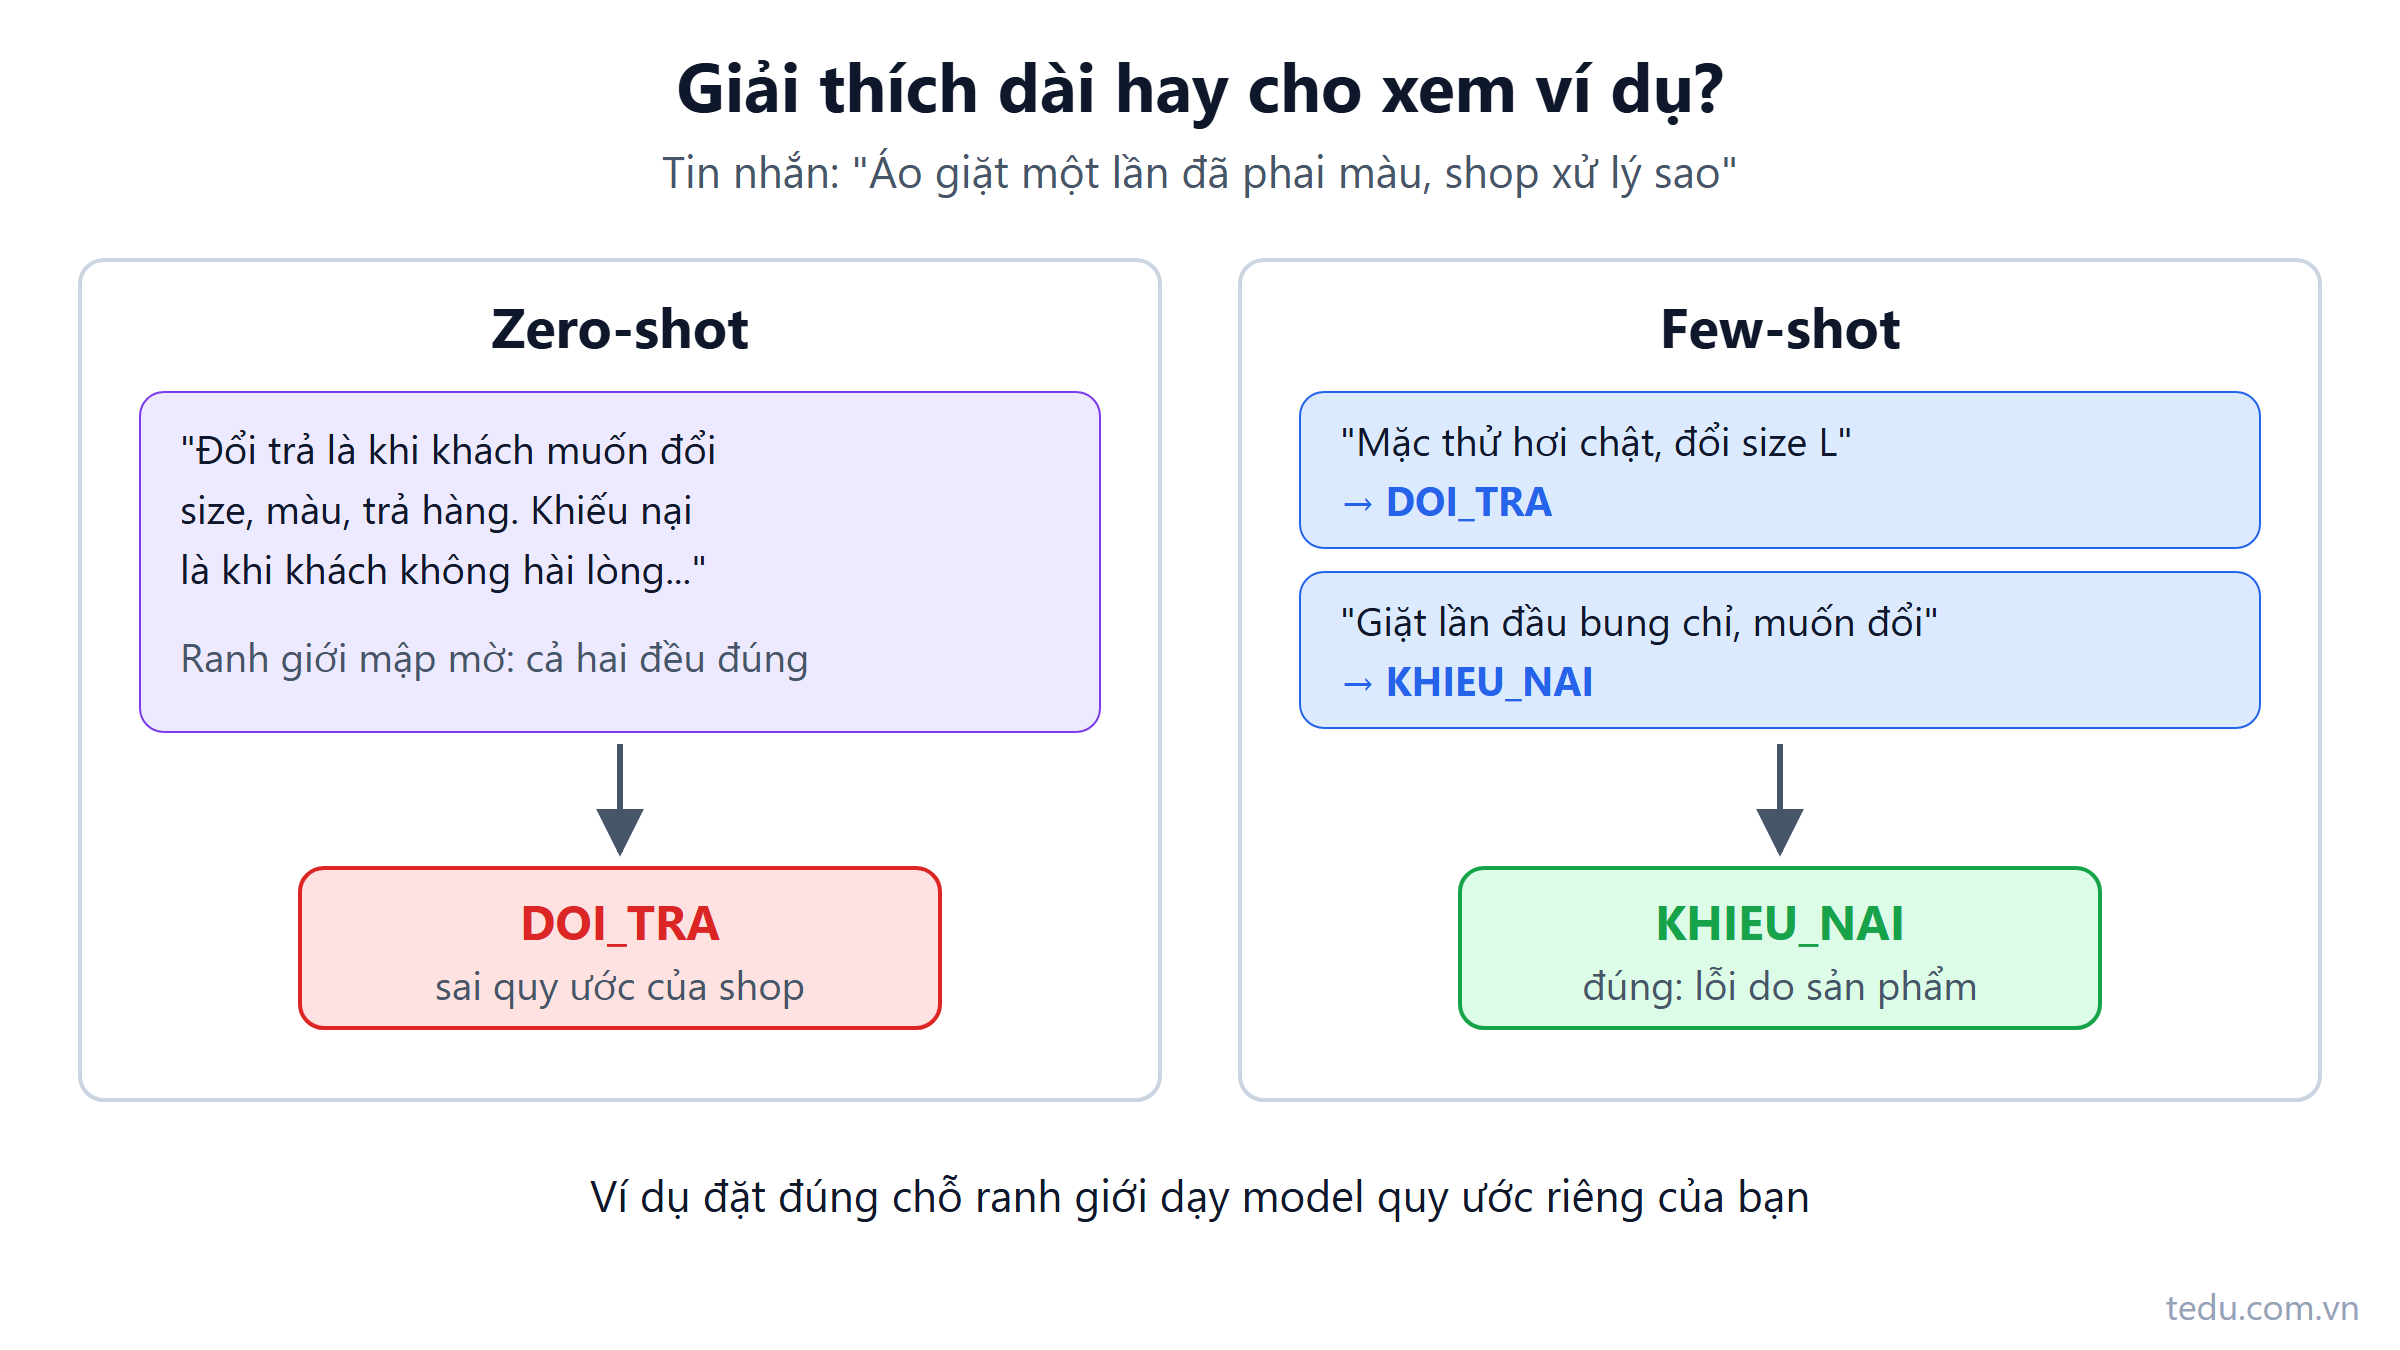
Few-shot prompting: cho LLM ví dụ thay vì giải thích dài dòng
Few-shot prompting là đưa vài ví dụ đầu vào và đầu ra mẫu để LLM bắt chước. Bài chỉ cách chọn ví dụ, lỗi hay gặp và few-shot động bằng C#.
Đọc thêm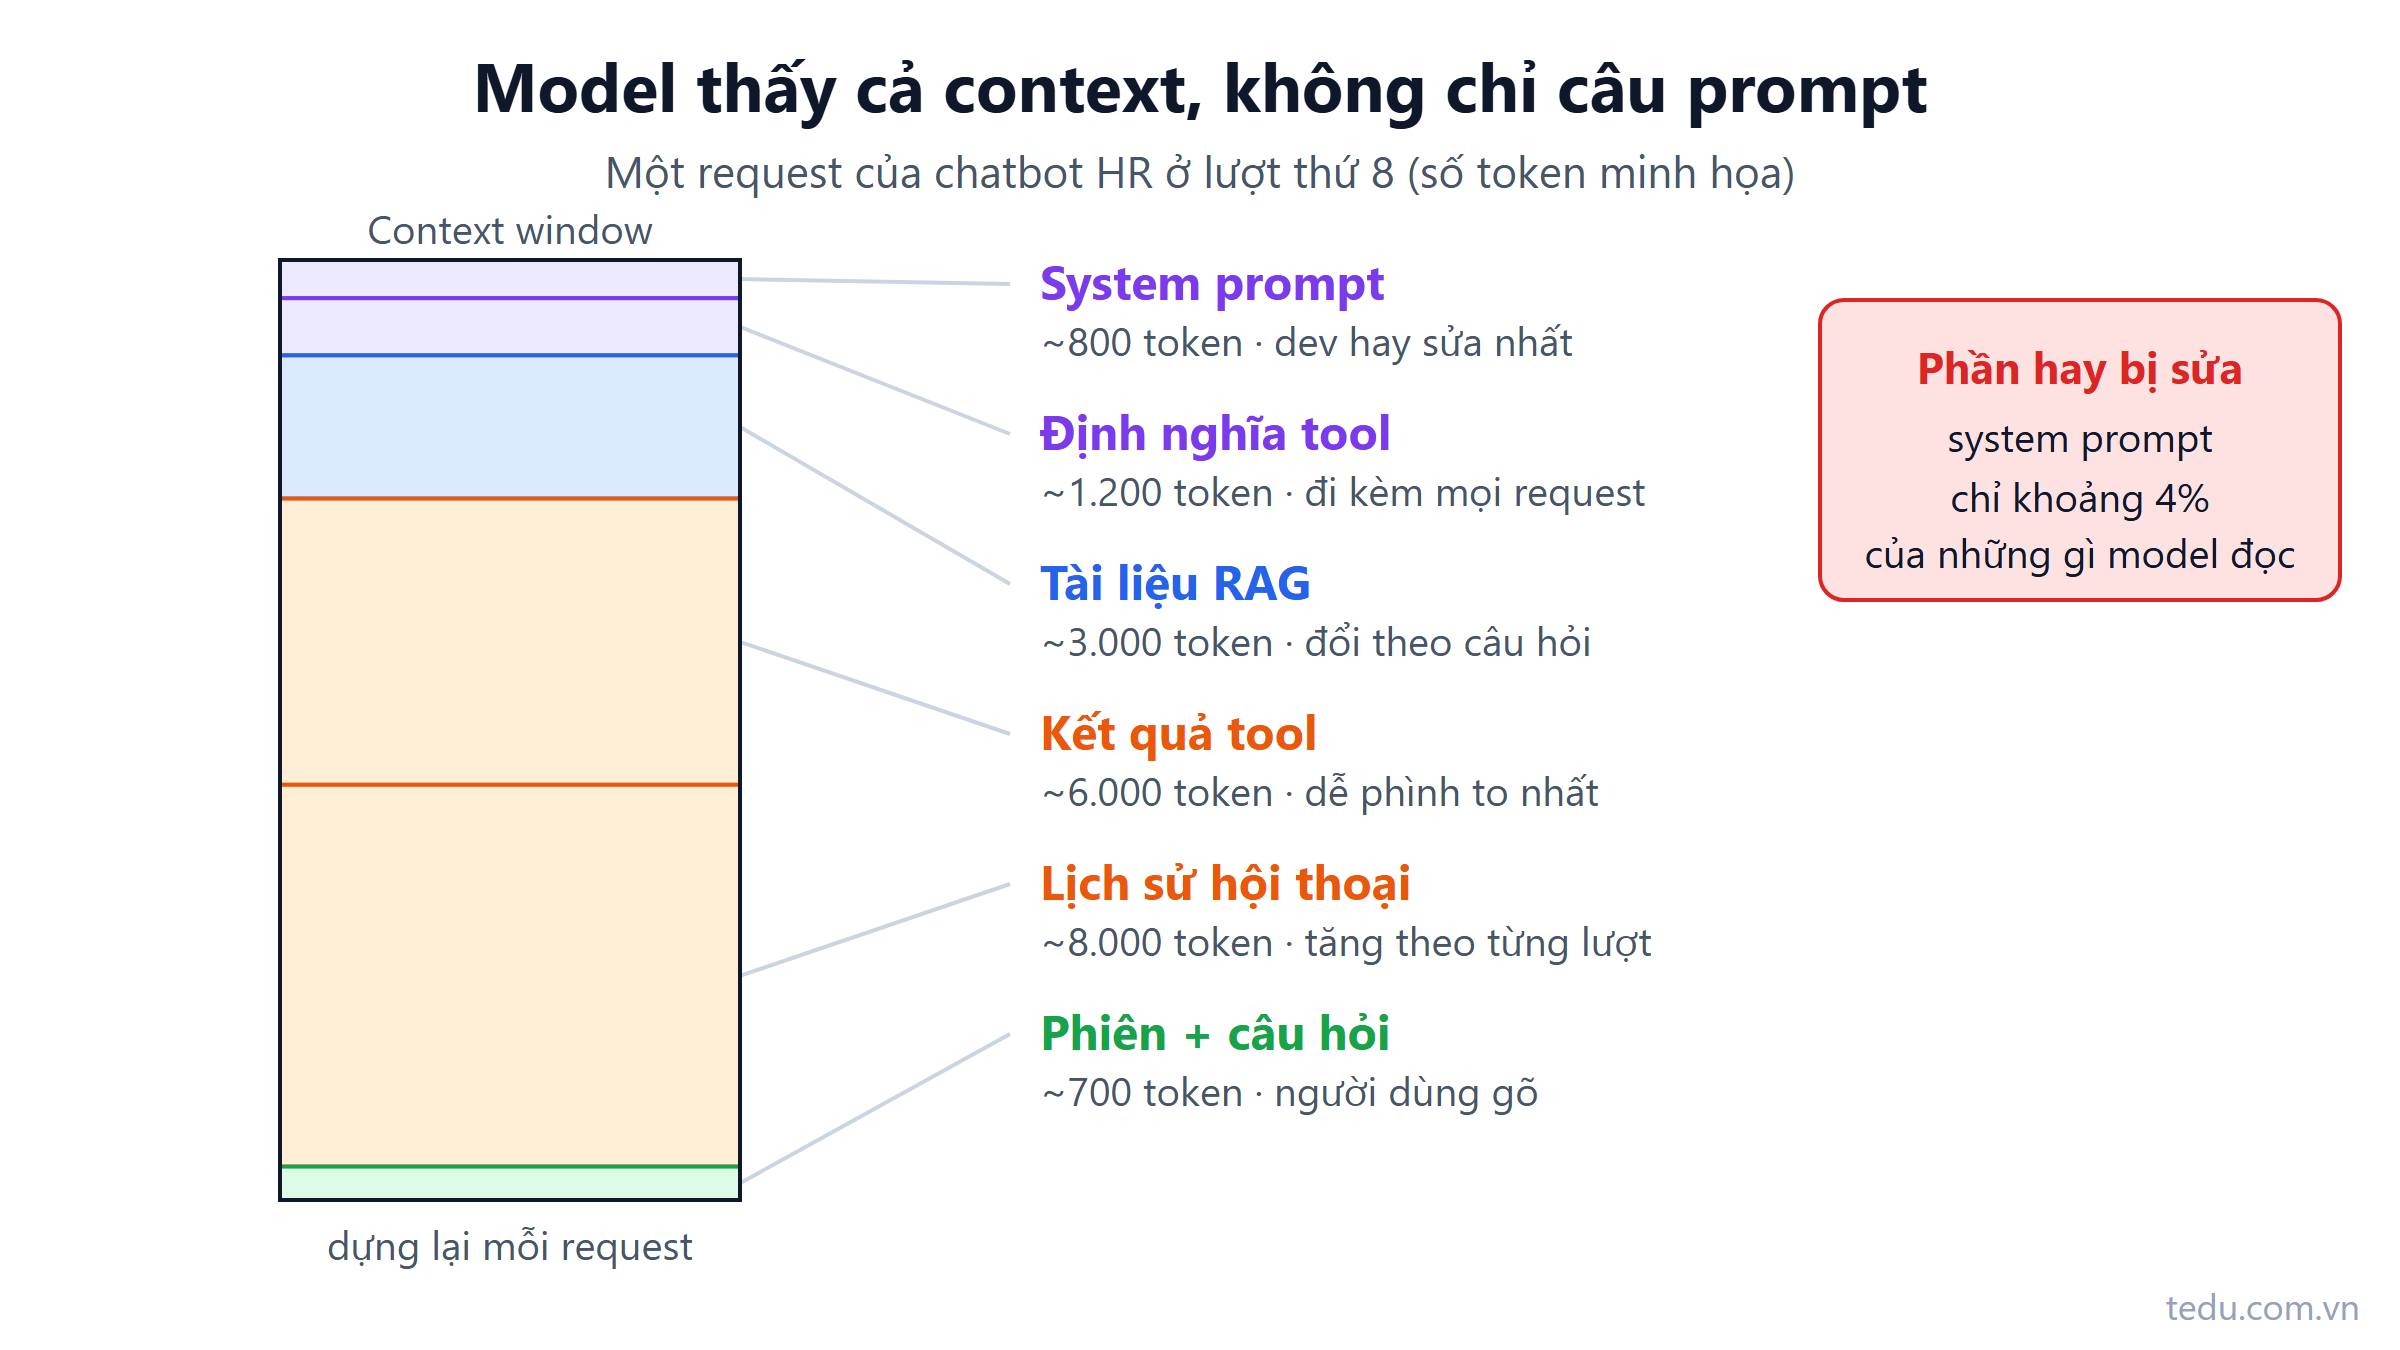
Context engineering là gì, vì sao quan trọng hơn prompt
Context engineering là quyết định cái gì vào context window, cái gì phải ra, theo thứ tự nào. Câu prompt chỉ là một phần nhỏ của những gì model thấy.
Đọc thêm