

pgvector: vì sao PostgreSQL thường đủ làm vector DB
Bạn vừa nhận việc làm tính năng "hỏi đáp trên tài liệu nội bộ" cho hệ thống đang chạy. Bước đầu tiên của RAG là lưu embedding ở đâu đó, và Google cho bạn một danh sách vector database chuyên dụng, mỗi cái một bảng giá, một SDK, một cách vận hành. Trước khi dựng thêm một cụm server mới, hãy tự hỏi: hệ thống của bạn đã có PostgreSQL chưa? Nếu có, pgvector biến chính database đó thành vector database chỉ bằng một lệnh CREATE EXTENSION.
Bài này giải thích pgvector làm được gì, viết SQL và C# thế nào, những lỗi hay gặp khi đưa lên production, và quan trọng hơn: khi nào PostgreSQL là đủ, khi nào thì không.
Vector database thật ra làm việc gì
Embedding là một mảng số (thường vài trăm đến vài nghìn chiều) đại diện cho ý nghĩa của một đoạn văn. Hai đoạn có nghĩa gần nhau thì vector của chúng nằm gần nhau. Vector database làm đúng hai việc:
Lưu các vector kèm dữ liệu đi theo (nội dung gốc, mã tài liệu, người sở hữu).
Tìm k vector gần nhất với một vector truy vấn, nhanh hơn việc so từng dòng một.
Việc thứ nhất database quan hệ nào cũng làm được. Việc thứ hai cần một loại chỉ mục riêng (chỉ mục xấp xỉ, approximate nearest neighbor), và pgvector bổ sung đúng thứ đó cho PostgreSQL. Không có gì thần bí: đây vẫn là bảng, cột, chỉ mục và câu SELECT quen thuộc.
Dựng pgvector trong 5 bước
Bước 1: bật extension và tạo bảng
CREATE EXTENSION IF NOT EXISTS vector;

CREATE TABLE document_chunks (
    id              bigserial    PRIMARY KEY,
    document_id     bigint       NOT NULL,
    tenant_id       int          NOT NULL,
    section         text         NOT NULL,
    content         text         NOT NULL,
    effective_from  date         NOT NULL,
    effective_to    date,
    embedding_model text         NOT NULL,
    embedding       vector(1536) NOT NULL
);
Số 1536 là số chiều của embedding, và nó phải khớp với model bạn dùng để tạo embedding. Đổi model embedding thì thường phải đổi số chiều và tạo lại toàn bộ vector, vì vector của hai model khác nhau không so sánh được với nhau. Cột embedding_model nhỏ nhưng cứu bạn trong ngày đổi model: biết chính xác dòng nào đã được tạo lại, dòng nào chưa.
Các cột section, effective_from, tenant_id là metadata đến từ bước chunking. Chúng chính là lý do pgvector mạnh trong hệ thống nghiệp vụ, như phần sau sẽ nói.
Bước 2: tạo chỉ mục
CREATE INDEX ON document_chunks
    USING hnsw (embedding vector_cosine_ops);
pgvector có hai loại chỉ mục xấp xỉ chính:
| Chỉ mục | Đặc điểm | Khi nào chọn |
|---|---|---|
| HNSW | Dựng dạng đồ thị, truy vấn thường nhanh và độ chính xác tốt, nhưng dựng lâu và tốn bộ nhớ hơn. Có thể tạo ngay cả khi bảng còn trống | Lựa chọn mặc định cho đa số trường hợp |
| IVFFlat | Chia vector thành các cụm (lists), dựng nhanh, nhẹ hơn. Nên tạo sau khi bảng đã có dữ liệu để chia cụm hợp lý | Khi cần dựng chỉ mục nhanh hoặc bị giới hạn bộ nhớ |
Lưu ý quan trọng: toán tử trong truy vấn phải khớp operator class của chỉ mục. Chỉ mục vector_cosine_ops phục vụ toán tử <=> (khoảng cách cosine). Dùng <-> (khoảng cách L2) với chỉ mục cosine thì PostgreSQL bỏ qua chỉ mục và quét cả bảng. Truy vấn vẫn chạy đúng, chỉ chậm, nên rất dễ không nhận ra cho tới khi bảng lớn lên. Hãy kiểm tra bằng EXPLAIN ngay từ đầu.
Chỉ mục còn có giới hạn số chiều tối đa cho từng kiểu dữ liệu. Nếu model embedding của bạn trả về vector rất nhiều chiều, hãy đọc tài liệu pgvector về giới hạn này và các lựa chọn như kiểu halfvec (lưu nửa độ chính xác) hoặc giảm số chiều nếu model hỗ trợ.
Bước 3: truy vấn k gần nhất, có lọc nghiệp vụ
SELECT id, section, content, embedding <=> $1 AS distance
FROM document_chunks
WHERE tenant_id = $2
  AND effective_from <= current_date
  AND (effective_to IS NULL OR effective_to >= current_date)
ORDER BY embedding <=> $1
LIMIT 5;
<=> trả về khoảng cách cosine (càng nhỏ càng giống). Nếu cần "độ tương đồng" để hiển thị, lấy 1 - (embedding <=> $1). Phần WHERE là nơi pgvector tỏa sáng: chỉ tìm trong tài liệu còn hiệu lực và thuộc đúng đơn vị của người hỏi, trong cùng một câu SQL.
Bước 4: chỉnh độ chính xác khi truy vấn
Chỉ mục xấp xỉ đổi một chút độ chính xác lấy tốc độ. Với HNSW, tham số hnsw.ef_search điều chỉnh sự đánh đổi đó lúc truy vấn (còn m và ef_construction điều chỉnh lúc dựng chỉ mục):
SET hnsw.ef_search = 100;Giá trị bao nhiêu là hợp lý phụ thuộc dữ liệu của bạn. Cách làm đúng: có sẵn một tập câu hỏi mẫu với đáp án đã biết, thử vài giá trị và đo cả độ chính xác lẫn thời gian phản hồi, thay vì chép con số từ bài khác (kể cả bài này).
Bước 5: gọi từ C#
Với Npgsql, gói Pgvector cung cấp kiểu Vector để truyền embedding vào tham số:
using Npgsql;
using Pgvector;

var dataSourceBuilder = new NpgsqlDataSourceBuilder(connectionString);
dataSourceBuilder.UseVector();
await using var dataSource = dataSourceBuilder.Build();

float[] queryEmbedding = await embeddingClient.EmbedAsync(question);

await using var cmd = dataSource.CreateCommand(
    @"SELECT id, section, content FROM document_chunks
      WHERE tenant_id = $1
      ORDER BY embedding <=> $2
      LIMIT 5");
cmd.Parameters.AddWithValue(tenantId);
cmd.Parameters.AddWithValue(new Vector(queryEmbedding));

await using var reader = await cmd.ExecuteReaderAsync();
while (await reader.ReadAsync())
{
    var id = reader.GetInt64(0);
    var section = reader.GetString(1);
    var content = reader.GetString(2);
    // ghép vào context cho model
}
embeddingClient là lớp bọc do bạn tự định nghĩa quanh API embedding của nhà cung cấp. Đoạn code trên chỉ minh họa luồng chính. Tên phương thức, namespace và cách đăng ký kiểu có thể khác tùy phiên bản Npgsql và gói Pgvector, nên hãy đối chiếu tài liệu chính thức của pgvector-dotnet theo phiên bản bạn đang dùng. Nếu dự án dùng Entity Framework Core, pgvector cũng có hướng dẫn tích hợp riêng.
Vì sao PostgreSQL thường là đủ
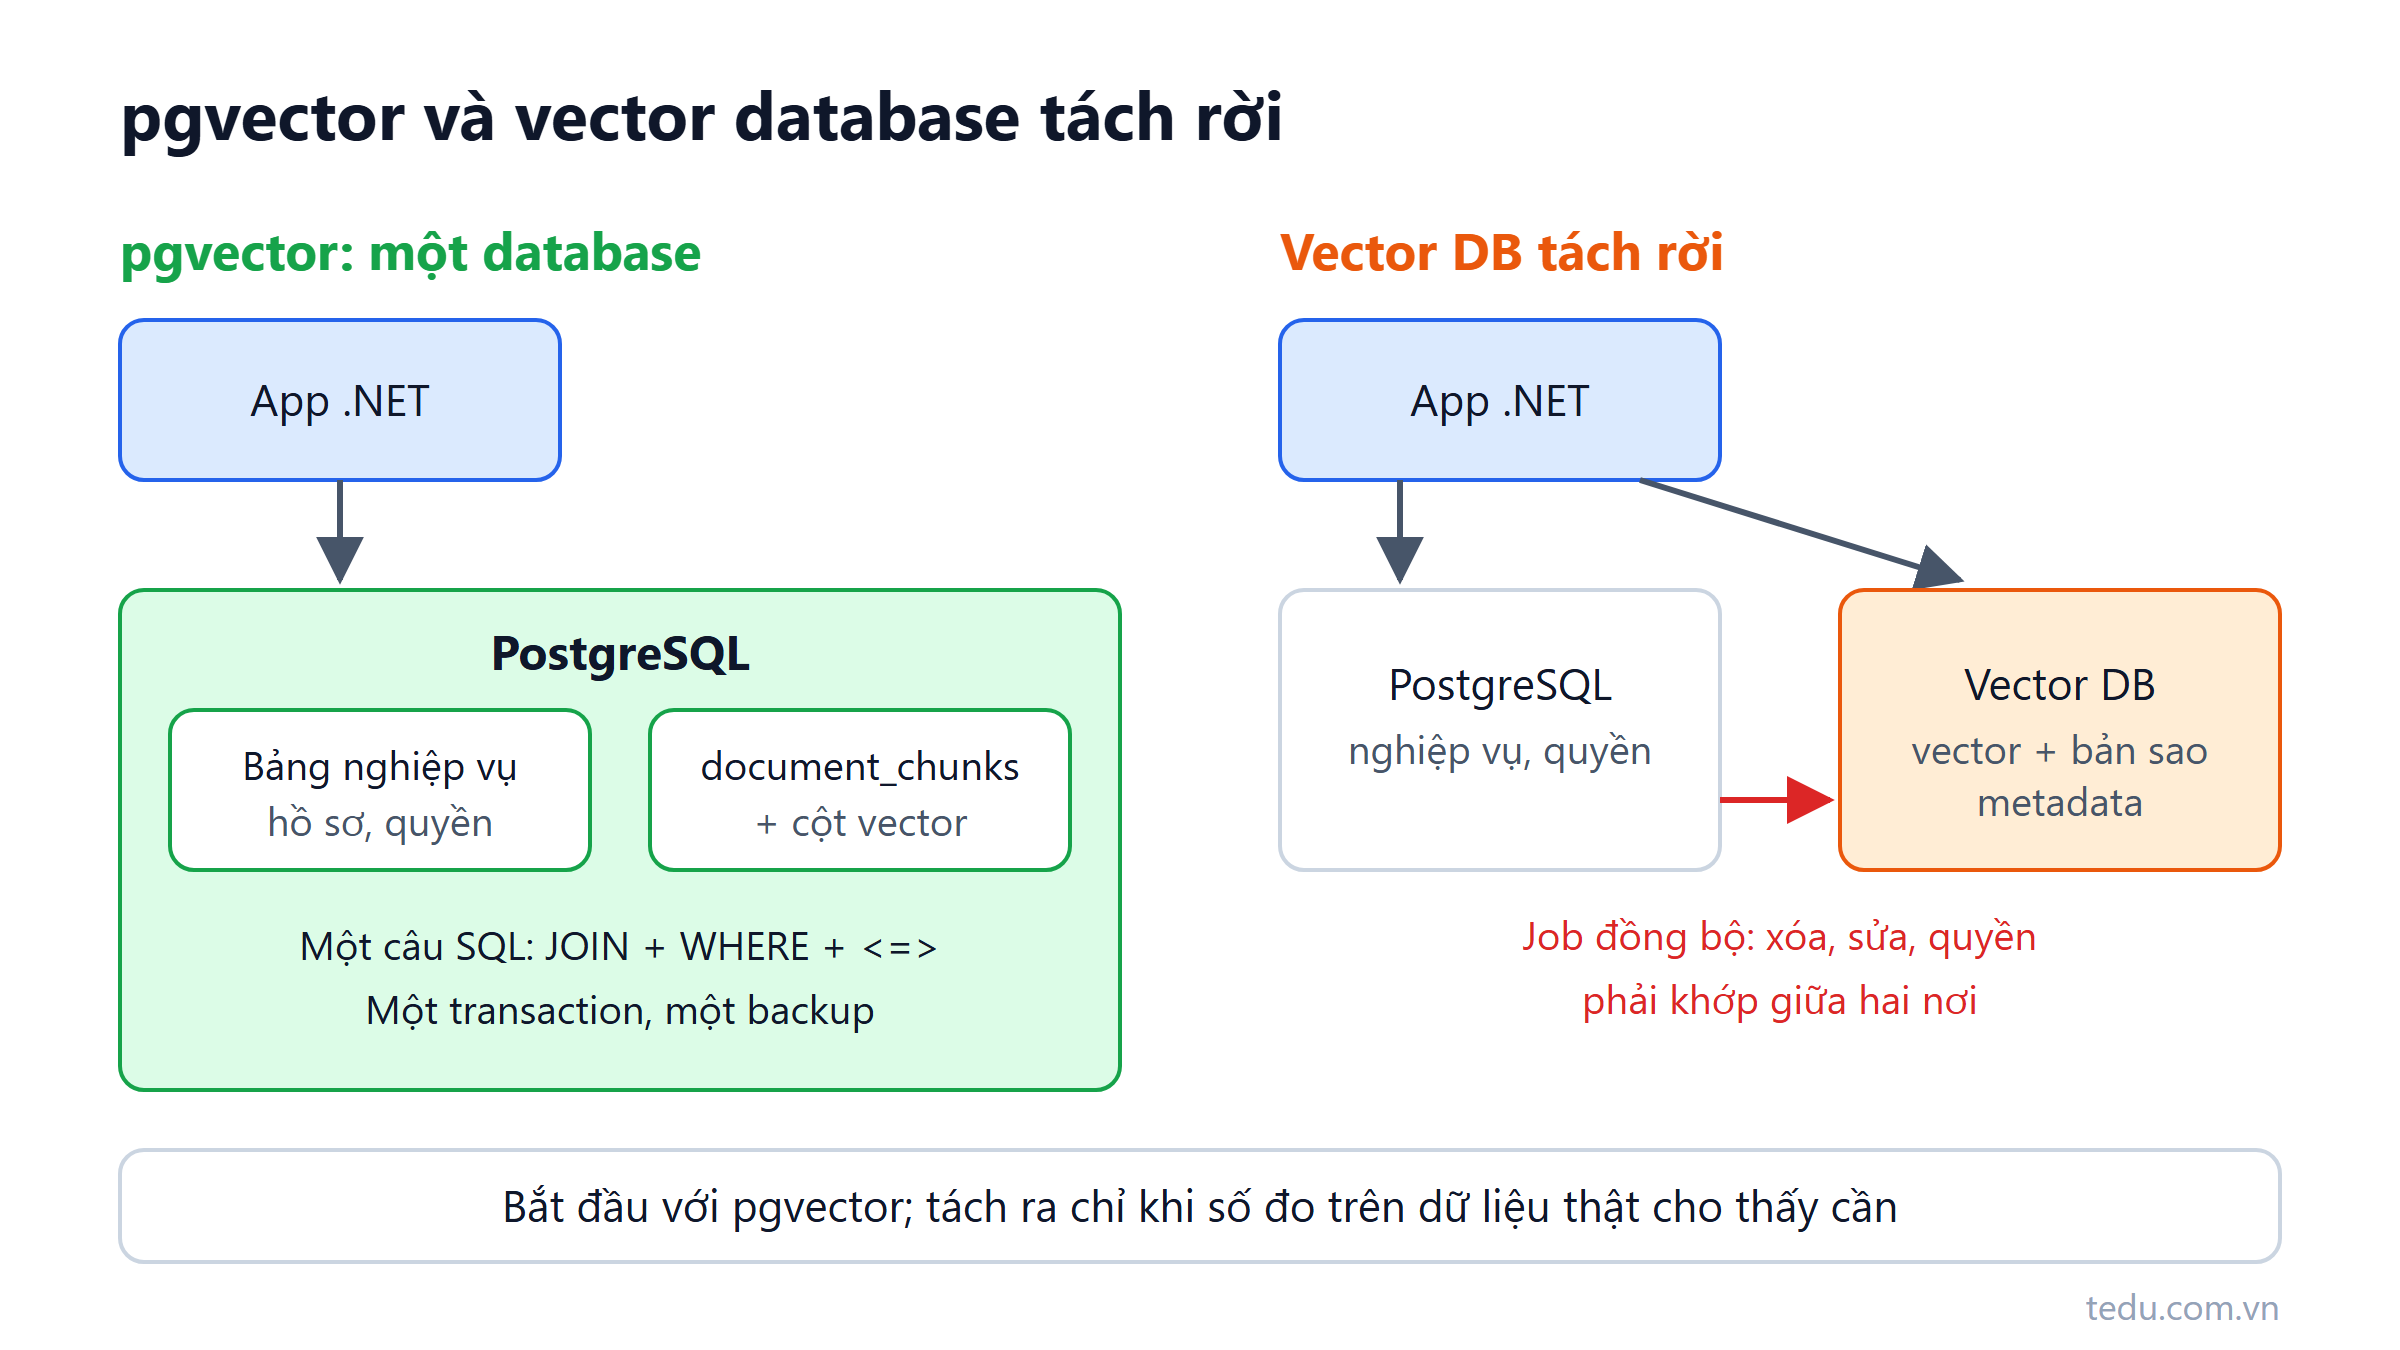
Câu hỏi hay gặp: "pgvector có nhanh bằng vector database chuyên dụng không?" Câu hỏi này đúng nhưng thường không phải câu hỏi quan trọng nhất. Với hệ thống nghiệp vụ, lợi thế lớn của pgvector nằm ở những thứ bạn không phải xây lại:
Transaction. Thêm tài liệu, cập nhật metadata và ghi embedding trong cùng một transaction. Không có chuyện bản ghi gốc đã xóa mà vector vẫn còn nằm ở hệ thống khác.
Join với bảng nghiệp vụ. Lọc theo phòng ban, trạng thái hồ sơ, hạn hiệu lực ngay trong một câu SQL, không cần đồng bộ hai nơi.
Phân quyền. Tài khoản database, row-level security và logic phân quyền bạn đã có tiếp tục dùng được. Với tài liệu nội bộ, đây là chỗ RAG hay lộ dữ liệu nhất (người này hỏi ra tài liệu của người kia).
Backup, replication, giám sát. Quy trình vận hành PostgreSQL của bạn áp dụng nguyên vẹn. Thêm một vector database riêng là thêm một thứ nữa phải backup, nâng cấp và theo dõi lúc 2 giờ sáng.
Đội đã biết dùng. Không ai phải học một ngôn ngữ truy vấn mới.
Hãy hình dung bạn làm RAG cho hệ thống quản lý hồ sơ của một sở. Mỗi tài liệu có đơn vị sở hữu, mức độ mật, ngày hết hiệu lực. Với pgvector, truy vấn "tìm 5 đoạn gần nhất, chỉ trong tài liệu còn hiệu lực và thuộc đơn vị của người hỏi" là một câu SQL có WHERE. Với vector database tách rời, bạn phải đồng bộ các thuộc tính đó sang hai nơi và giữ chúng khớp nhau mãi mãi. "Mãi mãi" là một khoảng thời gian rất dài đối với một job đồng bộ.
So sánh với vector database chuyên dụng
| Tiêu chí | pgvector trên PostgreSQL | Vector database chuyên dụng |
|---|---|---|
| Hạ tầng | Dùng lại PostgreSQL đang có | Thêm một hệ thống cần vận hành |
| Nhất quán dữ liệu | Cùng transaction với dữ liệu nghiệp vụ | Phải tự đồng bộ giữa hai hệ thống |
| Lọc theo thuộc tính | SQL, join, WHERE thoải mái | Tùy sản phẩm, thường có bộ lọc riêng |
| Phân quyền, backup | Dùng sẵn của PostgreSQL | Tùy sản phẩm |
| Tìm theo từ khóa | Full-text search có sẵn, kết hợp được trong cùng SQL | Tùy sản phẩm |
| Tính năng chuyên biệt cho vector ở quy mô rất lớn | Có giới hạn | Thường là điểm mạnh |
| Chi phí học và vận hành | Thấp với đội đã biết PostgreSQL | Cao hơn lúc ban đầu |
Dòng "tìm theo từ khóa" đáng chú ý: vì vector và full-text nằm cùng một database, bạn có thể kết hợp cả hai trong một câu truy vấn. Đó là nội dung của bài tiếp theo, hybrid search.
Lỗi hay gặp khi đưa pgvector lên production
| Lỗi | Biểu hiện | Cách tránh |
|---|---|---|
| Toán tử không khớp operator class | Truy vấn chậm dần khi bảng lớn, EXPLAIN thấy quét tuần tự | Dùng <=> với vector_cosine_ops, kiểm tra EXPLAIN |
Lọc WHERE sau khi lấy k ứng viên | Trả về ít hơn 5 dòng dù dữ liệu có đủ | Thử đúng bộ lọc thật; xem tùy chọn quét lặp ở phiên bản mới |
| Trộn vector của hai model embedding | Kết quả tìm kiếm "kỳ lạ" sau khi đổi model | Cột embedding_model, tạo lại toàn bộ khi đổi |
| Dựng HNSW trên bảng lớn giờ cao điểm | Database chậm, tốn RAM | Dựng ngoài giờ, xem cấu hình bộ nhớ cho việc dựng chỉ mục |
| Không index lại khi tài liệu đổi | Trả lời theo quy chế cũ | Lưu phiên bản tài liệu, xóa và tạo lại chunk khi nguồn đổi |
Lỗi thứ hai cần giải thích thêm. Khi kết hợp chỉ mục xấp xỉ với WHERE, PostgreSQL có thể lấy một số ứng viên từ chỉ mục rồi mới lọc, dẫn đến trả về ít kết quả hơn bạn mong đợi, nhất là khi bộ lọc loại bỏ phần lớn dữ liệu (ví dụ mỗi tenant chỉ chiếm 1% bảng). Các phiên bản pgvector gần đây có thêm cơ chế quét lặp (iterative index scan) để giảm vấn đề này. Hãy kiểm tra tài liệu của phiên bản bạn dùng và thử với đúng bộ lọc thật. Với hệ thống nhiều tenant mà mỗi tenant nhỏ, chỉ mục riêng theo tenant hoặc partition cũng là lựa chọn đáng cân nhắc.
Khi nào pgvector không đủ
Đây là phần bài viết kiểu "dùng gì cũng đủ" hay bỏ qua. Hãy cân nhắc giải pháp chuyên dụng khi:
Số lượng vector rất lớn đến mức chỉ mục không còn nằm vừa trong bộ nhớ của một máy PostgreSQL bạn sẵn sàng trả tiền, và bạn đã đo thực tế chứ không phải đoán.
Tải truy vấn vector áp đảo so với tải nghiệp vụ, và việc nó tranh tài nguyên với database chính bắt đầu gây hại. Lúc này có thể tách thành một PostgreSQL riêng cho vector trước (hoặc dùng read replica), vẫn chưa cần đổi công nghệ.
Cần tính năng chuyên biệt mà pgvector chưa có hoặc chưa đủ tốt cho bài toán của bạn, ví dụ một số kiểu tìm kiếm đa vector hoặc điều chỉnh chỉ mục đặc thù.
Bài này cố ý không đưa ra một con số "vượt quá N triệu vector thì đổi". Ngưỡng đó phụ thuộc số chiều, phần cứng, tần suất ghi và độ chính xác bạn chấp nhận. Cách duy nhất đáng tin là thử trên dữ liệu của chính bạn. Với chatbot quy chế nội bộ, CSKH của một shop, tra cứu hồ sơ của một đơn vị, số lượng chunk thường nằm xa dưới ngưỡng đó.
Bắt đầu thế nào
Bật extension trên PostgreSQL của môi trường thử nghiệm và tạo bảng như ở trên, kèm các cột metadata bạn cần lọc.
Nạp vài trăm đoạn tài liệu thật của hệ thống bạn (đã chia đoạn hợp lý).
Chuẩn bị 20–30 câu hỏi mà bạn biết rõ đoạn nào là đáp án.
Đo xem đoạn đúng có nằm trong 5 kết quả đầu không, và truy vấn mất bao lâu, với đúng bộ lọc
WHEREsẽ dùng thật.Chạy
EXPLAIN ANALYZEđể chắc chắn chỉ mục được dùng.
Nếu kết quả tốt (với RAG nội bộ thì phần lớn trường hợp là vậy), bạn vừa tiết kiệm được một hệ thống phải vận hành. Nếu chưa tốt, hãy nghĩ tới hybrid search và reranking trước khi đổ lỗi cho database: chất lượng RAG thường hỏng ở chunking và cách truy xuất nhiều hơn là ở nơi lưu vector.
Kết luận
pgvector biến PostgreSQL thành vector database bằng một extension: bảng có cột vector, chỉ mục HNSW, toán tử <=>, và mọi thứ còn lại là SQL quen thuộc. Lợi thế lớn nhất không phải tốc độ mà là transaction, join, phân quyền và vận hành dùng chung với hệ thống bạn đã có. Hãy bắt đầu với pgvector, đo trên dữ liệu thật, và chỉ chuyển sang giải pháp chuyên dụng khi số đo cho thấy cần.
Bước tiếp theo: dựng bảng thử nghiệm và chạy bộ 20 câu hỏi. Khi thấy vector search bỏ sót các câu hỏi chứa mã đơn hàng hay số hiệu văn bản, hãy đọc bài kế tiếp: hybrid search, kết hợp keyword và vector.
Xem bản tóm tắt dưới một phút trên YouTube @teduco hoặc TikTok @teducolabs, và đọc thêm các bài khác trong chuyên mục AI cho Backend Developer.
Bài viết liên quan
5 lý do RAG trả lời sai và cách tìm đúng chỗ hỏng
RAG trả lời sai hiếm khi do model kém. Bài chỉ ra 5 chỗ hỏng thường gặp từ dữ liệu, chunking, tìm kiếm đến prompt, kèm cách khoanh vùng lỗi bằng log.
Đọc thêm
Reranking trong RAG: bước bị bỏ qua nhiều nhất
Reranking chấm lại vài chục đoạn tìm được để chọn ra vài đoạn thật sự trả lời câu hỏi. Bài giải thích cơ chế, cách gắn vào pipeline C# và lỗi hay gặp.
Đọc thêm
Hybrid search trong RAG: kết hợp keyword và vector
Vector search giỏi hiểu nghĩa nhưng hay trượt mã đơn hàng, số hiệu văn bản. Hybrid search kết hợp keyword và vector bằng RRF, có ví dụ SQL PostgreSQL và C#.
Đọc thêm
Chunking trong RAG: cắt tài liệu sai thì kết quả hỏng
Chunking là bước cắt tài liệu thành đoạn nhỏ trước khi đưa vào RAG. Bài so sánh các cách chunking, ví dụ với quy chế tiếng Việt và code C# cắt theo Điều, Khoản.
Đọc thêm
RAG là gì? Khi nào cần và khi nào không cần
RAG là cách đưa đúng đoạn tài liệu vào prompt để model trả lời theo dữ liệu thật. Bài này giải thích pipeline và khi nào bạn không cần RAG.
Đọc thêm
Quản lý prompt như code: versioning, review và test
Prompt là logic nghiệp vụ, sửa một câu có thể đổi hành vi cả hệ thống. Bài hướng dẫn quản lý prompt như code: lưu trong repo, versioning, review, test và rollback.
Đọc thêm
Chain-of-thought: cho model suy nghĩ trước khi trả lời
Chain-of-thought là cho model viết các bước suy luận trước khi chốt đáp án. Bài giải thích vì sao nó hiệu quả, khi nào nên dùng và cách dùng trong production.
Đọc thêm
Vì sao nhồi nhiều context lại làm model kém đi
Context window lớn không có nghĩa là nhồi càng nhiều càng tốt. Bài giải thích vì sao model trả lời kém đi khi context dài và cách chọn lọc context đúng.
Đọc thêm
Few-shot prompting: cho LLM ví dụ thay vì giải thích dài dòng
Few-shot prompting là đưa vài ví dụ đầu vào và đầu ra mẫu để LLM bắt chước. Bài chỉ cách chọn ví dụ, lỗi hay gặp và few-shot động bằng C#.
Đọc thêm
Context engineering là gì, vì sao quan trọng hơn prompt
Context engineering là quyết định cái gì vào context window, cái gì phải ra, theo thứ tự nào. Câu prompt chỉ là một phần nhỏ của những gì model thấy.
Đọc thêm