

Quản lý prompt như code: versioning, review và test
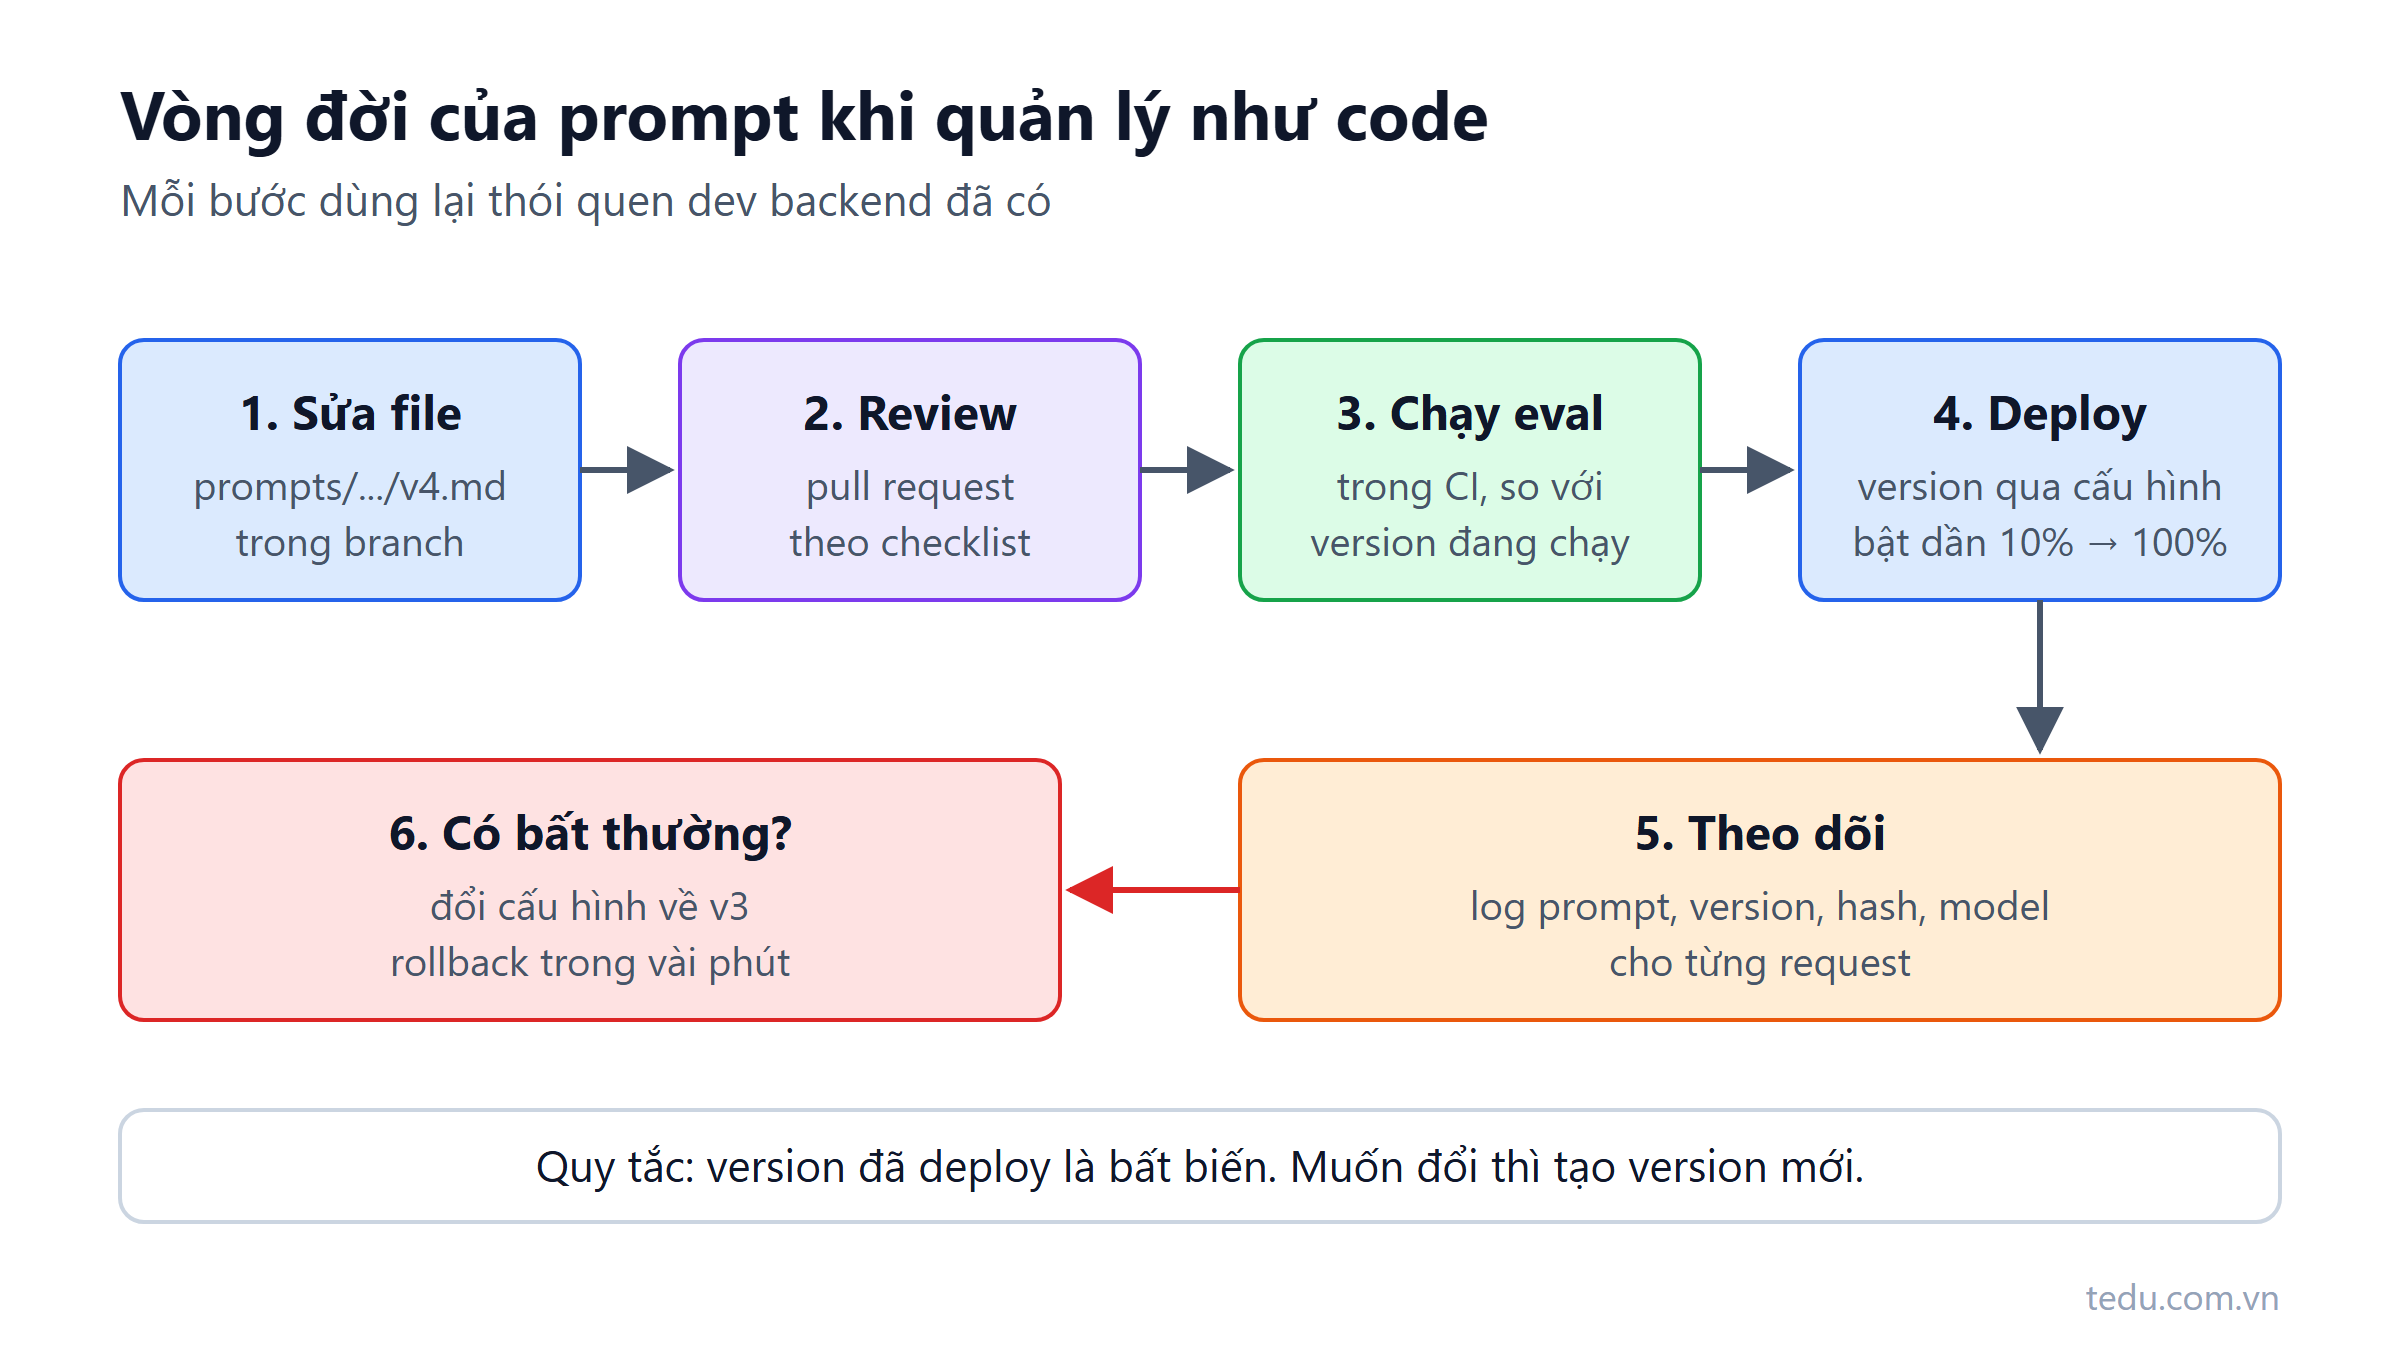
Thứ Sáu, một bạn trong team chăm sóc khách hàng thấy chatbot của shop trả lời hơi cộc. Bạn ấy mở trang admin, sửa system prompt, thêm một câu: "Luôn xin lỗi khách và cố gắng làm khách hài lòng." Không ai review, vì "chỉ là sửa câu chữ".
Thứ Hai, kế toán hỏi vì sao cuối tuần có 14 yêu cầu hoàn tiền được bot "hứa sẽ xử lý ngay". Hóa ra "cố gắng làm khách hài lòng" được model hiểu rất nhiệt tình. Không ai biết prompt cũ là gì, sửa lúc nào, và bản nào đã trả lời những khách nào.
Nếu bạn là dev backend, kịch bản này nghe rất giống chuyện sửa thẳng code trên server production. Bài này giải thích vì sao prompt nên được quản lý như code, và cách làm cụ thể: lưu ở đâu, đánh version thế nào, review gì, test ra sao, rollback thế nào.
Prompt là logic nghiệp vụ, không phải câu chữ
Trong một ứng dụng LLM, prompt quyết định bot được nói gì, không được nói gì, trả về định dạng nào, khi nào gọi tool. Đó là quy tắc nghiệp vụ, chỉ khác là viết bằng tiếng Việt thay vì C#.
Khác biệt nguy hiểm: code sai thì thường lỗi biên dịch hoặc test đỏ. Prompt sai thì hệ thống vẫn chạy bình thường, chỉ là trả lời khác đi. Không exception, không cảnh báo, cho tới khi khách hoặc sếp phát hiện.
| Thay đổi | Ví dụ | Hậu quả có thể |
|---|---|---|
| Thêm một câu "thân thiện" | "Luôn cố làm khách hài lòng" | Bot hứa hoàn tiền, hứa giao nhanh không có thật |
| Bỏ một ràng buộc | Xóa dòng "chỉ trả lời theo chính sách bên dưới" | Bot trả lời theo kiến thức chung, bịa chính sách |
| Đổi ví dụ few-shot | Thay 3 ví dụ mẫu | Định dạng đầu ra đổi, code parse phía sau lỗi |
| Đổi model nhưng giữ prompt | Nâng lên model mới | Cùng prompt, hành vi khác, có khi tốt hơn ở chỗ này và tệ hơn ở chỗ khác |
Mỗi dòng trong bảng đều là một thay đổi hành vi hệ thống. Chúng xứng đáng được đối xử như thay đổi code.
Năm nguyên tắc quản lý prompt như code
1. Lưu prompt trong repo, tách khỏi code xử lý
Đừng để prompt là chuỗi string rải rác trong 15 file service. Gom về một thư mục riêng, mỗi prompt một file, có version trong tên hoặc trong nội dung:
prompts/
  support-reply/
    v3.md
    v4.md
    examples.json
  refund-classifier/
    v1.md
  README.md
File prompt chứa template với biến rõ ràng, ví dụ {{policy}}, {{order}}, {{question}}. Code chỉ lo điền biến và gọi model. Khi prompt nằm trong file .md, review diff trên pull request dễ đọc hơn nhiều so với một chuỗi raw string trong C#.
2. Mỗi thay đổi đi qua pull request
Sửa prompt là sửa logic nghiệp vụ, nên đi qua đúng quy trình như sửa code: tạo branch, mở pull request, có người review. Người review không chỉ đọc câu chữ, mà hỏi những câu như trong checklist ở phần sau.
Prompt do người không biết code (CSKH, nghiệp vụ) đề xuất thì sao? Họ vẫn đề xuất được, qua pull request hoặc qua một issue, rồi dev đưa vào. Điều cần tránh là ô textarea trên trang admin sửa thẳng production mà không để lại dấu vết.
3. Version bất biến và log version theo từng request
Một khi support-reply/v3 đã lên production, không sửa nội dung v3 nữa. Thay đổi thì tạo v4. Như vậy bất cứ lúc nào bạn cũng trả lời được câu hỏi "khách này nhận câu trả lời từ prompt nào".
Muốn trả lời câu đó, mỗi lần gọi model phải log kèm: tên prompt, version, model, và tốt nhất là một mã hash của nội dung prompt sau khi điền biến. Đây là thông tin quan trọng nhất khi điều tra khiếu nại, và là nền tảng cho tracing.
4. Có bộ test trước khi merge
Code có unit test, prompt có bộ eval. Tối thiểu là vài chục câu hỏi thật kèm tiêu chí đúng: câu này phải từ chối hoàn tiền, câu này phải hỏi mã đơn, câu này phải trả JSON đúng schema. Mỗi pull request sửa prompt chạy bộ này và so với version đang chạy. Chi tiết cách xây bộ test ở bài xây bộ eval set đầu tiên và regression test khi đổi model hoặc prompt.
5. Deploy có kiểm soát, rollback được trong vài phút
Version nào đang dùng nên là cấu hình (feature flag, appsettings, biến môi trường), không phải hằng số trong code. Như vậy bạn có thể cho 10% request dùng v4 để theo dõi, và quay về v3 ngay khi thấy bất thường mà không cần build lại.
Ví dụ triển khai trong .NET
Dưới đây là một cách đơn giản, không phụ thuộc thư viện ngoài: prompt là file .md được nhúng vào assembly (embedded resource), có một lớp registry đọc theo tên và version, kèm hash để log. Tên lớp là do bạn tự định nghĩa.
Khai báo trong file .csproj:
<ItemGroup>
  <EmbeddedResource Include="prompts\**\*.md" />
</ItemGroup>
Lớp registry:
using System.Reflection;
using System.Security.Cryptography;
using System.Text;

public sealed record PromptTemplate(string Name, string Version, string Text, string Hash);

public sealed class PromptRegistry
{
    private readonly Assembly _assembly = typeof(PromptRegistry).Assembly;

    public PromptTemplate Get(string name, string version)
    {
        // Tên resource dạng: <RootNamespace>.prompts.support_reply.v3.md
        var suffix = $".prompts.{name.Replace('-', '_')}.{version}.md";
        var resource = _assembly.GetManifestResourceNames()
            .SingleOrDefault(n => n.EndsWith(suffix))
            ?? throw new InvalidOperationException($"Không tìm thấy prompt {name}/{version}");

        using var stream = _assembly.GetManifestResourceStream(resource)!;
        using var reader = new StreamReader(stream, Encoding.UTF8);
        var text = reader.ReadToEnd();

        var hash = Convert.ToHexString(SHA256.HashData(Encoding.UTF8.GetBytes(text)))[..12];
        return new PromptTemplate(name, version, text, hash);
    }

    public static string Render(PromptTemplate t, IReadOnlyDictionary<string, string> vars) =>
        vars.Aggregate(t.Text, (acc, kv) => acc.Replace("{{" + kv.Key + "}}", kv.Value));
}
Cách đặt tên embedded resource (dấu gạch ngang trong tên thư mục bị đổi thành gạch dưới) phụ thuộc cách MSBuild sinh tên, nên hãy in GetManifestResourceNames() ra một lần để kiểm tra trong project của bạn.
Sử dụng, với version lấy từ cấu hình:
var version = configuration["Prompts:SupportReply"] ?? "v3";
var template = registry.Get("support-reply", version);
var prompt = PromptRegistry.Render(template, new Dictionary<string, string>
{
    ["policy"] = currentPolicy,
    ["order"] = orderJson,
    ["question"] = userQuestion
});

logger.LogInformation(
    "LLM call prompt={Prompt} version={Version} hash={Hash} model={Model}",
    template.Name, template.Version, template.Hash, modelName);
Phiên bản đơn giản này đủ cho phần lớn đội nhỏ. Khi số prompt và số người sửa tăng lên, có các công cụ quản lý prompt chuyên dụng (thường đi kèm nền tảng observability cho LLM), nhưng nguyên tắc vẫn y như trên: version bất biến, có review, có test, có log.
Review một thay đổi prompt: hỏi gì
Review prompt khác review code ở chỗ bạn phải đọc nó bằng mắt của model. Bảng câu hỏi dưới đây dùng được làm template cho pull request:
| Câu hỏi | Vì sao quan trọng |
|---|---|
| Thay đổi này nhằm sửa ca nào? Có ví dụ input thật không? | Tránh sửa theo cảm giác, có ca để kiểm tra lại |
| Câu mới có mâu thuẫn với quy tắc nào đã có không? | "Làm khách hài lòng" mâu thuẫn ngầm với "không hứa hoàn tiền" |
| Có từ ngữ mơ hồ kiểu "cố gắng", "khi phù hợp", "nếu cần" không? | Model diễn giải các từ này rộng hơn bạn nghĩ |
| Định dạng đầu ra có đổi không? Code parse phía sau có còn chạy? | Prompt đổi định dạng là breaking change |
| Prompt có dài thêm nhiều không? | Tăng chi phí và có thể làm chỉ dẫn bị loãng |
| Bộ eval chạy ra kết quả thế nào so với version cũ? | Câu trả lời bằng số, không bằng cảm nhận |
Với ví dụ đầu bài, chỉ cần câu hỏi thứ hai và thứ ba là đã chặn được "Luôn xin lỗi khách và cố gắng làm khách hài lòng".
Lỗi hay gặp
Prompt nằm trong database, sửa qua trang admin, không lịch sử. Tiện lúc đầu, thảm họa khi cần điều tra. Nếu bắt buộc lưu trong DB, ít nhất phải có bảng version bất biến và log ai sửa, sửa lúc nào.
Sửa thẳng version đang chạy. Log ghi "v3" nhưng v3 hôm nay khác v3 hôm qua, log mất giá trị.
Không log version theo request. Khi khách khiếu nại, không biết họ đã gặp prompt nào.
Test bằng cách hỏi thử 3 câu. Ba câu thấy ổn không có nghĩa câu thứ 40 không hỏng.
Đổi model mà nghĩ prompt không đổi. Prompt và model là một cặp. Đổi một trong hai đều cần chạy lại bộ eval.
Copy prompt giữa các môi trường bằng tay. Staging một bản, production một bản, không ai chắc chúng giống nhau.
Checklist áp dụng cho đội của bạn
Gom toàn bộ prompt đang nằm rải rác trong code về thư mục
prompts/, mỗi prompt một file.Đặt version cho từng prompt, quy ước không sửa version đã deploy.
Đưa version đang dùng ra cấu hình, rollback không cần build lại.
Log tên prompt, version, hash, model cho mỗi lần gọi LLM.
Thêm template pull request với các câu hỏi review ở trên.
Xây bộ eval tối thiểu 20–30 ca thật và chạy nó trong CI khi thư mục
prompts/thay đổi.
Bước 1 đến 4 thường làm xong trong một ngày. Bước 5 và 6 là phần đem lại giá trị lâu dài.
Kết luận
Prompt là logic nghiệp vụ viết bằng ngôn ngữ tự nhiên, và nó hỏng một cách im lặng. Vì vậy hãy đối xử với nó như code: lưu trong repo, version bất biến, review qua pull request, test bằng bộ eval, deploy có cấu hình và rollback được. Đây là những thói quen dev backend đã có sẵn, chỉ cần áp sang một loại "mã nguồn" mới. Nếu bạn đang viết prompt có ví dụ mẫu hay bước suy luận, đó chính là những thứ cần được version cẩn thận nhất.
Bước tiếp theo: đếm xem hệ thống của bạn có bao nhiêu prompt và chúng đang nằm ở đâu. Phần tiếp theo của series chuyển sang RAG, bắt đầu với bài RAG là gì, khi nào cần và khi nào không.
Xem bản tóm tắt dưới một phút trên YouTube @teduco hoặc TikTok @teducolabs, và đọc thêm các bài khác trong chuyên mục AI cho Backend Developer.
Bài viết liên quan
5 lý do RAG trả lời sai và cách tìm đúng chỗ hỏng
RAG trả lời sai hiếm khi do model kém. Bài chỉ ra 5 chỗ hỏng thường gặp từ dữ liệu, chunking, tìm kiếm đến prompt, kèm cách khoanh vùng lỗi bằng log.
Đọc thêm
Reranking trong RAG: bước bị bỏ qua nhiều nhất
Reranking chấm lại vài chục đoạn tìm được để chọn ra vài đoạn thật sự trả lời câu hỏi. Bài giải thích cơ chế, cách gắn vào pipeline C# và lỗi hay gặp.
Đọc thêm
Hybrid search trong RAG: kết hợp keyword và vector
Vector search giỏi hiểu nghĩa nhưng hay trượt mã đơn hàng, số hiệu văn bản. Hybrid search kết hợp keyword và vector bằng RRF, có ví dụ SQL PostgreSQL và C#.
Đọc thêm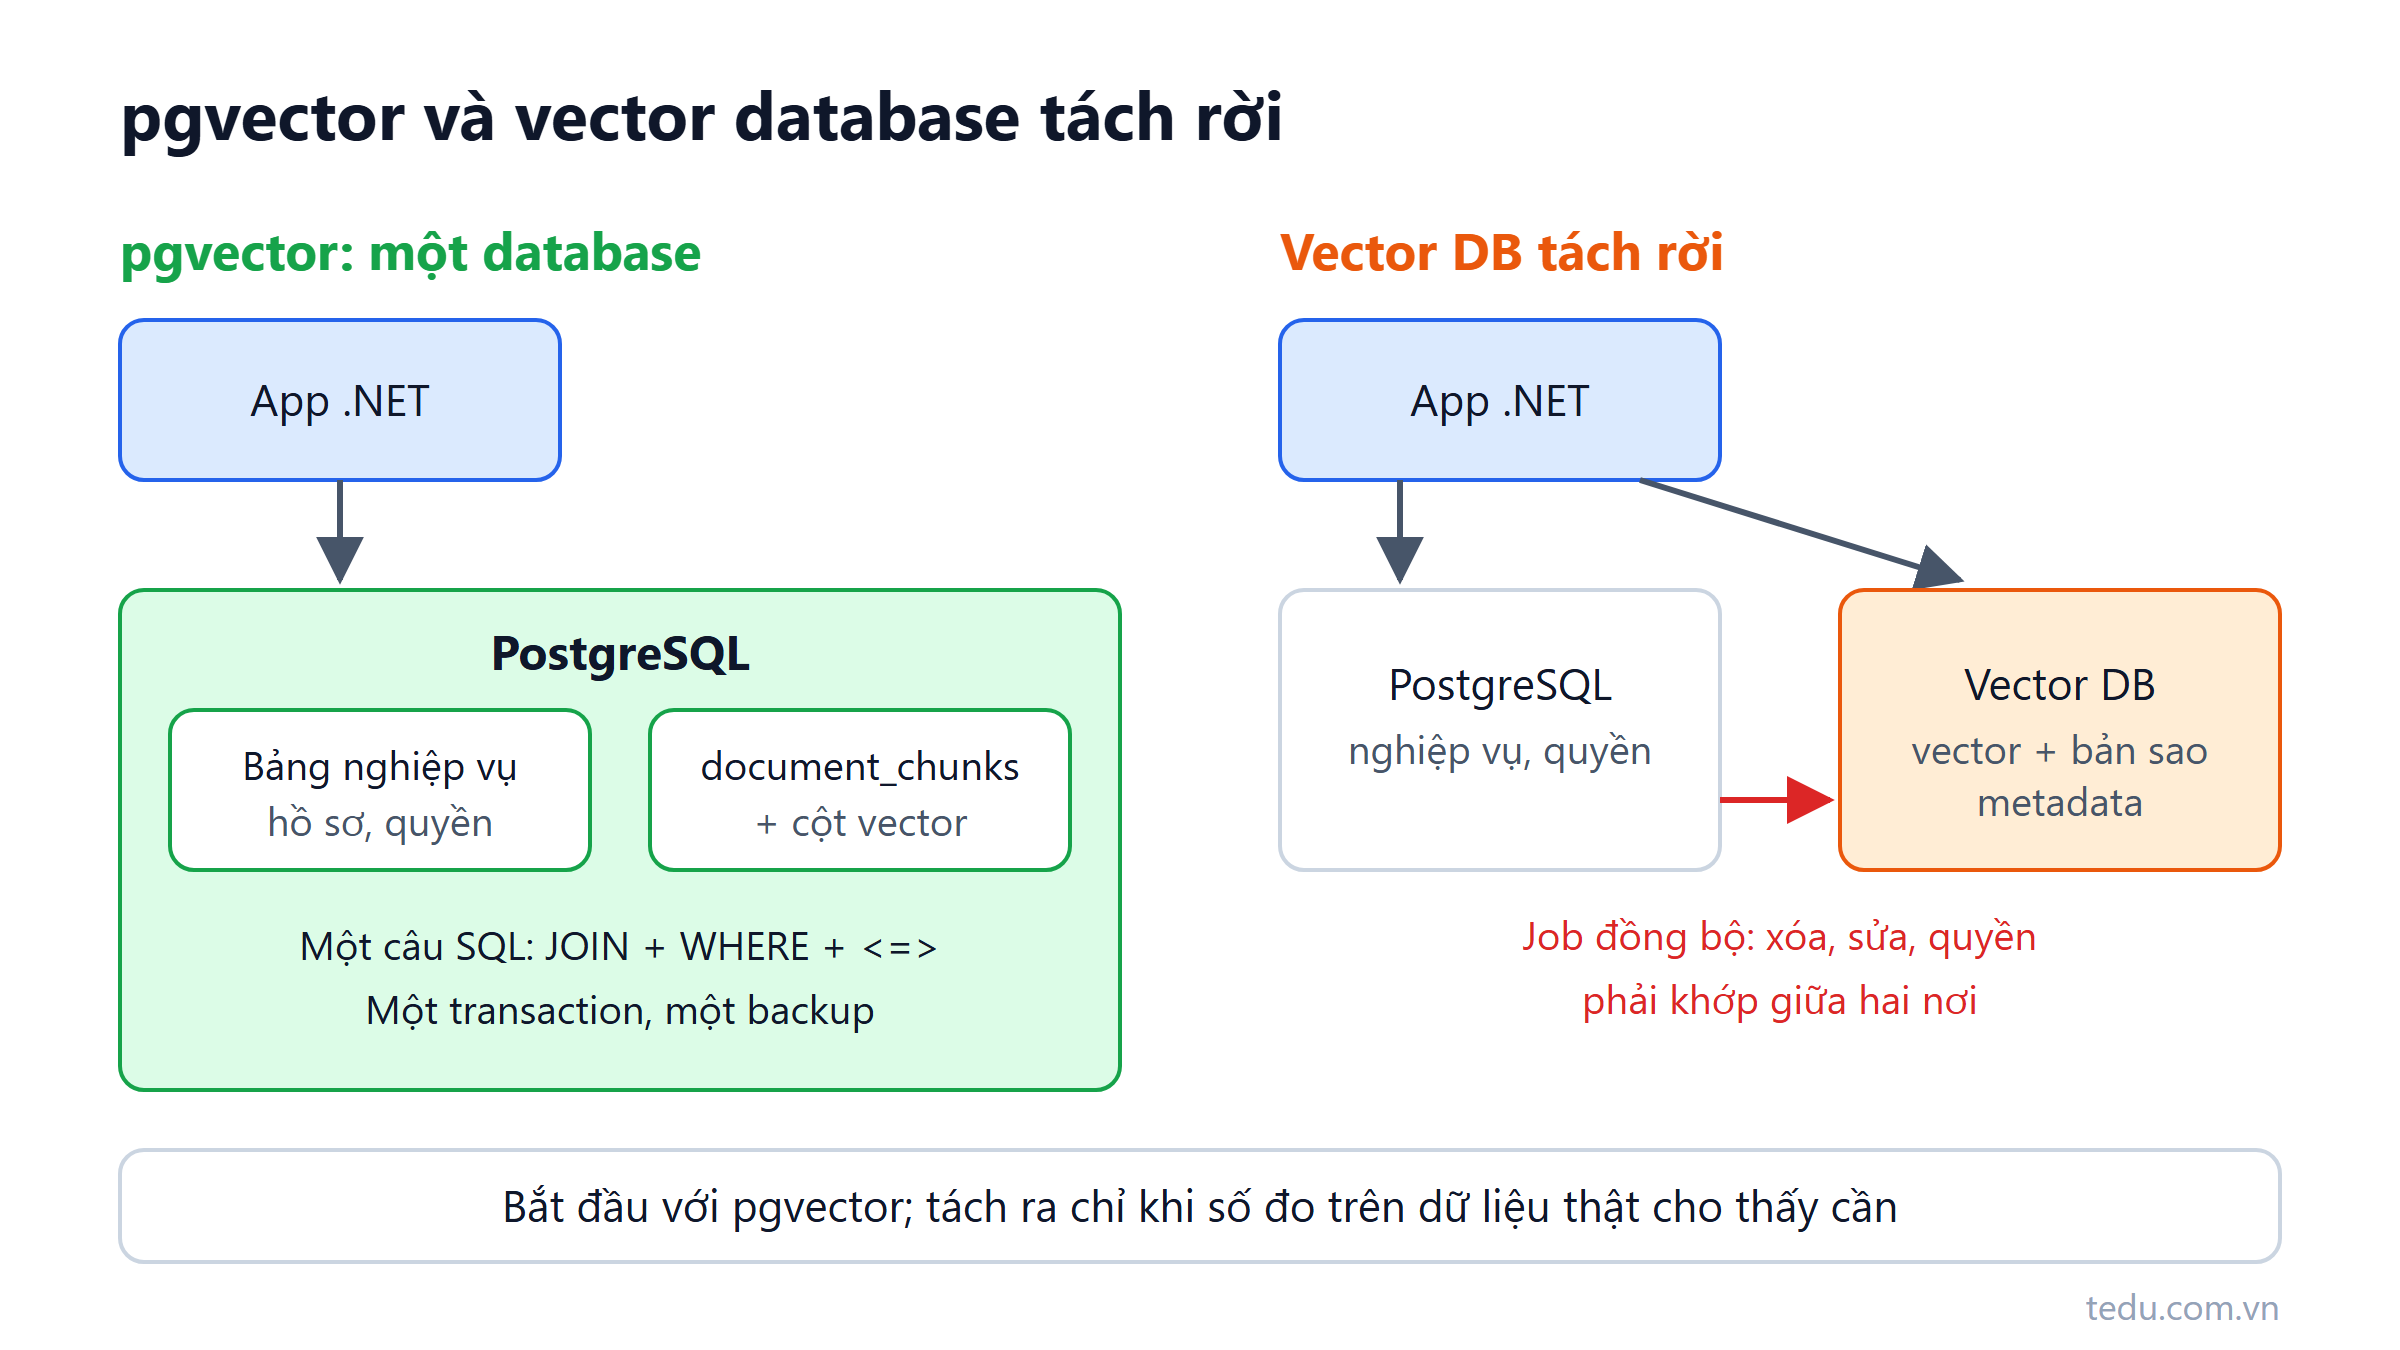
pgvector: vì sao PostgreSQL thường đủ làm vector DB
pgvector biến PostgreSQL thành vector database cho RAG. Hướng dẫn SQL, C#, so sánh với vector DB chuyên dụng và khi nào pgvector không đủ.
Đọc thêm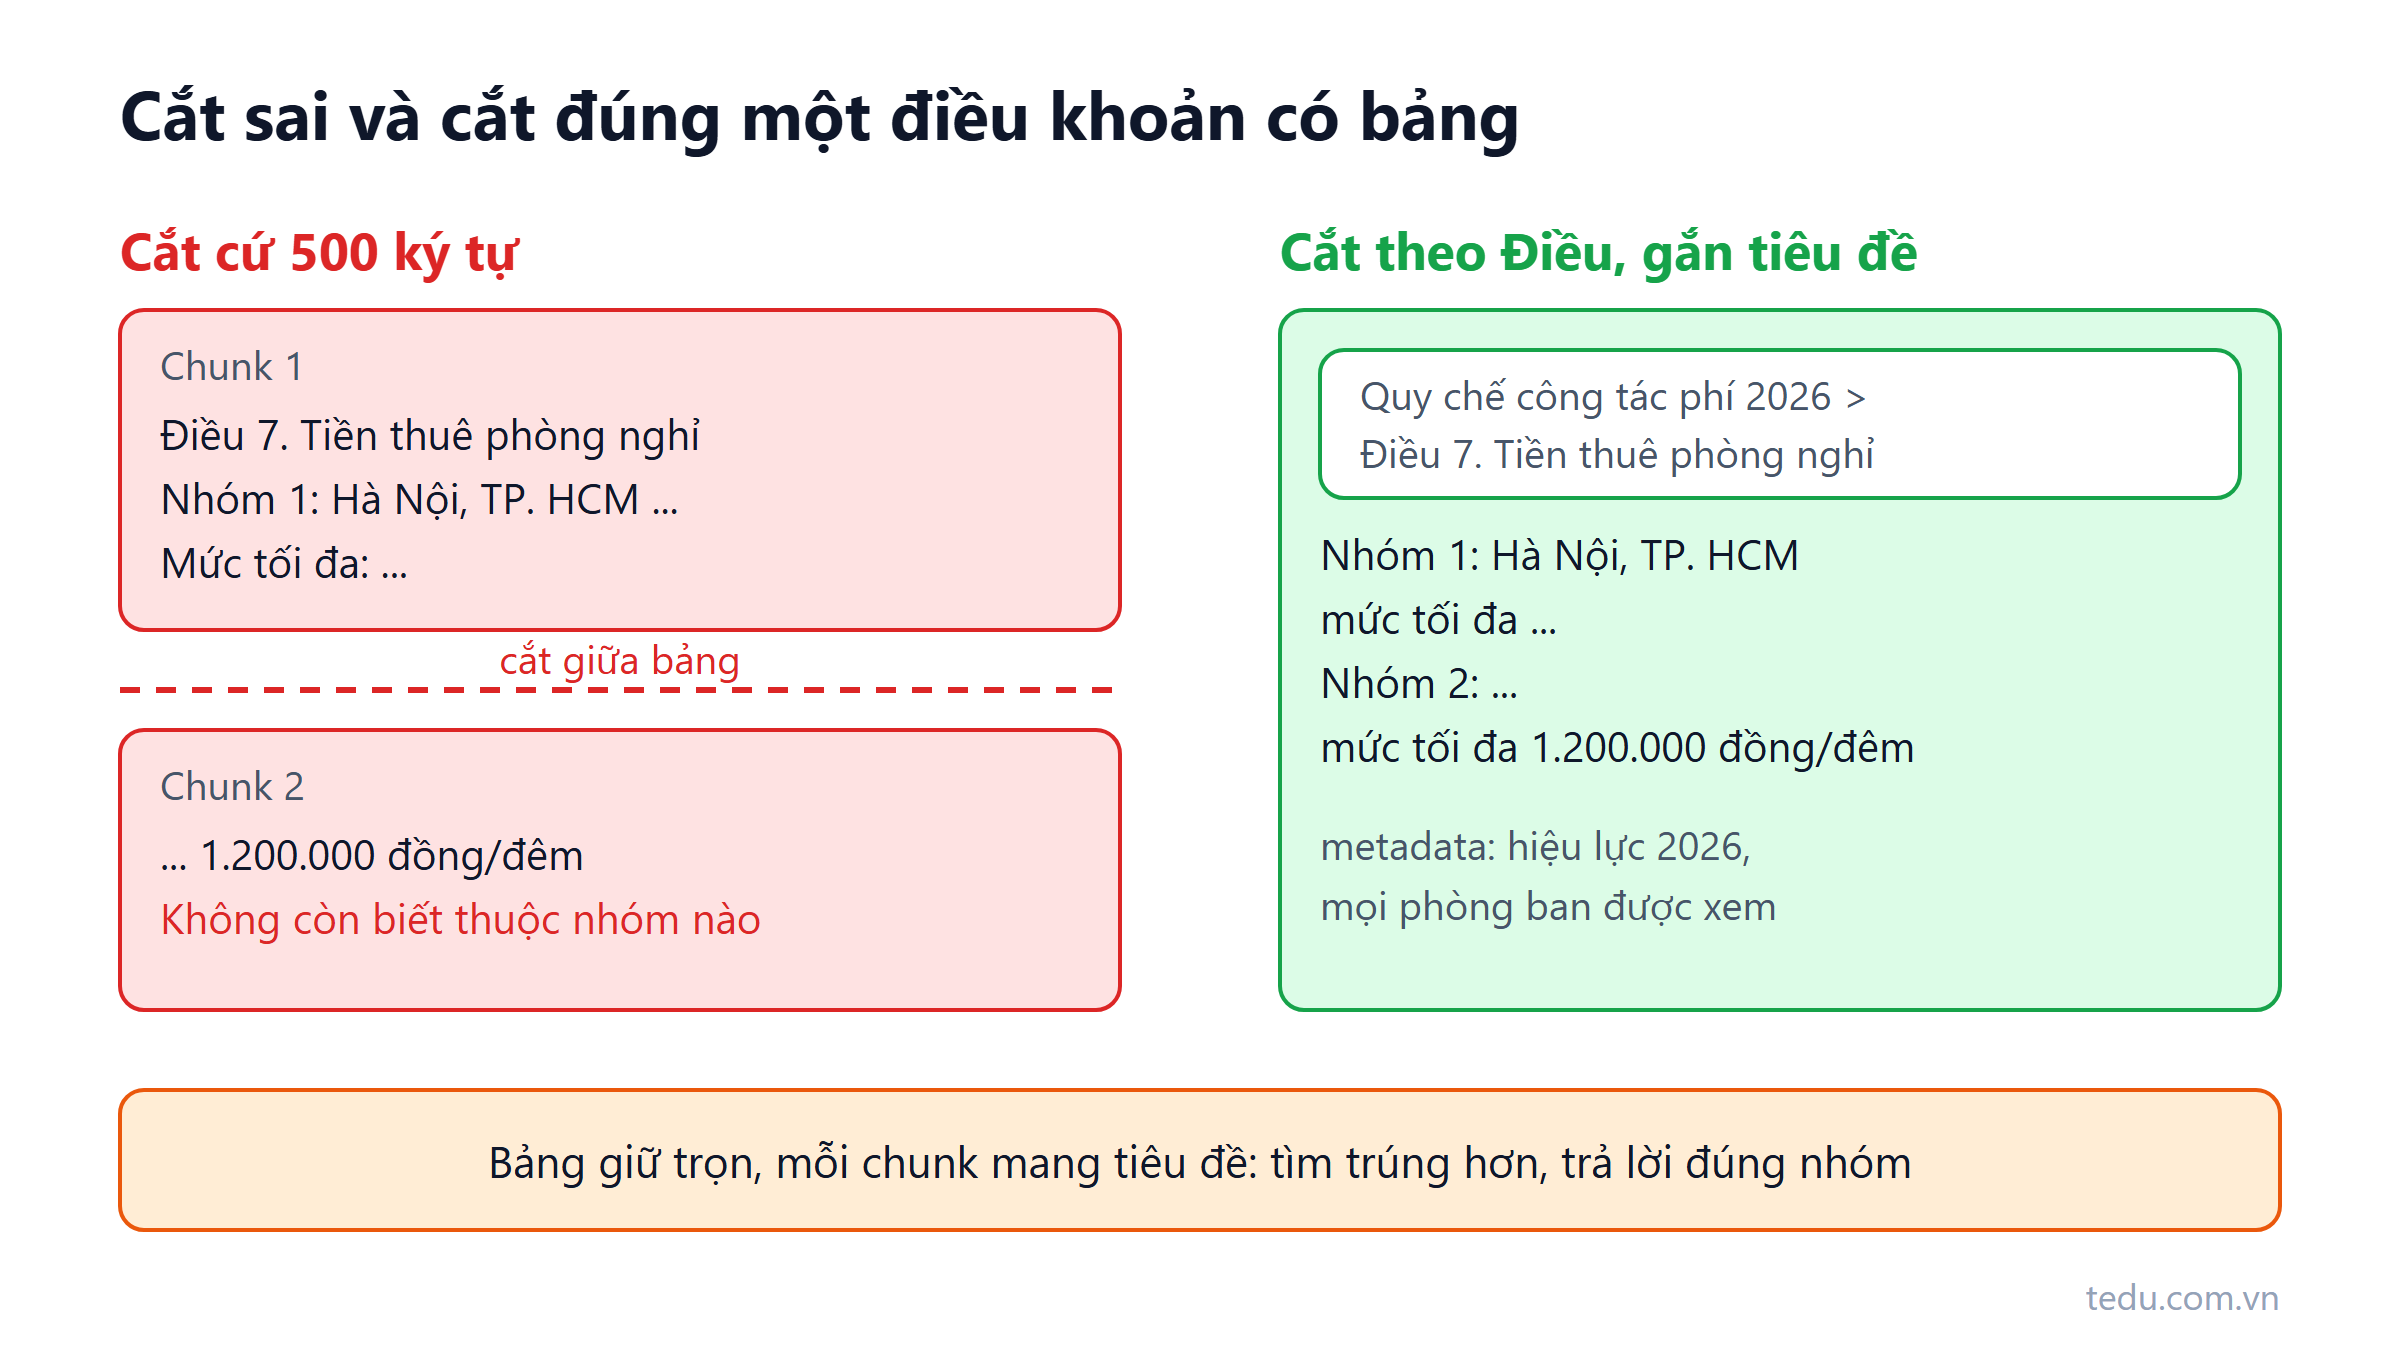
Chunking trong RAG: cắt tài liệu sai thì kết quả hỏng
Chunking là bước cắt tài liệu thành đoạn nhỏ trước khi đưa vào RAG. Bài so sánh các cách chunking, ví dụ với quy chế tiếng Việt và code C# cắt theo Điều, Khoản.
Đọc thêm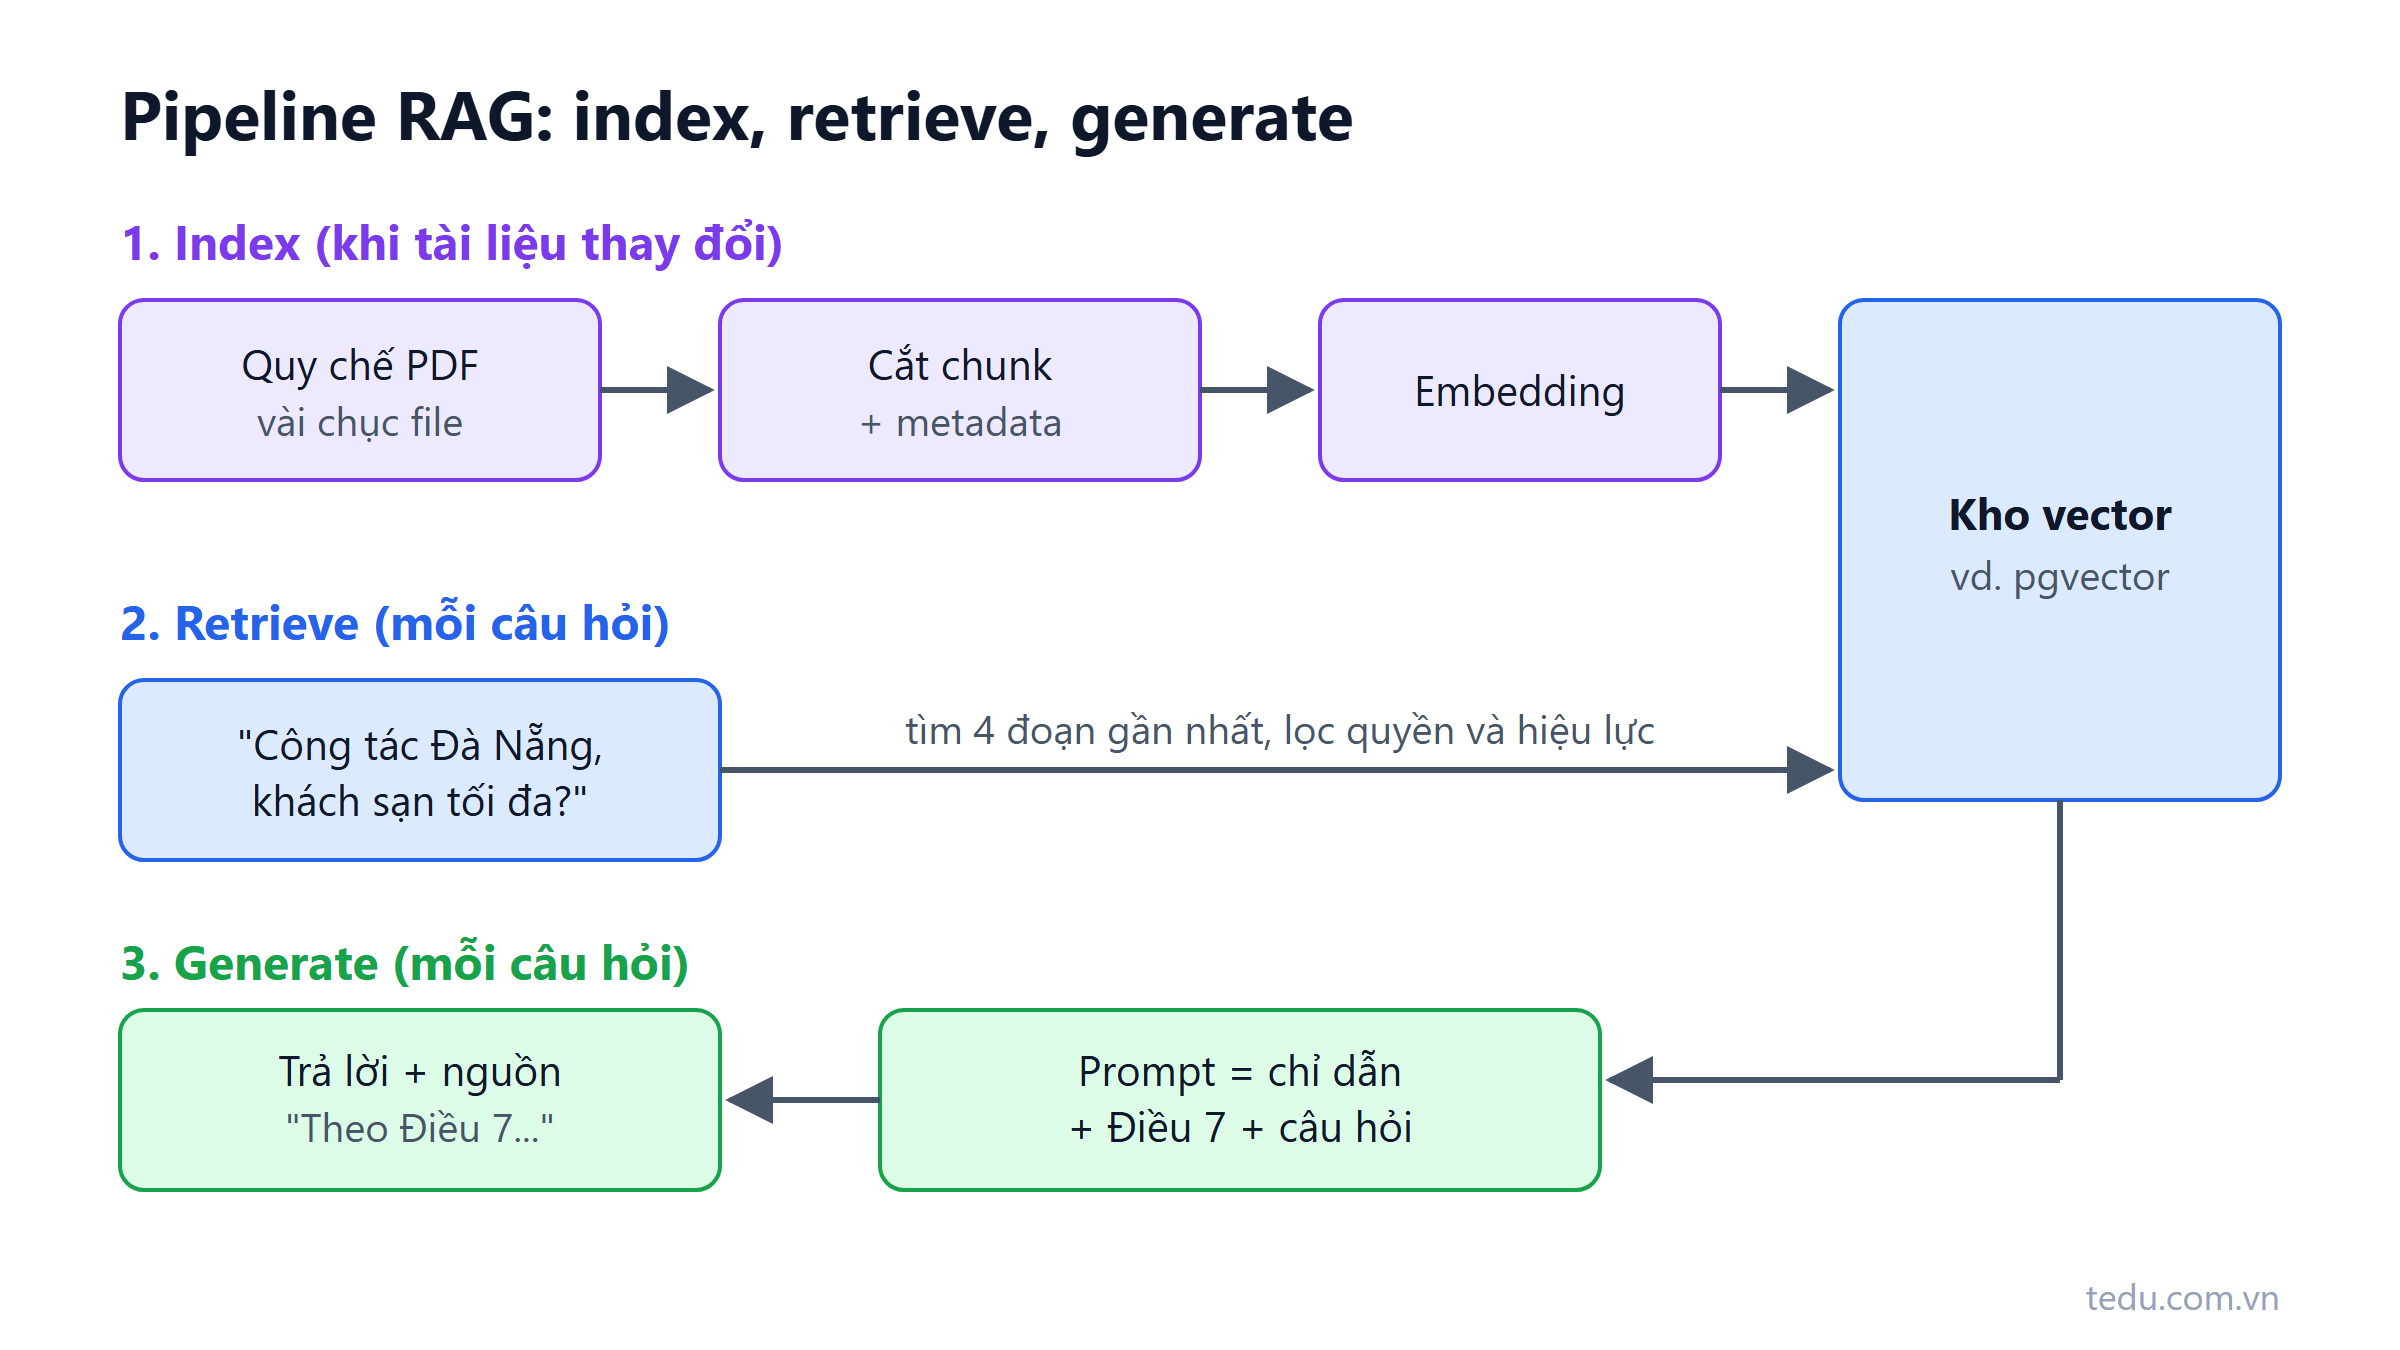
RAG là gì? Khi nào cần và khi nào không cần
RAG là cách đưa đúng đoạn tài liệu vào prompt để model trả lời theo dữ liệu thật. Bài này giải thích pipeline và khi nào bạn không cần RAG.
Đọc thêm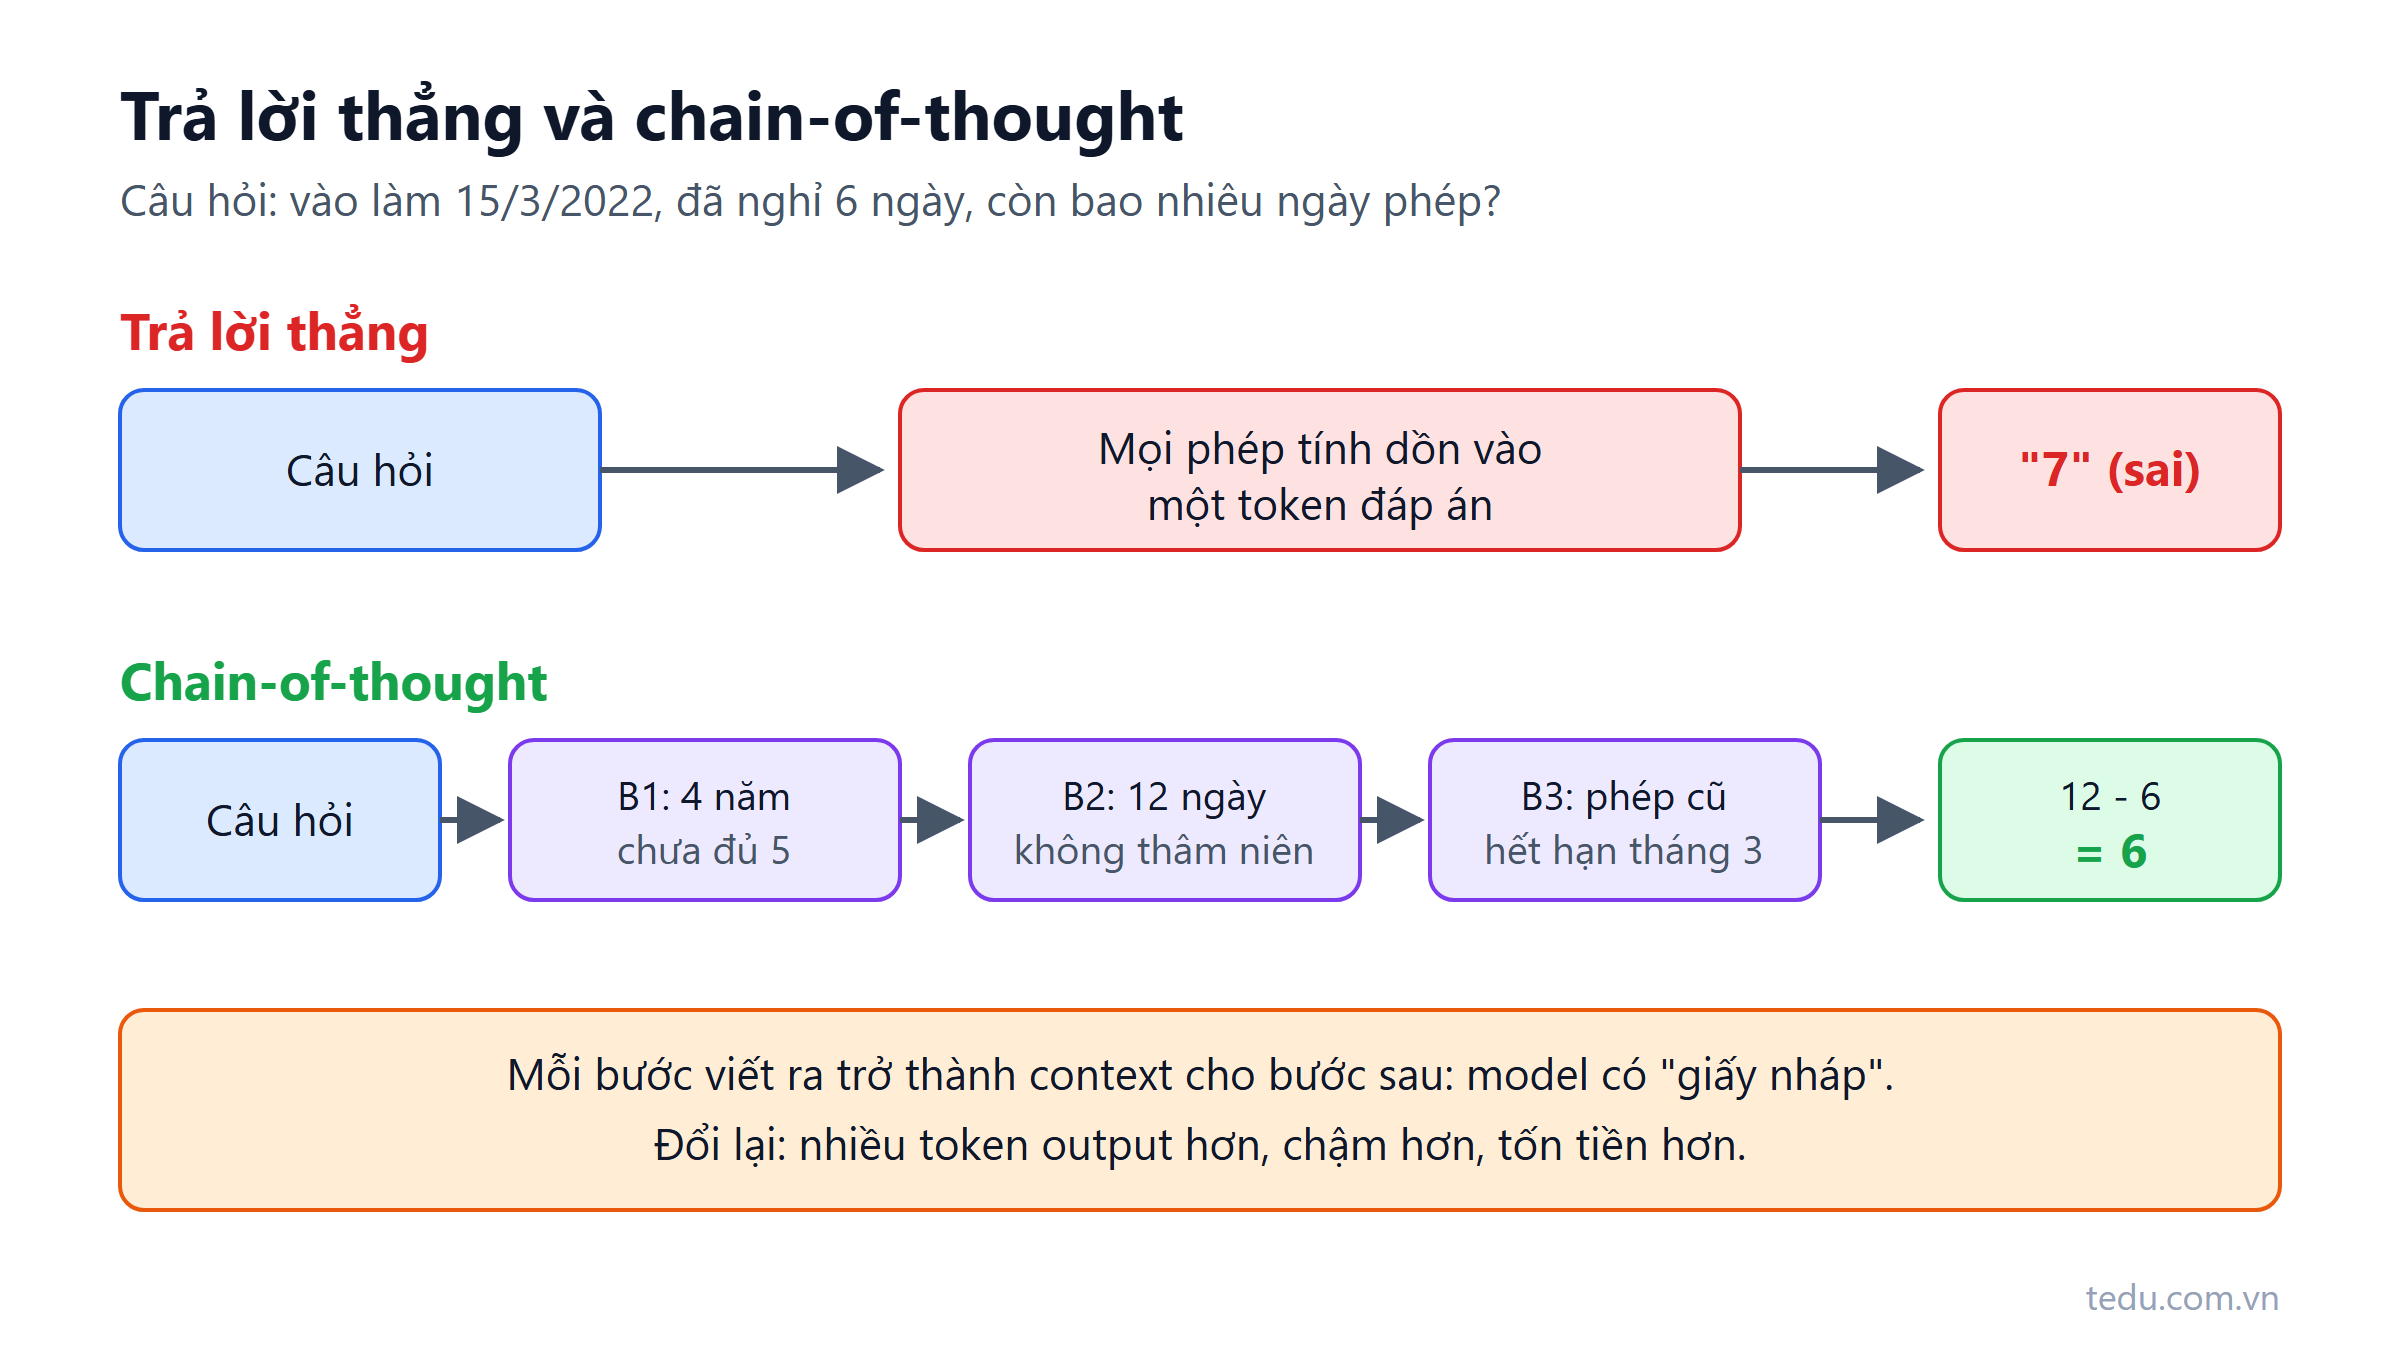
Chain-of-thought: cho model suy nghĩ trước khi trả lời
Chain-of-thought là cho model viết các bước suy luận trước khi chốt đáp án. Bài giải thích vì sao nó hiệu quả, khi nào nên dùng và cách dùng trong production.
Đọc thêm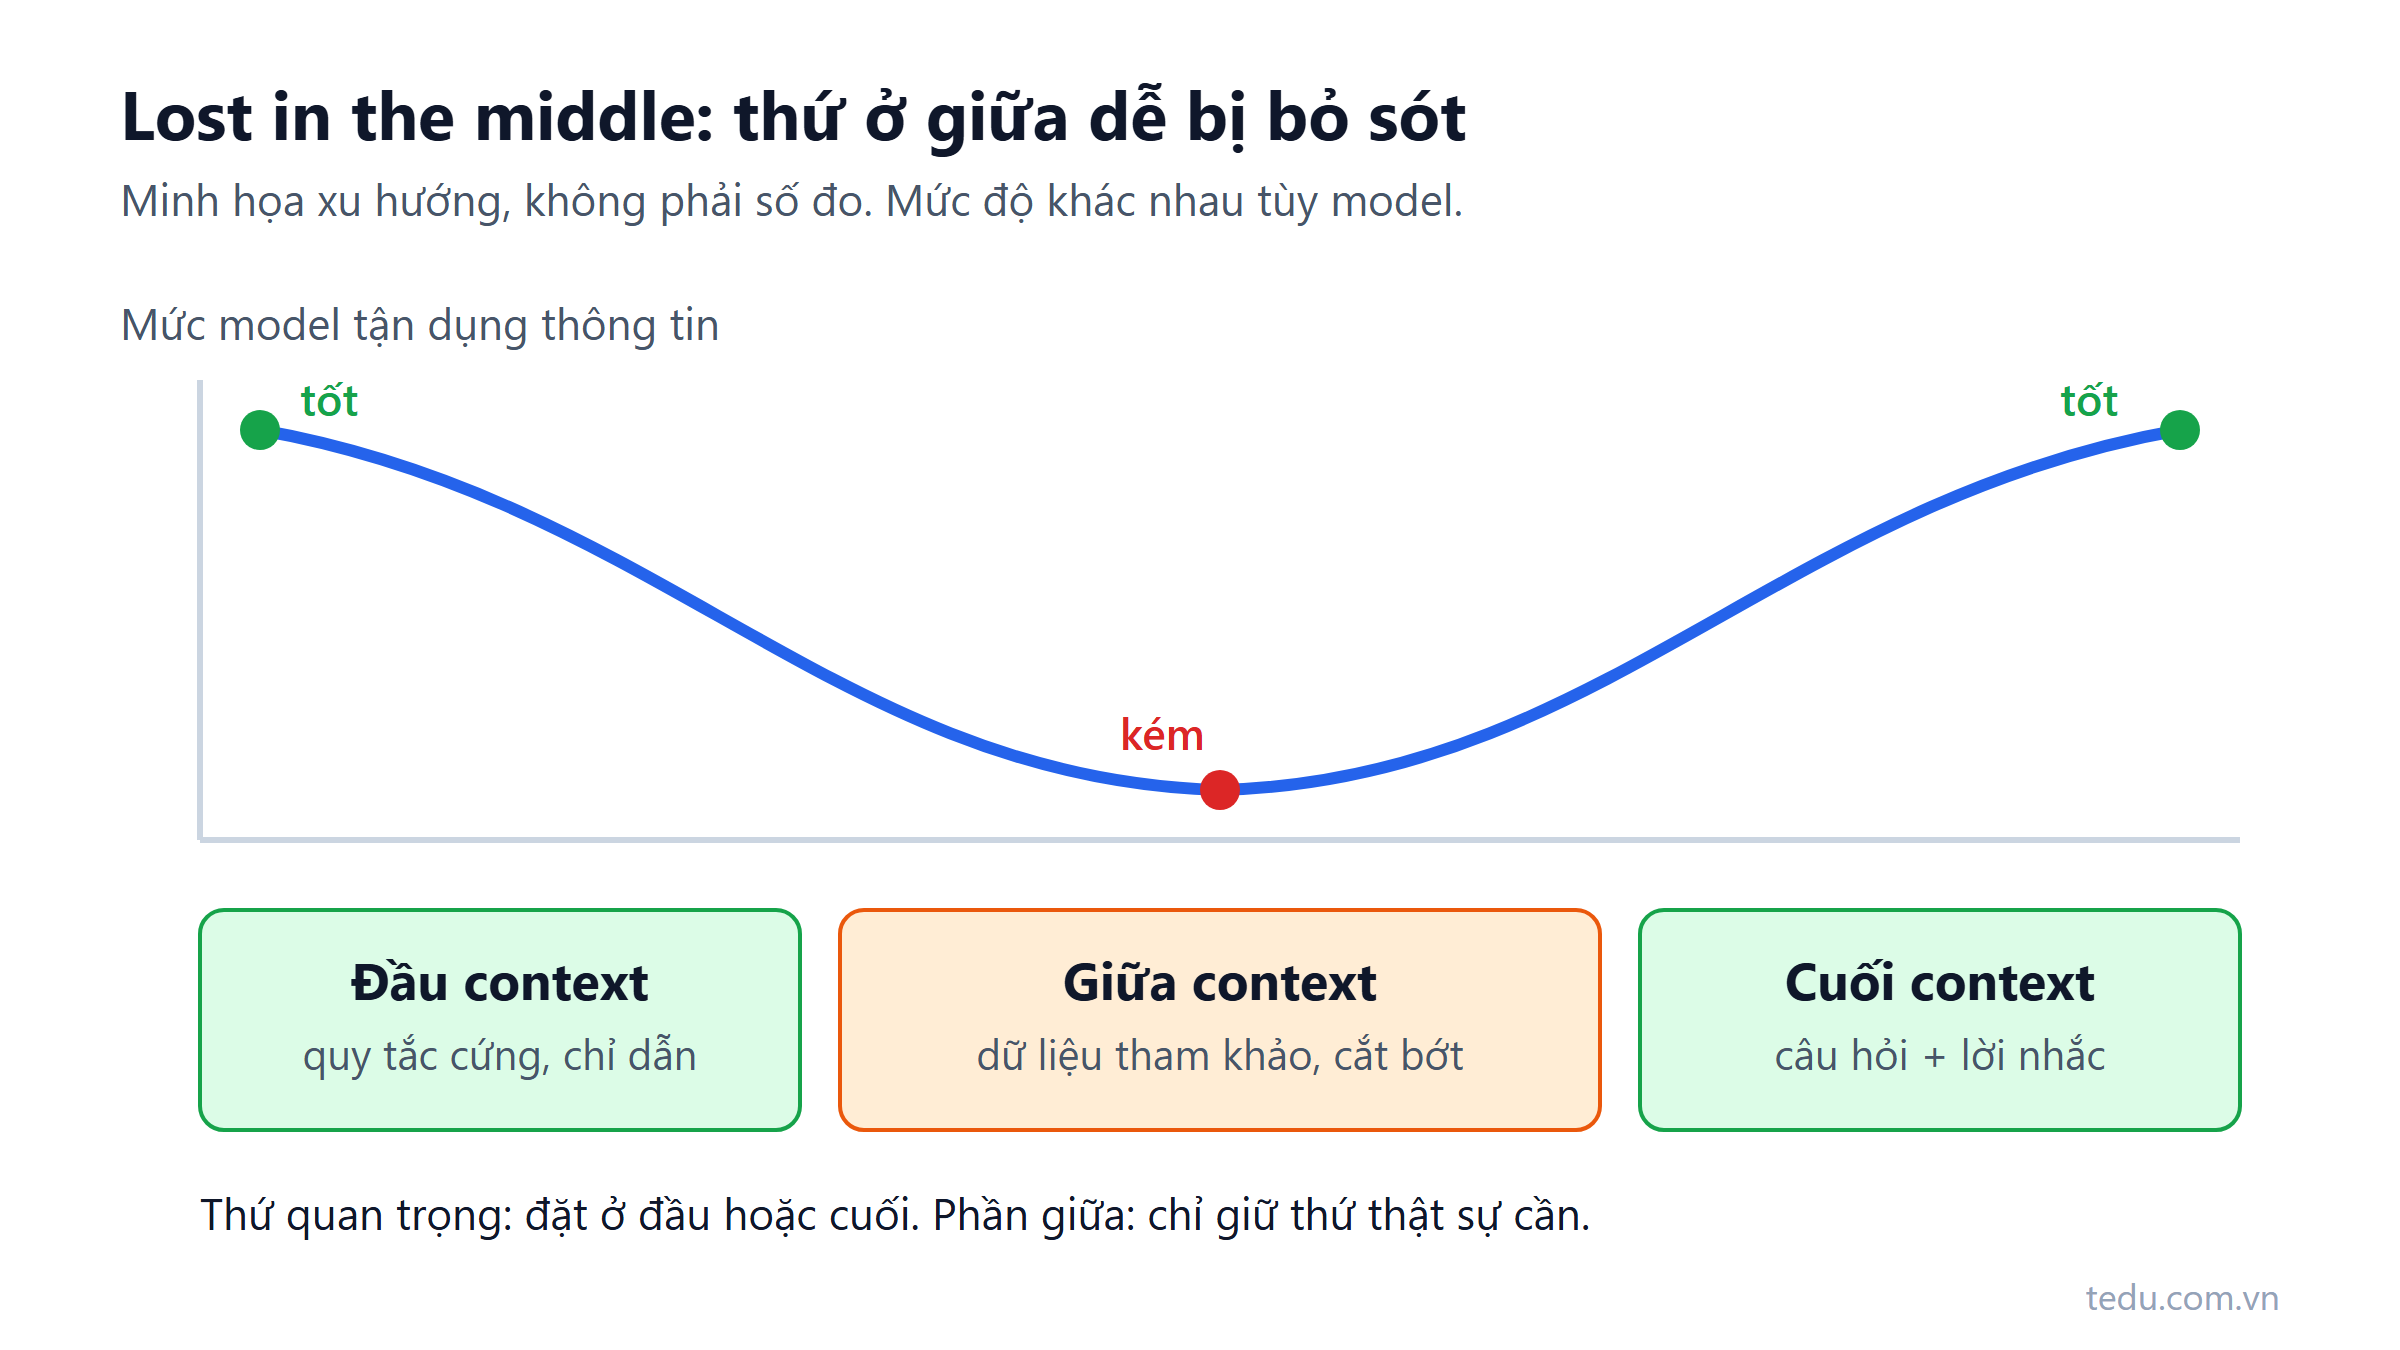
Vì sao nhồi nhiều context lại làm model kém đi
Context window lớn không có nghĩa là nhồi càng nhiều càng tốt. Bài giải thích vì sao model trả lời kém đi khi context dài và cách chọn lọc context đúng.
Đọc thêm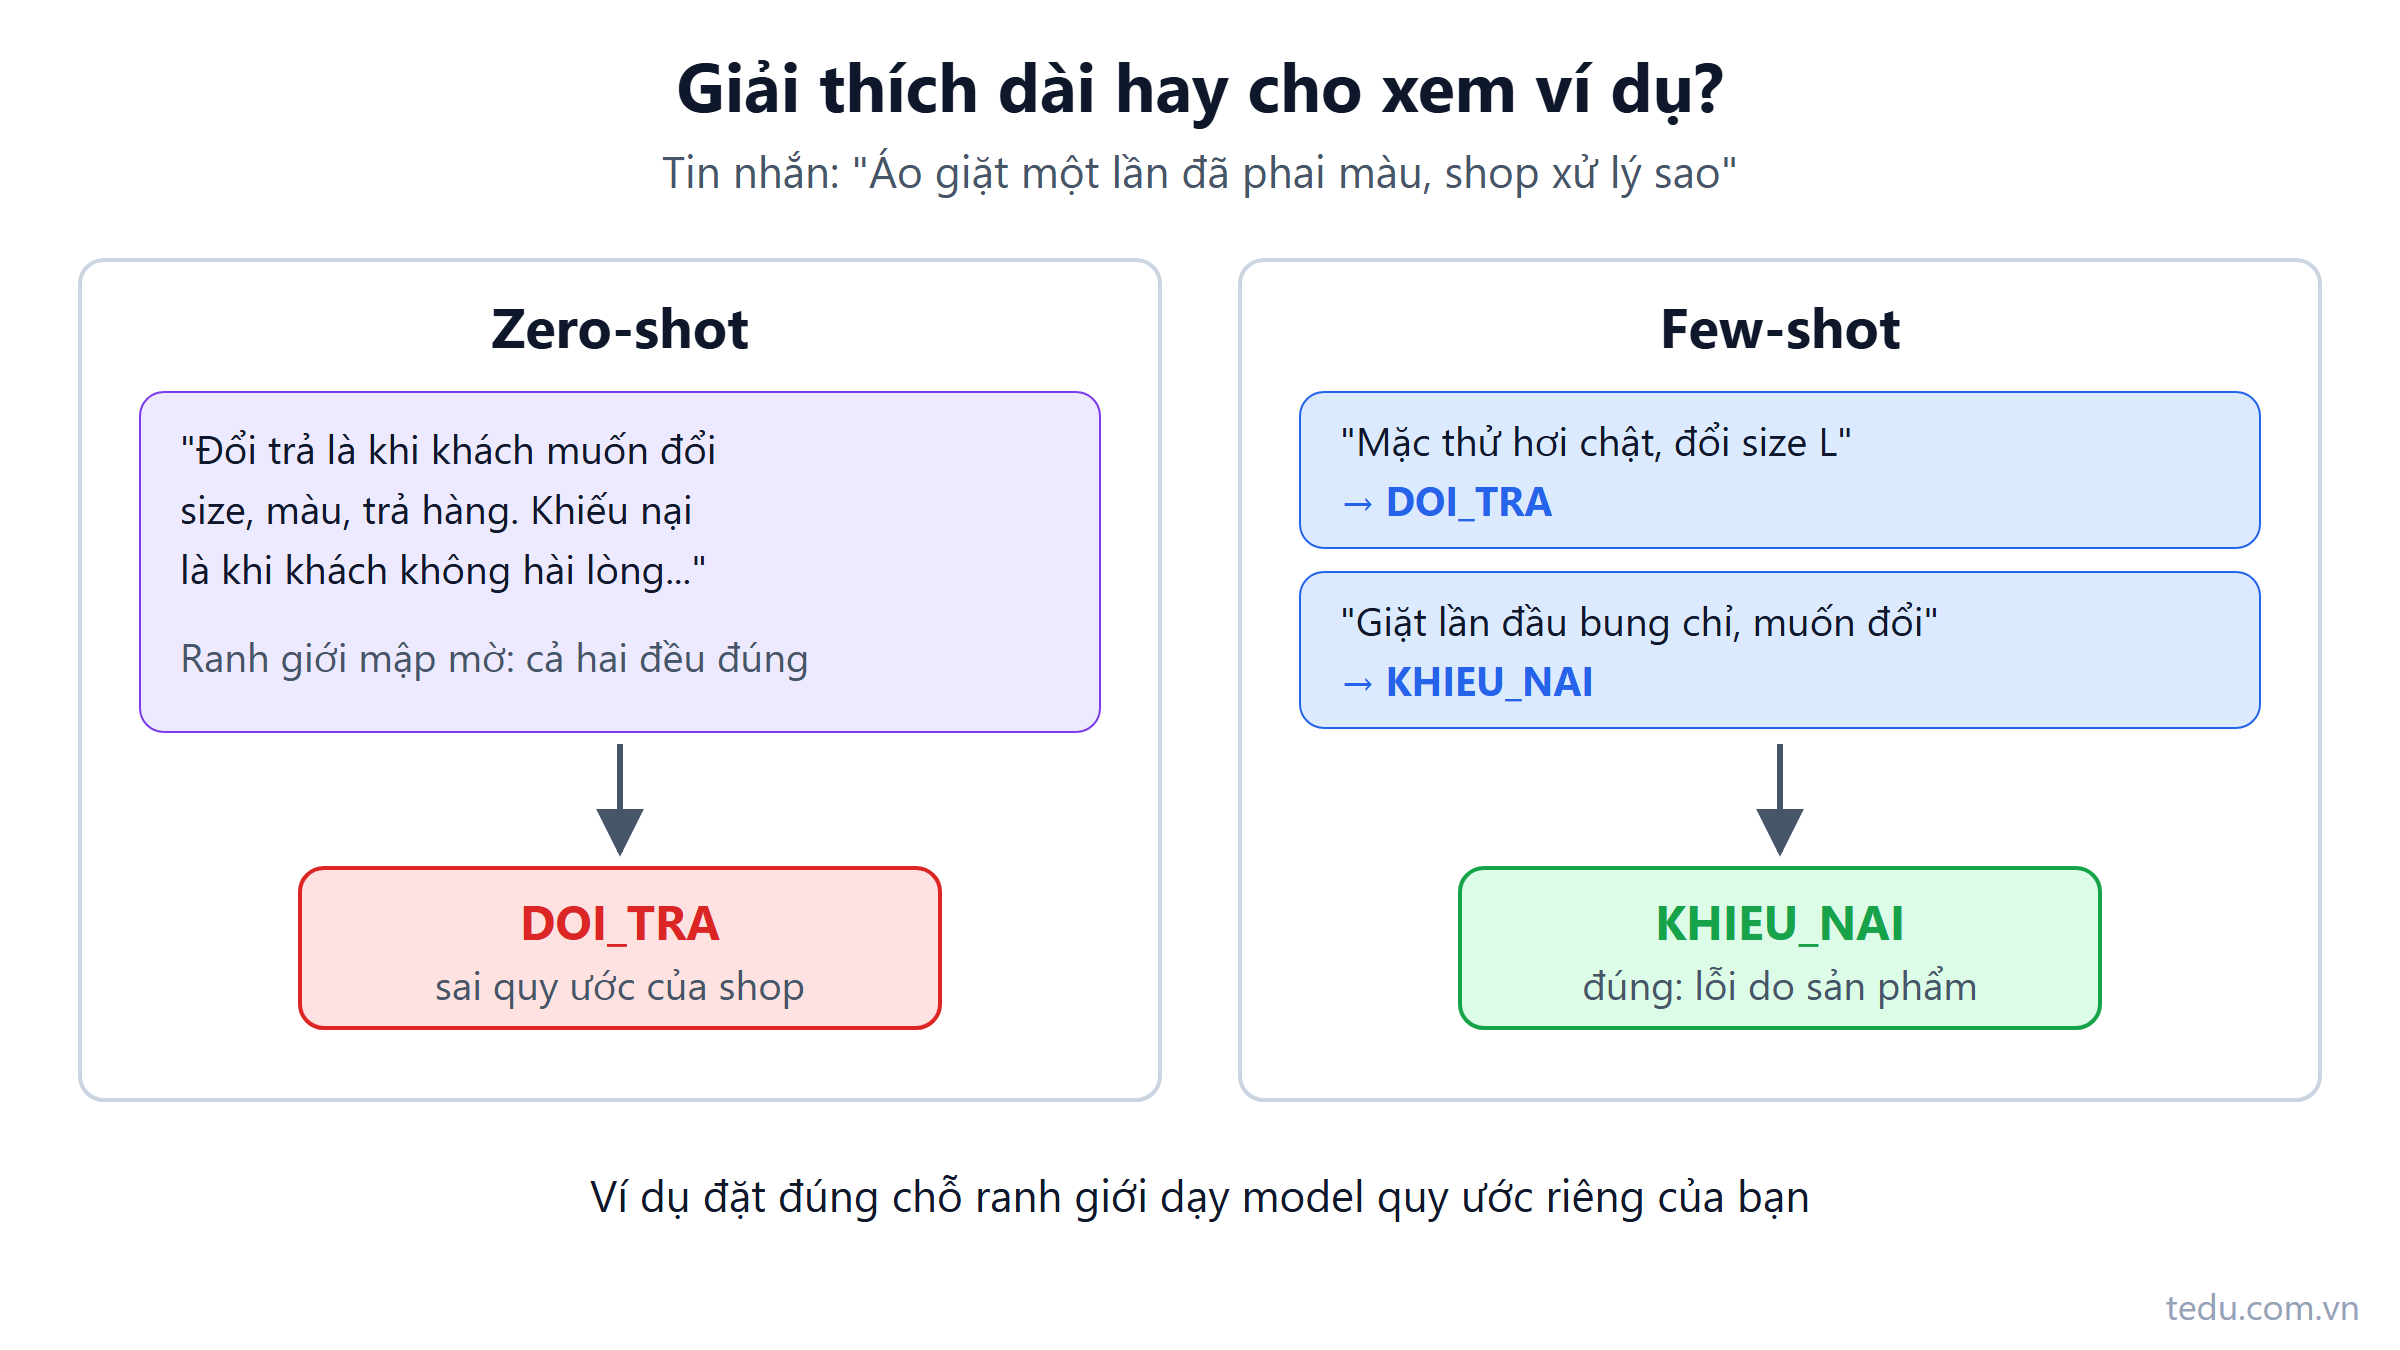
Few-shot prompting: cho LLM ví dụ thay vì giải thích dài dòng
Few-shot prompting là đưa vài ví dụ đầu vào và đầu ra mẫu để LLM bắt chước. Bài chỉ cách chọn ví dụ, lỗi hay gặp và few-shot động bằng C#.
Đọc thêm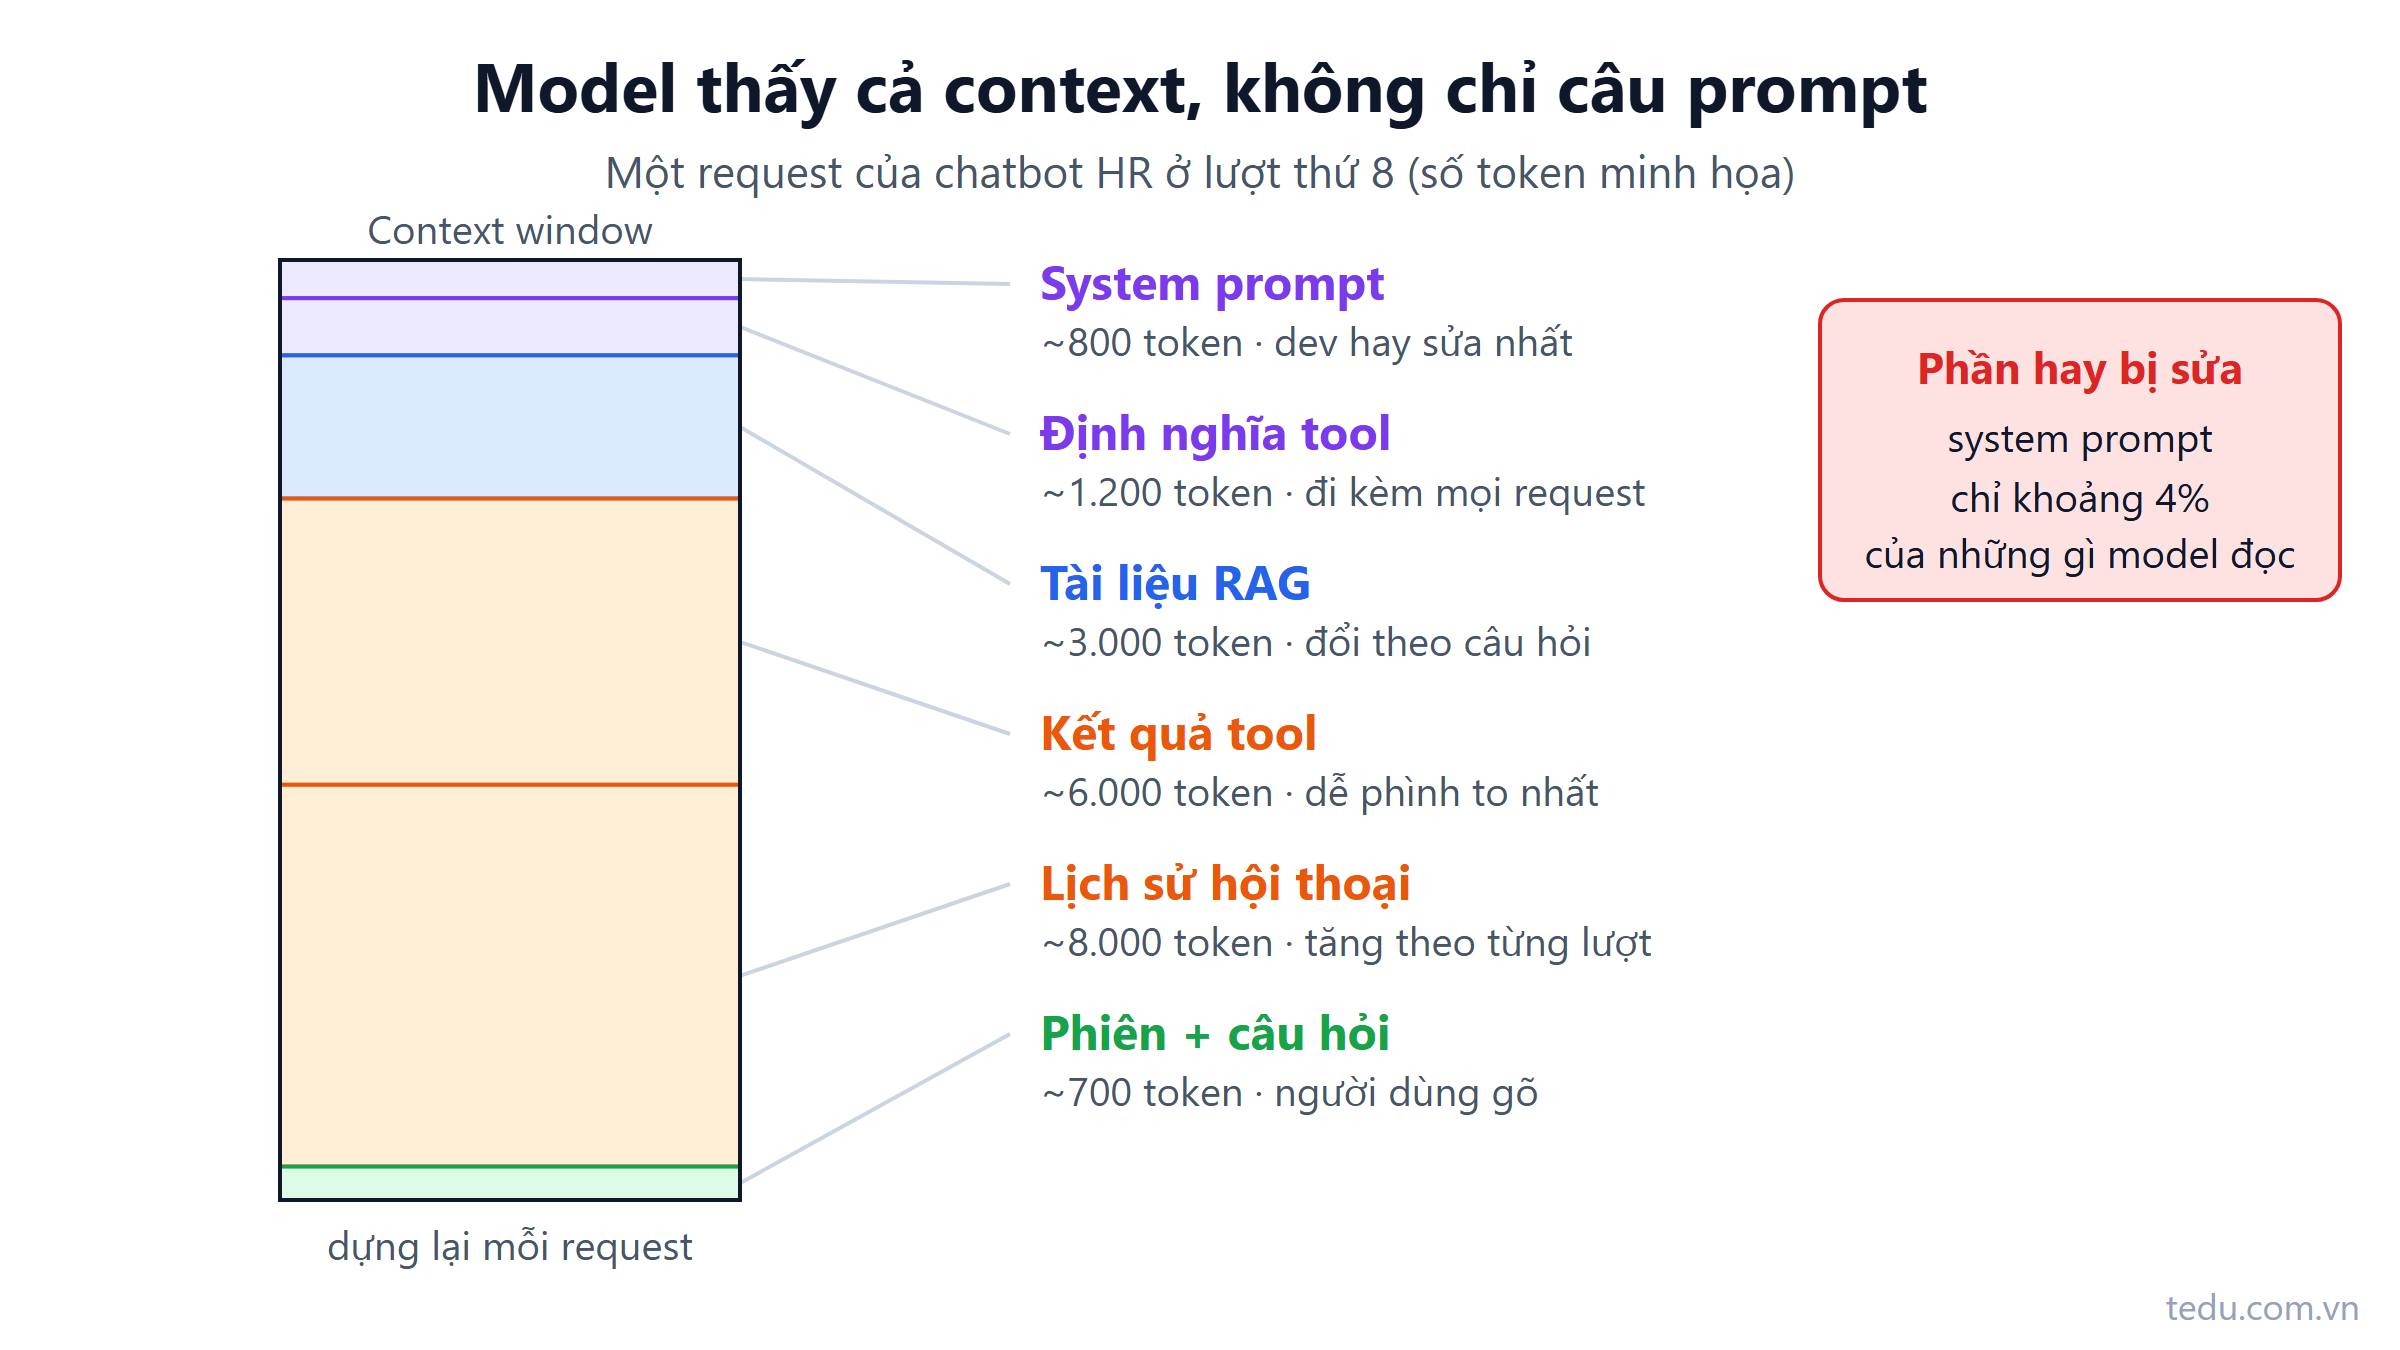
Context engineering là gì, vì sao quan trọng hơn prompt
Context engineering là quyết định cái gì vào context window, cái gì phải ra, theo thứ tự nào. Câu prompt chỉ là một phần nhỏ của những gì model thấy.
Đọc thêm