

Reranking trong RAG: bước bị bỏ qua nhiều nhất
Một shop thời trang online dựng chatbot CSKH bằng RAG trên bộ chính sách đổi trả. Khách hỏi: "Hàng mua trong đợt sale có được đổi size không?". Vector search trả về 5 đoạn, đoạn đứng đầu là "Chính sách đổi trả áp dụng trong 7 ngày kể từ khi nhận hàng". Nghe rất liên quan. Chỉ có điều đoạn trả lời đúng ("Sản phẩm giảm giá từ 50% trở lên chỉ được đổi size, không hoàn tiền") nằm ở vị trí thứ 14, không bao giờ được đưa vào prompt.
Model trả lời: "Dạ được ạ, trong vòng 7 ngày". Khách đổi, kho từ chối, khách đánh giá 1 sao. Lỗi không nằm ở model, cũng không hẳn ở vector search. Lỗi nằm ở chỗ pipeline thiếu một bước: reranking.
Bài này giải thích reranking trong RAG là gì, vì sao nó là bước bị bỏ qua nhiều nhất, và cách thêm nó vào pipeline mà không làm hệ thống chậm đi đáng kể.
Vì sao vector search trả về đoạn "gần nghĩa" nhưng sai ý
Nhắc lại cách tìm kiếm trong RAG: mỗi đoạn tài liệu được biến thành một vector từ trước, câu hỏi cũng được biến thành vector, rồi hệ thống lấy các đoạn có vector gần nhất. Mô hình làm việc này gọi là bi-encoder: câu hỏi và tài liệu được mã hóa riêng rẽ, không bao giờ "nhìn thấy nhau".
Cách này nhanh vì vector tài liệu tính sẵn một lần, lúc truy vấn chỉ còn phép so khoảng cách. Nhưng cái giá là độ tinh. Một vector vài trăm hay vài nghìn chiều phải nén cả đoạn văn thành một điểm, nên nó giữ được "chủ đề" nhưng hay đánh rơi chi tiết quyết định:
"Hàng sale có được đổi size không?" và "Chính sách đổi trả 7 ngày" cùng chủ đề đổi trả, nên gần nhau.
Chữ "sale" và điều kiện "giảm từ 50%" là chi tiết quyết định câu trả lời, nhưng trọng số của nó trong vector rất nhỏ.
Phủ định cũng hay bị nuốt: "được hoàn tiền" và "không được hoàn tiền" có vector rất giống nhau.
Nói cách khác, vector search giỏi trả lời câu "đoạn nào nói về chuyện này", nhưng kém ở câu "đoạn nào trả lời đúng câu hỏi này". Hai câu đó khác nhau hơn bạn tưởng. Hybrid search giúp bắt thêm từ khóa như "sale", mã sản phẩm, số hiệu điều khoản, nhưng thứ tự cuối cùng vẫn là trộn điểm của hai cách tìm, chưa có ai thật sự đọc câu hỏi cạnh từng đoạn.
Reranking là gì: đọc lại từng cặp câu hỏi và đoạn văn
Reranker là một mô hình nhận vào một cặp (câu hỏi, đoạn văn) và trả về một điểm: đoạn này trả lời câu hỏi tốt đến đâu. Dạng phổ biến nhất là cross-encoder: câu hỏi và đoạn văn được ghép lại, đi qua mô hình cùng lúc, nên mô hình nhìn được quan hệ giữa từng từ của câu hỏi với từng từ của đoạn văn.
| Tiêu chí | Bi-encoder (vector search) | Cross-encoder (reranker) |
|---|---|---|
| Cách mã hóa | Câu hỏi và tài liệu tách riêng | Câu hỏi và đoạn văn ghép chung |
| Tính trước được không | Có, vector tài liệu lưu sẵn trong DB | Không, phải chạy lại cho mỗi câu hỏi |
| Tốc độ trên hàng triệu đoạn | Nhanh, có index | Không khả thi |
| Độ chính xác thứ tự | Khá, theo chủ đề | Tốt hơn rõ, theo ý câu hỏi |
| Vai trò trong pipeline | Lọc rộng (recall) | Chọn tinh (precision) |
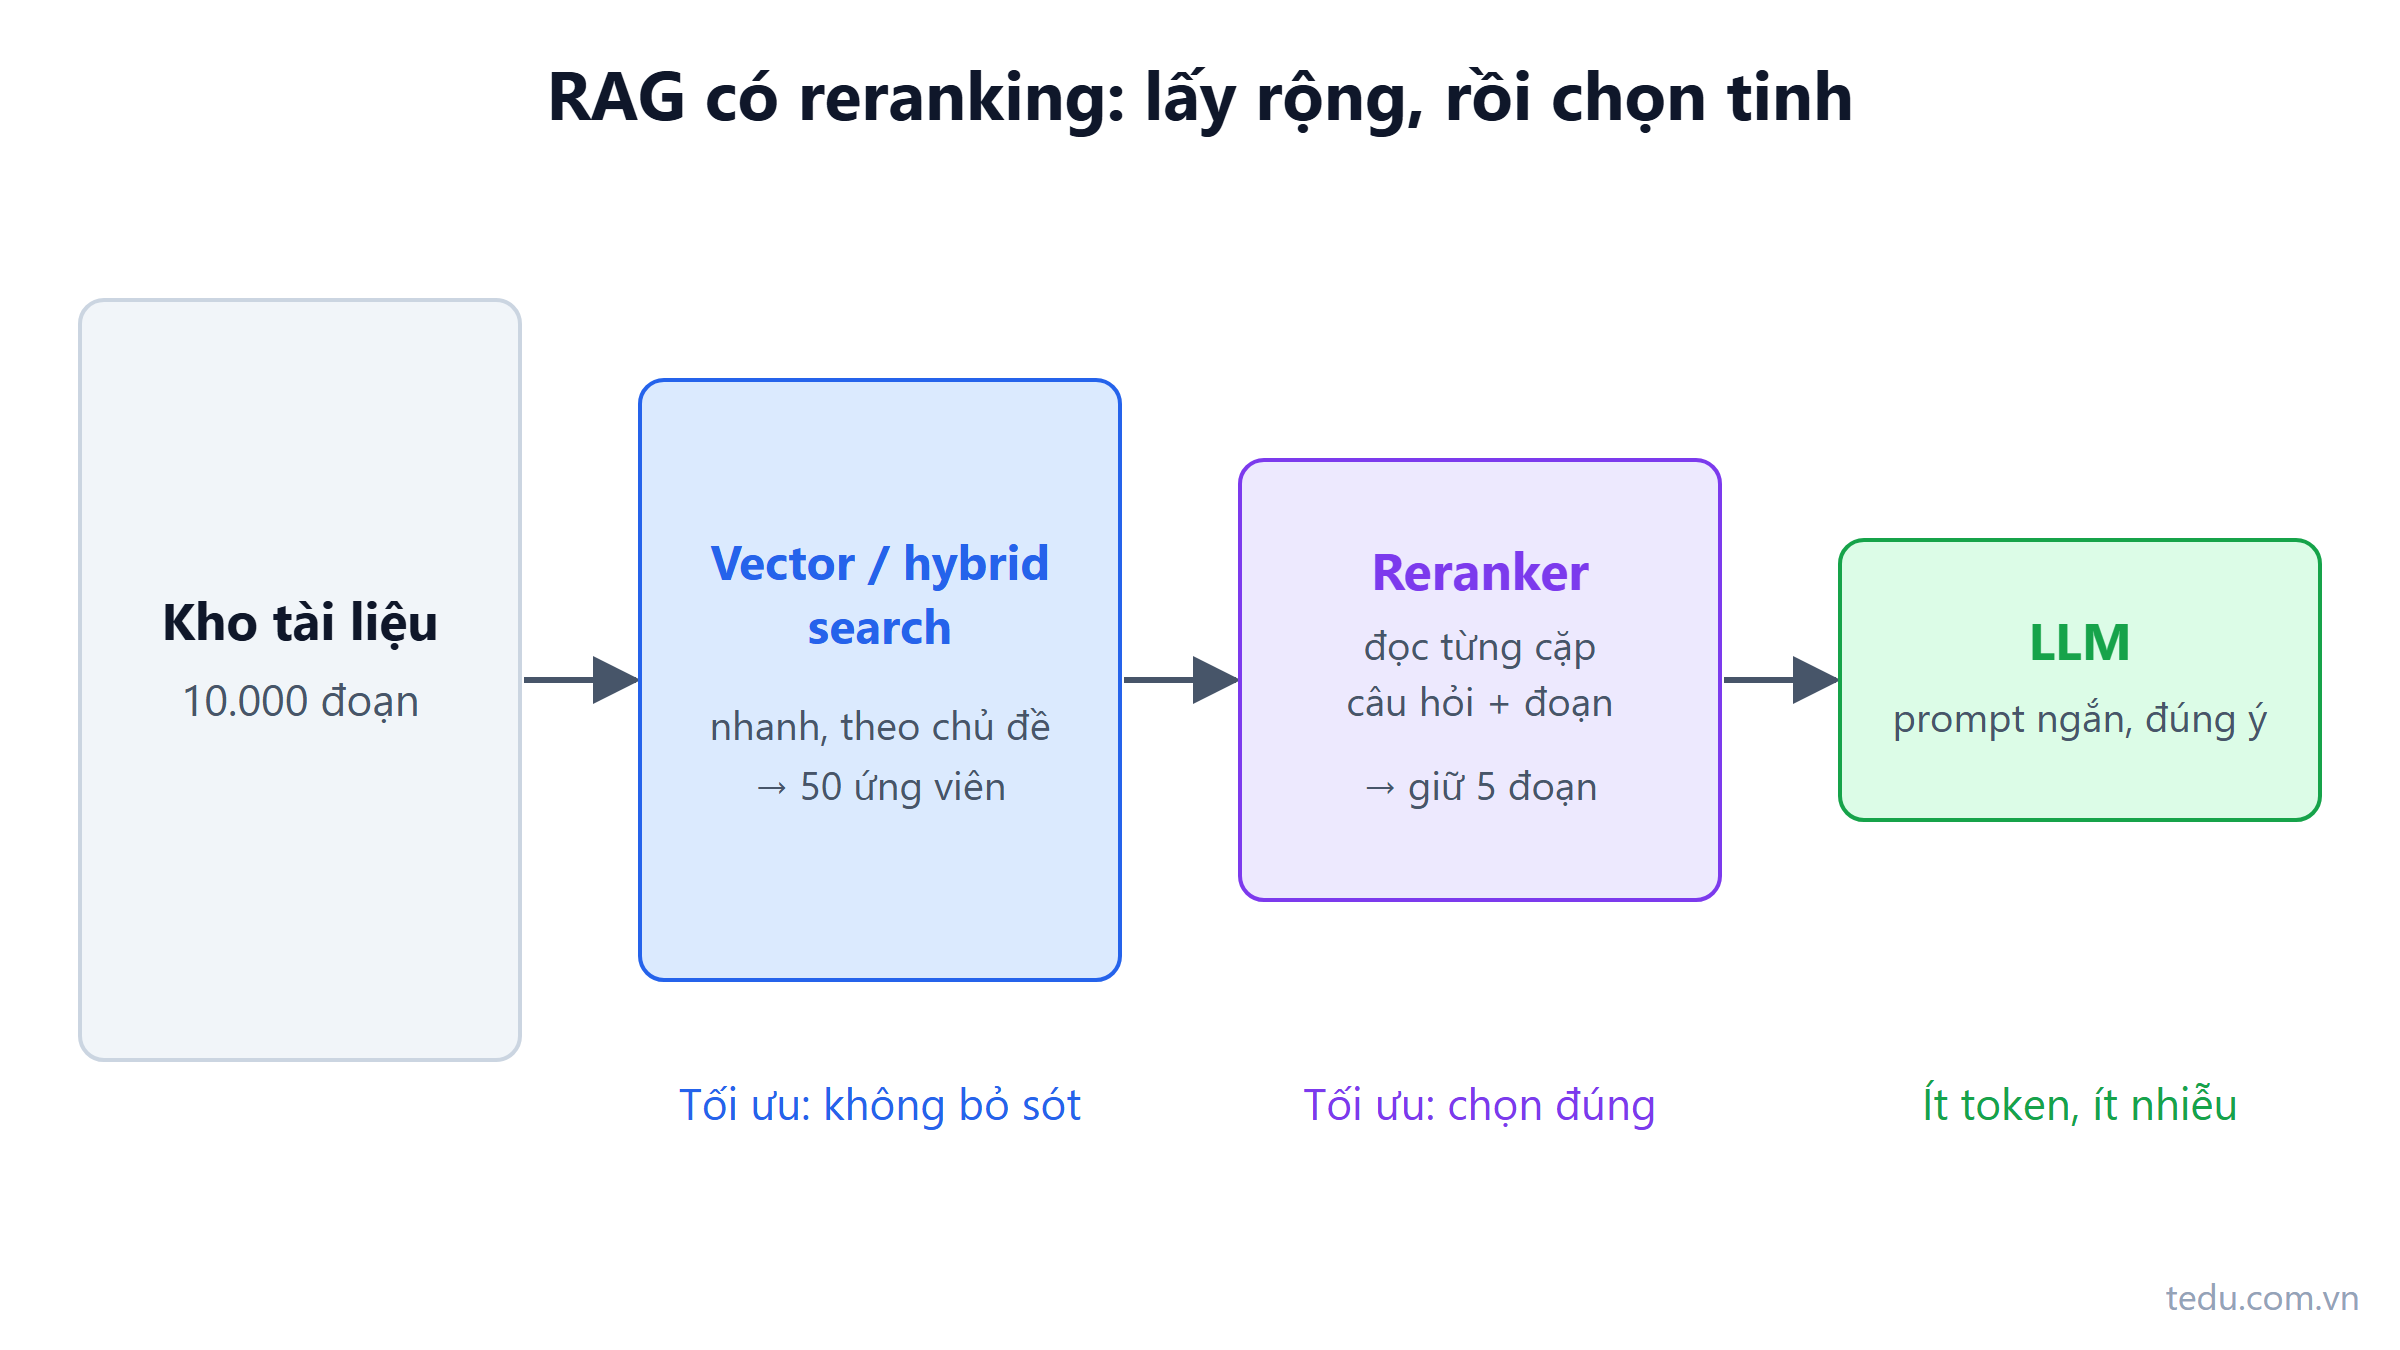
Vì cross-encoder phải chạy cho từng cặp, bạn không thể dùng nó tìm trên cả kho. Nên pipeline chuẩn có hai tầng: vector search (hoặc hybrid) lấy rộng, khoảng 30–100 ứng viên; reranker chấm lại các ứng viên đó và giữ 3–8 đoạn tốt nhất đưa vào prompt. Các con số này là điểm khởi đầu hợp lý, không phải hằng số; bạn tinh chỉnh bằng bộ câu hỏi thật của mình.
Ví von cho dễ nhớ: vector search như bộ phận nhân sự lọc CV theo từ khóa, nhanh và hơi thô. Reranker là buổi phỏng vấn, chậm hơn nhiều, nên chỉ dành cho danh sách ngắn. Không ai phỏng vấn cả 5.000 hồ sơ, và cũng không ai tuyển người chỉ dựa vào việc CV có chữ "C#".
Gắn reranker vào pipeline RAG bằng C#
Có ba cách phổ biến để có reranker:
Gọi API rerank của nhà cung cấp. Một số nhà cung cấp model có endpoint rerank riêng: gửi câu hỏi và danh sách đoạn văn, nhận về điểm cho từng đoạn.
Tự host một mô hình cross-encoder mã nguồn mở sau một service nhỏ (thường là Python), app .NET gọi qua HTTP.
Dùng chính LLM làm reranker: đưa câu hỏi và danh sách đoạn văn có đánh số, yêu cầu trả về thứ tự. Đơn giản, không cần hạ tầng mới, nhưng tốn token và chậm hơn.
Dù chọn cách nào, phía .NET chỉ thấy một interface. Đoạn dưới đây là lớp bọc do bạn tự định nghĩa (tên mang tính minh họa), request gửi đi dạng JSON thô; tên field cụ thể (query, documents, top_n...) khác nhau giữa các nhà cung cấp, hãy đối chiếu tài liệu của bên bạn dùng:
public interface IReranker
{
    Task<IReadOnlyList<ScoredChunk>> RerankAsync(string query, IReadOnlyList<Chunk> chunks, int topN);
}

public sealed class HttpReranker(HttpClient http) : IReranker
{
    public async Task<IReadOnlyList<ScoredChunk>> RerankAsync(
        string query, IReadOnlyList<Chunk> chunks, int topN)
    {
        var body = new
        {
            query,
            documents = chunks.Select(c => c.Text).ToArray(),
            top_n = topN
        };

        var res = await http.PostAsJsonAsync("rerank", body);
        res.EnsureSuccessStatusCode();
        var data = await res.Content.ReadFromJsonAsync<RerankResponse>();

        return data!.Results
            .Select(r => new ScoredChunk(chunks[r.Index], r.Score))
            .ToList();
    }
}

public sealed record RerankResponse(List<RerankItem> Results);
public sealed record RerankItem(int Index, double Score);
public sealed record ScoredChunk(Chunk Chunk, double Score);
Và pipeline trả lời câu hỏi chỉ thêm đúng hai dòng so với bản không có reranking:
public async Task<string> AnswerAsync(string question)
{
    var candidates = await retriever.SearchAsync(question, top: 50);   // lấy rộng
    var ranked = await reranker.RerankAsync(question, candidates, topN: 5);

    var context = string.Join("\n\n", ranked
        .Where(r => r.Score >= minScore)                              // ngưỡng tối thiểu
        .Select(r => $"[{r.Chunk.DocumentName}, {r.Chunk.Section}]\n{r.Chunk.Text}"));

    if (context.Length == 0)
        return "Mình chưa tìm thấy chính sách nào nói về trường hợp này, bạn chờ nhân viên hỗ trợ nhé.";

    return await llm.CompleteAsync(BuildPrompt(context, question));
}
Để ý dòng ngưỡng minScore. Đây là lợi ích phụ của reranker mà nhiều người không dùng: điểm rerank thường phản ánh mức "trả lời được câu hỏi" tốt hơn khoảng cách vector, nên bạn có thể dùng nó để quyết định không trả lời. Khi đoạn tốt nhất vẫn có điểm thấp, nhiều khả năng tài liệu không có câu trả lời, và chuyển sang nhân viên thật tốt hơn để model tự bịa. Giá trị ngưỡng phụ thuộc vào mô hình rerank (mỗi mô hình có thang điểm riêng), nên phải chọn bằng dữ liệu, không chọn bằng cảm giác.
Prompt dùng LLM làm reranker
Nếu chưa muốn thêm service, cách thứ ba đủ để thử nghiệm. Prompt tệ:
Sắp xếp các đoạn sau theo mức độ liên quan với câu hỏi.Prompt tốt hơn, nói rõ tiêu chí và định dạng đầu ra:
Câu hỏi của khách: "Hàng mua trong đợt sale có được đổi size không?"

Dưới đây là 20 đoạn chính sách, mỗi đoạn có số thứ tự [n].
Chấm mỗi đoạn từ 0 đến 3 theo tiêu chí: đoạn này có chứa thông tin
TRỰC TIẾP trả lời câu hỏi không (không phải chỉ cùng chủ đề).
0 = không liên quan, 1 = cùng chủ đề nhưng không trả lời,
2 = trả lời một phần, 3 = trả lời trực tiếp.

Trả về JSON: [{"id": n, "score": s}], không giải thích.
Cụm "không phải chỉ cùng chủ đề" là phần quan trọng nhất, vì đó chính là điểm yếu của vector search mà bạn đang muốn bù. Kết hợp với structured output để chắc chắn nhận được JSON parse được.
Reranking đáng giá đến đâu, và cái giá phải trả
Reranking không miễn phí. Bạn thêm một lần gọi mạng vào mỗi câu hỏi, và thời gian chấm tăng theo số ứng viên.
| Khía cạnh | Không rerank | Có rerank |
|---|---|---|
| Độ trễ thêm | 0 | Từ vài chục đến vài trăm mili giây tùy mô hình, số ứng viên và hạ tầng (tự đo) |
| Chi phí | Chỉ embedding + LLM | Thêm phí rerank hoặc chi phí host mô hình |
| Số đoạn đưa vào prompt | Thường phải để nhiều (10–20) cho chắc | Ít hơn (3–5) vì đã chọn tinh |
| Token cho LLM | Nhiều | Ít hơn, có khi bù lại chi phí rerank |
| Khả năng từ chối khi không có dữ liệu | Khó, khoảng cách vector khó diễn giải | Dễ hơn nhờ ngưỡng điểm rerank |
Dòng thứ ba và thứ tư hay bị bỏ qua. Không có reranker, đội dev thường "chữa cháy" bằng cách tăng số đoạn đưa vào prompt từ 5 lên 15 cho chắc có đoạn đúng. Kết quả là prompt dài hơn, đắt hơn, và model dễ bị nhiễu bởi các đoạn cùng chủ đề nhưng sai ý (chuyện nhồi context làm model kém đi không phải lý thuyết). Reranker cho phép bạn đưa ít đoạn hơn mà đúng hơn.
Cách đo xem reranker có giúp không
Đừng thêm reranker rồi "thấy có vẻ tốt hơn". Hãy đo:
Gom 50–100 câu hỏi thật từ log CSKH hoặc từ nhân viên, mỗi câu ghi sẵn đoạn tài liệu đúng.
Chạy retrieval không rerank, ghi lại: đoạn đúng có nằm trong top 5 không.
Chạy lại với rerank (lấy 50, giữ 5), ghi lại cùng chỉ số.
So thêm độ trễ trung bình và p95 của hai cách.
Chỉ số "đoạn đúng có trong top K không" thường gọi là hit rate hoặc recall@K. Nếu recall@50 của bước tìm rộng đã thấp (đoạn đúng không có trong 50 ứng viên), reranker không cứu được, vì nó chỉ sắp xếp lại những gì được đưa cho nó. Lúc đó vấn đề nằm ở chunking hoặc ở bước tìm kiếm.
Lỗi hay gặp khi thêm reranking
Lấy quá ít ứng viên. Lấy 5 rồi rerank giữ 5 thì reranker chỉ đổi thứ tự, không cứu được đoạn đúng nằm ở vị trí 14. Tầng đầu phải lấy rộng hơn tầng sau nhiều lần.
Lấy quá nhiều ứng viên. Rerank 500 đoạn cho mỗi câu hỏi thì độ trễ tăng vọt mà lợi ích gần như không thêm. Bắt đầu ở 30–50, đo rồi chỉnh.
Đưa đoạn quá dài vào reranker. Mô hình rerank có giới hạn độ dài đầu vào; đoạn dài bị cắt cụt và phần bị cắt có khi chứa câu trả lời. Đây lại là chuyện chunking.
Dùng reranker chỉ hiểu tiếng Anh cho tài liệu tiếng Việt. Hãy chọn mô hình hỗ trợ đa ngôn ngữ và kiểm bằng câu hỏi tiếng Việt thật, có cả câu không dấu và viết tắt kiểu "đt", "sp", "ck".
Dùng ngưỡng điểm cố định khi đổi mô hình. Mỗi reranker có thang điểm khác nhau. Đổi mô hình là phải chọn lại ngưỡng.
Bỏ qua metadata. Có những tiêu chí reranker không biết: chính sách hết hiệu lực, tài liệu thuộc chi nhánh khác. Lọc bằng metadata (ngày hiệu lực, phòng ban, quyền truy cập) trước khi rerank, đừng hy vọng mô hình tự đoán.
Checklist áp dụng
Đã có bộ câu hỏi thật kèm đoạn đúng để đo recall trước và sau.
Tầng tìm rộng lấy 30–100 ứng viên, tầng rerank giữ 3–8 đoạn.
Reranker hỗ trợ tiếng Việt, đã thử với câu không dấu và viết tắt.
Có ngưỡng điểm tối thiểu và đường lui khi không đoạn nào đạt ngưỡng.
Đo độ trễ p95 của bước rerank, có timeout và phương án dự phòng (dùng thẳng thứ tự vector nếu reranker lỗi).
Lọc metadata (hiệu lực, quyền truy cập) trước khi rerank.
Kết luận
Reranking là bước chấm lại vài chục đoạn tìm được bằng một mô hình đọc câu hỏi cạnh từng đoạn, để chỉ giữ những đoạn thật sự trả lời câu hỏi. Vector search lo phần "tìm rộng, nhanh", reranker lo phần "chọn đúng". Thêm nó vào pipeline chỉ mất vài dòng code, nhưng đổi lại prompt ngắn hơn, câu trả lời đúng hơn, và bạn có thêm một tín hiệu để biết khi nào nên nói "không biết".
Bước tiếp theo: lấy bộ câu hỏi thật của dự án, đo recall@5 trước và sau khi thêm reranker. Nếu kết quả vẫn sai, bài kế tiếp 5 lý do RAG trả lời sai giúp bạn khoanh vùng lỗi nằm ở bước nào.
Xem bản tóm tắt dưới một phút trên YouTube @teduco hoặc TikTok @teducolabs, và đọc thêm các bài khác trong chuyên mục AI cho Backend Developer.
Bài viết liên quan
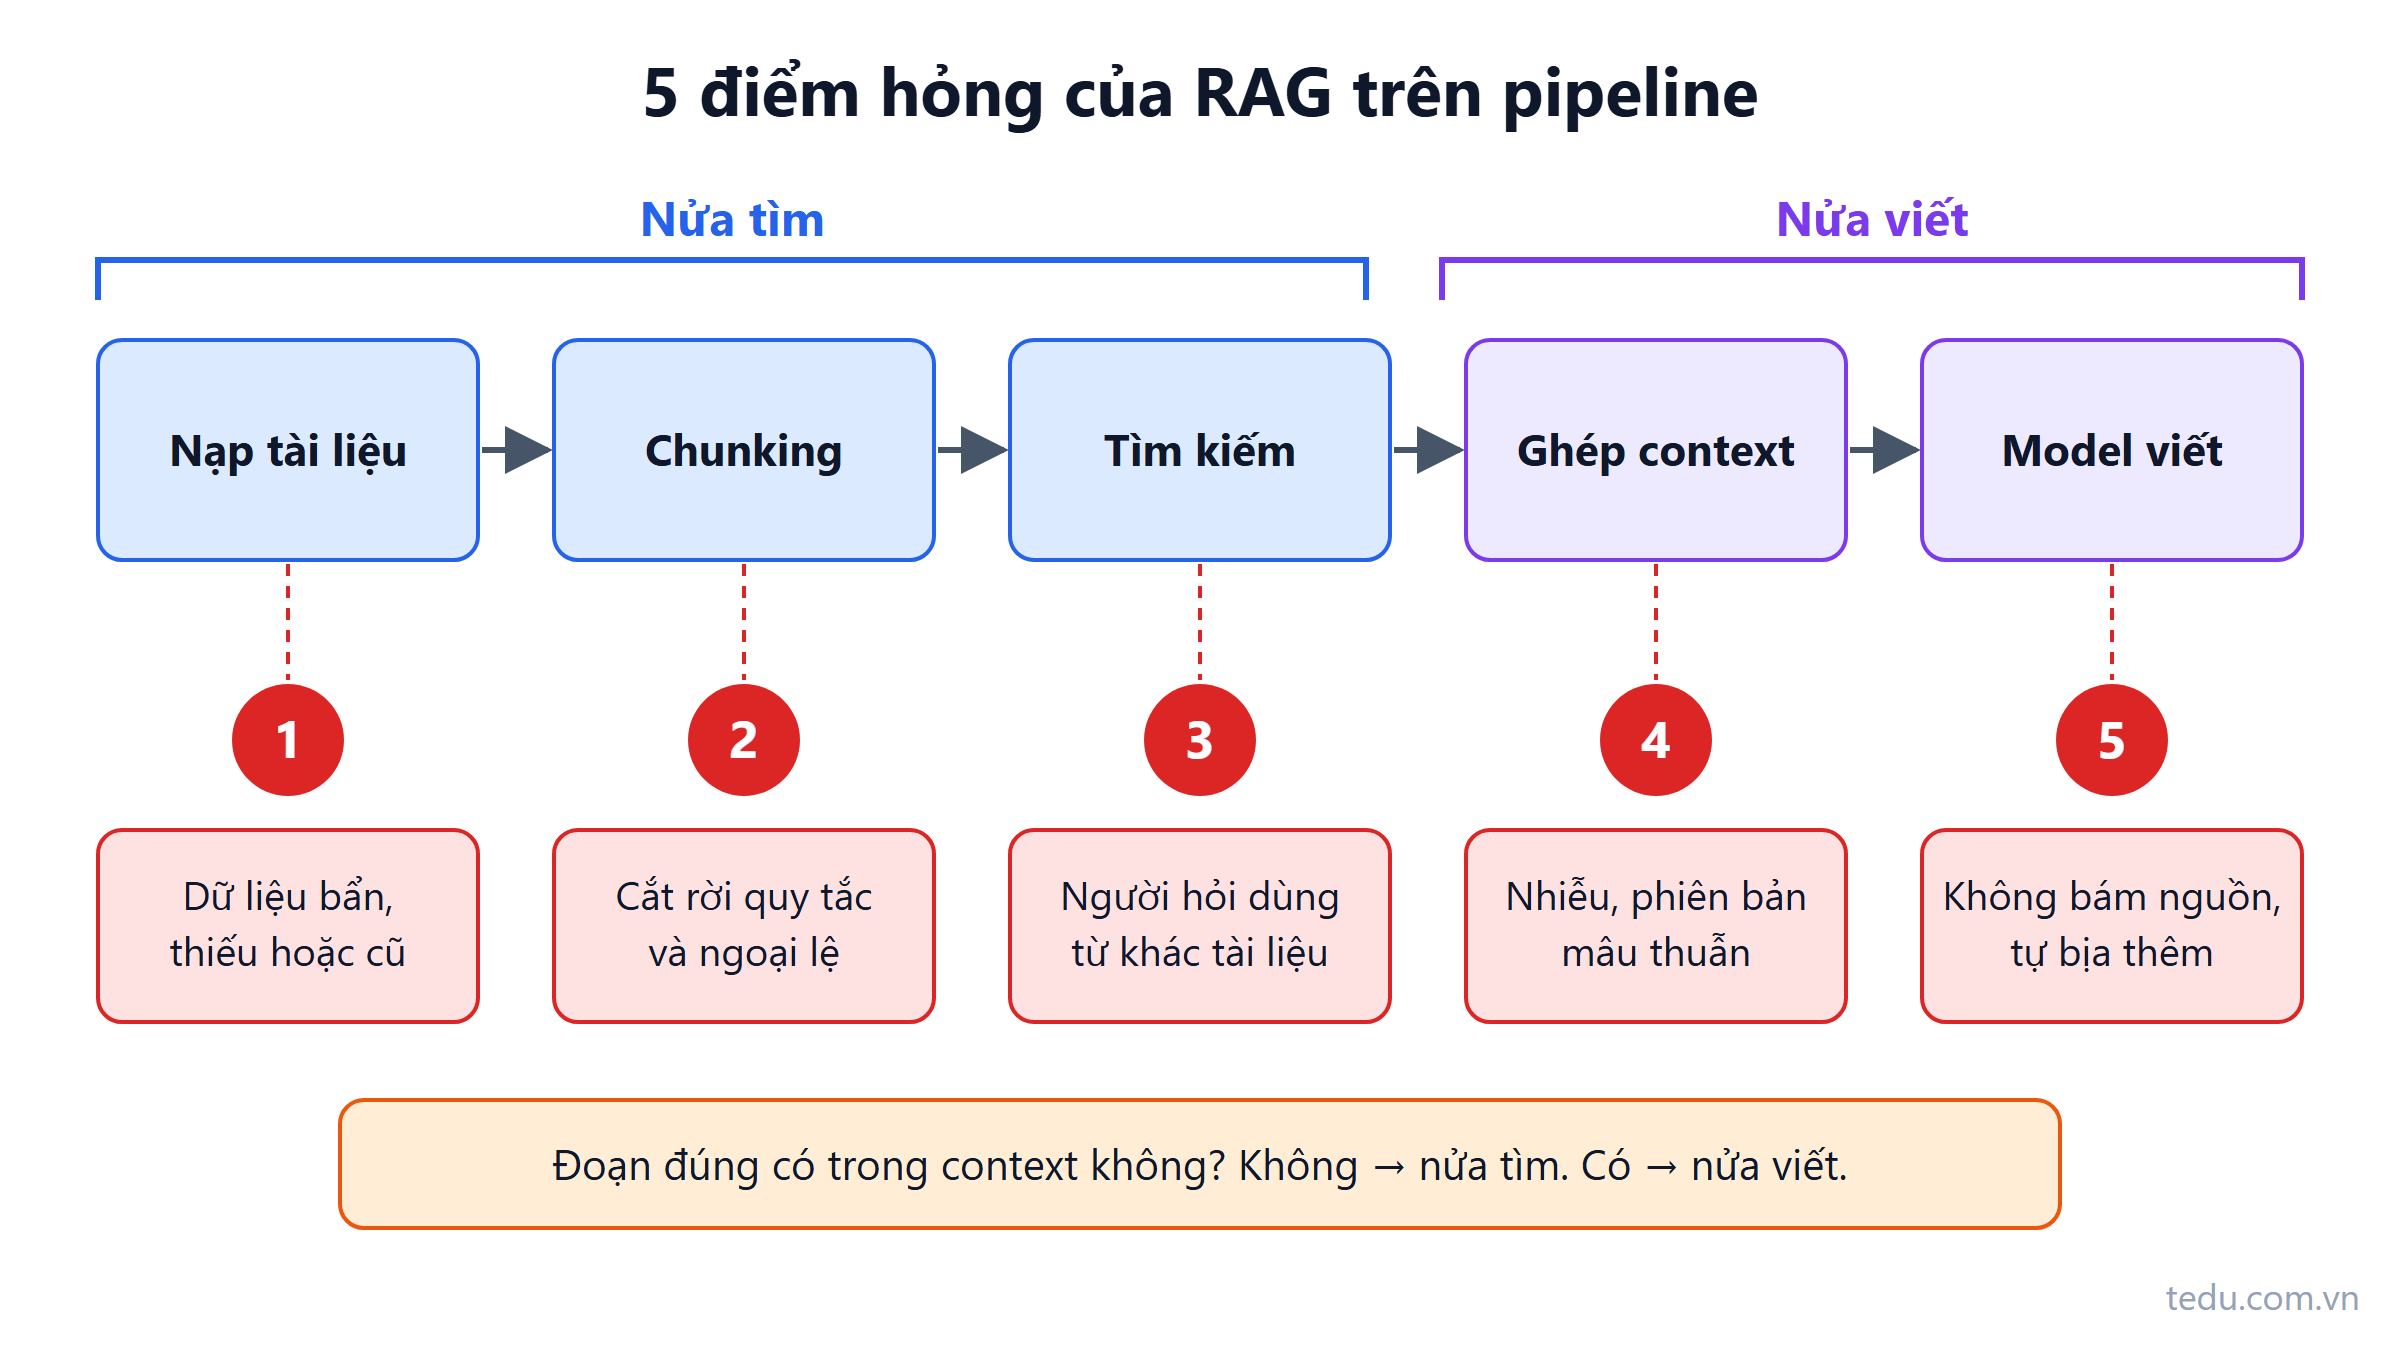
5 lý do RAG trả lời sai và cách tìm đúng chỗ hỏng
RAG trả lời sai hiếm khi do model kém. Bài chỉ ra 5 chỗ hỏng thường gặp từ dữ liệu, chunking, tìm kiếm đến prompt, kèm cách khoanh vùng lỗi bằng log.
Đọc thêm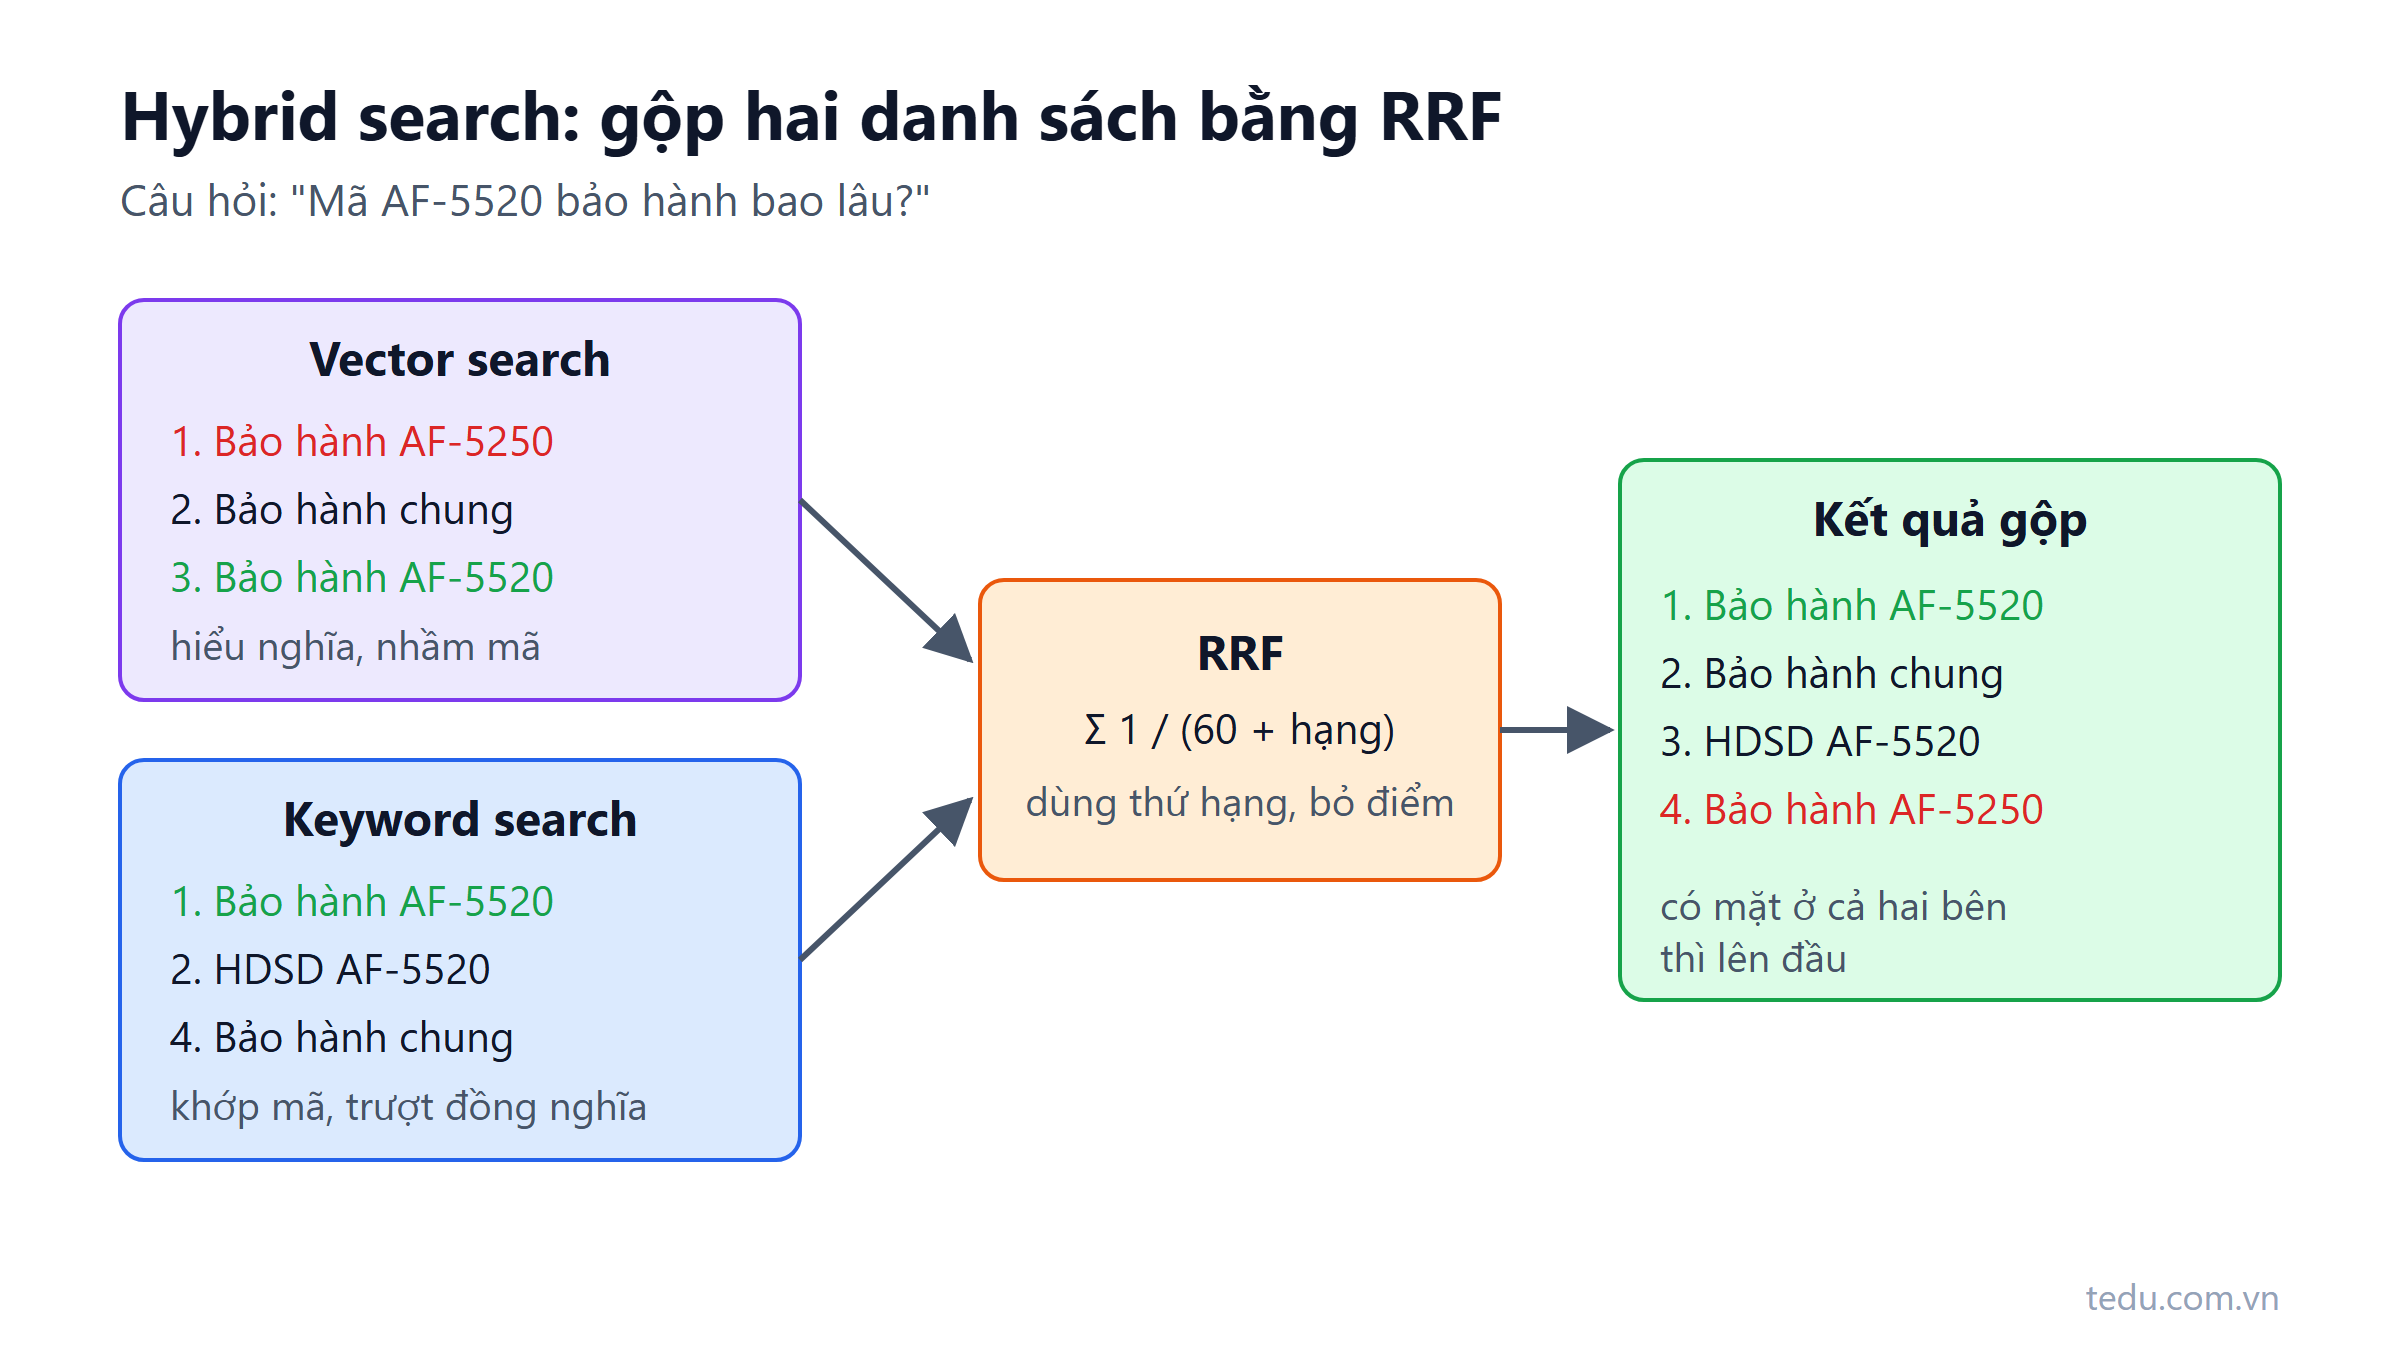
Hybrid search trong RAG: kết hợp keyword và vector
Vector search giỏi hiểu nghĩa nhưng hay trượt mã đơn hàng, số hiệu văn bản. Hybrid search kết hợp keyword và vector bằng RRF, có ví dụ SQL PostgreSQL và C#.
Đọc thêm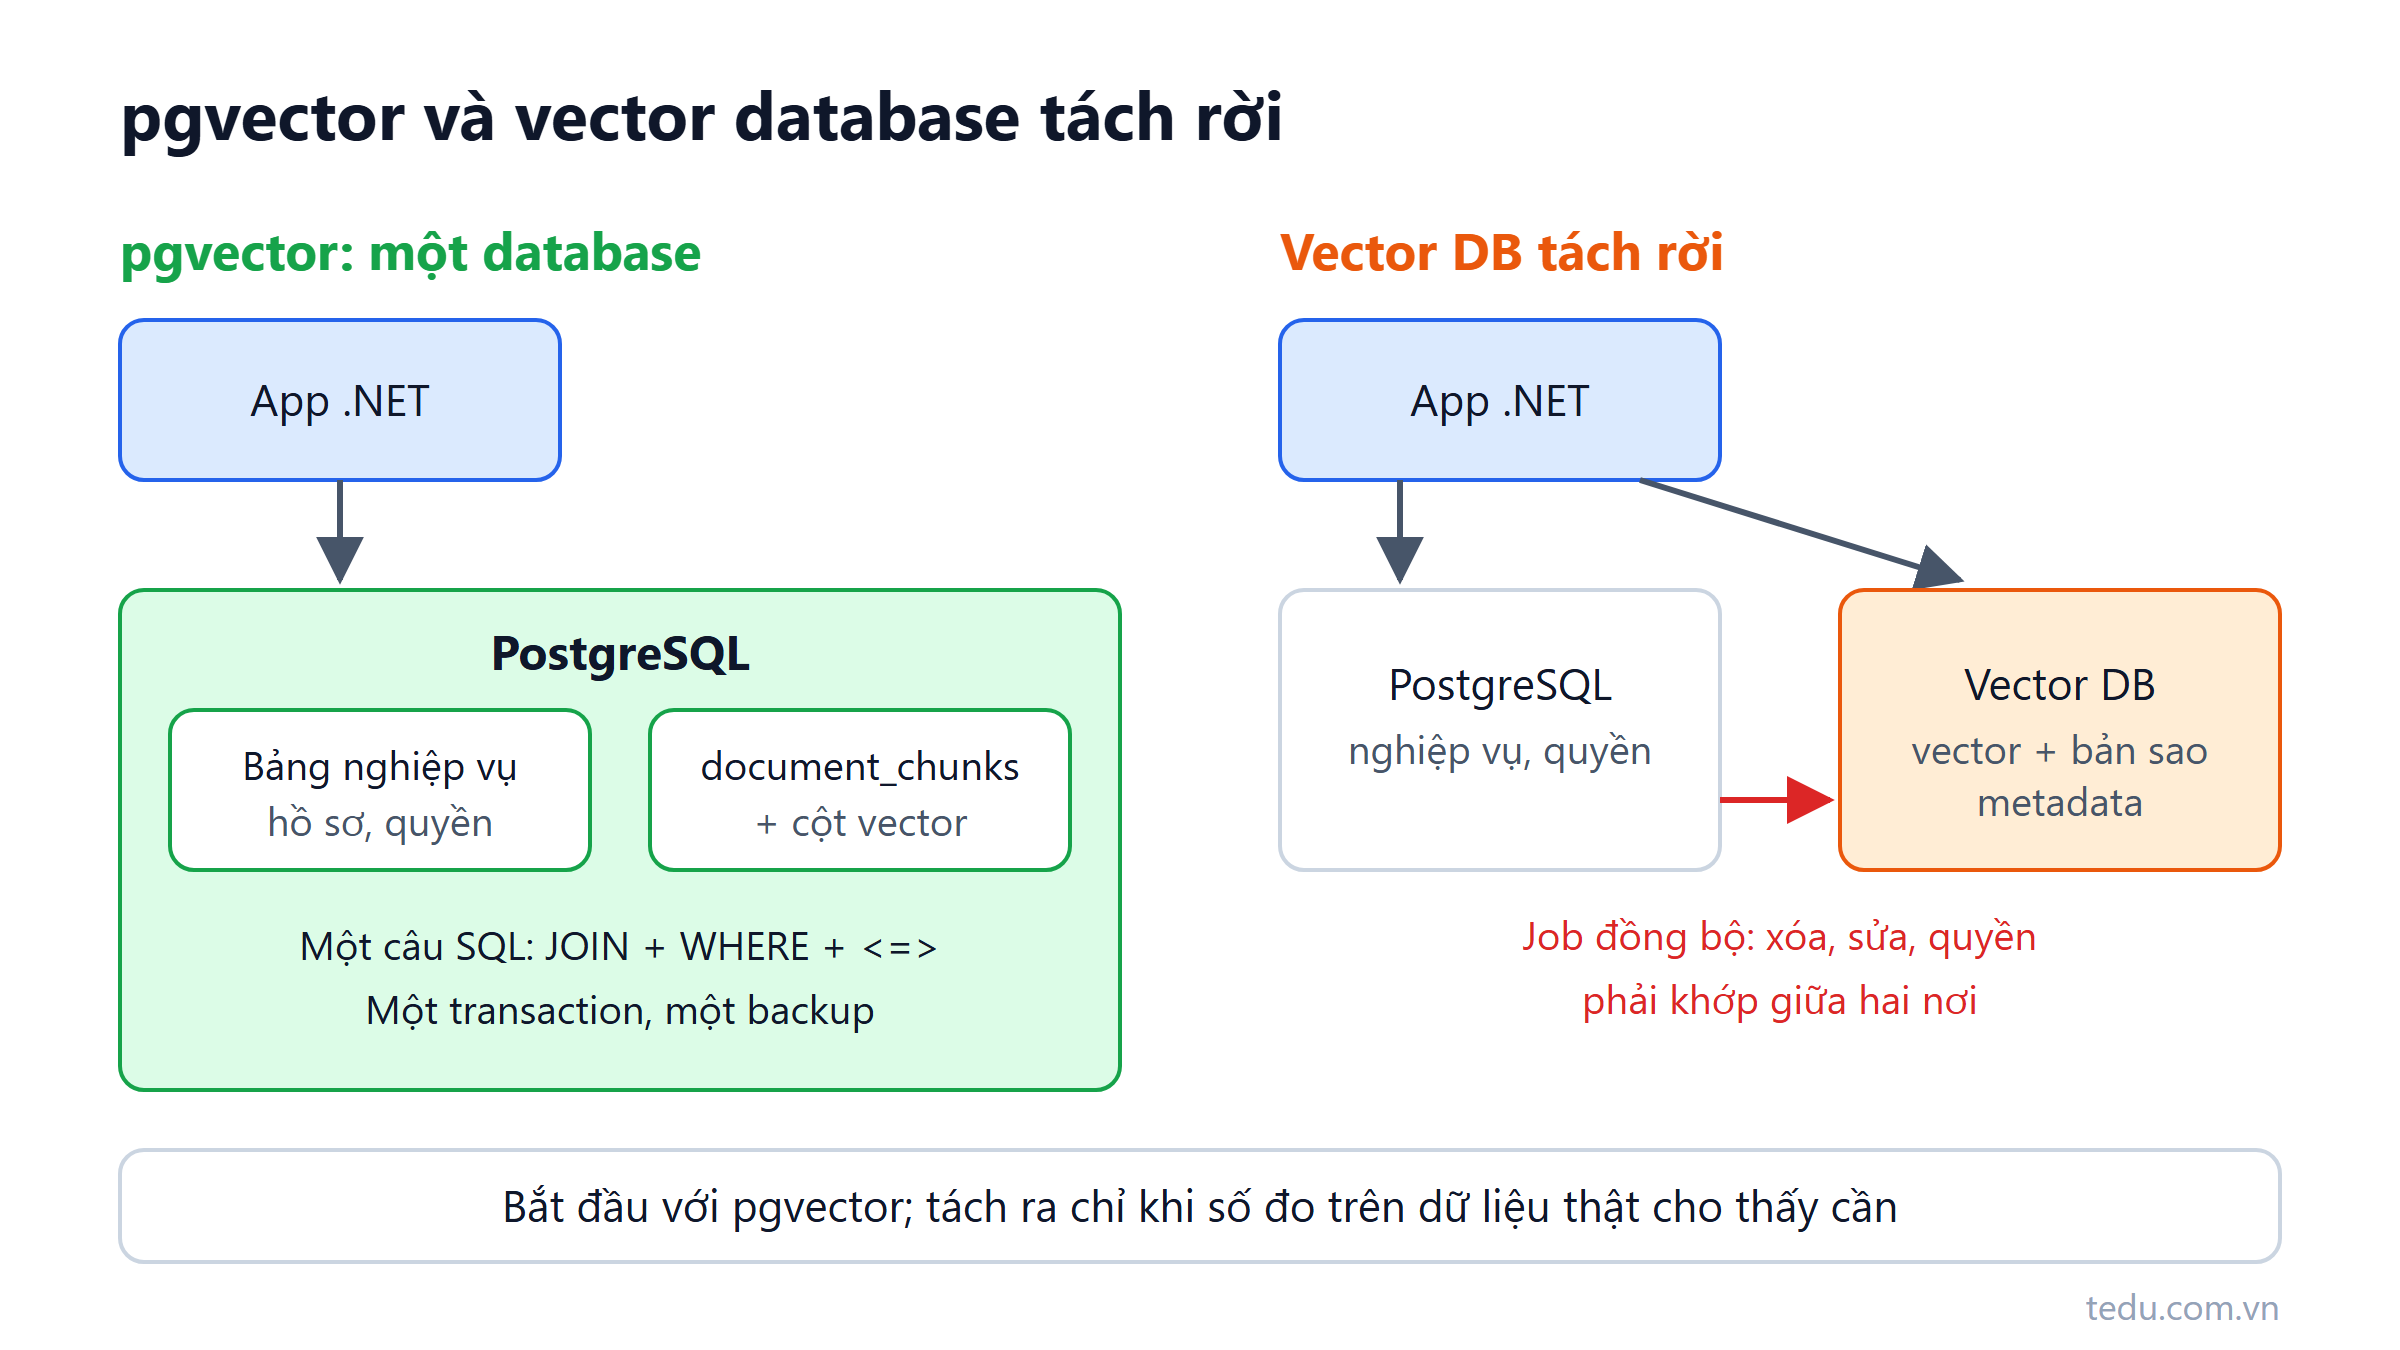
pgvector: vì sao PostgreSQL thường đủ làm vector DB
pgvector biến PostgreSQL thành vector database cho RAG. Hướng dẫn SQL, C#, so sánh với vector DB chuyên dụng và khi nào pgvector không đủ.
Đọc thêm
Chunking trong RAG: cắt tài liệu sai thì kết quả hỏng
Chunking là bước cắt tài liệu thành đoạn nhỏ trước khi đưa vào RAG. Bài so sánh các cách chunking, ví dụ với quy chế tiếng Việt và code C# cắt theo Điều, Khoản.
Đọc thêm
RAG là gì? Khi nào cần và khi nào không cần
RAG là cách đưa đúng đoạn tài liệu vào prompt để model trả lời theo dữ liệu thật. Bài này giải thích pipeline và khi nào bạn không cần RAG.
Đọc thêm
Quản lý prompt như code: versioning, review và test
Prompt là logic nghiệp vụ, sửa một câu có thể đổi hành vi cả hệ thống. Bài hướng dẫn quản lý prompt như code: lưu trong repo, versioning, review, test và rollback.
Đọc thêm
Chain-of-thought: cho model suy nghĩ trước khi trả lời
Chain-of-thought là cho model viết các bước suy luận trước khi chốt đáp án. Bài giải thích vì sao nó hiệu quả, khi nào nên dùng và cách dùng trong production.
Đọc thêm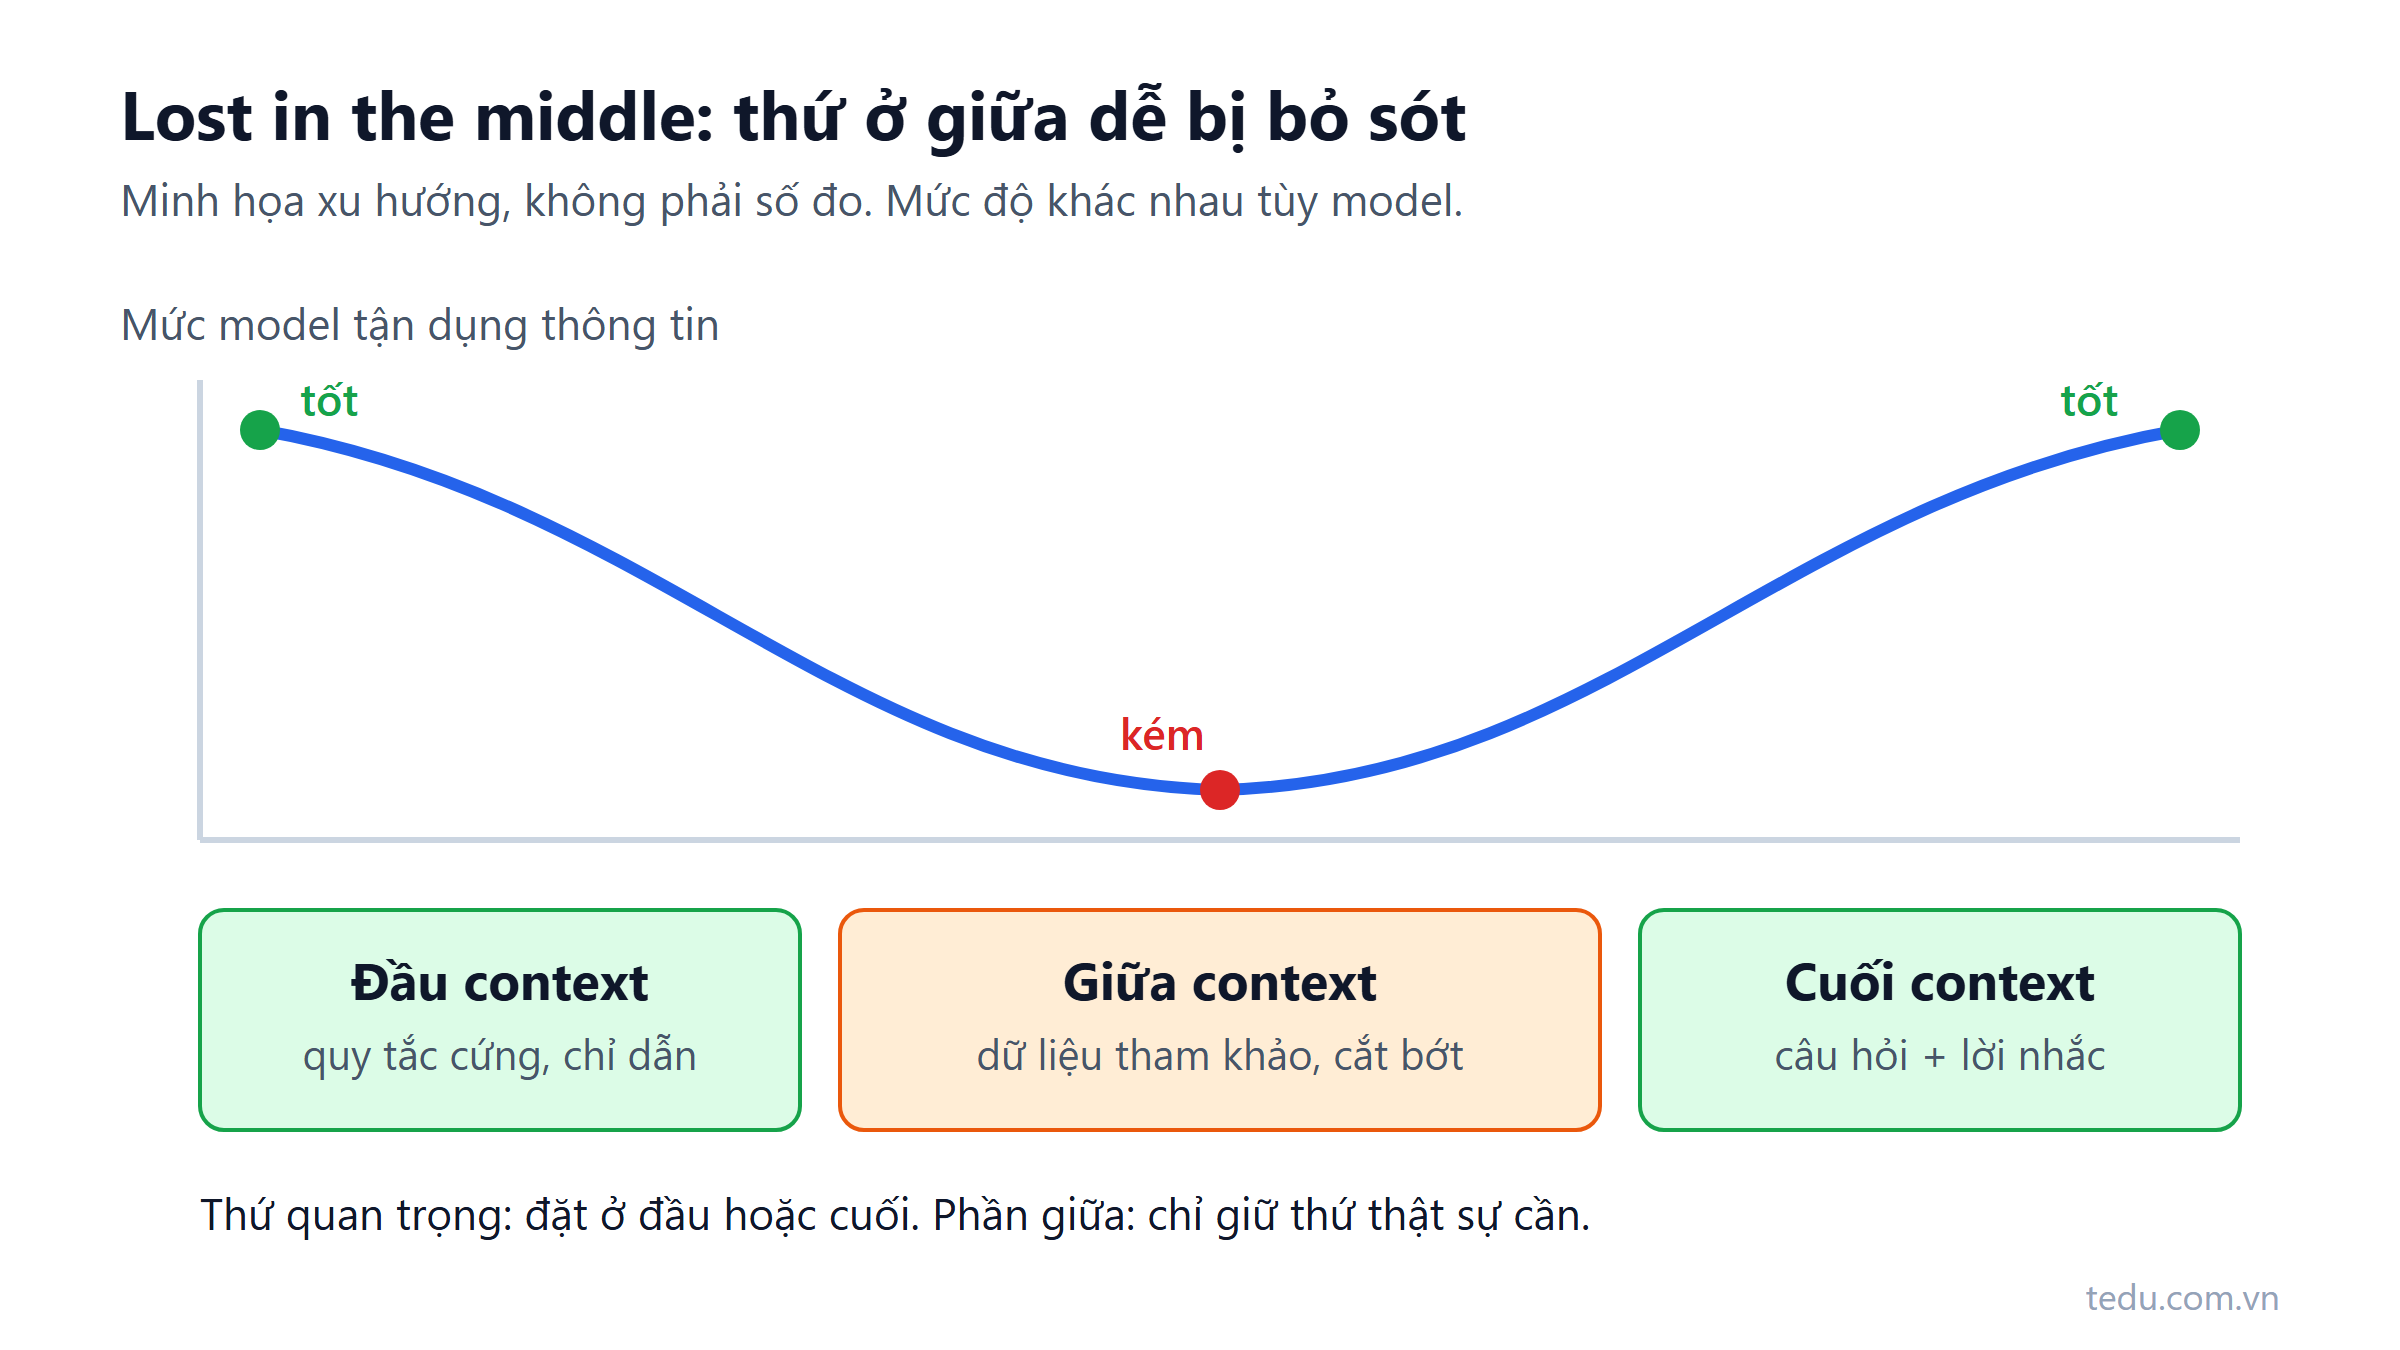
Vì sao nhồi nhiều context lại làm model kém đi
Context window lớn không có nghĩa là nhồi càng nhiều càng tốt. Bài giải thích vì sao model trả lời kém đi khi context dài và cách chọn lọc context đúng.
Đọc thêm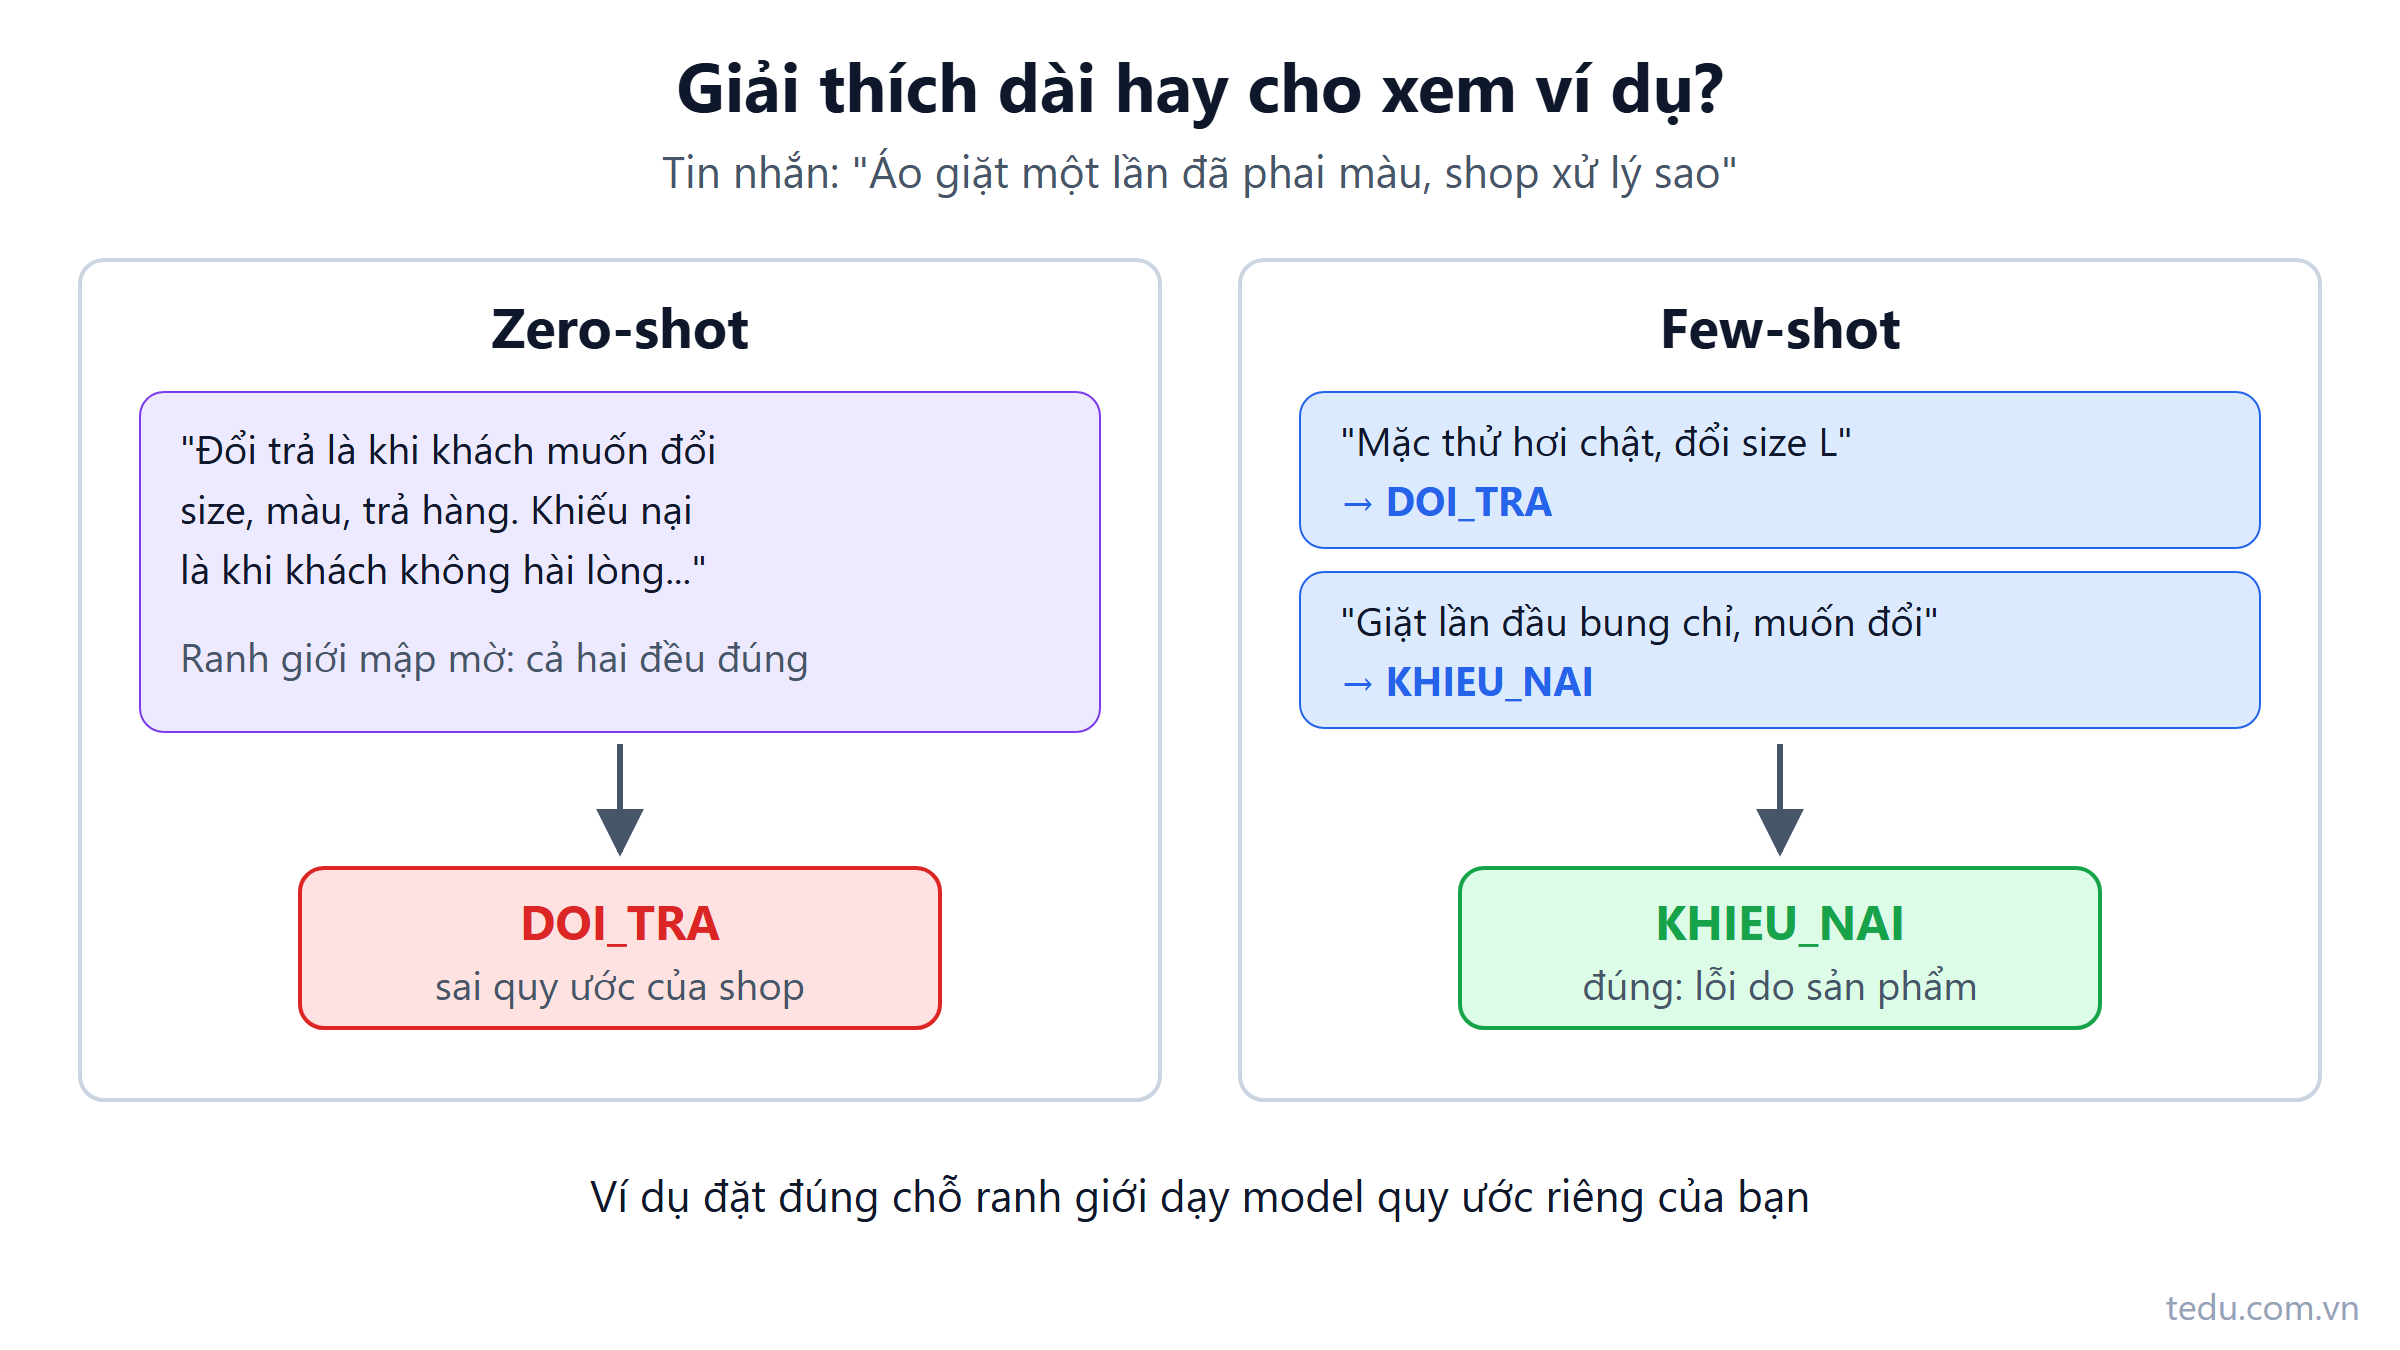
Few-shot prompting: cho LLM ví dụ thay vì giải thích dài dòng
Few-shot prompting là đưa vài ví dụ đầu vào và đầu ra mẫu để LLM bắt chước. Bài chỉ cách chọn ví dụ, lỗi hay gặp và few-shot động bằng C#.
Đọc thêm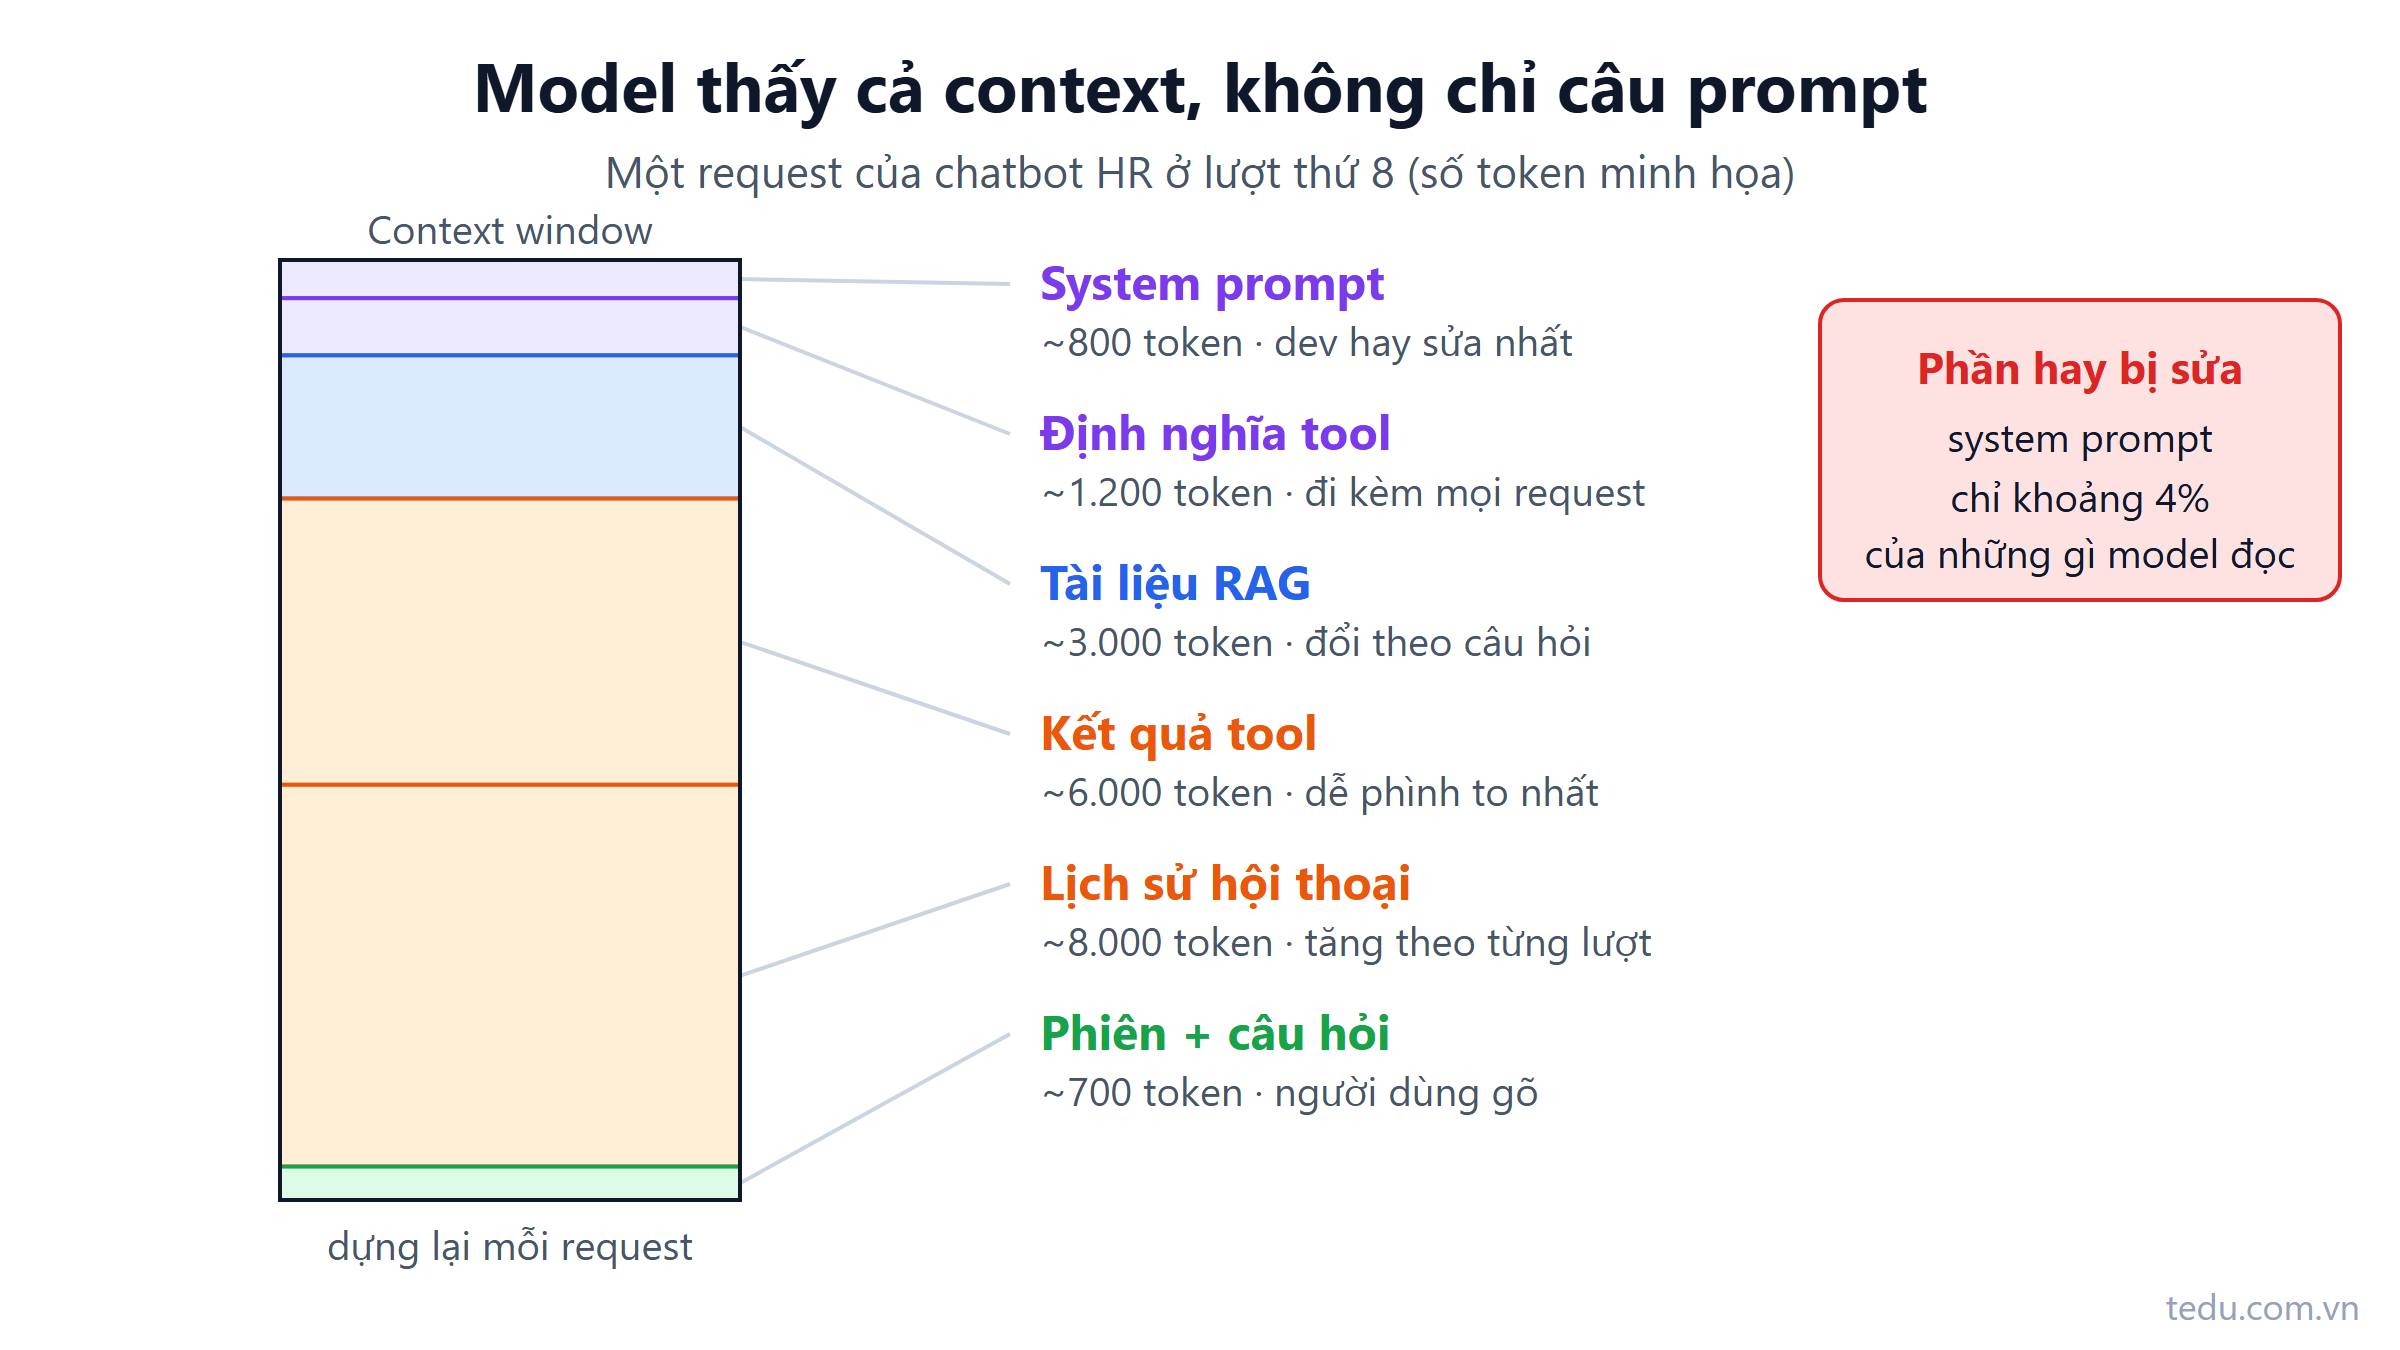
Context engineering là gì, vì sao quan trọng hơn prompt
Context engineering là quyết định cái gì vào context window, cái gì phải ra, theo thứ tự nào. Câu prompt chỉ là một phần nhỏ của những gì model thấy.
Đọc thêm