Tìm kiếm vector PostgreSQL với pgvector và hybrid search trong Next.js
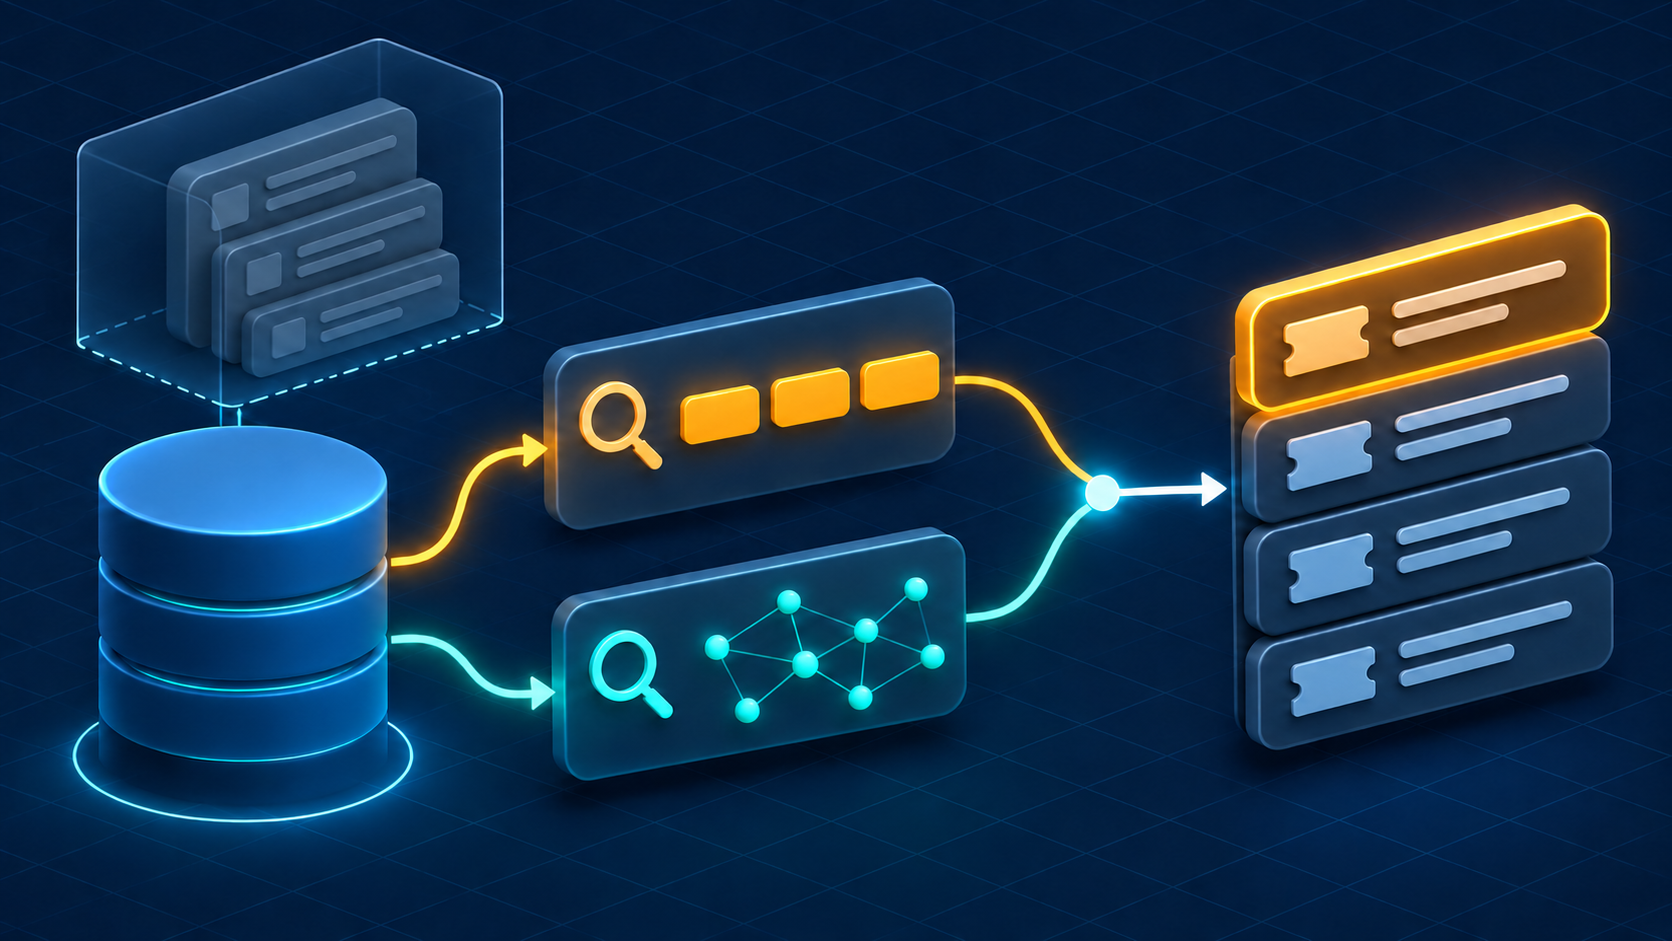
Bài viết trình bày cách xây dựng một lab tìm kiếm ticket hỗ trợ nhỏ, kết hợp tìm kiếm từ khóa, vector và hybrid trên PostgreSQL với pgvector 0.8 trở lên, sau đó nối truy vấn vào Next.js Route Handler. Lab dùng vector ba chiều cố định để có thể tái tạo hành vi xếp hạng và lọc mà không cần API key embedding; các con số này chỉ thay thế cho embedding, không đo khả năng hiểu ticket của mô hình.
Thiết lập schema và dữ liệu mẫu
Cần một database PostgreSQL dùng một lần, có extension vector. Phần thiết lập extension và schema dùng role migration; route tìm kiếm dùng một login riêng bị giới hạn quyền. Bảng support_ticket gồm tenant_id, error_code, title, body, embedding vector(3) và cột search_text tsvector sinh tự động, có trọng số: title mức A, body mức B.
Các chỉ mục gồm B-tree trên tenant_id, chỉ mục kết hợp (tenant_id, error_code) và GIN trên search_text. Dữ liệu mẫu có bốn ticket của hai tenant acme và other; một ticket của tenant other chứa cùng mã AUTH-4017 nhưng tuyệt đối không được trả về cho Acme. Tác giả lưu ý mã lỗi hay SKU nên nằm ở trường riêng có chỉ mục, vì full-text search chuẩn hóa ngôn ngữ và không đảm bảo khớp chính xác các ký tự đặc biệt.
So sánh tìm kiếm từ khóa và vector
Tìm kiếm từ khóa là baseline tốt cho từ đặc trưng, tên sản phẩm và mã định danh. Tìm kiếm vector sắp xếp theo khoảng cách tới vector truy vấn, có thể lấy được văn bản ít trùng từ với câu hỏi. Cả hai truy vấn đều lọc tenant trước khi trả ứng viên.
Với bộ dữ liệu mẫu, truy vấn từ khóa cho Acme và AUTH-4017 trả về ticket 1, còn tìm kiếm vector xếp ticket 2 lên trên ticket 1. Ticket riêng tư có vector gần hơn nhưng bị loại bởi bộ lọc tenant. Khi thử câu diễn đạt lại “sign-in works until I close the browser”, tìm kiếm từ khóa không tìm thấy dòng nào vì thiếu từ khóa bắt buộc, trong khi vector trả về ticket về session cookie trước. Trong hệ thống thật, hai chuỗi này sẽ tạo ra các vector truy vấn khác nhau; ở đây cố ý dùng chung một vector để giữ nguyên phía vector.
Kết hợp bằng Reciprocal Rank Fusion
Điểm xếp hạng văn bản và khoảng cách cosine khác đơn vị và ý nghĩa. Reciprocal rank fusion (RRF) dùng vị trí của ứng viên trong từng danh sách thay vì cộng điểm thô: mỗi ứng viên nhận 1 chia cho hằng số cộng thứ hạng của nó ở mỗi danh sách mà nó xuất hiện, ứng viên vắng mặt đóng góp 0. Đây là baseline có thể tinh chỉnh bằng các truy vấn đã được đánh giá.
Ví dụ hybrid ưu tiên khớp mã chính xác trước khi fusion, để mã định danh vẫn thắng khi có một kết quả ngữ nghĩa gần. Với Acme, AUTH-4017 và vector [1,0,0], truy vấn hybrid trả ticket 1 đầu tiên; với câu diễn đạt lại, danh sách từ khóa rỗng và danh sách vector cung cấp kết quả. Không nên coi điểm fusion là phần trăm độ tin cậy; kết quả đầu vẫn có thể sai, đặc biệt khi cả hai nhánh đều không có bằng chứng mạnh. Với agent dùng retrieval-augmented, cần giữ ID nguồn cho mỗi mục và quyết định khi nào trả “không có kết quả đáng tin” dựa trên các truy vấn đã đánh giá thay vì một ngưỡng điểm cố định.
Áp dụng Row Level Security theo tenant
Cần lọc cả hai danh sách ứng viên, không chỉ lọc sau khi lấy top 20 trên toàn bộ tenant, vì như vậy vừa lãng phí ứng viên vừa dễ lộ dữ liệu workspace khác qua một join sau này. Thêm Row Level Security (RLS) làm lớp thứ hai; ứng dụng lấy tenant từ kiểm tra membership đã xác thực, không bao giờ lấy từ tham số tìm kiếm do client kiểm soát.
Role support_search chỉ có quyền SELECT, không sở hữu bảng, không có BYPASSRLS hay quyền superuser. Policy dùng tenant_id = nullif(current_setting('app.tenant_id', true), ''); nếu không đặt tenant trong transaction, policy trả về không dòng nào. Cần kiểm thử qua chính role runtime, vì truy vấn thành công với tư cách chủ bảng không nói lên điều gì về RLS. Mô hình này giả định ứng dụng sở hữu kết nối database và chạy SQL tham số hóa cố định, không phù hợp làm sandbox cho SQL tùy ý từ agent.
Kết nối Next.js Route Handler
Route dùng gói pg với pool giới hạn kết nối, SQL lưu dạng hằng số phía server. Mỗi request xác thực tenant, kiểm tra độ dài câu hỏi (1–400 ký tự), tạo embedding và kiểm tra hình dạng vector. Trong transaction, route đặt statement_timeout 1500ms, đặt tenant bằng set_config với tham số thứ ba là true để cấu hình chỉ có hiệu lực trong transaction, chạy truy vấn hybrid rồi commit; lỗi sẽ rollback. Khi dùng pool, mọi câu lệnh trong transaction phải dùng cùng một client đã checkout.
Đo ảnh hưởng của bộ lọc tenant tới recall HNSW
Chỉ mục HNSW tăng tốc tra cứu vector nhưng chỉ trả về ứng viên gần đúng. Một predicate lọc tenant có độ chọn lọc thấp có thể loại bỏ ứng viên sau khi quét chỉ mục, khiến trả về ít dòng hơn yêu cầu dù tenant có đủ dữ liệu. Lab thêm 500 vector của tenant other gần vector truy vấn, giữ nguyên vector Acme, rồi tạo chỉ mục HNSW với operator class cosine để khớp toán tử khoảng cách đã dùng.
Cần lưu ba ID từ baseline chính xác trước khi tạo chỉ mục, sau đó xem EXPLAIN (ANALYZE, BUFFERS) cho cùng truy vấn vector. Với tenant nhỏ và chọn lọc cao, việc dùng bộ lọc B-tree rồi sắp xếp các dòng phù hợp là kết quả hợp lý trong production nhưng không kiểm tra HNSW; trong lab cần tạm tắt các đường truy cập cạnh tranh để kế hoạch thực thi nêu rõ chỉ mục HNSW.
Nguồn: Planet PostgreSQL
Trích nguồn từ: Planet PostgreSQL
Tags:
Bài viết liên quan
B-tree trong PostgreSQL: trang chỉ mục có thứ tự và thưa dần sau VACUUM
Bài viết của Radim Marek mổ xẻ cấu trúc trang B-tree trong PostgreSQL: khác với heap page, trang chỉ mục được sắp xếp, liên kết với trang anh em và VACUUM không thể thu hồi không gian bên trong trang lá.
Đọc thêm
Cùng truy vấn, cùng index nhưng hiệu năng khác nhau khi chuyển PostgreSQL lên Azure
Câu chuyện khách hàng chuyển PostgreSQL lên Azure gặp truy vấn chậm gấp hàng chục lần dù vẫn dùng index scan, nguyên nhân nằm ở cách dữ liệu được sắp xếp trên đĩa chứ không phải index hay storage.
Đọc thêm
json và jsonb trong PostgreSQL: đo kích thước và tốc độ thực tế
So sánh json và jsonb trên PostgreSQL 17 và 18 với sáu dạng tài liệu, cho thấy jsonb có thể nhỏ hơn 23% hoặc lớn hơn 41%, kèm tốc độ đọc và chỉ mục GIN.
Đọc thêm
PostgreSQL có thực sự đang thắng? Bằng chứng vượt xa các bảng xếp hạng
Bài viết của Dave Stokes tổng hợp khảo sát người dùng, các thương vụ mua bán công ty PostgreSQL, sản phẩm của đối thủ và lựa chọn của AI agent để lập luận PostgreSQL đang dẫn đầu mảng cơ sở dữ liệu vận hành.
Đọc thêm
PostgreSQL, NUMA và điện toán đám mây: những lưu ý khi chạy trong VM và container
Bài cuối trong loạt 4 phần về PostgreSQL và NUMA, tập trung vào thách thức khi chạy PostgreSQL trên máy ảo và container trong môi trường đám mây, kèm các khuyến nghị thực hành.
Đọc thêm
Nâng cấp PostgreSQL tại chỗ không downtime trên cụm phân tán
Ahsan Hadi hướng dẫn nâng cấp tại chỗ từng node PostgreSQL từ 17.10 lên 18.6 trên cụm Spock đa master, giữ ứng dụng luôn có endpoint ghi trong khi mỗi node tạm ngừng vài phút.
Đọc thêm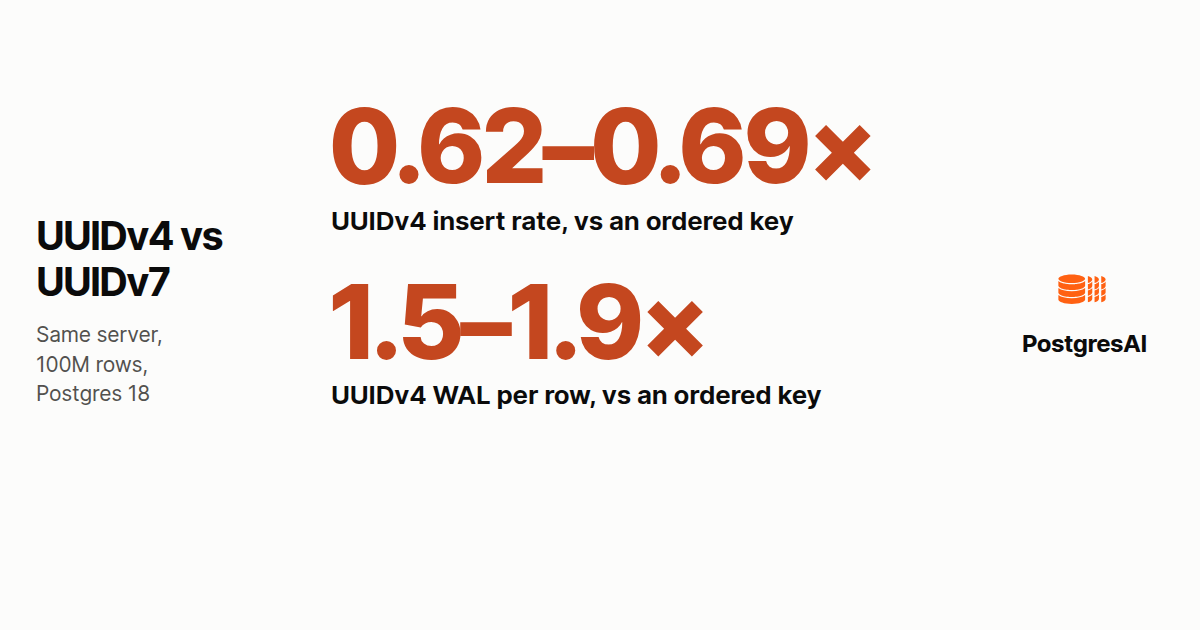
UUIDv4 và UUIDv7 trên Postgres: cái giá của khóa chính ngẫu nhiên
So sánh ba loại khóa chính trên Postgres 18 cho thấy UUIDv4 chèn chậm hơn khóa có thứ tự và ghi WAL nhiều hơn đáng kể ở mức 100 triệu dòng.
Đọc thêm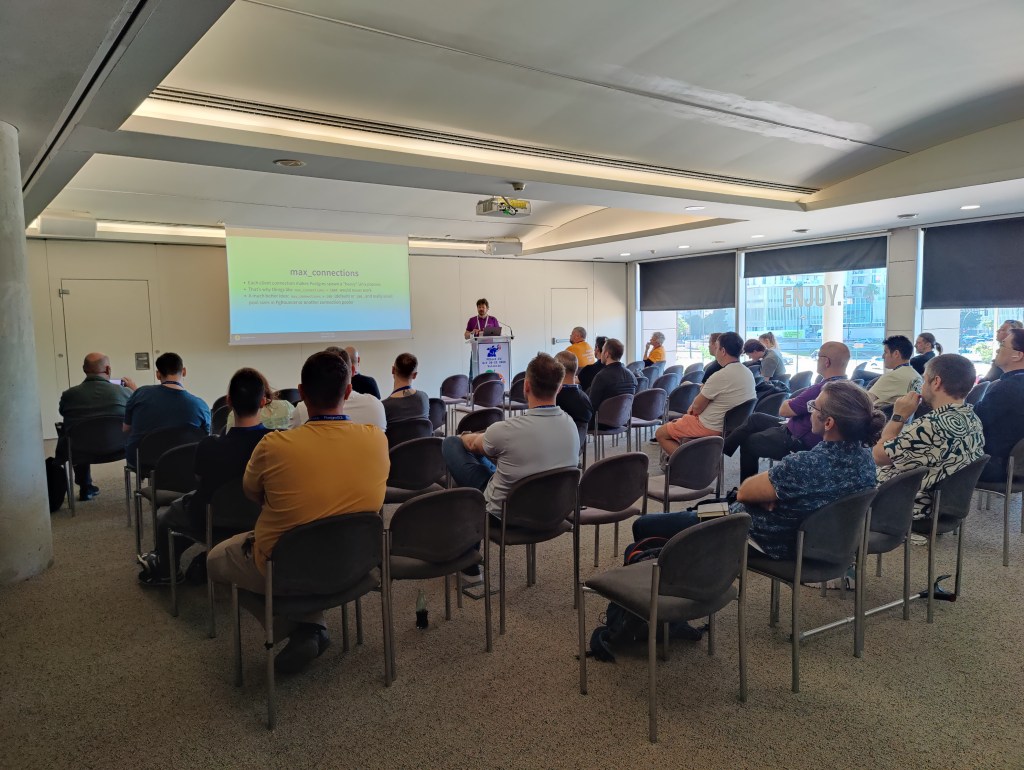
Ilya Kosmodemiansky bàn về file cấu hình postgresql.conf "mặc định"
Bài đầu tiên trong loạt bốn phần của Ilya Kosmodemiansky (Data Egret) về cách PostgreSQL đọc cấu hình và nhóm thiết lập kết nối, dựa trên bản PostgreSQL 18.
Đọc thêm
Chris van Eijk: Lỗi 'server closed the connection unexpectedly' trong PostgreSQL
Phân tích lỗi PostgreSQL đóng kết nối bất ngờ khi có sáu client, cách đọc log máy chủ theo từng nguyên nhân, nơi lưu lý do và các COMMIT bị mất.
Đọc thêm
Christophe Pettus: Hiểu đúng về row_security trong PostgreSQL
Chuyên gia tư vấn PostgreSQL Christophe Pettus giải thích rằng đặt row_security = off không tắt bảo mật cấp dòng mà sẽ gây lỗi khi có chính sách được áp dụng.
Đọc thêm